SageMaker Inference は、モデルエンドポイントの GPU 利用率を最大化するために、Multi-Instance GPU をサポートするようになりました。
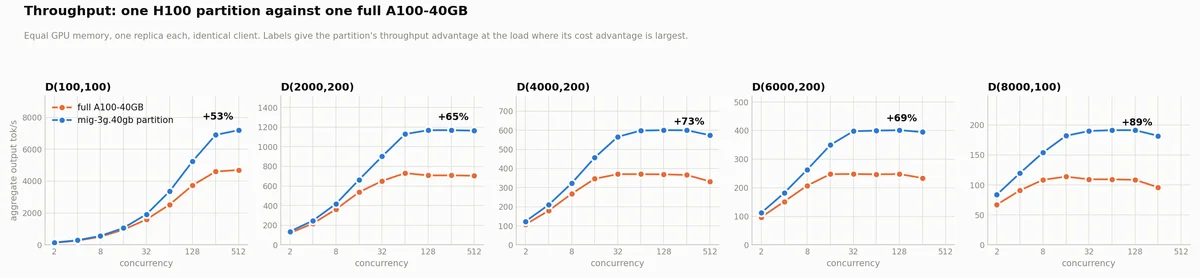
Amazon SageMaker Inference は、NVIDIA Multi-Instance GPU (MIG) による GPU パーティショニングをサポートするようになりました。これにより、1つの GPU をハードウェアで分離されたパーティションに分割し、各パーティションで異なるモデルを実行したり、新しいアクセラレータの適切なサイズのフラクションを使用したりできます。この記事では、2つのオプションの API フィールドがパーティションごとに1つのモデルを配置する方法と、古い GPU 全体に対して測定した結果を示します。