AWS Big Data Blog 한국어 팔로우 이 사이트는 아마존의 클라우드 컴퓨팅 플랫폼인 AWS에서 제공합니다. '블로그'에서 최신 컴퓨팅, AI, 머신 러닝, 분석 및 기타 많은 주제에 대한 기사를 포함하는 인사이트를 찾을 수 있습니다. 특정 블로그는 또한 AWS에서 빅데이터에 대한 정보를 포함합니다. 방문객들은 AWS 고객, 스타트업, 과학 연구자, 교육 기관 및 기타 전문가들의 커뮤니티에서 인사이트를 찾을 수 있습니다. AWS Big Data Blog aws.amazon.com RSS aws.amazon.com AWS Big Data Blog 한국어 RSS thenote.app
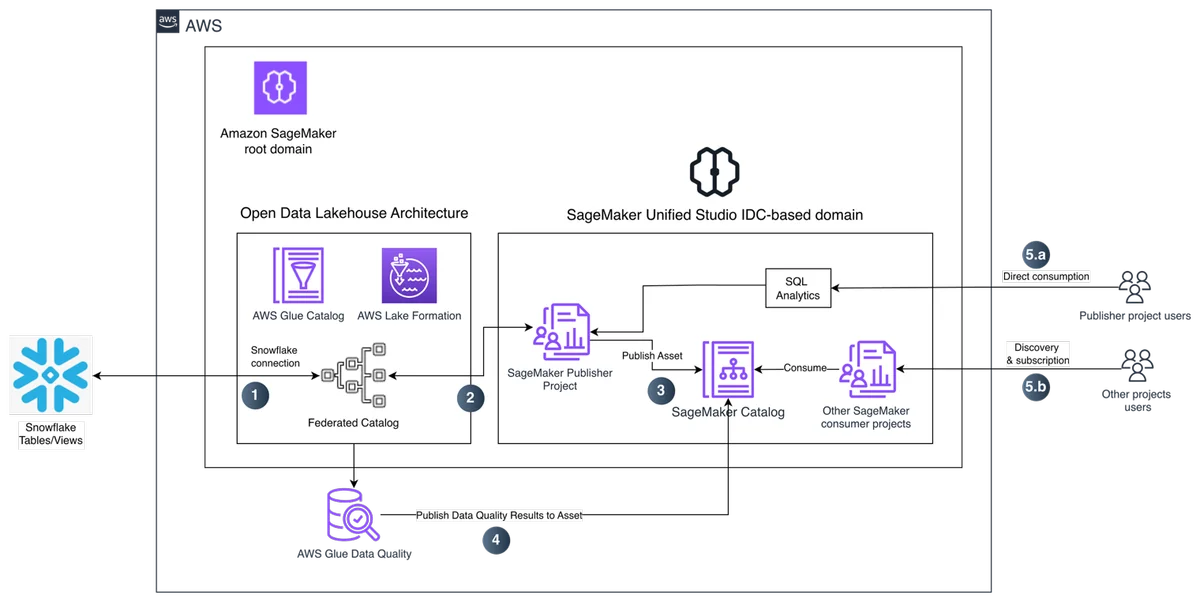
SageMaker Unified Studio를 사용하여 Snowflake 데이터를 검색하고 관리하세요 Snowflake를 Amazon SageMaker Unified Studio에 연결하여 통합 데이터 카탈로그를 구축하세요. 데이터를 이동하지 않고 페더레이션된 Snowflake 테이블을 쿼리하고, SageMaker Catalog에 강화된 에셋을 게시하며, Snowflake에 데이터를 유지한 채 AWS Glue Data Quality로 데이터 품질을 검증하세요. Discover and govern Snowflake data using SageMaker Unified Studio aws.amazon.com +1
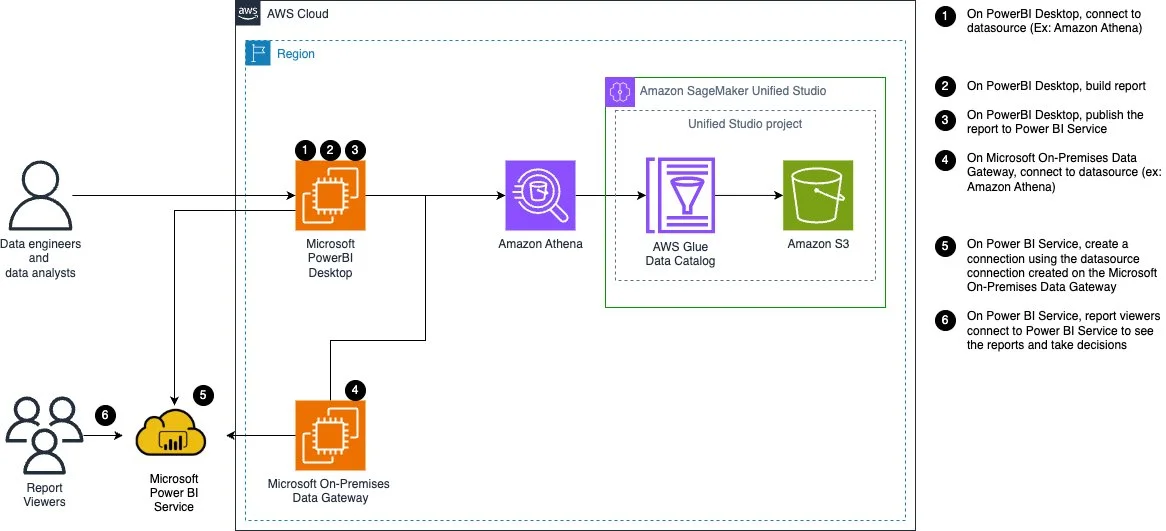
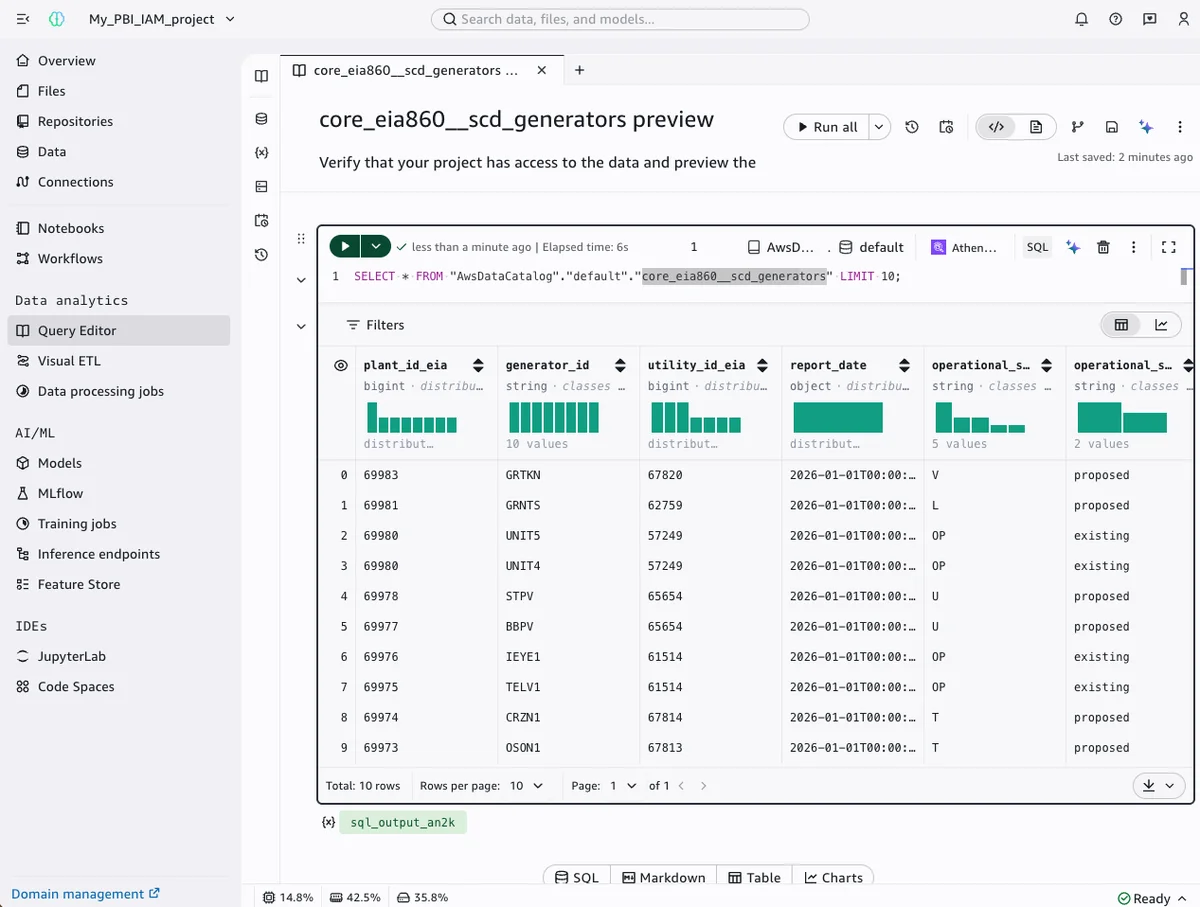
Amazon SageMaker Unified Studio를 Microsoft Power BI에 연결하기 – 1부: IAM Identity Center(IDC) 기반 도메인 Amazon Athena ODBC 드라이버의 새로운 인증 모드를 사용하여 Amazon SageMaker Unified Studio의 거버넌스 데이터에 Microsoft Power BI를 직접 연결하고, 타사 ODBC-JDBC 브릿지 없이 연결할 수 있습니다. 파트 1에서는 DSN 기반 및 DSN 없는 연결 방법 모두를 사용하여 IAM Identity Center(IDC) 기반 도메인을 다룹니다. Connect Amazon SageMaker Unified Studio to Microsoft Power BI – Part 1: IAM Identity Center (IDC)-based domains aws.amazon.com +1
Amazon SageMaker Unified Studio를 Microsoft Power BI에 연결하기 – 2부: IAM 기반 도메인 Amazon Athena ODBC 드라이버를 사용하여 Amazon SageMaker Unified Studio의 거버넌스 데이터에 Microsoft Power BI를 직접 연결합니다. 파트 2에서는 SageMakerIam 인증을 사용하는 IAM 기반 도메인, AWS IAM Identity Center 관리자 설정, DSN 기반 및 DSN 없는 연결 방법을 다룹니다. Connect Amazon SageMaker Unified Studio to Microsoft Power BI – Part 2: IAM-based domains aws.amazon.com +1
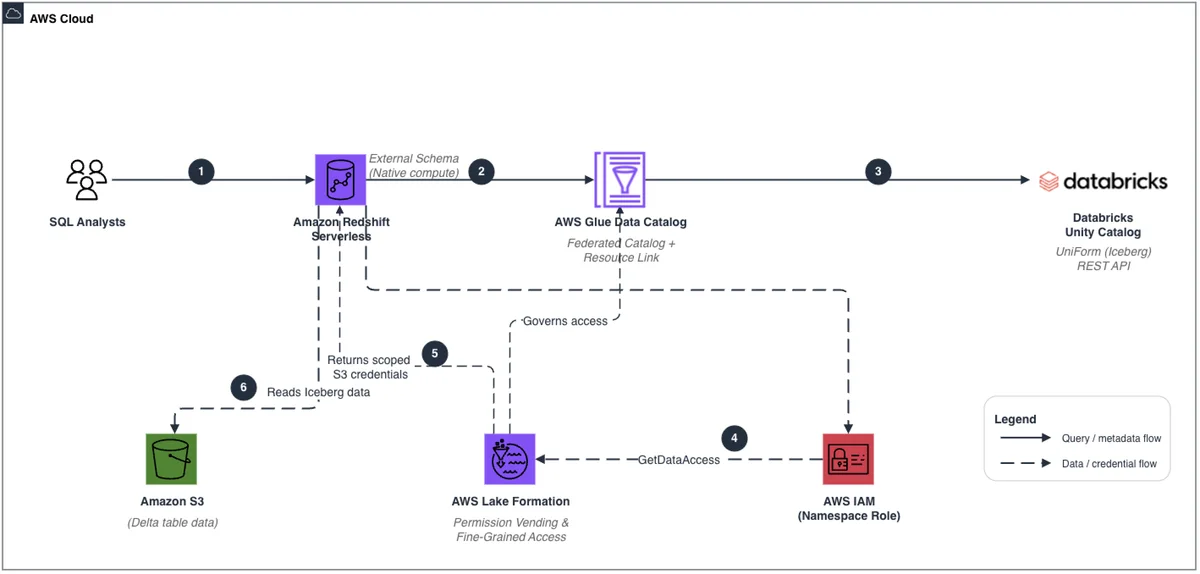
유나이티드 항공이 Amazon Redshift와 AWS Glue Data Catalog 페더레이션을 사용하여 Databricks 관리 데이터를 쿼리하는 방법 United Airlines가 데이터 중복 없이 Amazon Redshift Serverless에서 직접 Databricks Unity Catalog 데이터를 쿼리하기 위해 AWS Glue Data Catalog federation을 어떻게 활용하는지 알아보세요. 리소스 링크와 AWS Lake Formation을 거버넌스에 사용합니다. How United Airlines uses Amazon Redshift and AWS Glue Data Catalog federation to query Databricks-managed data aws.amazon.com +1
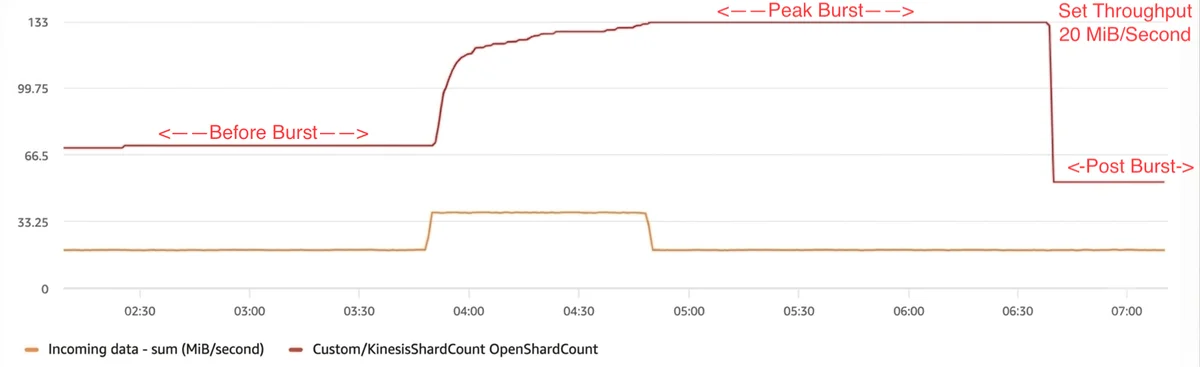
ODA 워밍 스루풋으로 Kinesis Data Streams 온디맨드 용량 축소 Amazon Kinesis Data Streams가 이제 온디맨드 Advantage 스트림의 인제스트 용량 축소를 따뜻한 처리량으로 지원합니다. 축소가 작동하는 방식, Amazon CloudWatch로 스트림 동작을 모니터링하는 방법, 일시적인 트래픽 급증 후 초과 용량을 해제하기 위한 모범 사례를 알아보세요. Scale down Kinesis Data Streams on-demand capacity with ODA warm throughput aws.amazon.com +1
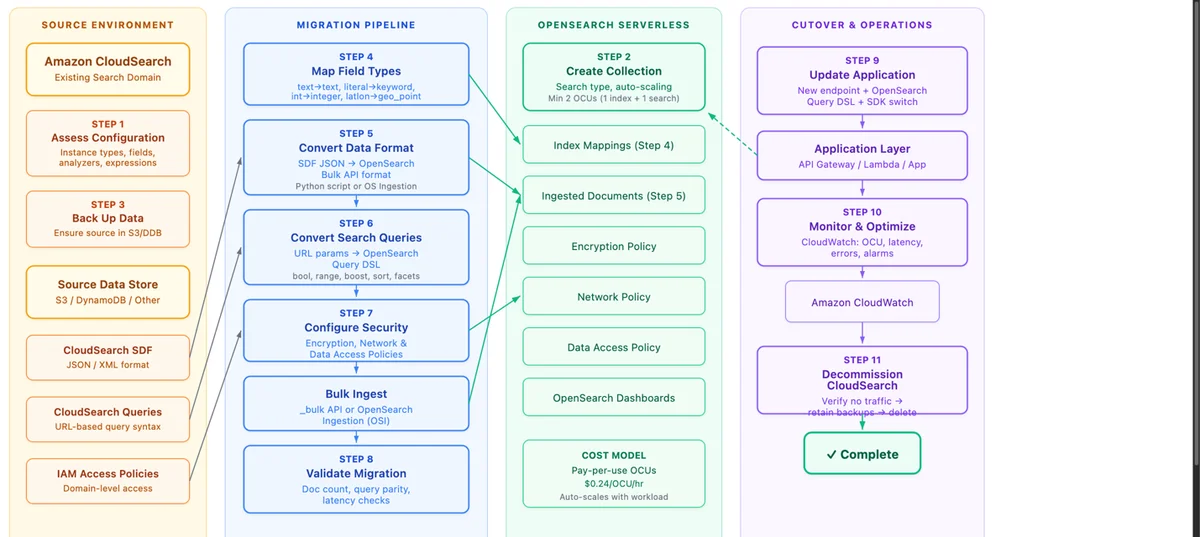
Amazon CloudSearch에서 Amazon OpenSearch Serverless로 마이그레이션하는 방법 Amazon CloudSearch 도메인을 Amazon OpenSearch Serverless로 마이그레이션하는 방법을 알아보세요: 구성을 평가하고, 명시적 인덱스 매핑으로 컬렉션을 생성하고, 문서를 OpenSearch 쿼리 DSL로 변환하고, 보안을 구성하고, Amazon OpenSearch Ingestion으로 데이터를 로드하고, 전환 전에 검증하세요. How to migrate from Amazon CloudSearch to Amazon OpenSearch Serverless aws.amazon.com +1
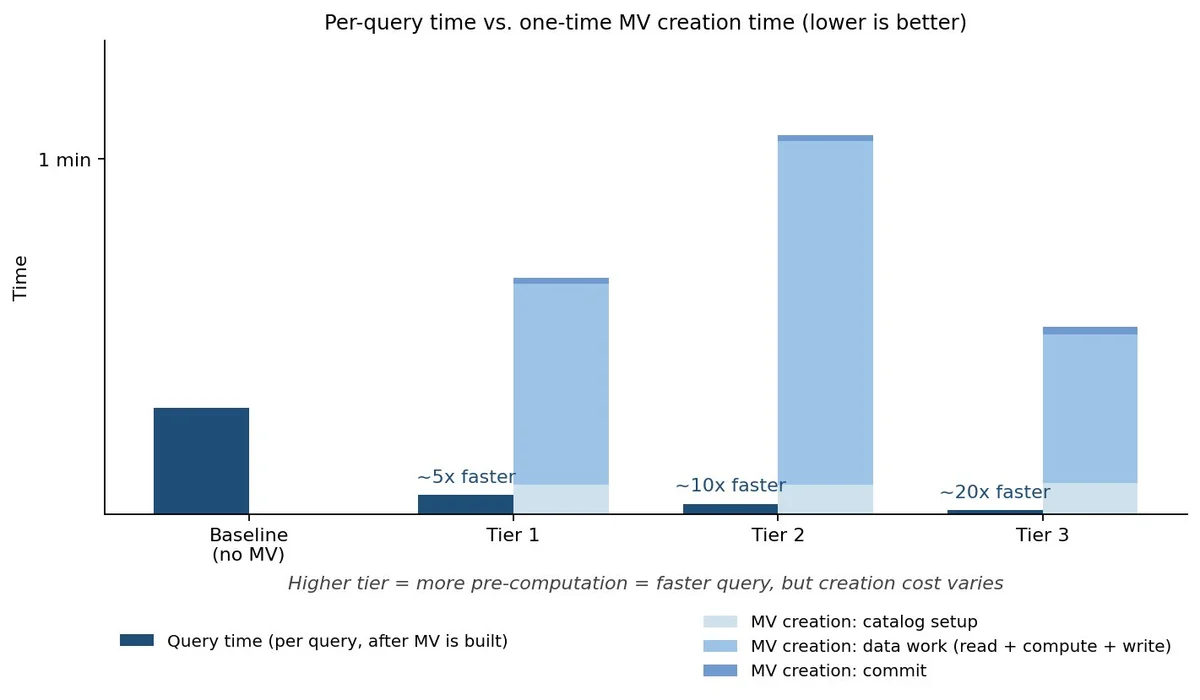
Iceberg materialized views를 이용한 Spark 쿼리 가속화 Apache Spark 분석 쿼리가 Apache Iceberg 테이블에서 느리고 반복적인 경우, SQL을 다시 작성할 필요 없이 가속화하십시오. 이 게시물에서는 Amazon EMR 및 AWS Glue의 자동 쿼리 재작성이 AWS Glue Data Catalog의 Iceberg materialized views를 사용하여 일치하는 쿼리 계획을 투명하게 대체하는 방법과 최상의 속도 향상을 위해 materialized views를 설계하는 방법을 보여줍니다. Accelerating Spark queries with Iceberg materialized views aws.amazon.com +1
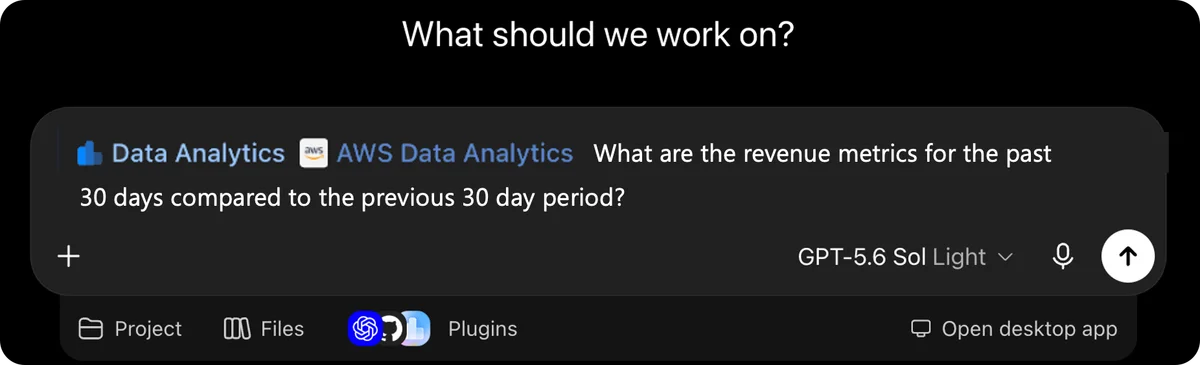
모든 팀은 데이터 팀입니다 — Amazon Redshift 분석을 ChatGPT Work에 도입하세요 AWS는 새로운 Data agent for ChatGPT Work를 위한 AWS Data Analytics 플러그인을 발표합니다. 팀은 자연어로 질문하고, Amazon Redshift 데이터 웨어하우스 및 데이터 레이크 전반의 거버넌스된 데이터를 분석하며, ChatGPT Work 대화에서 바로 공유 가능한 대시보드를 구축할 수 있습니다. Every team is a data team — bring Amazon Redshift analytics to ChatGPT Work aws.amazon.com +1
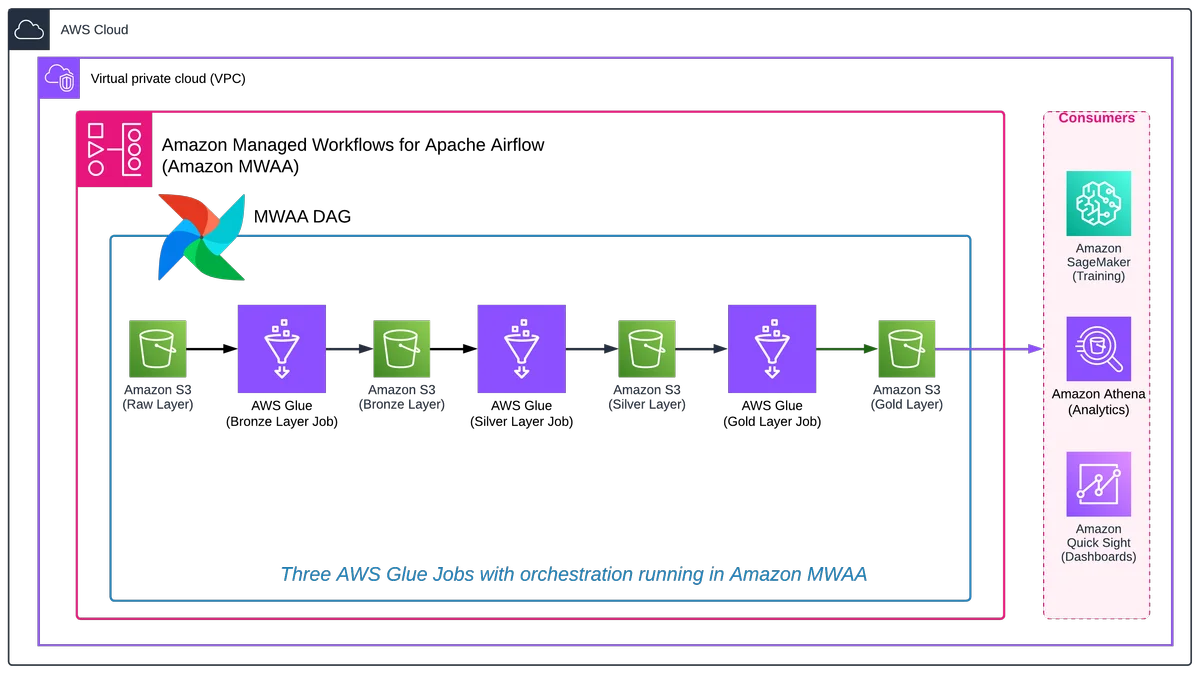
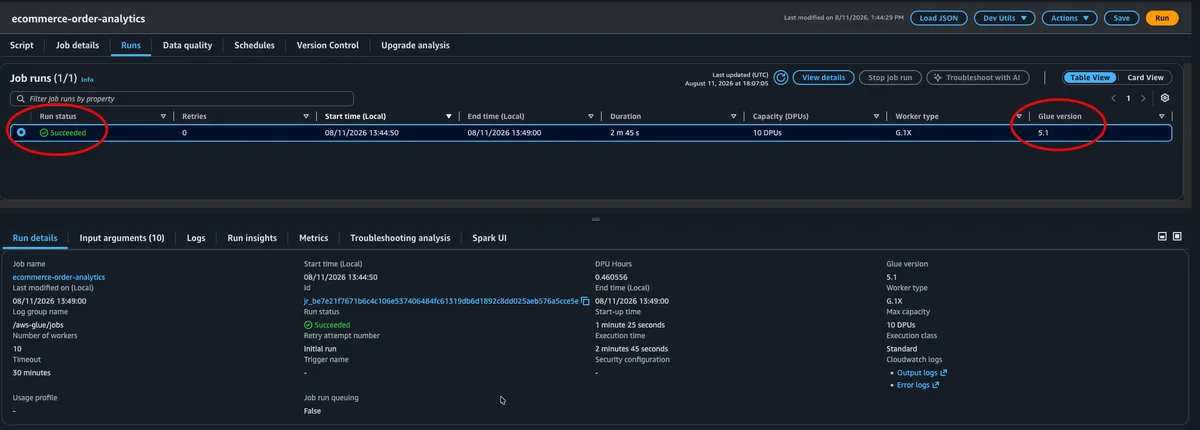
AWS Glue 6.0으로 선언형 ETL 파이프라인을 구축하세요 AWS Glue 6.0은 Spark 선언형 파이프라인을 도입합니다. 이 게시물에서는 오케스트레이션 로직을 작성하지 않고도 브론즈, 실버, 골드 시퀀스를 통해 원시 주문 레코드를 검증되고 집계된 테이블로 변환하는 단일 선언형 AWS Glue 6.0 작업을 구축합니다. Build declarative ETL pipelines with AWS Glue 6.0 aws.amazon.com +1
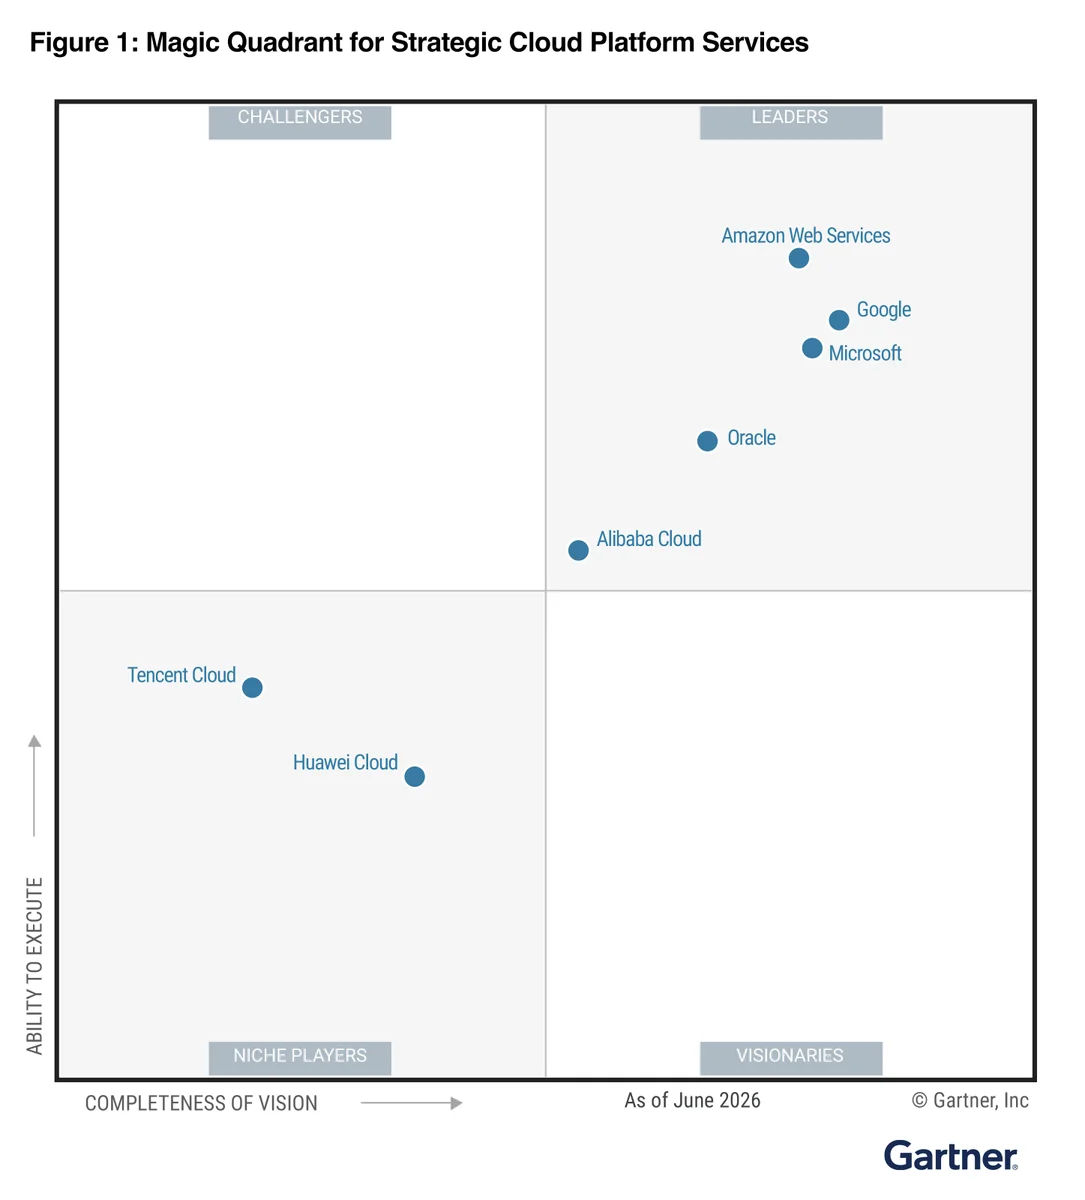
AWS, 16년 연속 2026 Gartner Magic Quadrant for Strategic Cloud Platform Services에서 리더로 인정받다 9월 1일, 가트너는 전략적 클라우드 플랫폼 서비스(SCPS)에 대한 매직 쿼드런트를 발표했습니다. Amazon Web Services(AWS)는 이 매직 쿼드런트에서 가장 오래된 리더이며, 가트너는 AWS를 16년 연속 리더로 선정했습니다. 보고서에서 가트너는 다시 한번 AWS를 실행 능력(Ability to Execute) 축에서 가장 높은 곳에 배치했습니다. 우리는 이것이 고객들이 더 빠르게 혁신하고, 더 안전하게 운영하며, 어떤 규모로든 구축할 수 있도록 돕겠다는 우리의 약속을 반영한다고 믿습니다. 특히 에이전트 AI가 프로덕션 준비가 된 데이터 기반에 대한 필요성을 증대시키고 있습니다. AWS recognized as a Leader in the 2026 Gartner Magic Quadrant for Strategic Cloud Platform Services for the 16th consecutive year aws.amazon.com +1
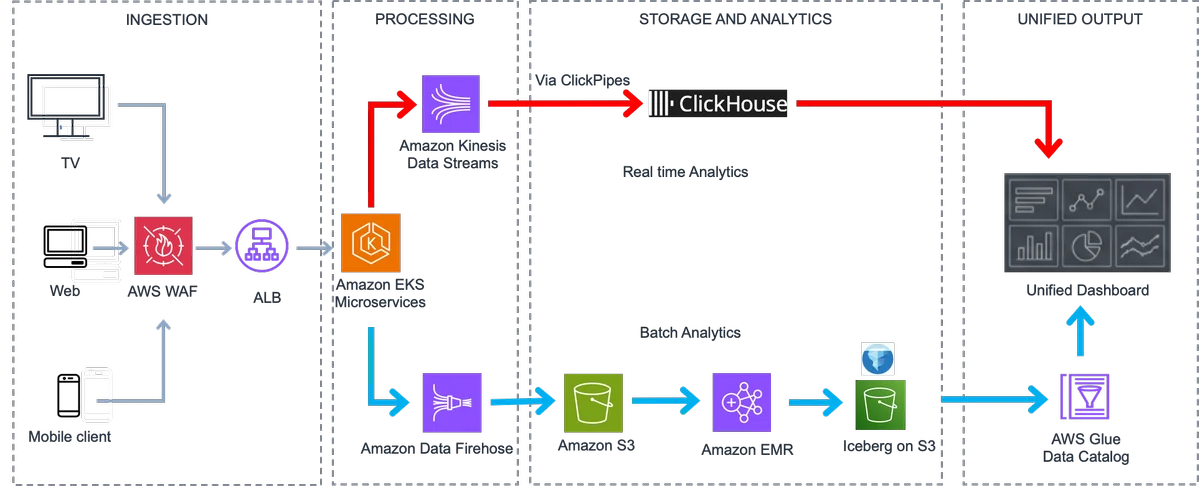
Sony LIV가 AWS로 실시간 비디오 스트리밍 분석을 구축한 방법 실시간 데이터 분석은 스트리밍 플랫폼이 시청자에게 서비스를 제공하는 방식을 변화시키고 있습니다. Sony LIV가 Amazon Kinesis Data Streams, Amazon EMR 및 Apache Iceberg를 사용하여 AWS에서 포괄적인 실시간 스트리밍 분석 솔루션을 구축한 방법을 알아보세요. How Sony LIV built real-time video streaming analytics with AWS aws.amazon.com +1
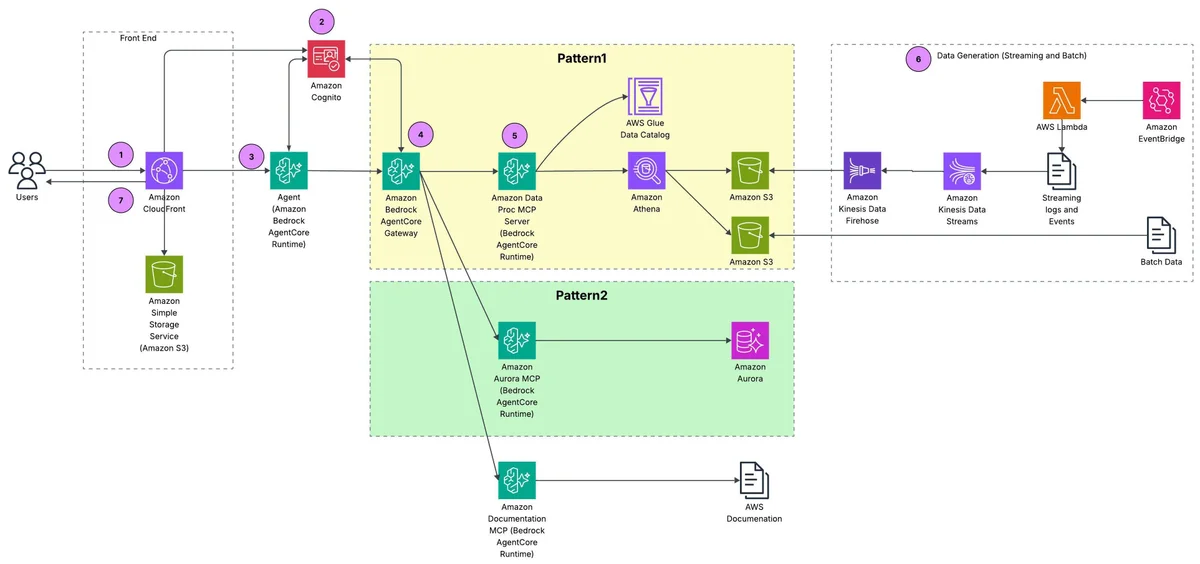
사일로에서 인사이트로: AI 에이전트를 위한 연합 데이터 액세스 패턴 AI 에이전트는 모든 질문을 데이터 엔지니어를 통해 라우팅하는 대신, 데이터가 있는 엔터프라이즈 데이터에 접근할 수 있습니다. 이 게시물은 Model Context Protocol (MCP) 서버와 Amazon Bedrock AgentCore를 사용한 연합 데이터 액세스를 위한 세 가지 참조 패턴, 즉 카탈로그 우선, 직접 소스, 하이브리드 액세스를 제시합니다. From silos to insights: Federated data access patterns for AI agents aws.amazon.com +1
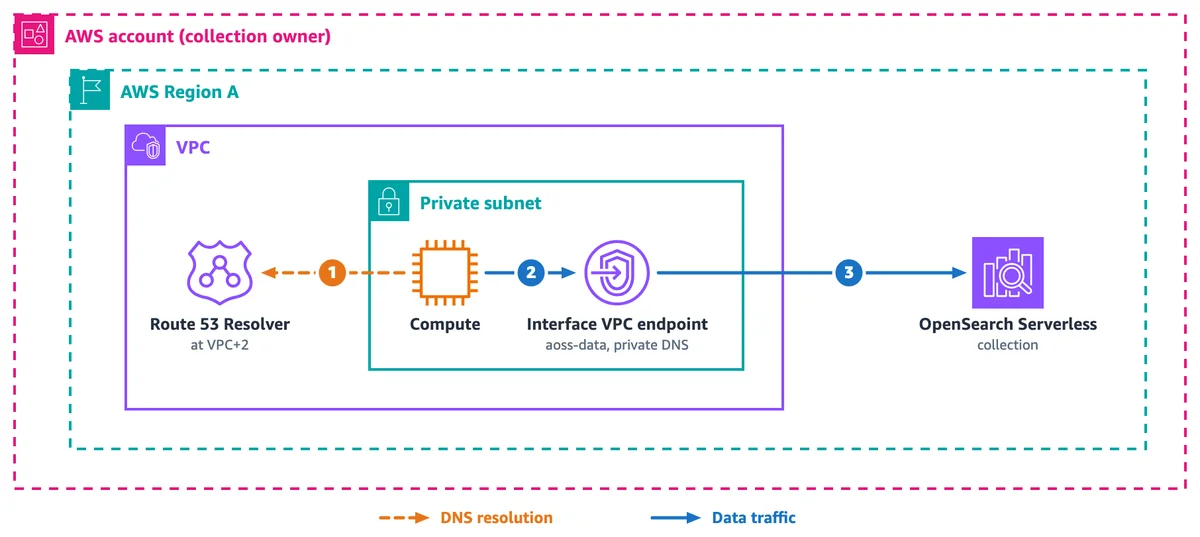
차세대 Amazon OpenSearch Serverless를 위한 네트워크 연결 패턴 차세대 Amazon OpenSearch Serverless는 on.aws 도메인의 표준 AWS PrivateLink 엔드포인트를 사용합니다. 이 게시물에서는 단일 VPC에서 여러 VPC, 계정 간, 온프레미스, 리전 간 연결에 이르기까지 9가지 프라이빗 액세스 연결 패턴과 각 패턴에 대한 DNS 확인 및 데이터 경로를 보여줍니다. Network connectivity patterns for the next generation of Amazon OpenSearch Serverless aws.amazon.com +1
Moovit, 아키텍처 현대화를 통해 33% 비용 최적화를 달성한 방법 Moovit이 Amazon Redshift에서 Amazon EMR with Spark SQL로 무거운 집계 워크로드를 오프로드하고, Amazon Redshift Serverless로 워크로드를 격리하며, 전반적인 데이터 파이프라인 비용을 33% 절감하여 멀티 엔진 레이크하우스 아키텍처로 데이터 플랫폼을 현대화한 방법을 알아보세요. How Moovit achieved 33% cost optimization through architectural modernization aws.amazon.com +1
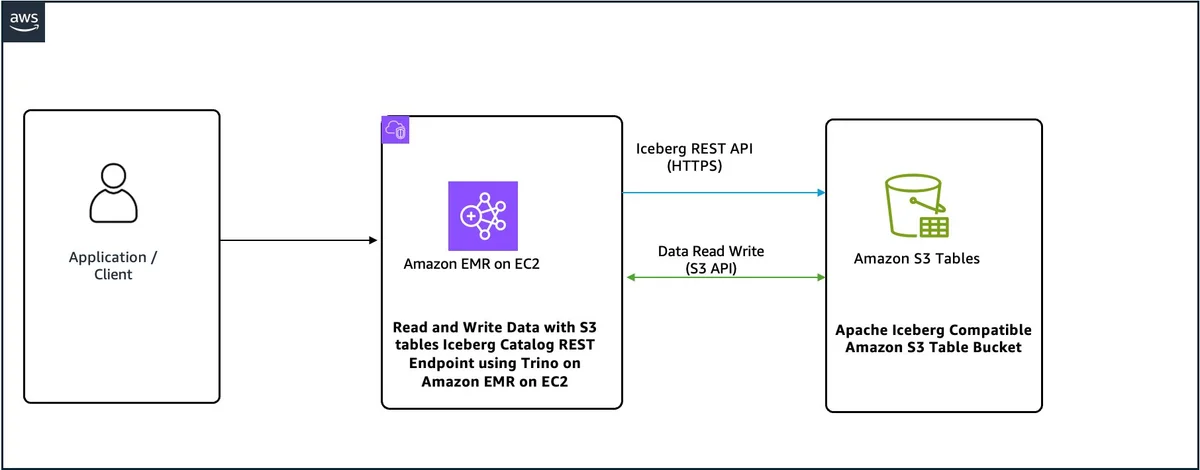
Amazon EMR Trino를 사용하여 Iceberg REST 엔드포인트를 통해 Amazon S3 테이블 쿼리 Amazon EMR의 Trino에서 Apache Iceberg REST 카탈로그 엔드포인트를 사용하여 Amazon S3 테이블을 쿼리하는 방법을 알아보세요. 이 게시물에서는 AWS CloudFormation으로 통합을 배포하고, Trino 카탈로그를 구성하고, Apache Iceberg 테이블을 생성, 쿼리 및 관리하는 SQL을 실행하는 방법을 보여줍니다. Query Amazon S3 Tables from Amazon EMR Trino using the Iceberg REST endpoint aws.amazon.com +1
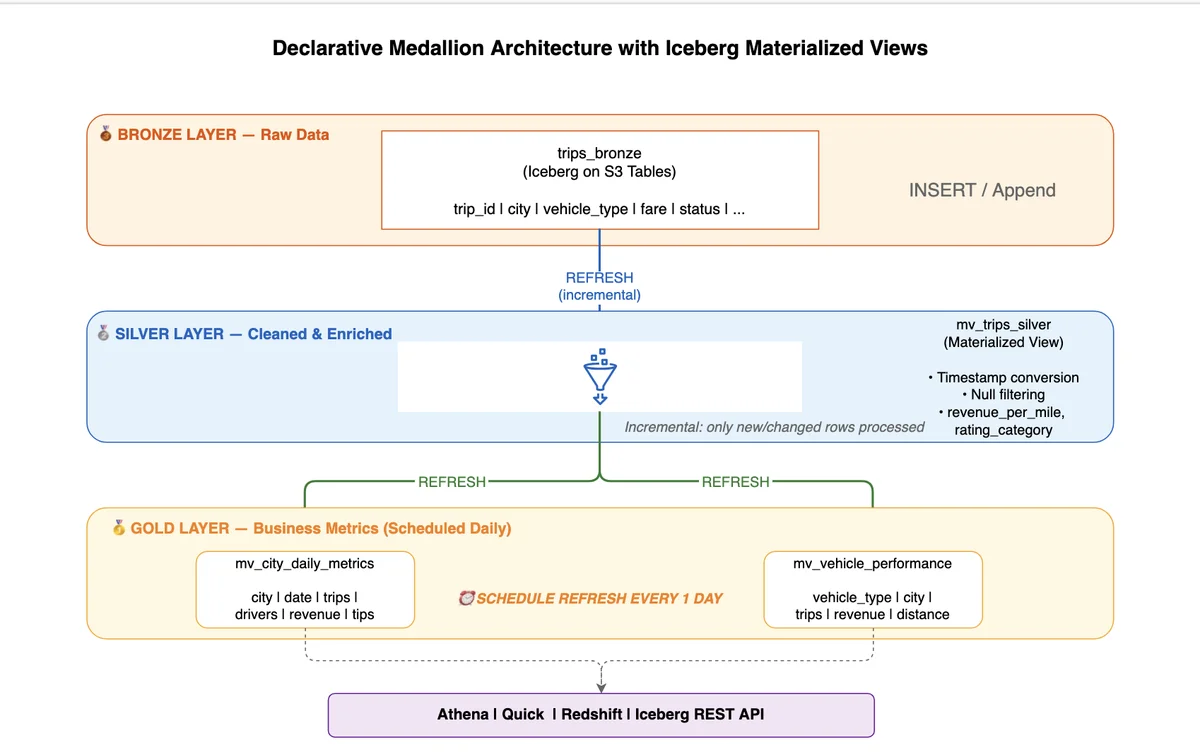
Amazon SageMaker에서 Iceberg materialized views를 사용하여 메달리온 아키텍처 구축 Amazon SageMaker의 Apache Iceberg materialized views를 사용하면 세 개의 SQL 문으로 Bronze, Silver, Gold 메달리언 아키텍처를 구축할 수 있습니다. 이 선언적 접근 방식은 변환, 오케스트레이션 및 증분 처리를 각 계층 정의에 통합하며, 유지 관리해야 할 ETL 작업, 오케스트레이터 또는 변경 데이터 캡처 코드가 없습니다. Building medallion architecture with Iceberg materialized views in Amazon SageMaker aws.amazon.com +1
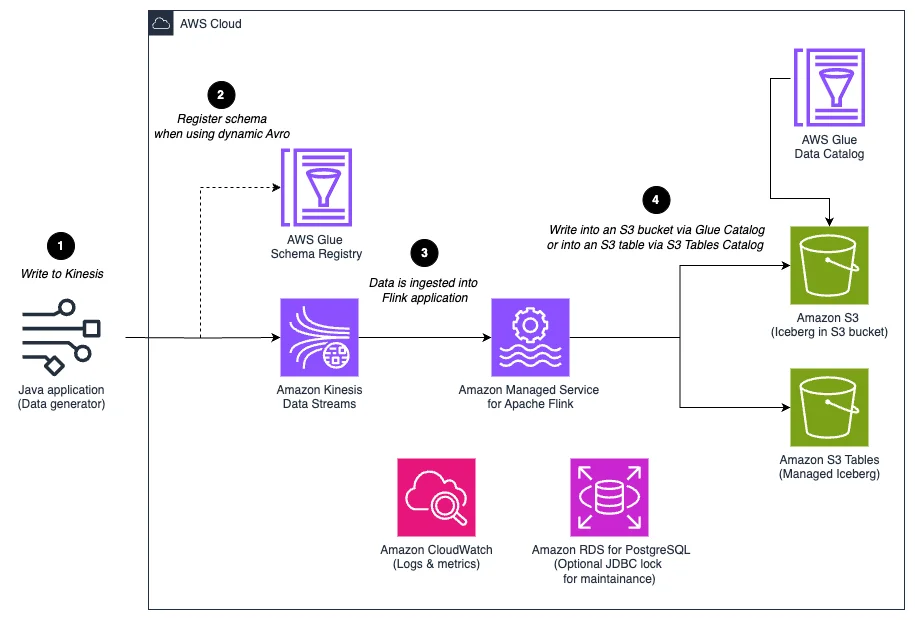
Apache Iceberg와 Apache Flink로 동적 스트리밍 데이터 레이크 구축하기 Amazon Managed Service for Apache Flink에서 동적 스트리밍 데이터 레이크를 구축하는 방법을 알아보세요. 이 데이터 레이크는 Apache Iceberg의 레코드별 테이블 라우팅 및 자동 스키마 진화를 위한 Dynamic Iceberg Sink를 사용하여 파이프라인을 중지하지 않고 새로운 이벤트 유형 및 스키마 변경에 적응합니다. Build a dynamic streaming data lake with Apache Iceberg and Apache Flink aws.amazon.com +1
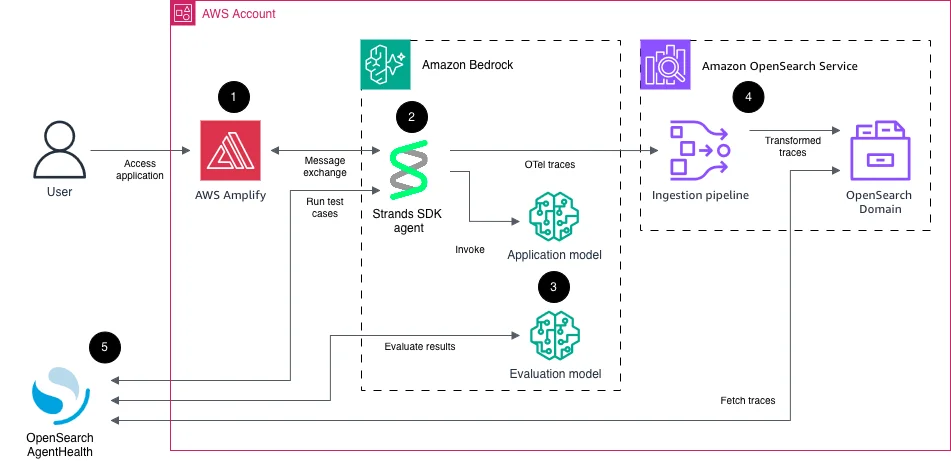
OpenSearch Agent Health를 이용한 프로덕션 에이전트 관찰 및 평가 AWS에서 실행되는 에이전트와 OpenSearch Agent Health를 결합하여 프로덕션 AI 에이전트를 관찰하고 평가하는 방법을 알아보세요. 이 게시물에서는 에이전트와 해당 관찰 가능성 파이프라인을 AWS에 배포한 다음, Agent Health를 사용하여 트레이스를 탐색하고 시간이 지남에 따라 에이전트 품질을 측정하고 개선하는 평가를 실행하는 과정을 안내합니다. Observing and evaluating production agents using OpenSearch Agent Health aws.amazon.com +1
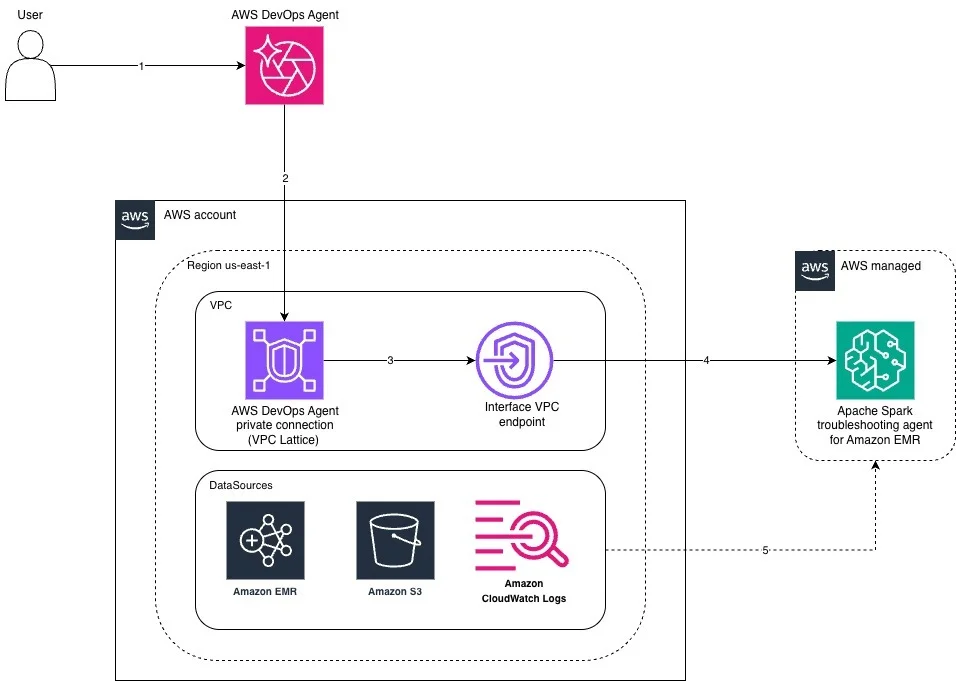
AWS DevOps Agent를 사용하여 Amazon EMR에서 Apache Spark 디버깅을 가속화하세요 Amazon EMR의 Apache Spark 실패를 조사하기 위해 AWS DevOps Agent를 확장합니다. 이 게시물에서는 Amazon EMR용 Apache Spark 문제 해결 Agent를 AWS PrivateLink를 통해 사용자 지정 MCP 기능 제공자로 등록하는 방법을 보여줍니다. 이를 통해 단일 Agent 채팅 세션으로 Amazon CloudWatch 경고부터 줄 번호가 있는 근본 원인까지 실패하는 Spark 작업을 진단할 수 있습니다. Accelerate Apache Spark debugging on Amazon EMR with AWS DevOps Agent aws.amazon.com +1
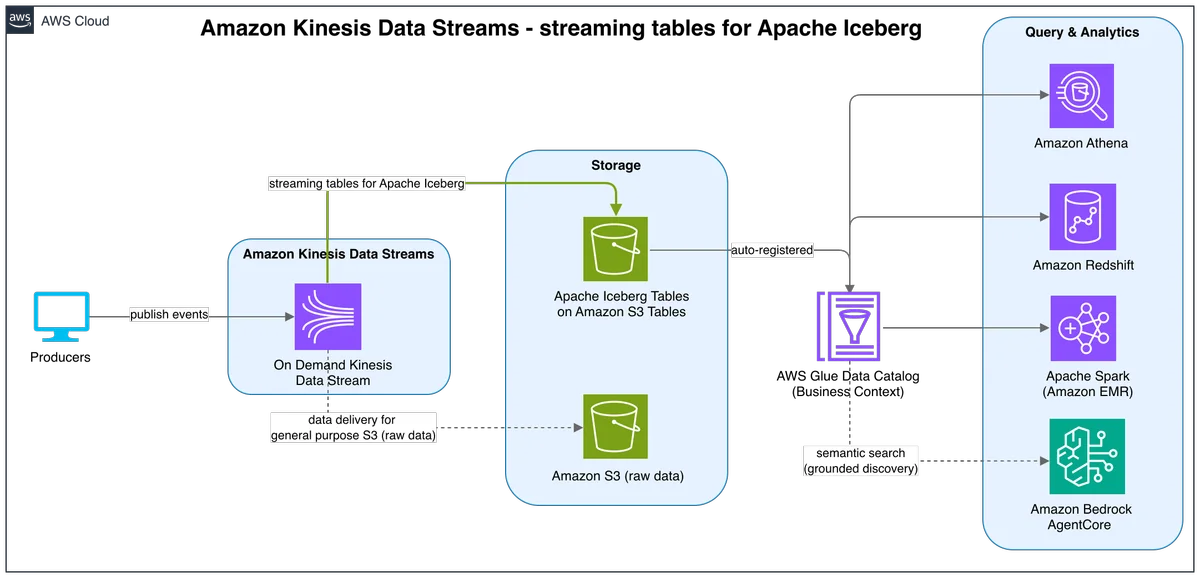
Amazon Kinesis Data Streams를 사용하여 Apache Iceberg의 스트리밍 테이블로 실시간 데이터 제공 Amazon Kinesis Data Streams가 이제 스트리밍 테이블을 지원합니다. 스트리밍 테이블은 스트리밍 데이터를 Amazon S3 테이블에 쿼리 가능한 Apache Iceberg 테이블로 지속적으로 제공하는 완전 관리형 기능입니다. 스트리밍 테이블은 인라인 컴팩션을 통해 운영할 인프라 없이도 제공 비용을 최대 25%, 쿼리 비용을 최대 30%까지 절감합니다. Deliver real-time data to streaming tables for Apache Iceberg with Amazon Kinesis Data Streams aws.amazon.com +1
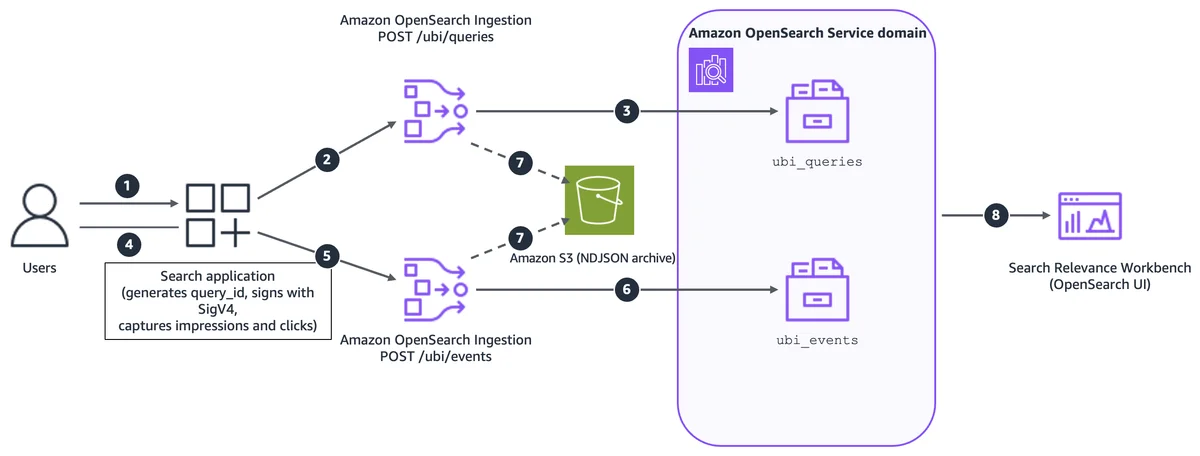
Amazon OpenSearch Service를 이용한 검색 품질 측정 및 개선 대부분의 팀은 매우 단순해 보이는 질문에 답하는 데 어려움을 겪습니다. 바로 "내 검색이 관련성 있는 결과를 반환하는가?"입니다. 이 게시물에서는 Amazon OpenSearch Service에서 사용자 행동 인사이트(UBI) 데이터를 캡처하고 검색 관련성 워크벤치(SRW)를 사용하여 이러한 신호를 관련성 판단으로 전환하고 검색 품질을 평가하는 방법을 보여줍니다. Measuring and improving search quality with Amazon OpenSearch Service aws.amazon.com +1
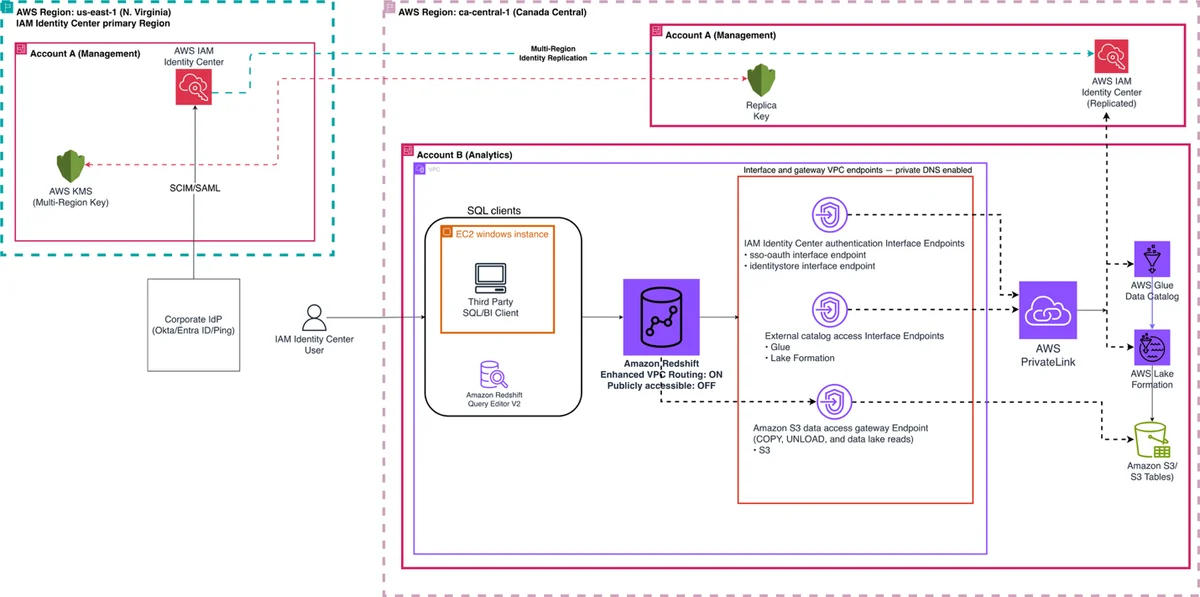
향상된 VPC 라우팅을 통해 Amazon Redshift와 IAM Identity Center 통합 Amazon Redshift는 이제 향상된 VPC 라우팅을 사용하는 클러스터 및 워크그룹에서 AWS IAM Identity Center 인증을 지원합니다. 사용자가 기업 자격 증명으로 싱글 사인온을 이용할 수 있도록 두 개의 인터페이스 VPC 엔드포인트를 생성하여 모든 인증 트래픽을 AWS 프라이빗 네트워크에 유지하십시오. Integrate Amazon Redshift and IAM Identity Center with enhanced VPC routing aws.amazon.com +1
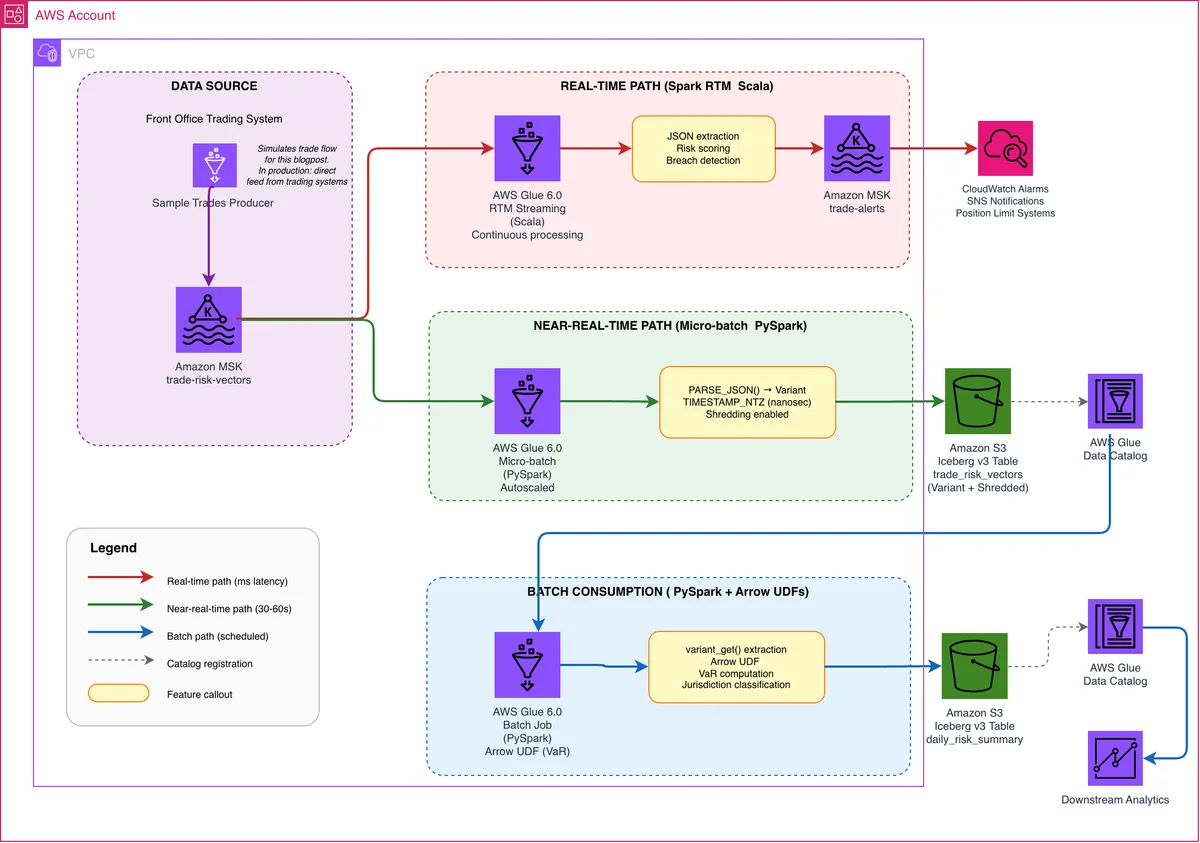
AWS Glue 6.0의 Spark 실시간 모드를 사용하여 실시간 이벤트 파이프라인 구축 AWS Glue 6.0을 사용하면 단일 플랫폼에서 실시간, 거의 실시간, 배치 데이터 파이프라인을 구축할 수 있습니다. 금융 시장 위험 예제를 사용하여 Spark 실시간 모드로 초당 미만의 지연 시간으로 고위험 거래를 플래그 지정하는 방법, Apache Iceberg v3 Variant 열을 사용하여 이기종 가격 벡터를 저장하는 방법, Arrow 네이티브 UDF로 배치 분석을 실행하는 방법을 알아보세요. Build a real-time event pipeline with Spark Real-Time Mode on AWS Glue 6.0 aws.amazon.com +1
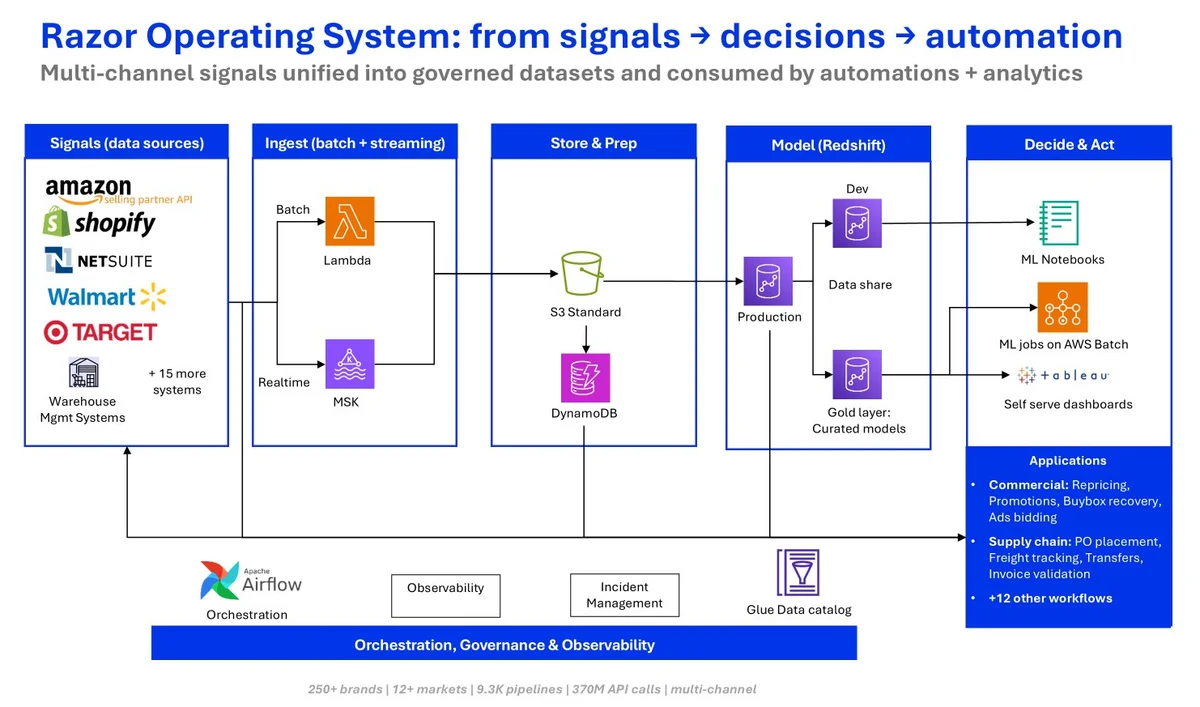
AWS에서 Razor Group의 현대적인 데이터 레이크하우스로의 여정 유럽의 선도적인 전자상거래 애그리게이터 중 하나로 250개 이상의 브랜드를 관리하는 Razor Group은 항상 켜져 있는 Amazon Redshift 클러스터에서 Apache Iceberg, Amazon S3 Tables 및 Apache Spark 기반의 오픈 레이크하우스로 마이그레이션했습니다. 아키텍처 결정, 5단계 마이그레이션 및 결과: P95 쿼리 65% 향상 및 인프라 비용 63% 절감을 알아보세요. Razor Group’s journey to a modern data lakehouse on AWS aws.amazon.com +1
Picnic이 Amazon MQ에 여러 OAuth 공급자를 구성한 방법 Picnic은 Amazon MQ for RabbitMQ에서 수백 개의 마이크로서비스를 위한 메시징 백본으로 RabbitMQ를 실행합니다. 이 게시물에서는 운영자를 위한 Keycloak과 서비스를 위한 AWS IAM을 위해 여러 OAuth 2.0 ID 공급자를 신뢰하도록 하나의 브로커를 구성하는 방법을 보여주며, 이를 통해 사람과 워크로드에 대한 별도의 ID 경로를 유지하면서 정적 자격 증명을 제거할 수 있습니다. How Picnic configured multiple OAuth providers for Amazon MQ aws.amazon.com +1
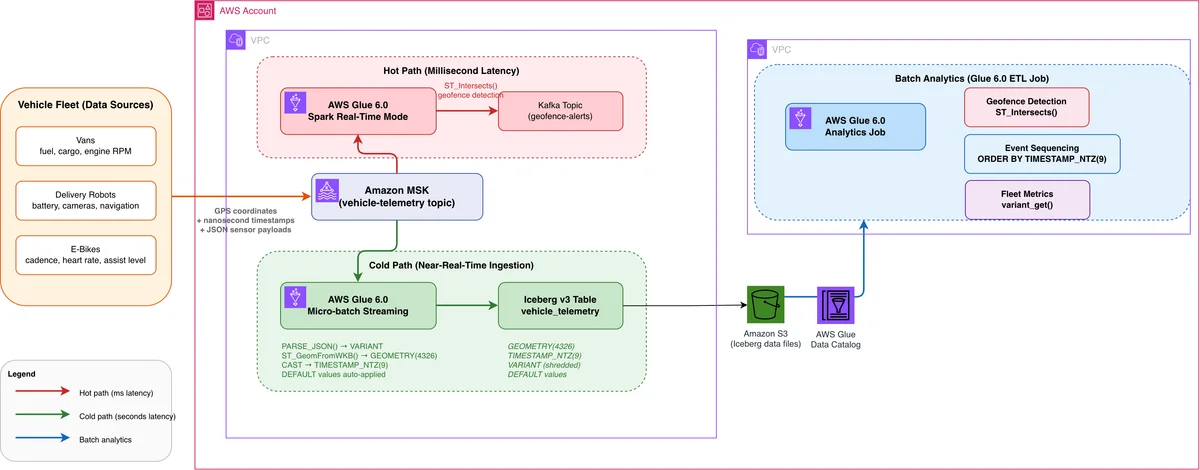
AWS Glue 6.0의 Iceberg v3에서 지리공간 및 변형 타입으로 빌드 Apache Spark 4.1을 탑재한 AWS Glue 6.0은 Apache Iceberg v3에 대한 지원을 추가합니다: 네이티브 지리공간 유형, 나노초 정밀도 타임스탬프, VARIANT 유형 및 DEFAULT 열 값. 이 게시물은 수집부터 공간, 나노초 및 변형 쿼리까지 단일 Iceberg v3 테이블에서 네 가지 모두를 사용하는 연결된 차량 함대 원격 측정 파이프라인을 구축합니다. Build with geospatial and variant types in Iceberg v3 on AWS Glue 6.0 aws.amazon.com +1
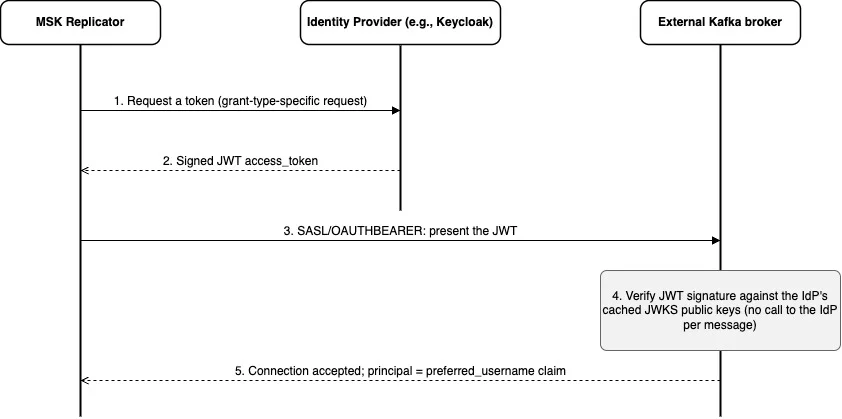
MSK Replicator를 사용하여 OAuth 2.0 인증 Apache Kafka 클러스터를 Amazon MSK로 마이그레이션 MSK Replicator가 이제 외부 Apache Kafka 클러스터에 대한 OAuth 2.0 (SASL/OAUTHBEARER) 인증을 지원합니다. 이 게시물에서는 지원되는 세 가지 grant 유형, 각 유형에 대해 Replicator를 구성하는 방법, 일반적으로 놓치는 네트워크 및 TLS 필수 구성 요소, 추가 페더레이션 계층 뒤에 있는 ID 공급자를 처리하는 방법을 살펴봅니다. Migrate an OAuth 2.0 authenticated Apache Kafka cluster to Amazon MSK with MSK Replicator aws.amazon.com +1
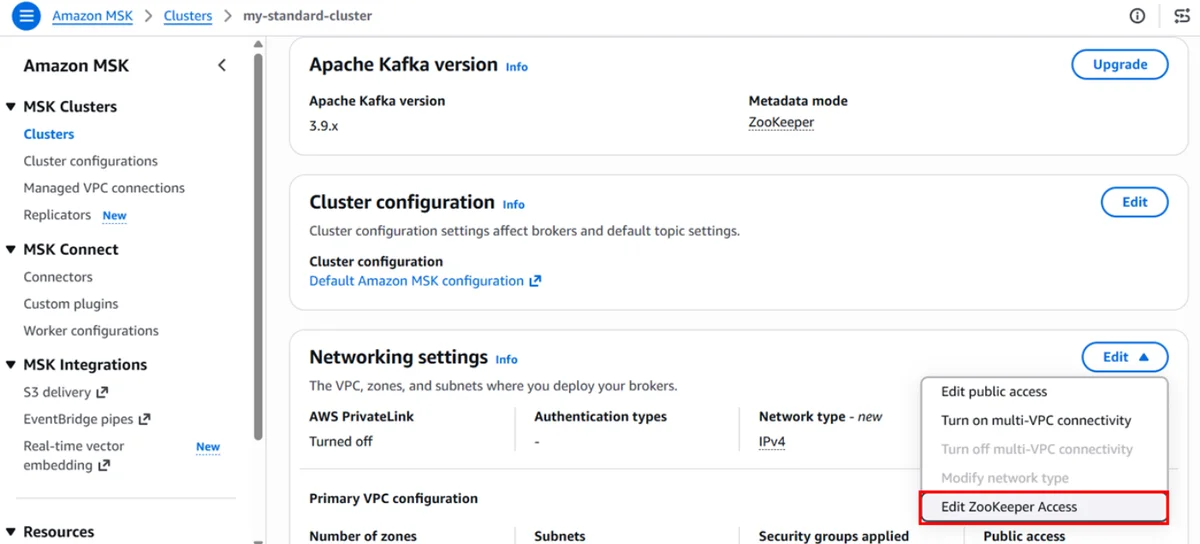
Amazon MSK의 인플레이스 ZooKeeper-to-KRaft 클러스터 업그레이드 발표 Amazon MSK가 이제 ZooKeeper에서 KRaft 메타데이터 모드로의 인플레이스 업그레이드를 지원합니다. 새로운 클러스터를 프로비저닝하거나 데이터 마이그레이션 없이 익숙한 버전 업그레이드 워크플로우를 통해 기존 클러스터의 메타데이터 관리를 현대화할 수 있습니다. 이 게시물에서는 사전 요구 사항과 단계별 업그레이드 프로세스를 다룹니다. Announcing in-place ZooKeeper-to-KRaft cluster upgrades for Amazon MSK aws.amazon.com +1
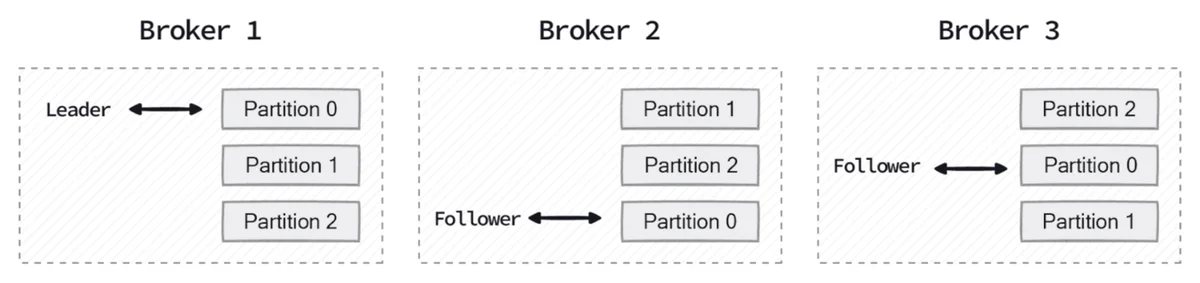
Amazon MSK 서비스 101: Amazon MSK 토픽은 파티션이 몇 개 필요할까요? Amazon MSK 토픽은 몇 개의 파티션이 필요할까요? 올바른 파티션 수를 선택하는 것은 처리량, 확장성 및 운영 복잡성에 영향을 미칩니다. 이 게시물은 파티션당 처리량, 소비자 병렬 처리, 파티션 키 및 Amazon MSK 파티션당 브로커 지침을 다루는 파티션 크기 조정에 대한 실용적인 지침을 제공합니다. Amazon MSK Service 101: How many partitions does an Amazon MSK topic need? aws.amazon.com +1
AWS와 DuckLabs: 함께 분석의 미래를 구축하다 오늘 아마존이 오픈소스 분석 데이터베이스 DuckDB의 개발사인 암스테르담 소재 기업 DuckLabs를 인수하는 확정 계약을 체결했음을 발표합니다. 관례적인 종결 조건에 따라 거래는 곧 완료될 것으로 예상됩니다. DuckDB를 개발하고 DuckLabs를 공동 창업한 Hannes Mühleisen과 Mark Raasveldt는 AWS의 일부로서 팀과 오픈소스 프로젝트의 기술 방향을 계속 이끌어갈 것입니다. DuckDB 오픈소스 프로젝트는 DuckLabs 팀에 의해 계속 추진될 것이며, 오늘날과 같이 독립적인 재단(DuckDB를 감독하는 비영리 단체) 하에서 오픈소스 상태를 유지하고 MIT 라이선스로 제공될 것입니다. AWS and DuckLabs: Building the future of analytics together aws.amazon.com +1
Amazon Managed Workflows for Apache Airflow(Amazon MWAA) 서버리스에서 PythonOperator 및 BashOperator 사용 가능 이제 Amazon MWAA Serverless 런타임에서 추가 인프라를 프로비저닝할 필요 없이 PythonOperator와 BashOperator를 사용하여 사용자 지정 Python 함수와 쉘 스크립트를 직접 실행할 수 있습니다. 이 게시물에서는 PythonOperator를 사용하여 CSV 파일을 JSON으로 변환하는 서버리스 파이프라인을 구축하고 BashOperator로 출력을 확인하는 과정을 안내합니다. PythonOperator and BashOperator Now Available on Amazon Managed Workflows for Apache Airflow (Amazon MWAA) Serverless aws.amazon.com +1
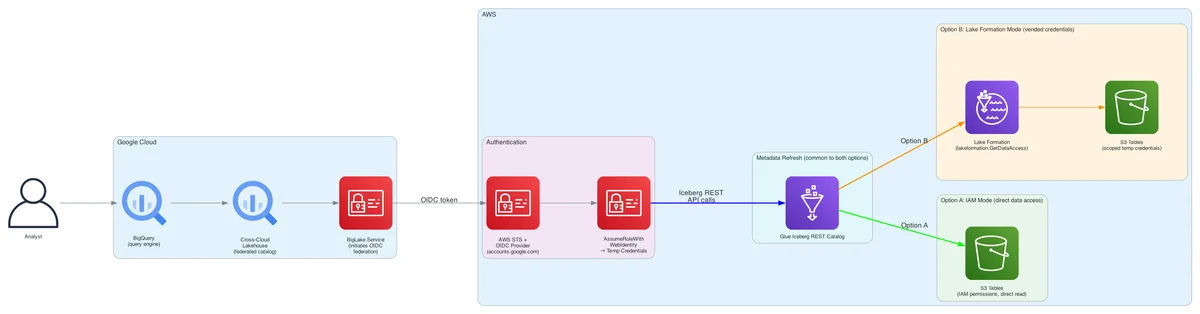
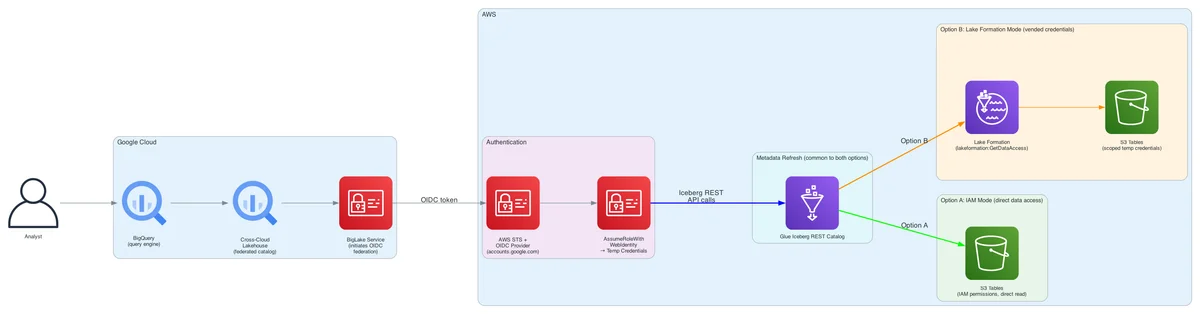
Amazon S3 Tables와 Google BigQuery를 이용한 크로스 클라우드 분석 활성화, 파트 1: IAM 기반 액세스 제어 Google BigQuery 사용자는 클라우드 간 복사 없이 AWS에 있는 Amazon S3 테이블의 데이터를 쿼리해야 합니다. 이 게시물에서는 IAM 기반 액세스 제어를 통해 AWS Glue Iceberg REST Catalog를 사용하여 BigQuery를 Amazon S3 테이블에 연결하는 방법을 보여주므로, 하나의 거버넌스된 데이터셋을 유지하고 BigQuery에서 실시간으로 쿼리할 수 있습니다. Enable cross-cloud analytics with Amazon S3 Tables and Google BigQuery, Part 1: IAM-based access control aws.amazon.com +1
Amazon S3 Tables와 Google BigQuery를 사용한 크로스 클라우드 분석, 파트 2: Lake Formation을 사용한 액세스 제어 이 시리즈의 파트 2에서는 AWS Lake Formation credential vending을 사용하여 Google BigQuery를 Amazon S3 테이블에 연결합니다. Lake Formation은 세분화된 권한을 관리하고 외부 엔진에 단기적이고 범위가 지정된 자격 증명을 발급하므로, 모든 소비자에 대한 IAM 정책을 관리하지 않고도 AWS에서 Iceberg 테이블을 읽는 팀과 쿼리 엔진을 중앙에서 제어할 수 있습니다. Enable cross-cloud analytics with Amazon S3 Tables and Google BigQuery, Part 2: access control with Lake Formation aws.amazon.com +1
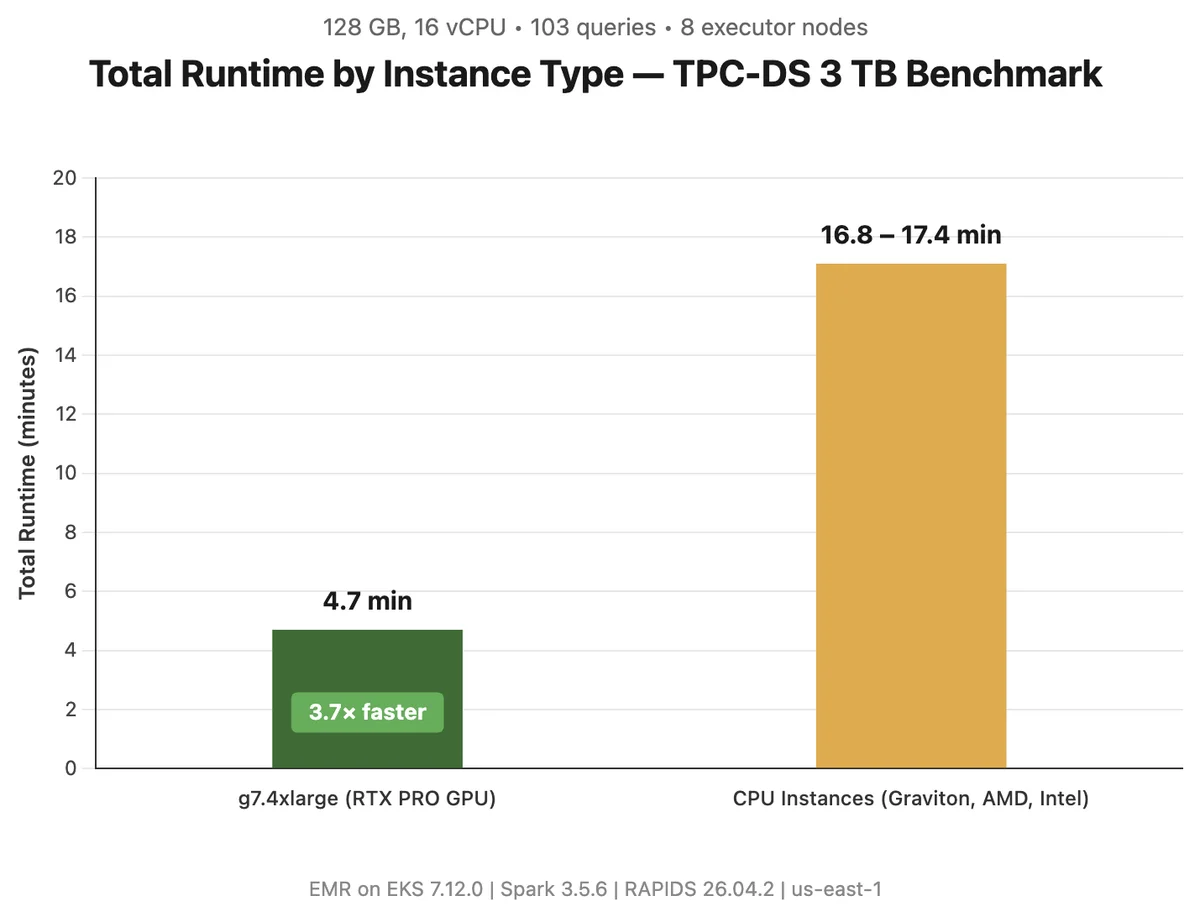
Amazon EMR과 NVIDIA RTX PRO 4500을 탑재한 Amazon EC2 G7 인스턴스에서 GPU 가속 Apache Spark를 사용하면 최대 3.7배 더 빠르게 실행됩니다. Amazon EKS 상의 Amazon EMR은 NVIDIA RTX PRO 4500 Blackwell GPU를 탑재한 Amazon EC2 G7 인스턴스에서 기존 Spark 코드 변경 없이 CPU 인스턴스 대비 최대 3.7배 더 빠르게 Apache Spark를 실행합니다. TPC-DS 벤치마크 결과, 비용 비교, 시작 방법을 확인하십시오. GPU-accelerated Apache Spark with Amazon EMR and NVIDIA RTX PRO 4500 on Amazon EC2 G7 instances runs up to 3.7x faster aws.amazon.com +1
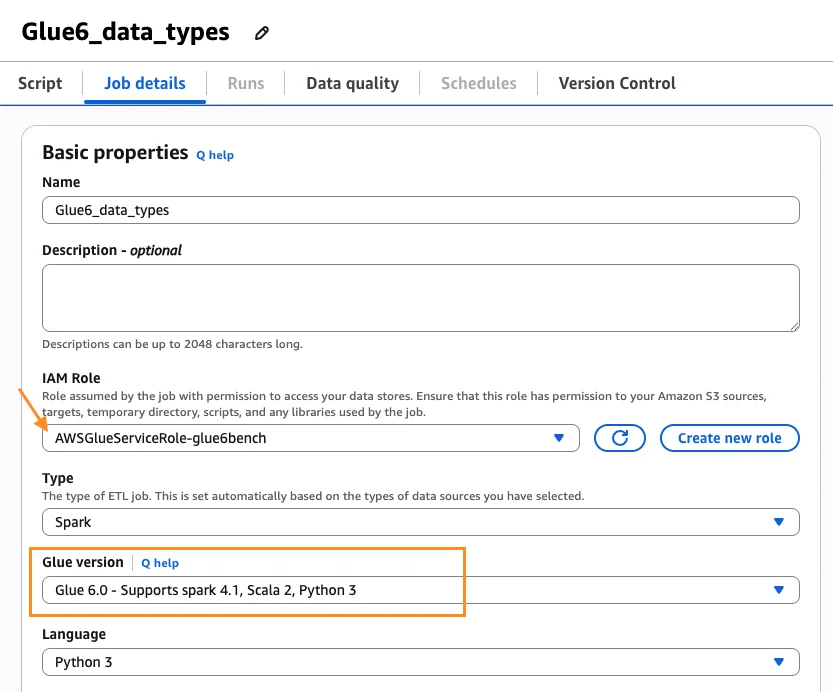
더 빠르고 비용 효율적인 데이터 통합을 위한 AWS Glue 6.0 소개 AWS Glue 6.0이 출시되어 AWS Glue 가격을 30% 인하하고, Apache Spark 4.1의 AWS 최적화 빌드를 추가했으며, 엔터프라이즈 채택에 적합한 Apache Iceberg V3 기능을 도입했습니다. 이 게시물에서는 주요 기능과 성능 이점을 다루고, 시작하는 데 도움이 되는 코드 예제를 제공합니다. Introducing AWS Glue 6.0 for faster and more cost-effective data integration aws.amazon.com +1
AI 기반 Spark 업그레이드를 통해 AWS Glue 작업을 Glue 6.0으로 업그레이드 Apache Spark를 위한 생성형 AI 업그레이드를 사용하여 AWS Glue 5.1에서 AWS Glue 6.0으로 PySpark ETL 작업을 업그레이드하는 과정을 살펴보세요. 업그레이드 분석은 비호환성을 자동으로 감지하고, 수정을 적용하며, 데이터 품질 검사를 통해 결과를 검증합니다. Upgrade AWS Glue jobs to Glue 6.0 with AI-powered Spark upgrades aws.amazon.com +1
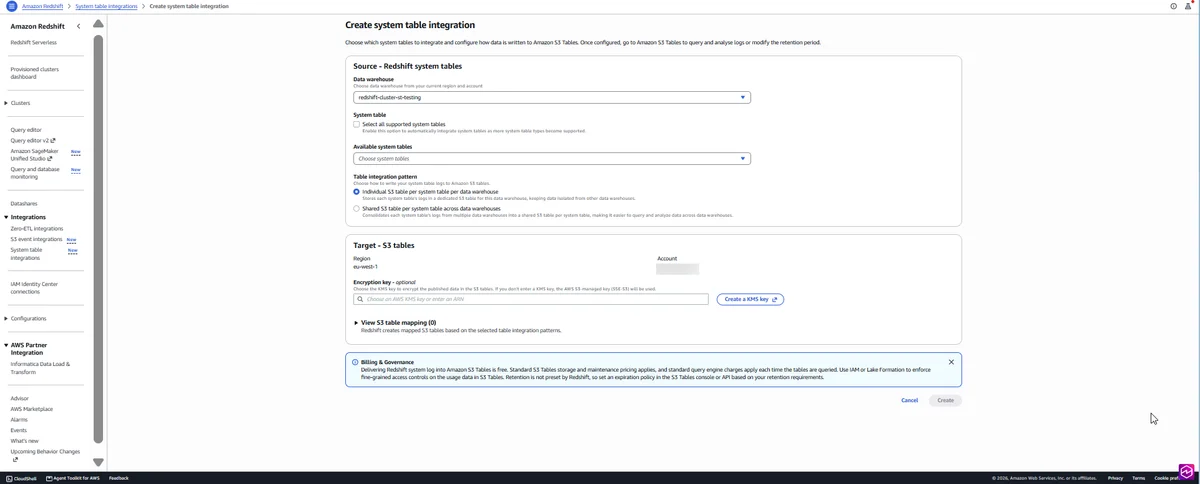
Amazon S3 테이블을 사용한 Amazon Redshift의 장기 시스템 테이블 보존 Amazon Redshift 시스템 테이블 통합은 Amazon S3 테이블에 Apache Iceberg 형식으로 시스템 테이블 로그를 자동으로 전달합니다. 맞춤형 ETL 파이프라인이나 클러스터 리소스 소비 없이도 규정 준수, 감사 및 크로스 웨어하우스 가시성을 위해 7일 제한을 훨씬 초과하여 이 데이터를 보존할 수 있습니다. Long-term system tables retention in Amazon Redshift with Amazon S3 Tables aws.amazon.com +1
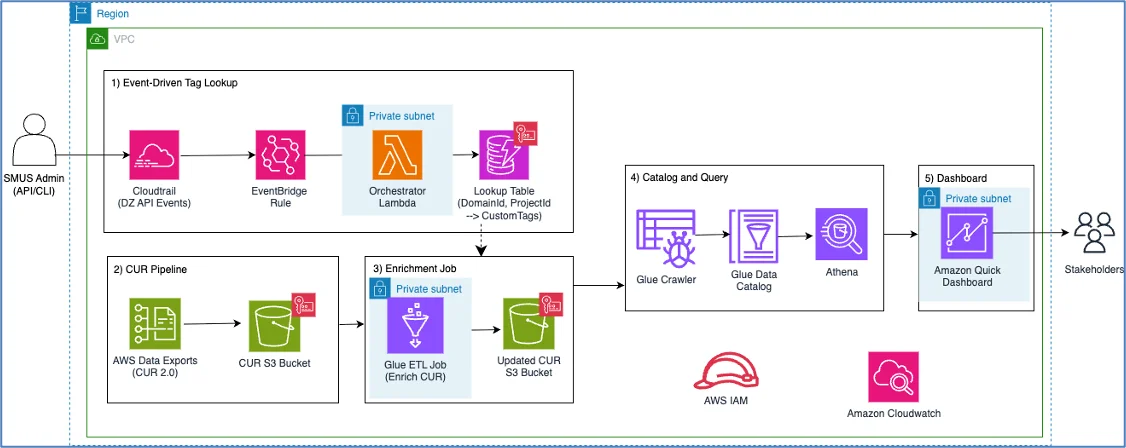
SageMaker Unified Studio 프로젝트 비용을 사용자 지정 태그 및 AWS CUR로 추적 사용자 지정 태그를 사용하여 Amazon SageMaker Unified Studio 프로젝트 비용을 추적하는 방법을 알아보세요. 이 서버리스 솔루션은 사용자 지정 프로젝트 태그로 AWS Cost and Usage Report(CUR) 데이터를 강화하고 Amazon Quick Sight 대시보드에서 CostCenter, Team 또는 Environment별로 비용을 시각화합니다. Track SageMaker Unified Studio project costs with custom tags and AWS CUR aws.amazon.com +1
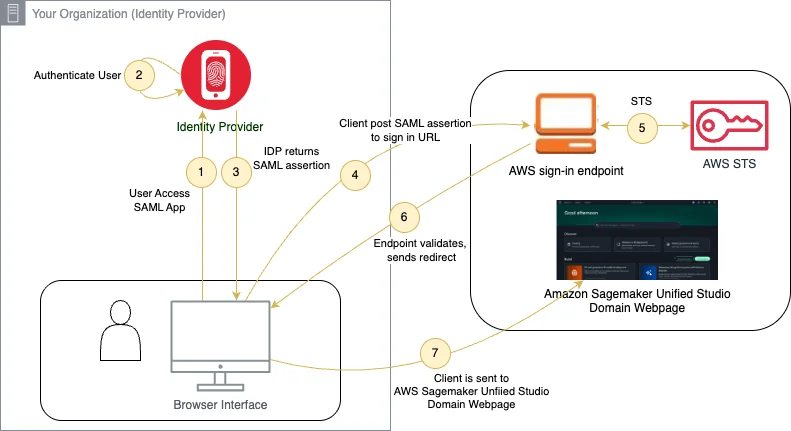
SAML 및 조건부 정책으로 SageMaker Unified Studio 액세스 보안 강화 Okta와 같은 외부 SAML ID 공급자와 통합하여 Amazon SageMaker Unified Studio를 안전하게 보호하는 방법을 알아보세요. 이 게시물에서는 데이터 및 AI 워크로드에 대한 장치 규정 준수, IP 기반 제한 및 다단계 인증을 시행하는 조건부 액세스 정책을 적용하는 방법을 보여줍니다. Secure SageMaker Unified Studio access with SAML and conditional policies aws.amazon.com +1
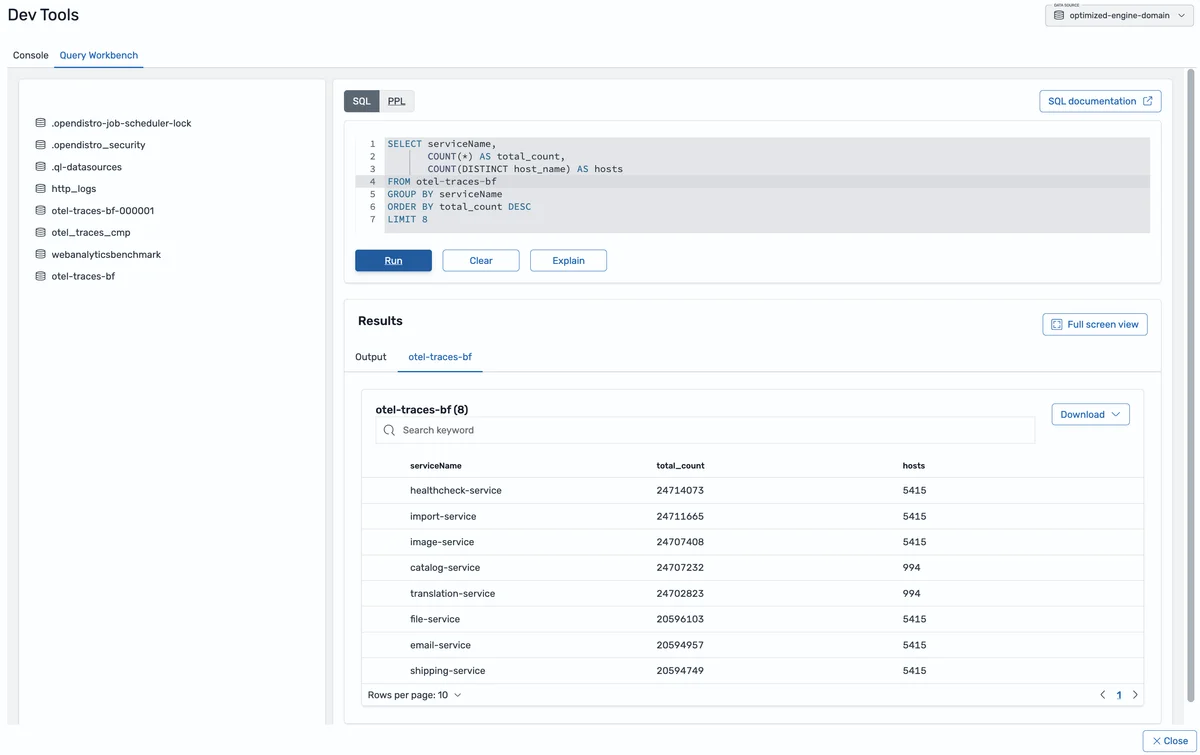
Amazon OpenSearch Service의 최적화된 엔진을 사용하여 SQL 및 PPL로 원시 로그 데이터를 쿼리 Amazon OpenSearch Service에서 PPL과 SQL을 사용하여 원시 로그 및 추적 데이터에 대해 직접 빠른 분석 쿼리를 실행하는 방법을 알아보세요. 단일 인시던트 조사를 쿼리별로 따라가면서 새로운 최적화된 엔진이 각 질문에 원시 스팬에서 직접 응답하는 것을 확인하세요. Querying raw log data using SQL and PPL with the optimized engine in Amazon OpenSearch Service aws.amazon.com +1
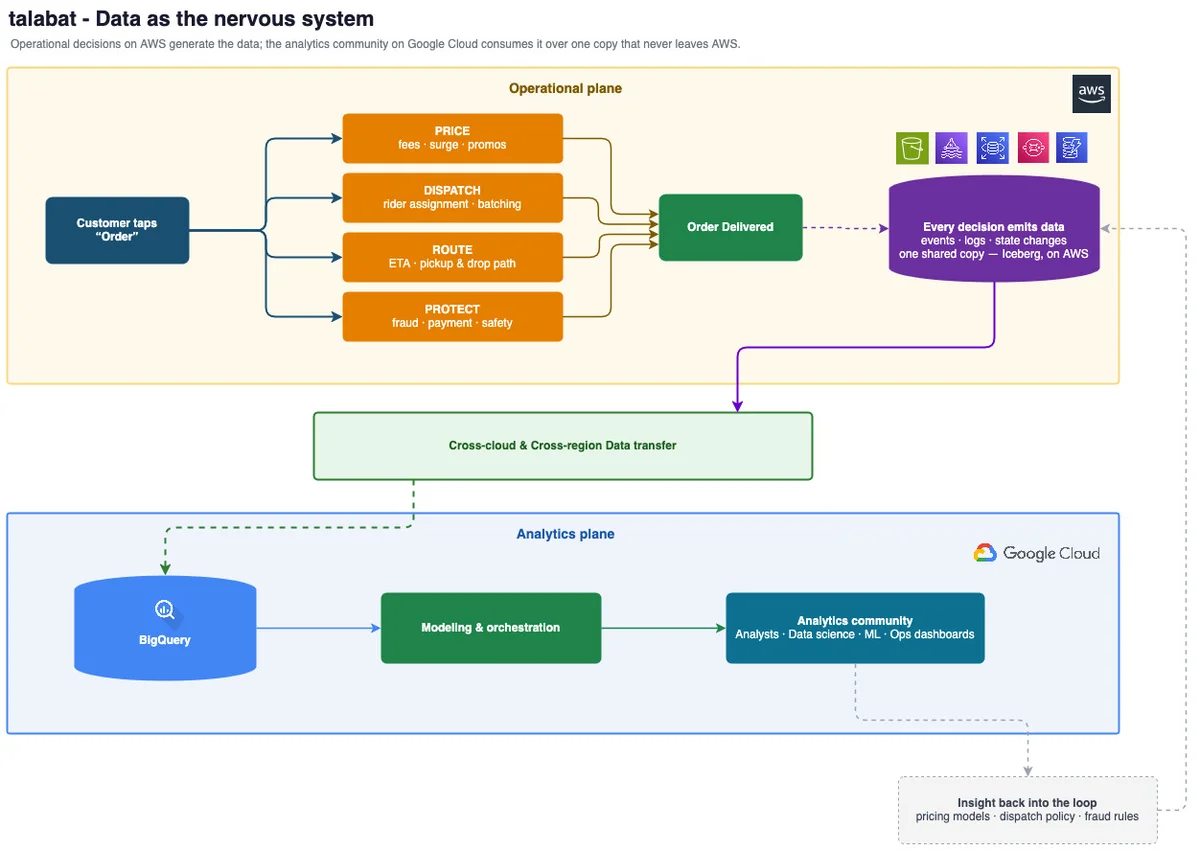
더 신선한 통찰력, 더 빠른 결정: AWS 및 Google Cloud 전반에 걸친 talabat의 거의 실시간 분석 중동 및 북아프리카 지역의 선도적인 일상 앱인 talabat은 Amazon S3 Tables에 스트리밍 데이터의 단일 Apache Iceberg 복사본을 유지하면서 Google BigQuery가 이를 제자리에서 쿼리할 수 있도록 하여 클라우드 간 데이터 중복 및 스키마 동기화 오버헤드를 제거하는 하이브리드 멀티 클라우드 레이크하우스를 구축했습니다. Fresher insights, faster decisions: talabat’s near-real-time analytics across AWS and Google Cloud aws.amazon.com +1
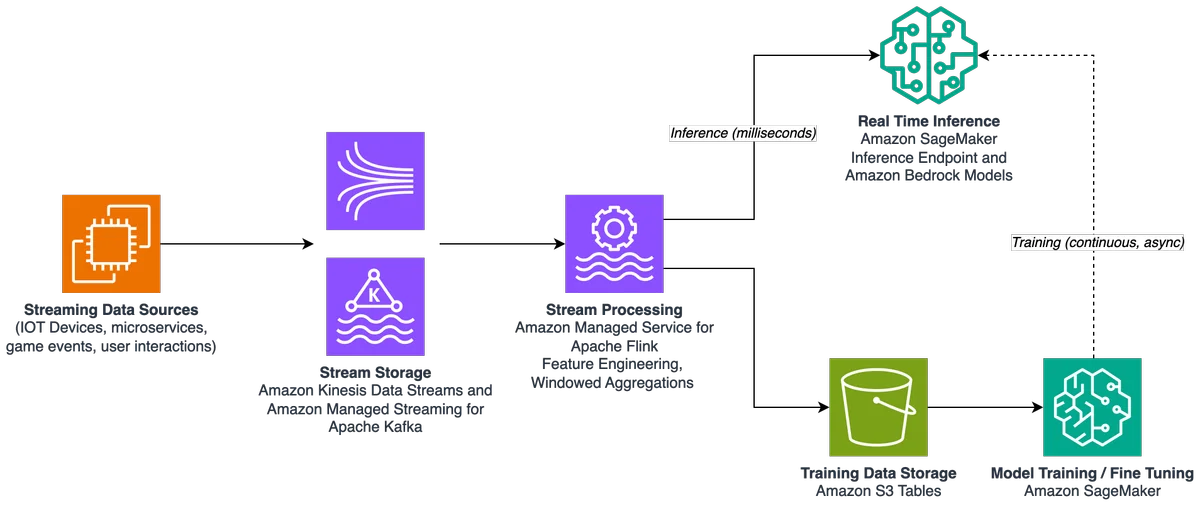
AWS에서 실시간 스트리밍 데이터로 에이전트 AI에 동력을 공급 Agentic AI 애플리케이션은 이제 프로덕션 환경에서 스트리밍 데이터를 관찰하고, 추론하며, 이에 기반하여 행동합니다. 본 게시물은 agentic AI 시대를 위한 통합 스트리밍 백본을 구성하는 세 가지 아키텍처 패턴을 제시합니다: 실시간 추론을 포함한 스트리밍 피처 엔지니어링, 이벤트 기반 에이전트 호출, 실시간 컨텍스트 동기화. Powering agentic AI with real-time streaming data on AWS aws.amazon.com +1
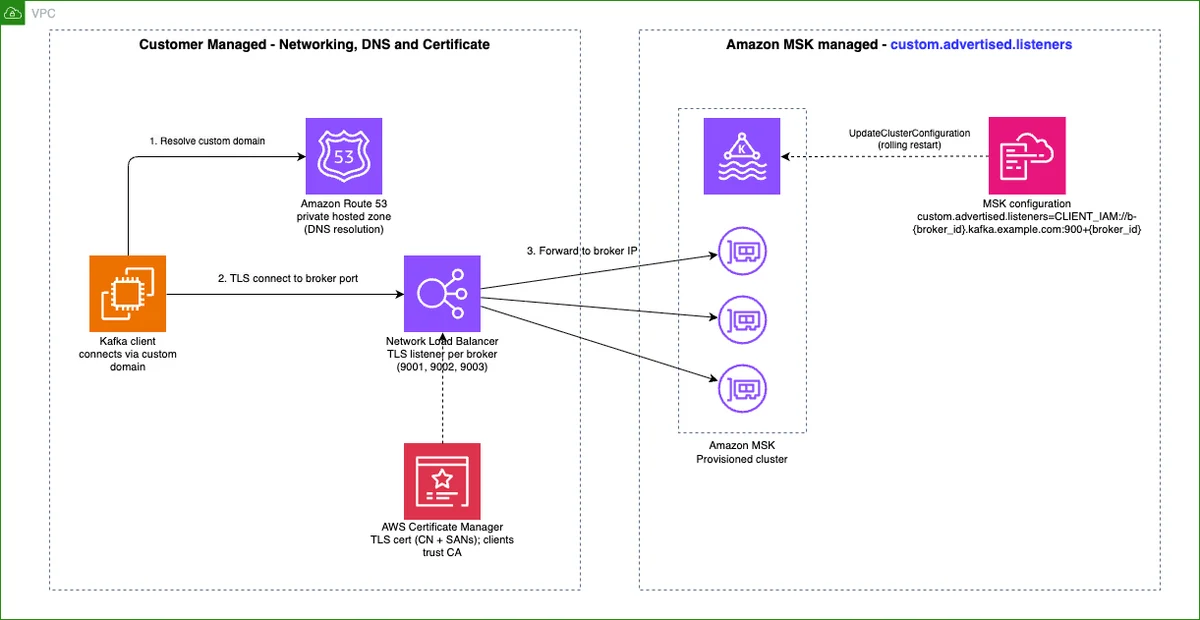
Amazon MSK는 맞춤형 도메인 이름 설정을 간소화합니다 Amazon MSK를 사용하면 ZooKeeper와 KRaft 모두에서 동일하게 작동하는 단일 구성 속성을 사용하여 프로비저닝된 클러스터에 대한 사용자 지정 도메인 이름을 구성할 수 있습니다. 도메인을 한 번 정의하면 Amazon MSK가 클러스터의 모든 브로커에 적용하므로 클러스터가 확장될 때 사용자 지정 도메인 이름이 계속 작동합니다. Amazon MSK simplifies configuring custom domain names aws.amazon.com +1
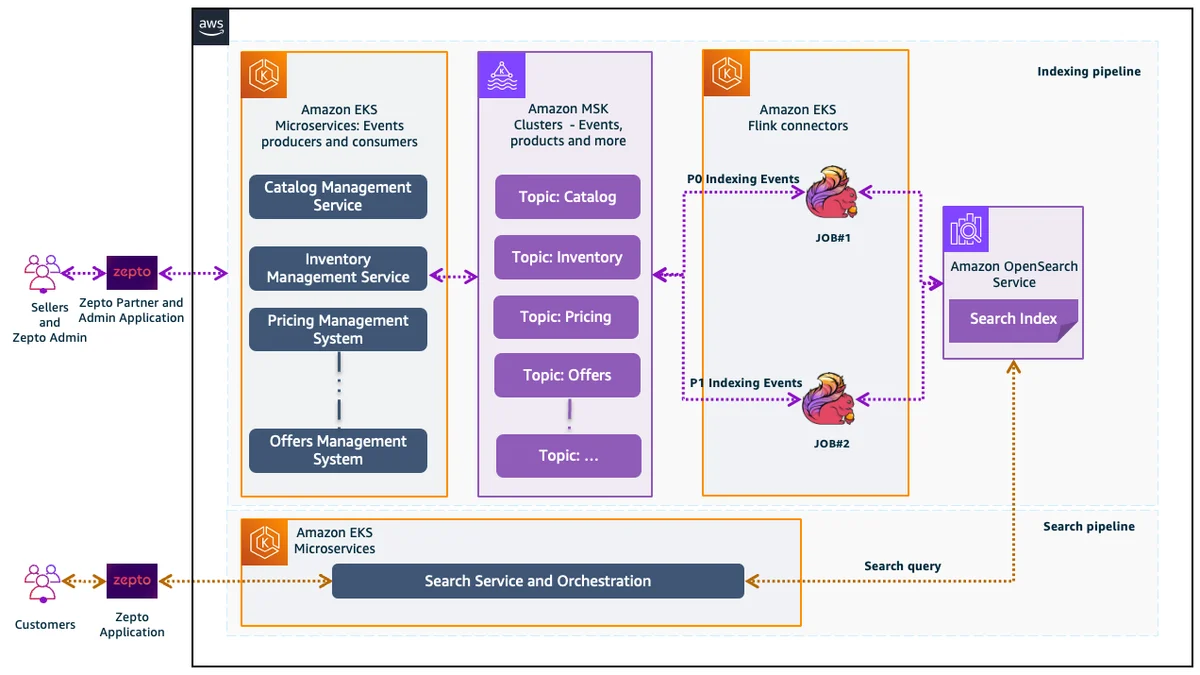
Zepto가 OpenSearch Service OR2 인스턴스를 사용하여 초당 미만의 검색을 지원하는 방법 인도의 빠르게 성장하는 퀵커머스 플랫폼인 Zepto가 수백 개의 배송 허브에 걸쳐 초당 미만(sub-second)의 상품 검색을 확장하기 위해 Amazon OpenSearch Service를 OpenSearch Optimized (OR2) 인스턴스로 마이그레이션하여, 동일한 워크로드를 3분의 2의 데이터 노드로 처리하면서 인덱싱 처리량 100% 이상 향상 및 비용 30% 절감을 달성한 방법을 알아보세요. How Zepto powers sub-second search using OpenSearch Service OR2 instances aws.amazon.com +1
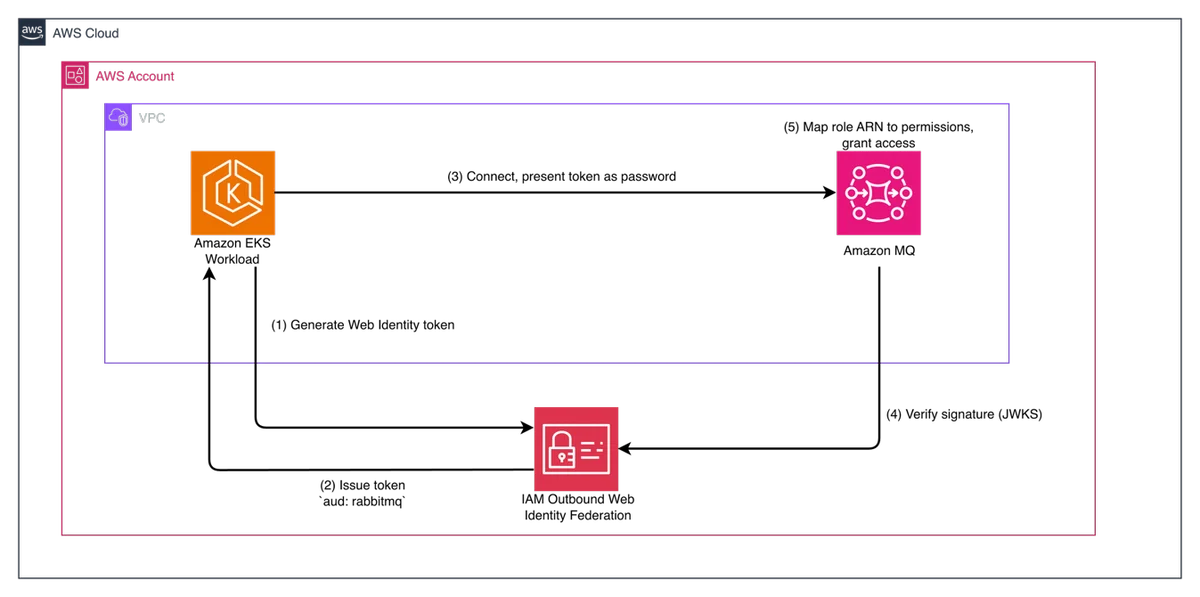
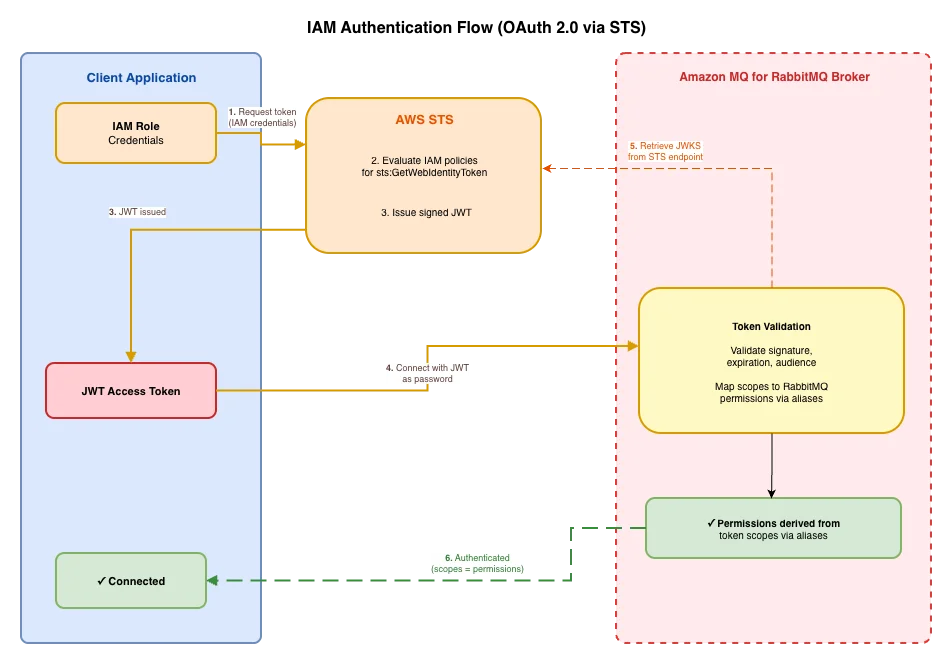
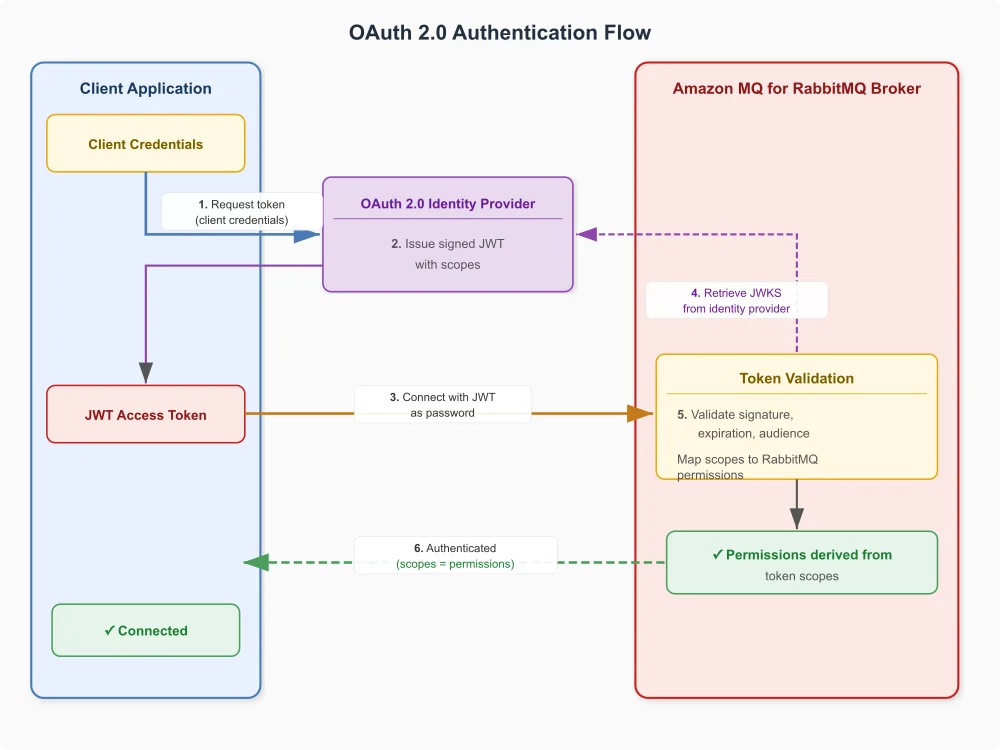
Amazon MQ for RabbitMQ를 위한 OAuth 2.0을 이용한 IAM 인증 IAM 인증과 OAuth 2.0을 사용하면 클라이언트는 정적인 브로커 로컬 자격 증명 대신 기존 IAM ID를 사용하여 Amazon MQ for RabbitMQ에 연결할 수 있습니다. 이 게시물에서는 AWS IAM을 OAuth 2.0 공급자로 사용하는 데 필요한 주요 rabbitmq.conf 구성을 다루고, IAM 역할 및 브로커 범위 별칭으로 적용되는 vhost 격리를 포함하는 멀티 테넌트 예제를 보여줍니다. IAM authentication with OAuth 2.0 for Amazon MQ for RabbitMQ aws.amazon.com +1
Amazon MQ for RabbitMQ용 OAuth 2.0, LDAP 및 HTTP 인증 Amazon MQ for RabbitMQ는 OAuth 2.0, LDAP 및 HTTP 기반 인증 백엔드를 지원하므로 이미 사용 중인 ID 인프라에 브로커를 연결할 수 있습니다. 이 게시물에서는 각 접근 방식이 어떻게 작동하는지 설명하고 사용 사례에 가장 적합한 것을 결정하는 데 도움을 드립니다. OAuth 2.0, LDAP, and HTTP auth for Amazon MQ for RabbitMQ aws.amazon.com +1
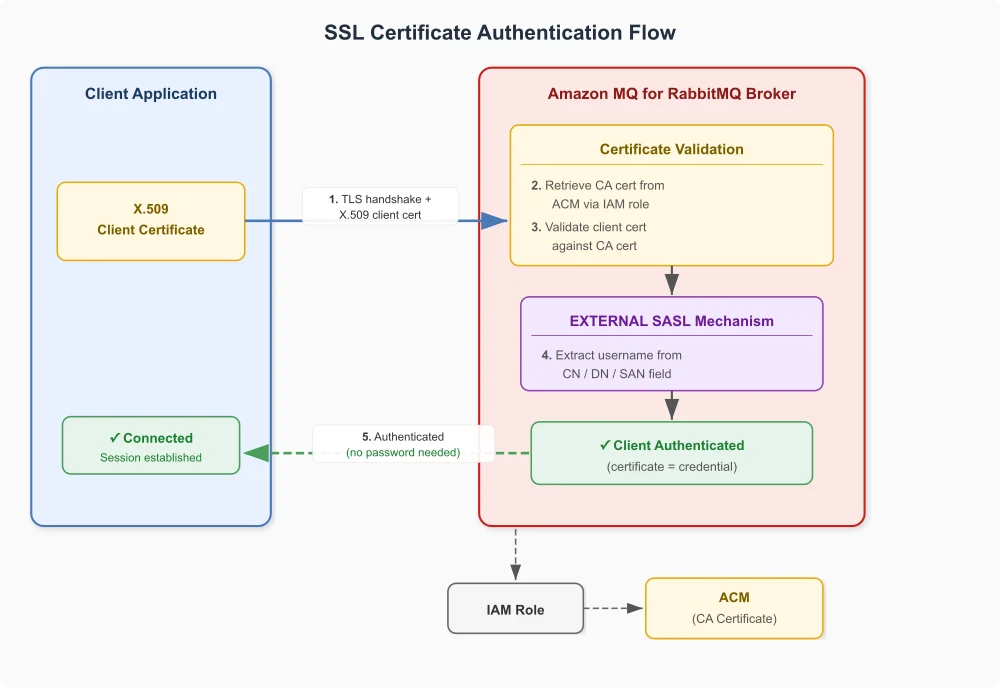
Amazon MQ for RabbitMQ를 위한 상호 TLS 및 SSL 인증서 인증 Amazon MQ for RabbitMQ에 인증서 기반 ID 확인을 추가하는 방법을 알아보세요. 이 게시물에서는 EXTERNAL SASL 메커니즘을 통한 암호 없는 로그인에 대한 SSL 인증서 인증 및 양방향 인증서 확인을 위한 상호 TLS(mTLS)를 설명하고, 주요 rabbitmq.conf 설정을 강조하며, 규정 준수 요구 사항에 맞는 접근 방식을 결정하는 데 도움을 줍니다. Mutual TLS and SSL certificate authentication for Amazon MQ for RabbitMQ aws.amazon.com +1
Amazon MQ for RabbitMQ의 인증 및 권한 부여 옵션 Amazon MQ for RabbitMQ는 여러 인증 및 권한 부여 방법을 지원하므로 기존에 사용 중인 ID 인프라에 브로커를 연결할 수 있습니다. 이 게시물에서는 사용 가능한 옵션을 소개하고 사용 사례에 적합한 옵션을 선택하는 데 도움을 드립니다. Authentication and authorization options for Amazon MQ for RabbitMQ aws.amazon.com +1
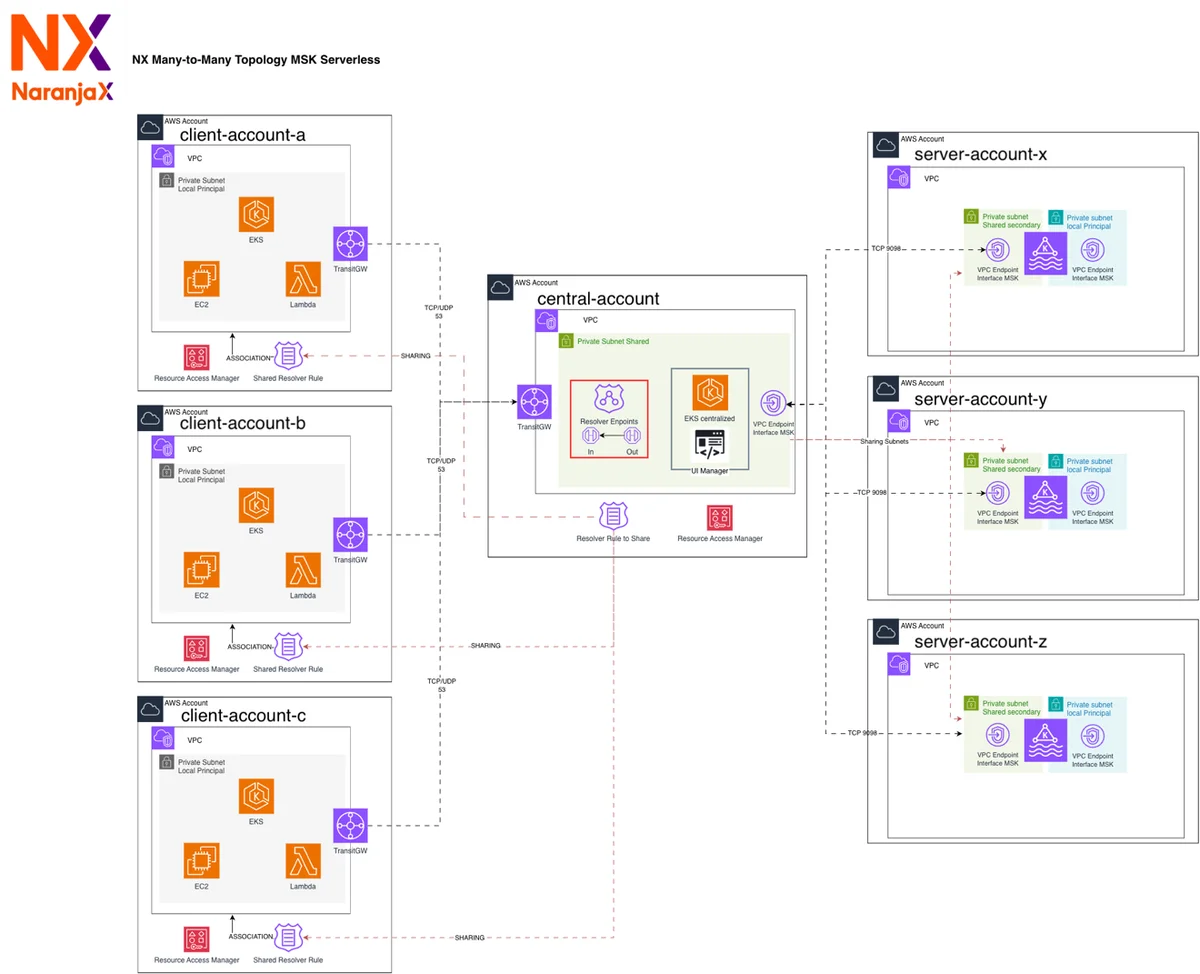
NaranjaX는 IDP에서 AWS RAM 및 Route 53을 사용하여 여러 계정의 여러 Amazon MSK Serverless 클러스터를 관리합니다. NaranjaX가 AWS Resource Access Manager와 Amazon Route 53 Resolver를 사용하여 Amazon MSK Serverless를 위한 교차 계정, 다대다 연결 모델을 구축한 방법을 알아보세요. 이를 통해 40개 이상의 AWS 계정에 걸쳐 있는 팀들이 중앙 집중식 내부 개발 플랫폼에서 이벤트 기반 아키텍처를 채택할 수 있습니다. NaranjaX manages multiple Amazon MSK Serverless clusters in different accounts from their IDP using AWS RAM and Route 53 aws.amazon.com +1
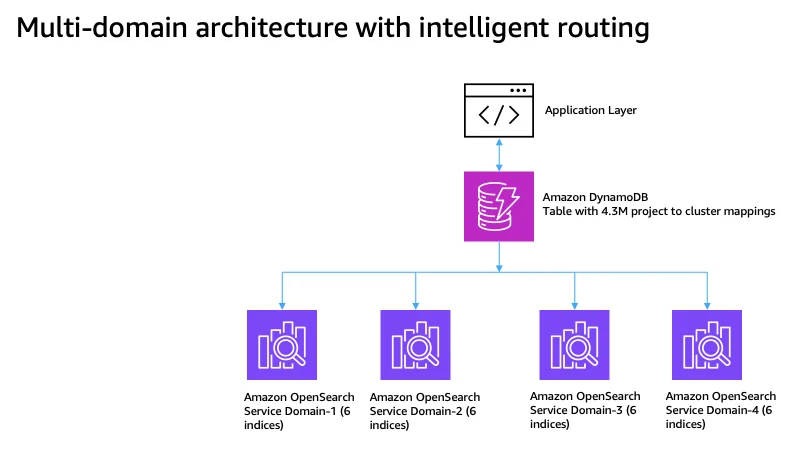
Autodesk가 Migration Assistant와 지능형 라우팅을 사용하여 23억 개의 문서를 Amazon OpenSearch Service로 마이그레이션한 방법 이 게시물은 Amazon OpenSearch Service의 단일 인덱스 Elasticsearch 7.1.1 도메인을 네 개의 멀티 인덱스 OpenSearch Service 도메인으로 재아키텍처링하는 과정을 Amazon OpenSearch Service용 마이그레이션 도우미와 각 쿼리를 해당 쿼리의 데이터를 보유한 샤드로 안내하는 라우팅 계층을 사용하여 설명합니다. How Autodesk migrated 2.3 billion documents to Amazon OpenSearch Service using Migration Assistant and intelligent routing aws.amazon.com +1