Spring 한국어 노트

Spring 한국어

스프링은 웹 애플리케이션을 빠르고 효율적으로 구축하는 데 사용되는 강력한 도구 세트입니다. 개발자가 엔터프라이즈 수준의 애플리케이션을 생성하는 데 사용할 수 있는 간단하고 확장 가능한 코드 작성 방법을 제공합니다. 스프링 프레임워크는 Java 또는 다른 언어를 사용하여 애플리케이션을 생성하고, 이를 어떤 계층 서버에든 배포할 수 있도록 합니다. 예를 들어 HTTP 서버 또는 애플리케이션 서버 등입니다.스프링은 다양한 환경에서 가치가 증명된 것으로, 소규모 및 대규모 팀 모두에게 다양한 작업을 용이하게 합니다. 프레임워크는 독립적으로 또는 함께 사용할 수 있는 다양한 모듈을 제공하여 엔터프라이즈 수준의 애플리케이션을 생성하는 데 유연성과 간소화를 제공합니다.공식 스프링 사이트는 개발자가 시작하고 프레임워크를 마스터하는 데 도움이 되는 다양한 리소스와 도구를 제공합니다. 예를 들어 문서, 자습서, 교육 과정, 예제 등이 있습니다. 사이트에는 또한 최신 릴리즈 노트, 업데이트와 개발자가 아이디어를 공유하거나 지원을 받거나 프로젝트에 기여할 수 있는 커뮤니티 섹션도 포함되어 있습니다.

노트 스레드

Spring AI TypeSafe는 TypeSafe AI의 Jev API를 통합하여 AI 애플리케이션을 위한 빠르고 저렴하며 구조화된 의사 결정 구성 요소를 제공합니다. 기존의 프롬프트 템플릿팅 및 JSON 스키마 파싱을 우회하고, 대신 상태와 타입이 지정된 질문을 받아 구조화된 답변을 반환하는 클라이언트를 제공합니다. 시스템은 세 가지 기본 질문 유형을 처리합니다: 예/아니오를 위한 Noul, 옵션 선택을 위한 Choice, 루브릭에 따른 순위 매기기를 위한 Score. 이러한 기본 요소는 정확한 값, 확률 및 신뢰도를 반환하여 세분화된 평가를 가능하게 합니다.이 서비스는 속도와 비용 효율성을 위해 설계되었으며, 성능과 가격 모두에서 벤치마크에서 일반적인 채팅 모델 호출보다 훨씬 뛰어납니다. 이를 통해 AI 파이프라인의 다양한 단계에서 검사를 수행할 수 있습니다. 핵심 아이디어는 코드에서 원자적 질문을 구성하여 서비스가 단일 상태 관찰에 대해 병렬로 처리할 수 있도록 하는 것입니다.이 기능은 LLM-as-a-Judge 시나리오에서 예시로 제공되며, 여기서 JevJudge는 특정 기준과 임계값을 사용하여 모델 출력을 평가하도록 구축될 수 있습니다. 신뢰도 점수는 답변의 확실성을 분포에 기반하여 나타내는 추가 정보 축을 제공합니다. JevSelfRefineAdvisor는 이 판단 시스템을 활용하여 기준이 충족되지 않을 때 피드백과 함께 모델 호출을 재시도함으로써 자체 수정 루프를 구현합니다.또한, JevGuardrailAdvisor는 안전 계층 역할을 하여 사용자 입력과 모델 출력 모두를 미리 정의된 위험에 대해 검사합니다. 재시도하지 않고 심각도에 따라 차단하거나 플래그를 지정합니다. 시스템의 출력은 구조화되어 있으며, 산문을 생성하지 않고 분류, 점수 및 결정을 제공합니다.TypeSafe AI 기본 요소는 Noul (예/아니오, 0과 1 사이의 진리 값 반환), Choice (하나의 옵션 선택, 선택된 레이블과 모든 옵션의 확률 및 신뢰도 반환), Score (순서가 있는 루브릭에 배치, 연속 값 및 관련 확률 반환)입니다. 옵션 설명과 이러한 기본 요소에 대한 명확한 지침은 성능과 신뢰도를 크게 향상시킵니다. 이 프로젝트는 Maven Central 스타터로 제공되며 Spring Boot와 함께 또는 없이 사용할 수 있습니다.
CdXz5zHNQW_hDXjfLYIZj.png
Spring AI 2.0.1이 2.0.0 GA 릴리스를 기반으로 하는 유지보수 업데이트로 출시되었습니다. 이 중요한 업데이트는 일반 공급 이후 80개 이상의 이슈를 해결하고 자주 요청되는 기능을 통합했습니다. 이 릴리스에는 무제한 재귀 및 임의 파일 쓰기와 같은 몇 가지 중요한 보안 취약점에 대한 수정 사항이 포함되어 있습니다. 업그레이드하기 전에 사용자는 지원 중단된 Mistral AI 모델의 은퇴 및 Redis 채팅 메모리 자동 구성 모듈의 이름 변경을 포함한 사소한 변경 사항을 인지해야 합니다. OpenAI 도구 호출 엄격 모드는 이제 기본적으로 false이며, 미디어 빌더는 이제 명확성을 위해 형식화된 데이터 오버로드를 사용합니다. DeepSeekApi는 다른 API 클라이언트 규칙에 맞게 수정되었으며, Couchbase 벡터 저장소는 이제 Spring Boot 관리 Couchbase 클라이언트를 활용합니다. 이 릴리스의 새로운 기능에는 무한 에이전트 루프를 방지하기 위한 요청당 구성 가능한 도구 호출 제한 및 이러한 제한 초과에 대한 예외가 포함됩니다. OpenAI 오디오 기능은 이제 스트리밍을 지원하며 전사(transcription)에 대한 풍부한 옵션을 포함합니다. Google GenAI는 ToolChoice 지원 및 이미지 생성 기능을 얻었으며, PagePdfDocumentReader는 특정 페이지 범위의 수집을 허용합니다. AWS 리전 확인은 이제 기본 SDK 규칙을 준수하여 다른 AWS 스택 구성 요소와의 일관성을 개선합니다. 스트리밍 및 도구 호출에 대한 상당한 안정성 개선이 이루어졌으며, 델타 및 취소 처리가 개선되었습니다. 채팅 메모리 및 벡터 저장소 또한 다양한 버그 수정 및 강화 작업을 거쳐 다양한 통합에서 안정성과 기능을 개선했습니다.
Spring Cloud 2025.1.3 릴리스 트레인이 Maven Central에서 사용할 수 있으며, 릴리스 노트에서 더 자세한 정보를 확인할 수 있습니다. 이 릴리스는 Spring Boot 4.0.8을 기반으로 구축되었습니다. 여러 모듈에 걸쳐 몇 가지 중요한 변경 사항과 치명적인 보안 수정 사항이 포함되었습니다. Spring Cloud Circuitbreaker는 더 이상 Resilience4JCircuitBreakerFactory의 기본 TimeLimiterConfig를 사용하지 않습니다. Spring Cloud Commons는 CVE-2026-59284 취약점을 수정하고, Bouncycastle을 업그레이드했으며, 속성 구성 재설정을 개선했습니다. Spring Cloud Config는 여러 CVE(2026-47836, 2026-47837, 2026-47894, 2026-59315)를 해결하고, 이제 AWS S3에서 Git 스타일의 searchPaths를 지원합니다. Spring Cloud Function은 파일 읽기, SSRF, 헤더 필터링, 함수 중독 및 민감한 데이터 로깅과 관련된 여러 CVE(2026-59291, 2026-59297, 2026-59298, 2026-59299, 2026-59300, 2026-59301)를 해결합니다. Spring Cloud Gateway는 SSRF 및 네이티브 파일 액세스와 관련된 CVE-2026-47879를 수정하고, MVC 재시도 백오프 지원을 추가했습니다. Spring Cloud Stream은 민감한 데이터 로깅, 캐시 크기, 콘텐츠 유형 캐싱, 인터셉터 문제 및 역직렬화 취약점과 관련된 CVE(2026-59302, 2026-59303, 2026-59304, 2026-59305, 2026-59306)를 해결합니다. 이 릴리스 내의 다양한 모듈의 업데이트된 버전을 개략적으로 설명하는 표가 있습니다. GitHub, Gitter, Stack Overflow 또는 Twitter를 통해 피드백을 권장합니다. 커뮤니티 사용을 위한 Maven 및 Gradle과의 통합 지침이 제공됩니다.
이번 주 Spring에는 커뮤니티를 위한 몇 가지 흥미로운 업데이트와 발표가 있습니다. 분산 작업 실행 엔진인 JobRunr가 Spring Initializr에 추가되어 개발자들이 이 도구를 더 쉽게 시작할 수 있게 되었습니다. Craig Walls의 최근 게시물은 Spring AI와 함께 여러 대규모 언어 모델을 사용하는 방법을 탐구하며 개발자들에게 귀중한 통찰력을 제공합니다. Spring for Apache Kafka와 Kafka Streams의 데드 레터 큐를 사용하는 방법에 대한 기사도 게시되어 Kafka를 사용하는 사람들에게 유용한 자료를 제공합니다. Spring Boot 팀의 일원인 Moritz Halbritter는 Spring Framework 7과 Spring Boot 4가 null 포인터를 식별하고 제거하는 데 어떻게 도움이 되는지에 대한 강연을 했습니다. Spring Cloud Contract는 Stubborn.sh로 새로운 보금자리로 이전될 예정이며, 이곳에서 개발자들에게 중요한 도구로 계속 사용될 것입니다. A Bootiful Podcast의 최근 에피소드에서는 Spring Framework 및 Spring AI 기여자 Sebastien Deleuze와 함께 이야기를 나눴습니다. Spring AI의 MCP 주석에 대한 튜토리얼이 게시되어 개발자들에게 유용한 가이드라인을 제공합니다. Spring AI의 도입 또한 강조되어 Spring 커뮤니티에 미칠 잠재적 이점을 보여주었습니다. 전반적으로 Spring 커뮤니티는 번창하고 있으며, Apache Kafka의 개발사인 Confluent와 같은 공급업체들은 자사 제품이 Spring 생태계를 어떻게 지원하고 향상시킬 수 있는지에 집중하고 있습니다.
이 글의 저자는 2011년 1월부터 This Week in Spring이라는 주간 요약을 작성해 온 Spring 팬입니다. 저자는 최근 아시아 투어를 마치고 현재 일본에서 휴가를 보내고 있으며, 이곳에서 휴식을 취하고 Spring 세계의 새로운 발전에 대해 배울 계획입니다. Microsoft는 새로운 Spring AI 2.0 출시와 Azure CosmosDB와의 통합에 대한 블로그 게시물을 작성했습니다. Craig Walls는 또한 음성을 Spring AI 및 ElevenLabs Voices와 함께 사용하는 방법에 대한 레시피를 작성했습니다. Spring Boot의 최신 버전인 4.1이 새로운 기능과 CVE에 대한 패치를 포함하여 출시되었으며, 사용자는 가능한 한 빨리 코드를 업데이트하는 것이 좋습니다. 저자는 취약점이 발견, 공개 및 수정되는 과정을 설명하고, AI가 이 과정을 더 쉽게 만들었지만 CVE의 양도 증가시켰다고 설명합니다. 저자는 또한 MongoDB 기반 Spring Batch 리포지토리와 자동 구성을 포함한 Spring Boot 4.1의 몇 가지 새로운 기능에 대해 언급합니다. 또한, 저자는 Spring AI 2.0의 Self-Correcting Structured Output에 대한 블로그 게시물과 CVE 상태에 대한 팟캐스트 에피소드를 포함한 다른 흥미로운 기사와 팟캐스트를 강조합니다. 저자는 또한 일본어 Spring Boot 시리즈와 Spring AI를 사용한 에이전트 스킬 구축에 대한 게시물을 포함한 다른 리소스를 언급합니다. 전반적으로 이 글은 Spring 생태계의 최신 개발에 대한 업데이트를 제공하고 사용자가 최신 릴리스 및 보안 패치를 최신 상태로 유지하도록 권장합니다.
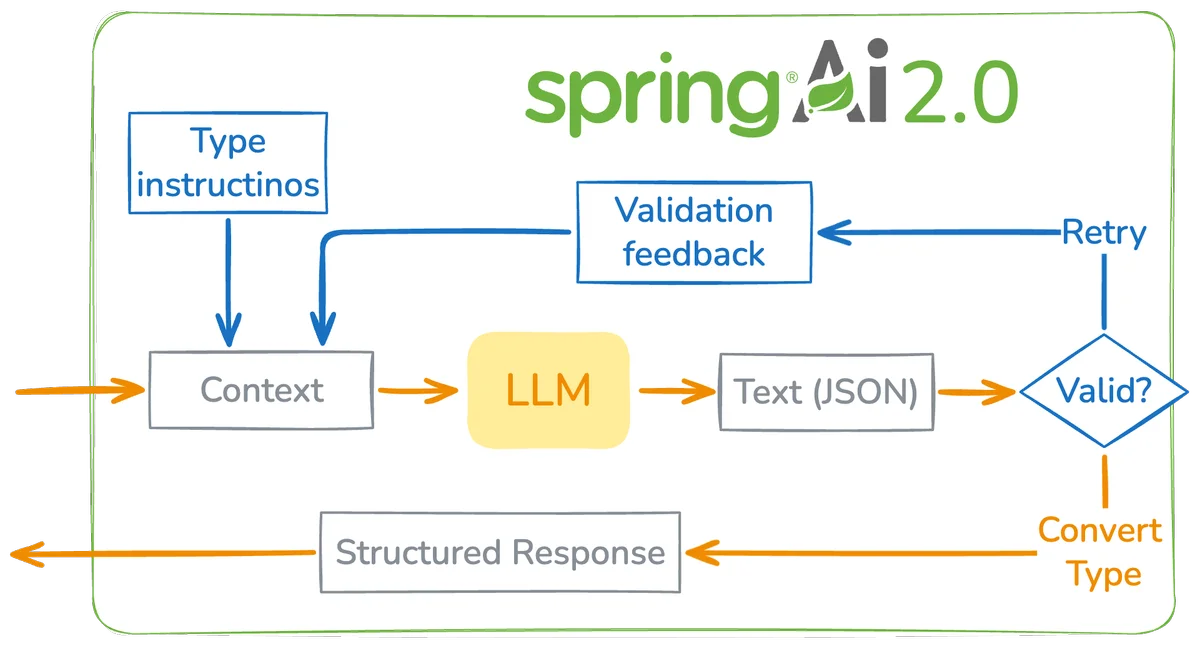
대규모 언어 모델은 강력하지만 소프트웨어 통합을 위한 구조화된 데이터에는 어려움을 겪습니다. Spring AI의 구조화된 출력은 모델이 정의된 스키마를 준수하는 텍스트를 생성하도록 허용하여 이 간극을 메우며, 이는 타입이 지정된 객체로 파싱됩니다. Spring AI 2.0은 두 가지 주요 개선 사항을 도입합니다. 공급자 네이티브 구조화된 출력 및 자체 수정 스키마 유효성 검사입니다. 기존 코드는 변경되지 않은 기본값으로 인해 호환됩니다.구조화된 출력을 생성하기 위해 개발자는 Java record를 정의한 다음 .entity() 메서드를 사용하여 대상 유형을 지정합니다. 이 프로세스는 내부적으로 레코드에서 JSON 스키마를 생성하고, 이를 프롬프트에 추가하고, 모델의 JSON 응답을 원하는 객체로 다시 파싱합니다. Spring AI 2.0 이전에는 이 프로세스에 보장이 부족하여 모델이 스키마에서 벗어날 경우 잠재적인 파싱 오류가 발생했습니다..validateSchema() 스위치는 자체 수정 재시도 루프를 활성화하여 스키마에 대해 모델의 응답을 자동으로 유효성 검사하고 유효성 검사에 실패하면 특정 오류 피드백과 함께 프롬프트를 다시 발행합니다. 더 강력한 보장을 위해 .useProviderStructuredOutput()은 공급자별 API 기능을 활용하여 소스에서 스키마 준수를 강제합니다. 이렇게 하면 잘못된 응답이 처음부터 생성되지 않도록 하여 잘못된 출력을 최소화합니다.이 두 가지 기능은 최대 복원력을 위해 결합될 수 있으며, 공급자 네이티브 출력이 기본 제약 역할을 하고 스키마 유효성 검사가 대체 역할을 합니다. List 및 Map과 같은 제네릭 유형의 경우 간단한 Class 대신 ParameterizedTypeReference가 사용됩니다. .responseEntity() 메서드를 사용하면 파싱된 엔티티와 메타데이터를 위한 원시 ChatResponse 모두에 액세스할 수 있습니다.내장된 변환기가 불충분한 경우 사용자 지정 StructuredOutputConverter 구현을 사용하여 비표준 JSON 래핑 또는 YAML 또는 CSV와 같은 완전히 다른 형식을 처리할 수 있습니다. 이는 다양한 통합 요구에 대한 추가 유연성을 제공합니다.
CdXz5zHNQW_ujOXatEKZz.png
Spring Batch는 역사적으로 JobRepository에서 작업 실행 상태를 저장하기 위해 SQL 데이터베이스에 의존해 왔습니다. 이 요구 사항은 MongoDB와 같은 NoSQL 데이터베이스를 주로 사용하는 사용자들에게도 지속되었습니다. 최근 Spring Batch 버전에서는 JobRepository를 JDBC에서 분리했으며, Spring Boot 4.1은 MongoDB에 대한 자동 구성을 도입했습니다. 이를 통해 배치 메타데이터를 MongoDB에 저장할 수 있어 별도의 SQL 데이터베이스가 필요 없어졌습니다. 이 글은 JobRepository에 MongoDB를 사용하는 Spring Batch 작업의 완전한 예제를 보여줍니다. 이 예제는 Docker Compose를 사용하여 MongoDB와 PostgreSQL을 설정합니다. CSV에서 고객 데이터를 읽어 PostgreSQL 테이블에 쓰는 ETL 작업을 정의합니다. 이는 대상 테이블을 재설정하는 작업과 실제 데이터 전송을 위한 작업의 두 단계로 이루어집니다. 데이터 전송 단계에서는 FlatFileItemReader, 간단한 프로세서, JdbcBatchItemWriter를 사용합니다. 이 청크 기반 단계에 대한 내결함성 및 재시도 메커니즘이 구성됩니다. 그런 다음 애플리케이션이 실행되며, 모든 작업 실행 세부 정보가 MongoDB에 기록됩니다. OpenTelemetry 및 Grafana 통합으로 관찰 가능성이 향상됩니다. 이 글은 또한 Spring Batch를 GraalVM 네이티브 이미지와 함께 작동하도록 하는 방법과 최적화를 위한 지연 데이터 소스 연결을 소개합니다. 핵심은 Spring Batch가 이제 MongoDB와 원활하게 통합되어 개발자가 선호하는 데이터베이스를 타협 없이 사용할 수 있다는 것입니다.