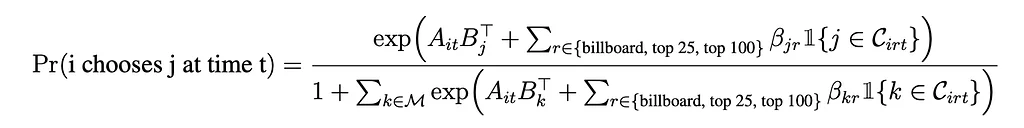Netflix TechBlog | Medium 한국어 팔로우 넷플릭스 테크 블로그는 넷플릭스가 기술을 처리하는 방법에 대한 통찰을 제공합니다. 그들은 데이터 과학, 엔지니어링, 디자인 및 기술 혁신에 대한 연구를 수행합니다. 그들은 자체 콘텐츠 전송 네트워크와 같은 혁신을 보여 주고 서비스 신뢰성 노력에 대한 통찰을 제공합니다. Netflix TechBlog - Medium netflixtechblog.com RSS netflixtechblog.com Netflix TechBlog | Medium 한국어 RSS thenote.app
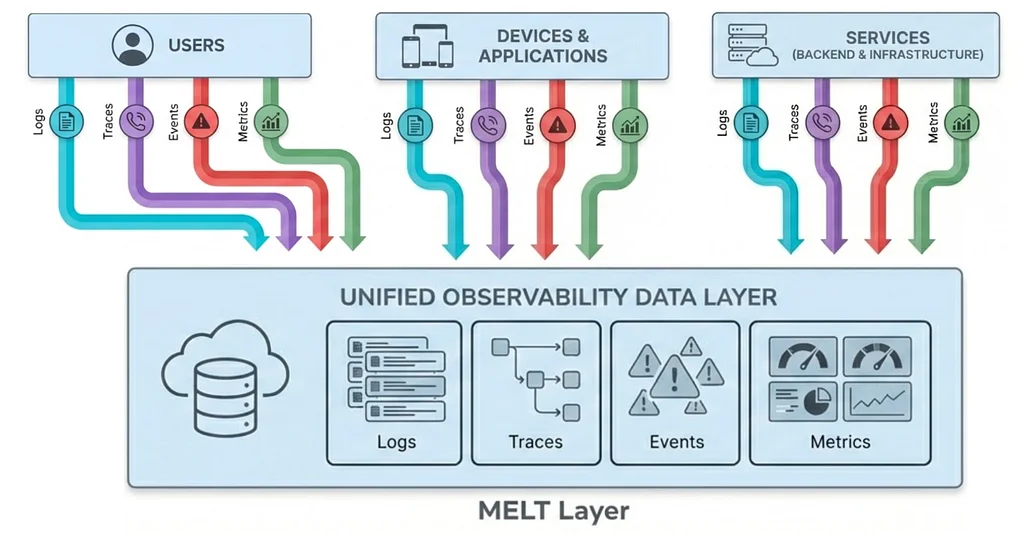
Netflix 규모의 온톨로지 기반 관찰 가능성: 엔드-투-엔드 지식 그래프 구축 이 회사는 6,500만 스트림을 기록한 제이크 폴과 마이크 타이슨의 경기와 같은 라이브 이벤트 중에 특히 방대하고 복잡한 인프라를 이해하는 데 어려움을 겪고 있습니다. 느리게 렌더링되는 홈 화면과 같은 디버깅 문제는 정보가 서로 다른 시스템에 사일로화되어 있기 때문에 몇 시간이 걸릴 수 있습니다. 이러한 시스템은 메트릭, 이벤트, 로그 및 추적(MELT)을 통해 데이터를 수집하지만, 이 데이터를 효과적으로 상관시키는 것은 어렵습니다. 핵심 문제는 운영 엔티티에 대한 공유되고 기계가 읽을 수 있는 이해가 부족하다는 것입니다.이를 해결하기 위해 운영 세계 내의 유형, 속성 및 관계에 대한 공식적인 사양인 "관찰 가능성 온톨로지"를 개발했습니다. 이 온톨로지는 RDF, OWL, SHACL 및 SPARQL과 같은 표준을 사용하며 지식 그래프로 데이터를 저장합니다. 핵심 설계 결정은 일반적인 "서비스" 유형을 피하고 대신 ops:Application과 같이 구체적이고 검증된 유형을 사용하는 것이었습니다. 또한 사고 논의에서 추론 및 컨텍스트를 모델링하여 구조화되지 않은 채팅을 구조화된 삼중항으로 변환했습니다.이 온톨로지는 파이프라인 접근 방식을 통해 본질적으로 확률적인 프로세스(LLM 및 퍼지 매칭)에서 결정론을 생성합니다. 이 파이프라인은 엄격한 계약을 따르는 입력 데이터를 유형화된 삼중항으로 변환하여 엔트로피를 줄이는 "강화기"를 사용합니다. 이러한 강화기는 모든 엔티티에 유형이 있고, URI가 명명 규칙을 따르며, 애플리케이션이 카탈로그에 대해 검증되도록 합니다. 파이프라인은 경쟁 조건을 방지하기 위해 순차적으로 실행되며, 차단을 방지하기 위해 외부 호출은 최선을 다합니다.그런 다음 "상관 엔진"이 다양한 소스의 신호를 통합하여 인과적 또는 상관적 이벤트 체인을 식별합니다. 13가지 신호 유형을 분석하고 증거와 신뢰도 점수를 포함한 가설을 제안하며 지원 그래프 레코드를 저장합니다. 관찰, 강화, 상관 및 저장의 각 주기는 "지식 플라이휠"을 형성하여 지식 그래프를 지속적으로 강화하고 시스템 컨텍스트를 개선합니다. 이 플라이휠은 시스템 운영에 대한 통합되고 상호 연결된 보기를 제공하여 디버깅 시간을 줄이는 것을 목표로 합니다. Ontology-Driven Observability: Building an End-to-End Knowledge Graph at Netflix Scale netflixtechblog.com +1
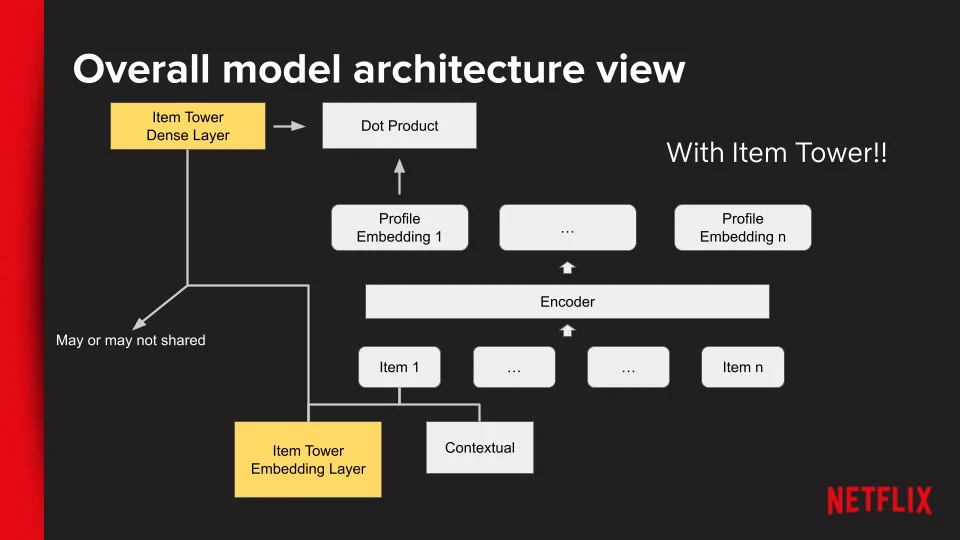
Netflix의 Foundation Model을 Personalization 애플리케이션에 통합하기 Netflix는 회원 선호도 학습을 중앙 집중화하기 위해 개인화를 위한 Foundation Model을 개발했습니다. 방대한 사용자 상호 작용 및 콘텐츠 데이터로 학습된 이 강력한 모델은 학습 내용을 다른 모델에 배포합니다. 이 대규모 모델을 프로덕션 시스템에 통합하는 것은 과제였으며, Netflix는 임베딩, 서브그래프 및 미세 조정을 포함한 세 가지 뚜렷한 접근 방식을 실험하게 되었습니다. 각 방법은 지연 시간, 기술 스택 및 모델 활용 측면에서 다른 애플리케이션 요구 사항을 충족합니다.임베딩 접근 방식은 임베딩 스토어에 저장된 Foundation Model의 사전 계산된 사용자 프로필 및 항목 표현을 활용합니다. 간단하고 비용 효율적이지만 계산과 추론 간의 시간 간격으로 인해 오래된 추천으로 이어질 수 있습니다. Netflix는 일일 미세 조정 및 임베딩 안정화 기술로 이를 향상시킵니다. 오래된 추천을 해결하고 적응성을 개선하기 위해 거의 실시간 프레임워크가 개발 중입니다.서브그래프 통합은 Foundation Model 디코더를 애플리케이션의 더 큰 모델 그래프 내의 구성 요소로 취급합니다. 이를 통해 더 깊은 통합이 가능하고 최신 학습을 사용하며 특정 Foundation Model 계층에 액세스하여 애플리케이션별 가치를 발휘할 수 있습니다. 그러나 기능 생성의 복잡성을 야기하고 모델 크기와 추론 시간을 증가시킵니다. 이 접근 방식은 메트릭 개선이 비용을 정당화하는 높은 영향력 있는 사용 사례에 예약되어 있습니다.미세 조정 접근 방식은 제품별 데이터 및 목표에 대해 추가로 학습하여 특정 애플리케이션에 맞게 Foundation Model을 조정합니다. 이는 최적화된 성능을 제공하고 새로운 애플리케이션의 기준선 역할을 합니다. 지연 시간 및 SLA에 대한 신중한 최적화가 필요하지만 모델 및 파이프라인의 확산으로 이어질 수 있습니다. Netflix는 이 프로세스를 단순화하기 위해 미세 조정 프레임워크를 제공합니다.지속적인 혁신에는 지연 시간을 줄이기 위한 거의 실시간 임베딩 추론 및 더 작고 압축된 Foundation Model 버전이 포함됩니다. 표준화된 API와 강력한 미세 조정 프레임워크는 애플리케이션 팀이 Foundation Model을 더 쉽게 활용할 수 있도록 하는 것을 목표로 합니다. 이러한 세 가지 통합 패턴은 Netflix 애플리케이션이 Foundation Model의 이점을 누릴 수 있는 포괄적인 전략을 제공합니다. Integrating Netflix’s Foundation Model into Personalization applications netflixtechblog.com +1
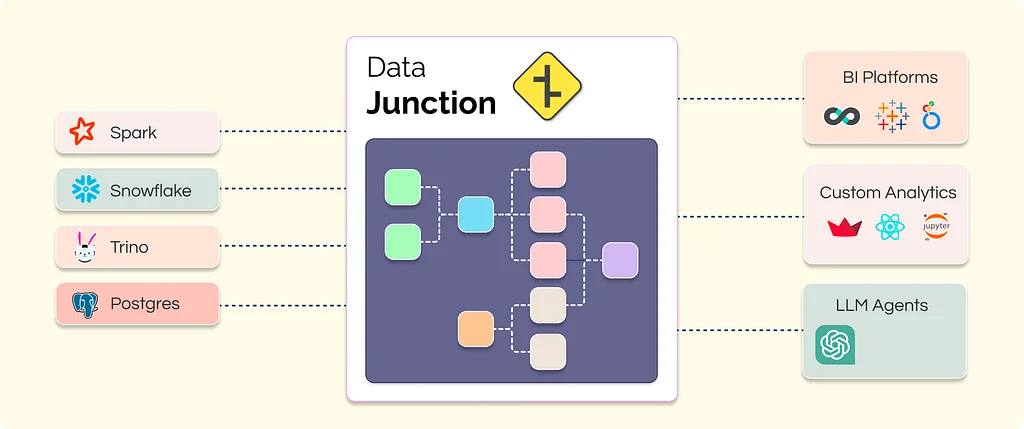
넷플릭스의 현대 데이터 스택의 누락된 부분을 채우는 솔루션으로서의 DataJunction Netflix는 특히 실험 플랫폼 내에서 분산되고 일관성 없이 정의되며 신뢰할 수 없는 측정 항목으로 인해 어려움을 겪었습니다. 이러한 복잡성은 데이터 과학자와 분석 엔지니어에게 장애가 되었고, 이전 시스템을 통해 측정 항목 온보딩에 몇 주가 소요되었습니다. 이를 해결하기 위해 Netflix는 시맨틱 레이어 솔루션을 탐색했으며, 강력한 SQL 파싱 및 생성 엔진과 그래프 기반 메타데이터 저장 기능으로 인해 DataJunction을 선택했습니다. DataJunction은 측정 항목 이식성 문제를 해결하기 위해 Facebook에서 시작되었으며, 나중에 Netflix 엔지니어에 의해 오픈 소스화되고 확장되었습니다. 주요 아키텍처 결정은 SQL 입력 및 출력 기능을 갖춘 견고한 시맨틱 레이어 엔진과 API에 중점을 둔 API 우선 접근 방식을 우선시하는 것이었습니다. 이 플랫폼은 익숙한 사용자 인터페이스와 효율적인 데이터 전달을 위해 다차원 큐브를 최우선 기능으로 채택했습니다. DataJunction은 측정 항목 정의를 소스에 다시 연결하는 기능을 통해 문제 해결 및 임시 분석을 간소화합니다. 이 플랫폼의 Netflix 실험 도메인 통합은 측정 항목 및 차원 정의 및 관리를 간소화했습니다. 향후 계획에는 다른 도구와의 통합 강화 구축을 통해 Netflix의 일반 분석을 통합하는 것이 포함됩니다. 이를 통해 Netflix 데이터 스택 전반에 걸쳐 측정 항목을 더 쉽게 검색, 사용 및 실험할 수 있습니다. DataJunction as Netflix’s answer to the missing piece of the modern data stack netflixtechblog.com +1
개인 맞춤 추천의 영향 측정 넷플릭스와 같은 온라인 플랫폼에서 개인화는 사용자 발견 및 참여에 영향을 미치는 핵심 기능입니다. 그러나 개인화의 진정한 가치를 측정하는 것은 상당한 과제를 제시합니다. 추천은 예측된 사용자 선호도를 기반으로 타겟팅되므로 추천 효과와 사용자 매력을 분리하기 어렵습니다. 추천된 시청 횟수를 단순히 계산하는 방식은 인과 관계를 확립하지 못하기 때문에 불충분합니다. 개인화를 완전히 비활성화하기 위한 실험을 실행하는 것은 사용자 경험에 부정적인 영향을 미치므로 실행 가능한 측정 전략이 아닙니다.대신, 연구자들은 행동 모델과 소규모 A/B 테스트를 결합한 하이브리드 접근 방식을 개발했습니다. 이 모델은 추천의 점진적인 영향을 사용자 선호도와 분리함으로써 추천이 시청 결정과 타이틀 선택 모두에 어떻게 영향을 미치는지 추정합니다. 이 모델은 과거 시청 기록이 현재 취향을 형성하는 방식을 포착하여 멤버 선호도를 동적으로 표현합니다. 이는 인식 및 정보 증가를 반영하는 타이틀 선택에 대한 추천의 "보너스" 효과를 명시적으로 모델링합니다.대체 패턴을 예측하는 모델의 정확성을 검증하기 위해 무작위 실험 결과와 비교되었습니다. 이러한 실험은 추천 알고리즘이 변경되는 방식을 모방하여 타이틀 가시성에 외생적인 변동을 도입했습니다. 이 모델은 높은 상관관계를 보이는 시뮬레이션된 전환 비율을 통해 강력한 예측력을 입증했습니다.검증된 모델을 사용하여 연구자들은 현재 넷플릭스 추천 시스템을 무작위, 인기 기반, 기본 행렬 분해 추천과 같은 기준선과 비교하기 위해 반사실적 분석을 수행했습니다. 현재 시스템은 집계 참여 측면에서 이러한 기준선보다 훨씬 뛰어났으며, 무작위 추천의 경우 16%, 인기 기반 추천의 경우 12% 감소했습니다. 행렬 분해와 비교했을 때도 현재 시스템은 참여에서 4%의 증가를 보였습니다.단순히 시청을 늘리는 것 외에도 이 모델은 소비 다양성을 평가했습니다. 현재 시스템은 인기 기반 및 행렬 분해 추천과 달리 시청률이 타이틀 전반에 걸쳐 더 넓은 분포를 유지했으며, 이는 시청률 집중 증가로 이어졌습니다. 무작위 추천은 더 많은 다양성을 제공했지만 참여 비용이 상당히 컸습니다. 따라서 개인화는 더 많은 시청을 유도할 뿐만 아니라 다양한 취향을 반영하여 사용자에게 더 다양한 타이틀을 매칭합니다. Measuring the Impact of Personalized Recommendations netflixtechblog.com +1
시계열 계층형 스토리지 여정: Kafka/Flink 스트림에서 네이티브 Cassandra 콜드 리드까지 Netflix의 페타바이트 규모의 시계열 데이터에 필수적인 TimeSeries Abstraction 플랫폼은 상당한 스토리지 비용 문제에 직면해 있습니다. 이를 해결하기 위해, 저렴한 객체 스토리지로 이전되고 덜 접근되는 오래된 데이터를 이동시키면서도 낮은 지연 시간 액세스를 유지하기 위한 두 가지 솔루션이 구현되었습니다. 첫 번째 솔루션은 Apache Kafka와 Flink를 사용하여 S3로 데이터를 스트리밍하고, 이후 일일 압축 작업이 Parquet 파일을 병합하고 최적화합니다. 이 압축 과정은 작은 행 그룹을 생성하고, 이벤트를 시간별로 정렬하며, 효율적인 읽기를 위해 Bloom 필터를 사용하는 것을 포함합니다. 압축된 파일은 컨트롤 플레인에 등록되어 핫 스토리지 절단을 가능하게 합니다. 읽기는 핫 및 콜드 티어에 걸쳐 분산되며, 콜드 티어는 압축 메타데이터를 활용하여 S3 읽기를 최소화합니다.성공에도 불구하고, 스트리밍 인프라는 복잡성과 비용을 증가시켰습니다. 이로 인해 Cassandra 백업을 활용하는 두 번째, 보다 통합된 솔루션이 개발되었습니다. 이 접근 방식은 별도의 데이터 전송 없이 S3 백업에서 직접 데이터를 읽는 것을 목표로 합니다. 이는 불변 시계열 조각에 대한 새로운 Cassandra 압축 전략인 ReadOnlyCompactionStrategy(ROCS)를 도입했습니다. ROCS는 SSTable을 토큰 범위와 정렬하여 읽기 분산을 줄이고 모든 티어에 걸쳐 지연 시간을 개선합니다.Cassandra는 데이터를 S3에 백업하고 SSTable 경로를 나열하는 매니페스트를 생성합니다. 두 번째 솔루션은 불변 시계열 조각에 대해 이러한 S3 백업에서 직접 읽도록 Cassandra를 사용자 정의합니다. 이는 읽기를 리디렉션하기 위해 플러그형 Memtable, 특히 "backupmemtable"을 사용합니다. 이 백업 Memtable은 필요한 인덱스 및 메타데이터 파일을 S3에서 노드로 다운로드합니다. 강력한 복원력 메커니즘은 구성 요소의 안정적인 다운로드 및 초기화를 보장합니다. 로컬 구성 요소가 준비되면 Cassandra는 이러한 백업에서 읽기를 제공하고, S3 읽기를 병렬화하며, 추가 최적화를 위해 캐싱을 활용합니다. 이 전략은 별도의 스트리밍 인프라를 제거함으로써 운영 오버헤드와 인프라 비용을 크게 줄입니다. TimeSeries Tiered Storage Journey: Kafka/Flink Streams to Native Cassandra Cold Reads netflixtechblog.com +1
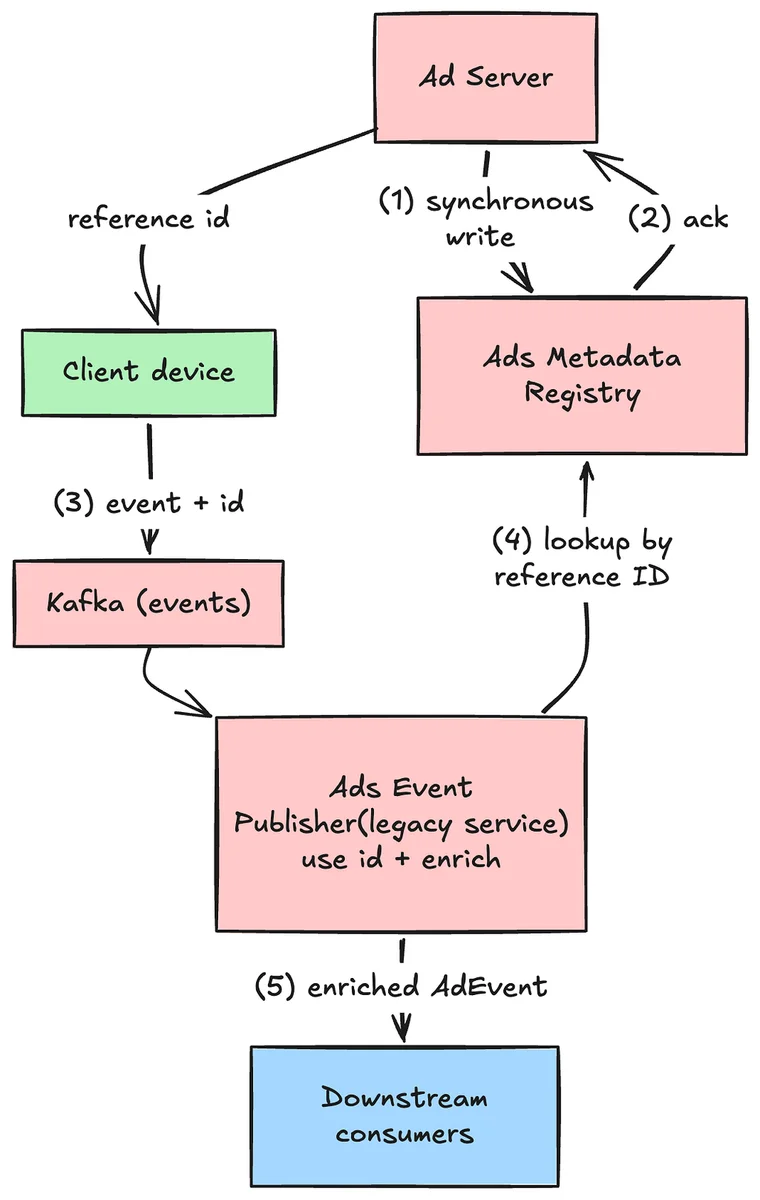
비하인드 스토리: 라이브를 위한 넷플릭스 광고 이벤트 파이프라인 진화 - 2부 Netflix는 특히 라이브 스트리밍 광고의 증가하는 규모와 복잡성을 처리하기 위해 광고 이벤트 게시자(Ads Event Publisher)를 재구축했습니다. 이전 시스템은 광고 메타데이터 보강을 위해 Key-Value 저장소를 사용했습니다. 이 접근 방식은 기능적이었지만, 라이브 이벤트에 부적합한 확장 병목 현상과 중요 경로 종속성을 야기했습니다. 라이브 스트림은 더 강력하고 탄력적인 솔루션을 요구하는 방대하고 급증하는 트래픽을 생성합니다.새로운 아키텍처는 상태 저장 스트림 처리 프레임워크인 Apache Flink를 사용하여 거의 실시간으로 보강합니다. 광고 서버 응답 로그는 데이터베이스 대신 Kafka로 전송됩니다. 그런 다음 Flink는 이러한 응답과 클라이언트 생성 광고 이벤트 간의 실시간 스트리밍 조인을 수행합니다. 이를 통해 중요 서빙 경로에서 직접적인 데이터베이스 쓰기를 제거하여 장애를 방지하고 확장성을 향상시킵니다.Flink 작업은 이벤트를 정규화하고 올바른 처리 영역으로 라우팅하며, 특히 상태 저장 조인을 수행합니다. 최근 광고 서빙 응답을 메모리에 유지하고 구성 가능한 창(일반적으로 60분) 내에서 들어오는 클라이언트 이벤트를 일치시킵니다. 이 접근 방식은 두 이벤트가 모두 사용 가능한 경우 즉석 보강을 가능하게 합니다. 이벤트가 먼저 도착하면 해당 응답이 나타날 때까지 보류됩니다.지역 간 보강을 해결하기 위해 시스템은 모든 서빙 응답을 전역적으로 복제하는 대신 광고를 제공한 영역으로 클라이언트 이벤트를 라우팅하여 비용 효율성을 높입니다. 광고 토큰에는 이제 서빙 영역 정보가 포함됩니다. 60분 창은 대부분의 이벤트를 포함하지만, 청구 및 보고를 위한 데이터 완전성을 보장하기 위해 늦게 도착하는 이벤트를 복구하기 위한 별도의 경로가 존재합니다. 이 상태 저장 스트림 처리 아키텍처는 Netflix의 진화하는 광고 요구 사항에 필요한 확장성과 복원력을 제공합니다. Behind the Scenes: Evolving Netflix’s Ads Event Pipeline for Live — Part II netflixtechblog.com +1
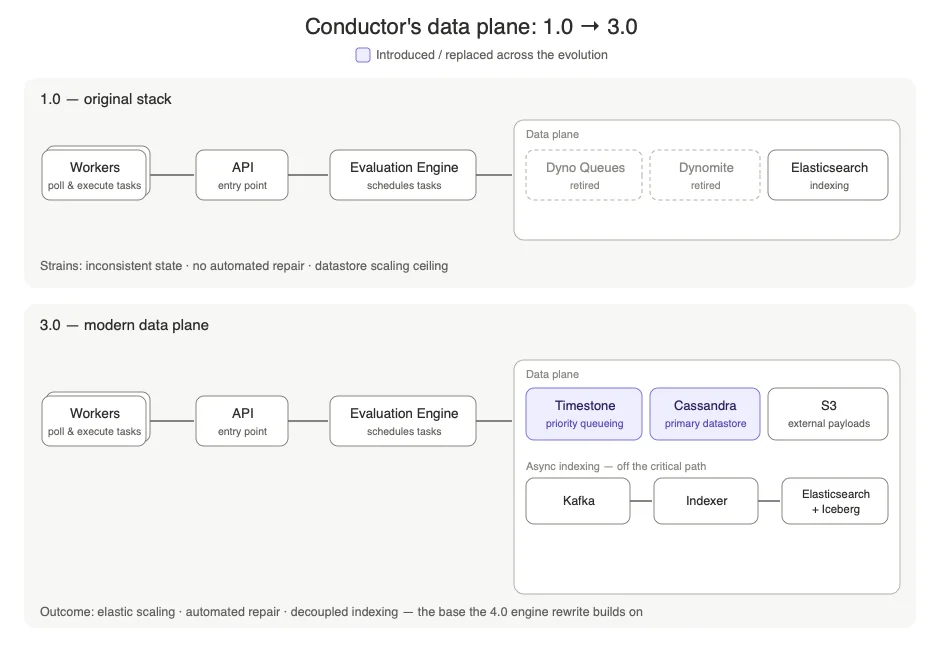
Netflix Conductor: 다음 챕터 Netflix Conductor는 초기 오픈소스 릴리스를 넘어 상당한 발전을 이루었습니다. 오픈소스 버전의 유지보수는 중단되었지만, 내부 개발이 가속화되어 완전한 재구축으로 이어졌습니다. Conductor의 규모는 폭발적으로 증가하여 연간 수십억 건의 워크플로우 실행을 처리하고 있으며, 이는 초기 마일스톤 달성과는 극명한 대조를 이룹니다. 이러한 성장은 데이터 플레인부터 평가 엔진에 이르기까지 거의 모든 시스템 계층의 현대화를 필요로 했습니다. Conductor는 이제 방대한 수의 워크플로우 정의를 지원하며, 콘텐츠 및 스튜디오 엔지니어링, 광고, 게임을 포함한 다양한 Netflix 비즈니스에 필수적입니다. 예를 들어, 미디어 프로덕션 스위트는 중요한 미디어 수집 및 처리 파이프라인을 위해 Conductor에 의존합니다. 아키텍처 측면에서 Conductor는 Dynomite 기반 스택에서 Cassandra를 기본 데이터 저장소로, Timestone을 큐잉에 사용하여 확장성과 안정성을 크게 향상시켰습니다. Conductor 3.0의 도입은 근본적인 문제를 해결했으며, Conductor 4.0은 핵심 평가 엔진을 재구축했습니다. 이 재작성은 메모리 효율성과 성능 향상을 위해 데이터를 분할하고, 동기식 병목 현상을 제거하기 위해 비동기 평가 모델을 도입했습니다. 전반적인 결과는 Netflix의 막대한 운영 요구 사항을 처리할 수 있는 보다 강력하고 확장 가능하며 성능이 뛰어난 워크플로우 오케스트레이션 엔진입니다. Netflix Conductor: The Next Chapter netflixtechblog.com +1
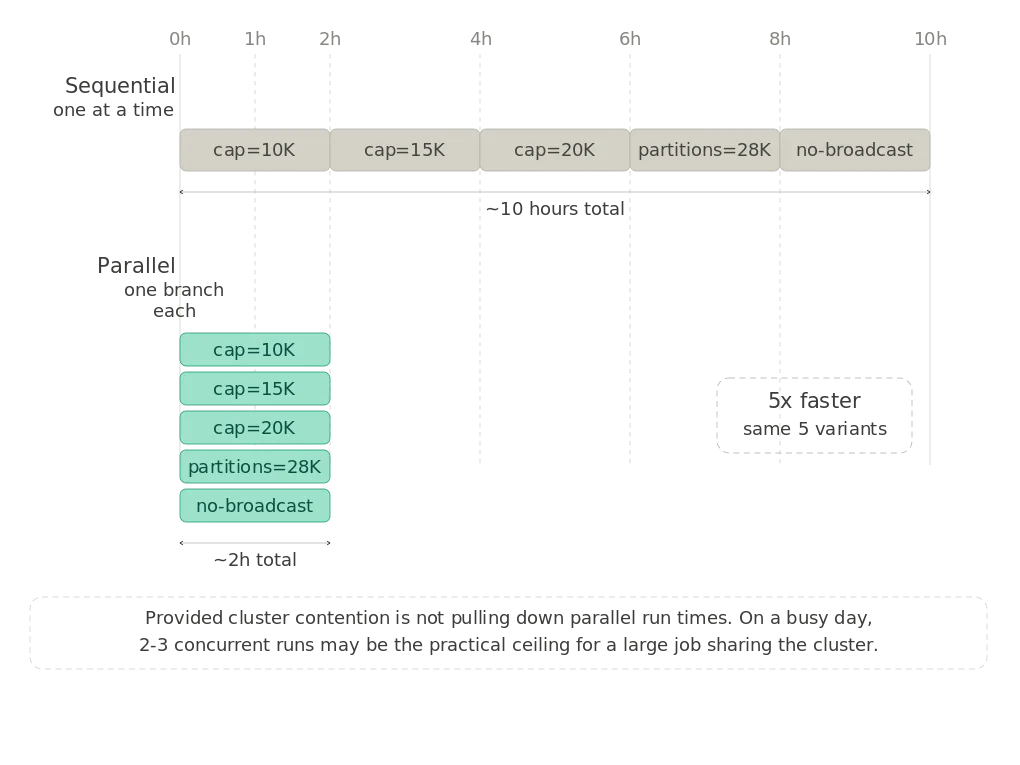
잠자는 동안 (그리고 비행기 안에서) 아파치 스파크 실험 실행하기 Netflix의 member-sessionizer는 사용자 시청 세션을 생성하기 위해 수십억 개의 이벤트를 처리하는 중요한 데이터 파이프라인입니다. 데이터 편향으로 인해 샘플링되지 않은 대규모 데이터셋에서만 발생하는 Out-Of-Memory 오류와 같은 문제는 Netflix의 프로덕션 규모에서 표준 디버깅 접근 방식으로는 해결되지 않았습니다. 저자의 돌파구는 단일 실행 속도를 높이는 것에서 여러 동시 실험을 가능하게 하는 것으로 초점을 전환한 것이었습니다. 이는 Dataflow의 브랜치 기반 개발을 활용하여 각 테스트 변형을 격리함으로써 달성되었습니다.스케줄러를 매개변수화하고 각 실험에 자체 브랜치와 출력 테이블을 할당함으로써 여러 테스트를 동시에 실행할 수 있었습니다. 이는 테스트당 총 실행 시간을 몇 시간에서 가장 긴 단일 작업의 지속 시간으로 크게 단축했습니다. AI 에이전트는 수많은 병렬 실험을 실행하는 운영 복잡성을 관리하고, 구성 업데이트, 작업 트리거 및 메트릭 폴링을 자동화하는 데 사용되었습니다. 이를 통해 저자는 지루한 수동 확인에서 벗어나 즉시 결과를 비교할 수 있었습니다.Netflix의 클라우드 개발 환경에서 지속적인 tmux 세션은 수 시간 동안 실행되는 Spark 작업이 네트워크 끊김이나 노트북 종료로 인해 중단되는 것을 방지하는 데 중요했습니다. 핵심 성능 병목 현상은 전체 이벤트 백을 메모리에 버퍼링하는 collect_list 연산자와 비효율적인 데이터 구조로 확인되었습니다. 특히, 세션 ID를 UUID 문자열로 변경하고 필드에 Scala Options를 사용하는 것은 메모리 사용량을 크게 증가시켰습니다. 또한, 부풀려진 문자열 속성은 각 이벤트에 불필요한 부담을 추가했습니다.수정 사항에는 Options에서 기본 필드를 언박싱하고 사용되지 않는 속성을 제거하여 이벤트 백을 축소하는 것이 포함되었습니다. 세션에 불변하는 메타데이터는 세션 헤더로 옮겨졌습니다. 두 가지 직관에 반하는 발견은 Spark 메모리 관리의 복잡성을 강조했습니다. 행을 좁히는 것이 브로드캐스트 조인을 강제하여 더 빠른 OOM을 유발할 수 있었고, Adaptive Query Execution은 브로드캐스트 해시 조인을 통해 메모리에 대량의 데이터를 조용히 축적했습니다. AQE의 브로드캐스트 임계값을 조정하여 이 문제를 해결했습니다.체계적인 로깅 시스템은 각 실험, 해당 구성 및 주요 메트릭을 추적하여 단일 진실 공급원을 만들고 격리된 변수 변경을 강제했습니다. 세션 잘림 수정 사항을 Spark Window 스테이지 이전에 테스트하는 실수가 있었는데, 이는 잘림 전에 메모리를 버퍼링했습니다. 최종적으로 수정된 수정 사항은 메모리 부풀림을 방지하기 위해 잘림을 업스트림으로 옮겼습니다. 이러한 튜닝 노력은 즉각적인 문제를 해결했지만, 전체 세션을 단일 행으로 집계하는 근본적인 데이터 형태는 미래의 확장성 문제를 제기합니다. Running Apache Spark experiments in my sleep (and on a plane) netflixtechblog.com +1
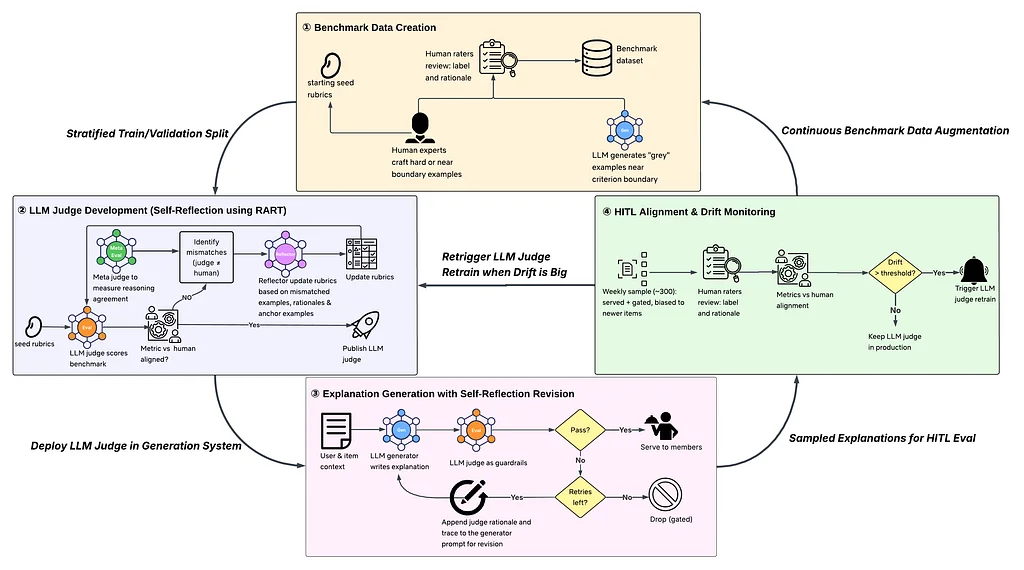
LLM-as-a-Judge의 라이프사이클: 구축, 정렬 및 대규모 모니터링 LLM을 이용한 대규모 텍스트 생성에는 수동 검토의 한계로 인해 자동 평가가 필수적입니다. LLM-as-a-Judge 접근 방식은 두 번째 LLM을 사용하여 첫 번째 LLM의 출력을 평가하지만, 평가자의 신뢰성에 대한 우려를 제기합니다. 이 문제는 LLM 판사를 구축, 조정하고 지속적으로 모니터링하여 모든 단계에서 인간의 판단에 고정되도록 함으로써 해결됩니다. 인간은 품질 표준을 정의하고, 레이블이 지정된 데이터셋을 생성하며, 판사의 행동을 모니터링하고, 업데이트를 승인합니다.신뢰할 수 있는 LLM 판사는 정적이지 않습니다. 생성, 조정, 운영 및 유지 관리에서 인간의 소유권을 포함하는 수명 주기를 가집니다. 이 과정은 항목 추천을 설명하는 짧은 메시지인 추천 설명 생성 작업을 통해 설명됩니다. 오해의 소지가 있는 설명은 사용자 신뢰를 약화시키기 때문에 품질이 중요합니다.LLM 판사 수명 주기는 탄생, 훈련, 배포 및 HITL 조정 및 드리프트 모니터링의 네 가지 단계로 구성됩니다. 탄생 단계에서는 인간 전문가가 적대적 및 경계 예제를 포함한 벤치마크 데이터를 제작하며, 이는 인간 평가자에 의해 레이블이 지정됩니다. 훈련 단계에서는 자기 성찰 및 루브릭 업데이트를 사용하여 LLM 판사를 인간 레이블 및 합리화에 맞게 조정합니다. 배포 단계에서는 판사를 설명 생성 시스템 내에서 게이트 및 비평가로 통합합니다.HITL 조정 및 드리프트 모니터링은 인간 평가자와 주기적으로 판사를 벤치마킹하고 시스템 변경에 대한 인간의 승인을 요구함으로써 지속적인 신뢰성을 보장합니다. 이 단계에서는 메타 판사를 사용하여 LLM 판사의 합리화와 인간의 합리화를 비교하여 판사가 잘못된 이유로 올바른 답에 도달하는 경우를 포착합니다. 새로운 인간 레이블 데이터와 신호를 통합하는 이 지속적인 피드백 루프는 벤치마크 및 개발 단계로 다시 피드백됩니다. 시스템 구성 요소에는 생성기, 판사, 반성기, 메타 판사, 인간 전문가 및 평가자가 포함되며, 이들은 모두 수명 주기 단계 전반에 걸쳐 협력하여 판사의 무결성을 유지합니다. The Lifecycle of LLM-as-a-Judge: Building, Aligning, and Monitoring at scale netflixtechblog.com +1
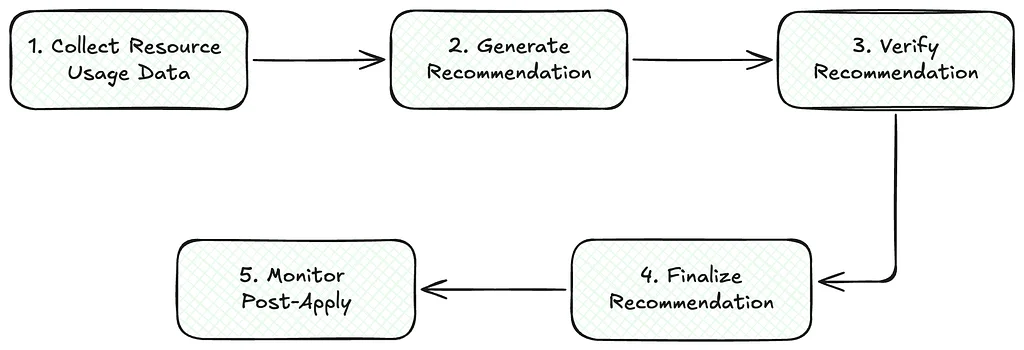
Netflix Stratum Media Processing: 자동화된 컨테이너 최적화 Stratum은 Netflix의 내부 서버리스 미디어 처리 플랫폼으로, 인코딩 및 패키징과 같은 다양한 미디어 워크로드를 처리하는 데 필수적입니다. 엔지니어는 Stratum 함수를 OCI 이미지로 정의하며, 이는 Titus 컴퓨팅 플랫폼에서 배치 작업으로 예약됩니다. 수십만 개의 컨테이너를 관리하는 Stratum은 팟캐스트 및 라이브 이벤트와 같은 새로운 콘텐츠 형식에 대한 동적 확장이 필요합니다. YAML로 지정된 리소스 요청은 인프라 및 애플리케이션 변경 사항의 진화로 인해 종종 과도하게 프로비저닝되어 비효율성과 운영 비용 증가를 초래합니다.이를 해결하기 위해 Netflix는 프로덕션에서 컨테이너 리소스를 올바르게 조정하도록 설계된 자동화 시스템인 Stratum Resource Tuner(SRT)를 개발했습니다. SRT는 리소스 사용량의 70-80%를 차지하는 지연 시간 요구 사항이 완화된 고처리량 워크로드에 초점을 맞춰 수동 리소스 구성을 제거하는 것을 목표로 합니다. 함수 소유자는 리소스 유형(CPU, 메모리, 디스크, 네트워크)별 자동 조정 기능을 선택할 수 있습니다.SRT 워크플로우는 리소스 사용량 메트릭 수집, 권장 사항 생성, 실험을 통한 권장 사항 검증, 권장 사항 적용 또는 거부, 적용 후 메트릭 모니터링의 다섯 단계로 구성됩니다. 권장 사항은 CREATED, EVALUATING, APPLIED, REJECTED, MONITORED 상태를 거칩니다. 예를 들어, VideoEncoder.encodeV1 함수의 과도하게 프로비저닝된 메모리와 CPU는 성공적으로 조정되었습니다.메트릭 수집은 강력하며, 단기 조회를 위해 Elasticsearch에 실행 수준 요약이 저장되고 장기 추세 분석을 위해 Iceberg 테이블에 고해상도 원시 사용량 메트릭이 저장됩니다. Conductor 워크플로우는 매일 실행되며, 한 달간의 Iceberg 데이터를 사용하여 모든 함수 및 리소스 유형에 대한 권장 사항을 생성합니다. 이 프로세스에는 고처리량 워크로드 필터링, CPU 및 네트워크(p99 사용량)의 공격적인 조정, 메모리 및 디스크(안전 버퍼가 있는 p99.9 사용량)의 보수적인 조정이 포함됩니다.권장 사항이 너무 작으면 폐기하고, 메모리 및 디스크의 최대 감소를 주기당 15%로 제한하는 등 안전 장치가 마련되어 있습니다. 권장 사항은 CREATED 상태로 생성되며 이 단계를 지나면 변경할 수 없습니다. 예시는 단일 단계에서 CPU 권장 사항이 8에서 4로, 메모리가 18000MB에서 15300MB로 감소하는 것을 보여주며, 이는 비용 최적화에서 SRT의 실제 적용을 보여줍니다. Netflix Stratum Media Processing: Automated Container Right-Sizing netflixtechblog.com +1
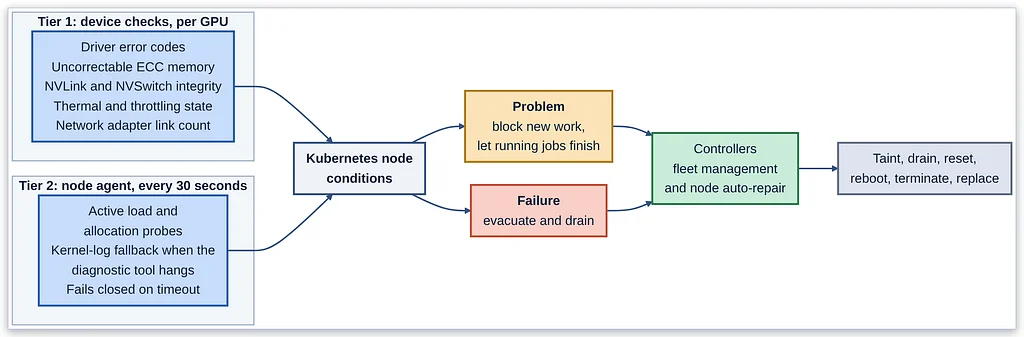
대규모 학습 및 추론 작업을 위한 안정적인 GPU 컴퓨팅 Netflix는 개인화된 콘텐츠 추천 및 기타 머신러닝 애플리케이션을 위해 GPU에 크게 의존합니다. 이러한 GPU는 콘텐츠를 학습하고 제공하는 데 필수적이므로, 가용성과 비용 효율성 모두에 있어 안정성이 비즈니스 필수 요소입니다. 기본적인 클라우드 제공업체의 상태 확인은 장시간 실행되는 학습 작업에 치명적인 미묘한 GPU 또는 네트워크 패브릭 장애를 감지하지 못하기 때문에 불충분합니다. 이러한 장애는 성능 저하 또는 작업 중단으로 나타날 수 있으며, 사용자 경험에 영향을 미치고 리소스를 낭비합니다.Netflix는 GPU 인프라 상태를 보장하기 위해 계층화된 접근 방식을 사용합니다. 첫 번째 계층은 GPU 및 네트워크 어댑터와 같은 실패하는 하드웨어를 감지하고 복구하는 데 중점을 둡니다. 두 번째 계층은 작업을 재시도하고 사용 전에 머신을 검증하는 스케줄러 및 플랫폼을 포함합니다. 세 번째 계층은 체크포인팅 및 탄력적 워커를 통해 머신 손실에서 장시간 실행되는 작업이 생존할 수 있도록 합니다. 네 번째 계층은 다른 세 계층의 효과를 모니터링하는 관찰 가능성입니다.상태 확인은 두 가지 계층으로 작동합니다. 개별 GPU에 대한 장치 수준 확인과 에이전트가 수행하는 노드 수준 확인입니다. 이러한 확인은 Kubernetes 노드 조건으로 결과를 보고합니다. 문제가 감지되면 머신의 조건이 업데이트되고 컨트롤러가 조치를 취합니다. 초기 문제는 허용되지만, 지속적인 장애는 머신 대피, 드레인 및 교체로 확대됩니다.복구는 등급별로 이루어지며, 단일 GPU를 다시 시작하는 것부터 전체 머신을 종료하고 교체하는 것까지 오류 심각도에 맞춰 조치가 이루어집니다. 지속적으로 실패하는 하드웨어의 경우, 불변 식별자가 기록되어 풀에 다시 참여하는 것을 방지합니다. 머신은 모든 진단을 통과하도록 보장하기 위해 작업에 투입되기 전에 검증됩니다. 마지막으로, 체크포인팅을 통해 장시간 실행되는 작업이 복원력을 갖추게 되어, 머신이 손실될 경우 마지막 안정적인 상태에서 재개할 수 있습니다. Reliable GPU compute for large training & inference jobs netflixtechblog.com +1
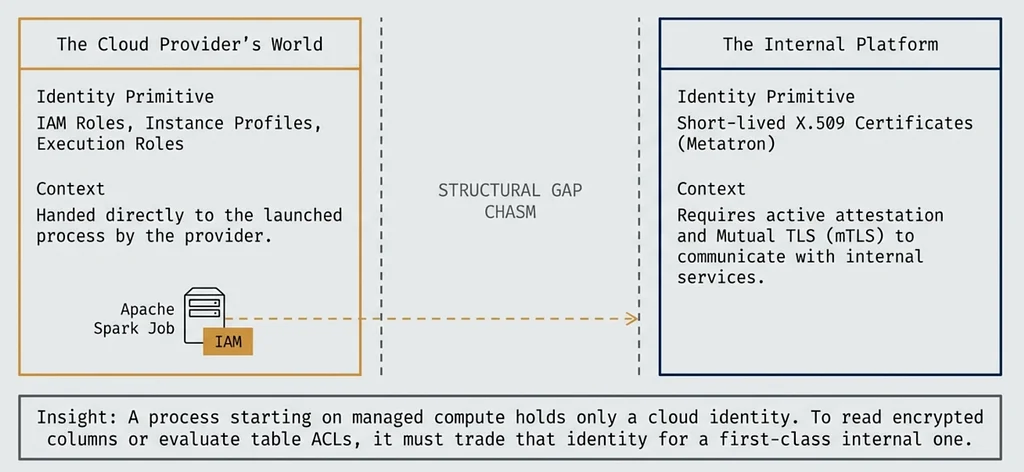
클라우드 ID를 자신의 것으로 거래하기: 관리형 컴퓨팅에서의 워크로드 증명 조직은 종종 클라우드 제공업체(AWS 등)의 시스템과 내부 서비스용 시스템이라는 두 개의 병렬 ID 시스템을 유지합니다. 이 게시물은 Amazon EMR의 Apache Spark 워크로드가 이 간극을 어떻게 해소하여 초기 클라우드 ID에서 일급 내부 ID를 얻을 수 있도록 하는지 자세히 설명합니다. Netflix는 서비스 간 상호 TLS 인증을 위해 Metatron이라는 비공개 PKI를 사용하며, 워크로드 ID를 확인하기 위한 증명 프로세스가 필요합니다. 또한 데이터 소유 및 자체 ID를 갖는 "데이터 프로젝트" 개념을 사용하여 액세스 제어 및 감사 일관성을 보장합니다.핵심 과제는 관리형 컴퓨팅에서 Spark 작업에 필요한 내부 ID로 클라우드 기반 AWS 실행 역할을 변환하는 것입니다. 이 솔루션은 각 데이터 프로젝트 ID와 전용 IAM 역할 간에 일대일 직접 매핑을 설정하며, 데이터 프로젝트 서비스가 이 매핑에 대한 권한자 역할을 합니다. 이 매핑은 클라우드 제공업체의 어휘에서 조직의 내부 어휘로 문장을 변환하는 데 중요합니다. 수많은 IAM 역할을 관리하는 확장성 문제를 해결하기 위해 이러한 역할은 전용 AWS 계정의 작은 풀에 결정론적으로 샤딩됩니다.다섯 가지 구성 요소가 포함됩니다. 제어 평면(작업을 시작하고 메타데이터에 서명), 데이터 프로젝트 서비스(ID-역할 매핑 관리), ID 서비스(증명을 확인하고 인증서 발급), Spark 플러그인(프로세스 부트스트래핑에 후킹), AWS STS(공증인 역할). 프로세스는 제어 평면이 워크로드 세부 정보가 포함된 메타데이터 페이로드에 서명하는 것으로 시작됩니다. 이후 Spark 드라이버 플러그인은 AWS STS에서 사전 서명된 URL을 생성하기 위해 AWS 자격 증명을 사용하여 클라우드 ID 소유권을 증명합니다.그런 다음 ID 서비스는 사전 서명된 URL에서 식별된 역할과 제어 평면의 서명된 메타데이터라는 두 가지 독립적인 주장을 모두 확인합니다. 일치하는 경우 워크로드에 대한 인증서가 발급됩니다. 제공업체의 주장은 위조할 수 없지만 불완전하고 제어 평면의 주장은 완전하지만 잠재적으로 재현 가능하므로 이 두 주장만으로는 충분하지 않기 때문에 이 확인이 중요합니다. 이 시스템은 드라이버가 한 번 증명하고 자격 증명을 안전하게 배포함으로써 실행자에 대한 팬아웃 문제를 해결합니다. 인증서는 수명이 짧으며 드라이버 JVM 내의 반복 가능한 증명 프로세스를 통해 갱신됩니다. 신뢰 모델은 단일 참가자가 독립적으로 ID를 발급할 수 없도록 보장하며, 워크로드 자체는 자신의 합법성을 보증할 필요가 없습니다. Trading a Cloud Identity for Your Own: Workload Attestation on Managed Compute netflixtechblog.com +1
클래스 패스를 백미러에 남겨두세요 ja와 그 컴포저블 명령줄 도구의 새로운 미리보기가 Java 개발을 현대화하는 것을 목표로 합니다. 이러한 도구는 Java 모듈 시스템을 활용하여 모듈 생성 및 사용을 단순화합니다. 모듈 설명자는 종속성 버전 및 메타데이터를 포함하여 프로젝트를 완전히 설명하도록 향상되었습니다. jig와 같은 도구는 모듈 확인, 컴파일 및 조립을 처리하며 Maven 리포지토리로의 다리 역할을 합니다. jfmt는 더 깨끗한 Java 코드를 위해 코드 서식 규칙을 강제합니다. jist는 더 쉬운 코드 탐색을 위해 소스 인식 심볼 검색을 제공합니다. jdocserver는 로컬 API 문서 브라우징을 제공합니다. 이러한 도구는 JDK의 도구 검색 및 실행 기능과 통합됩니다. jdeps 및 jlink와 같은 표준 JDK 도구로의 원활한 전환을 제공합니다. 이 시스템은 모듈 좌표를 추론하고 표준 좌표를 설정하여 기존 Maven 아티팩트의 문제를 해결합니다. 기본적으로 무결성은 런타임 액세스 요구 사항의 명시적 선언 및 승인을 허용하여 무단 변형을 방지함으로써 강제됩니다. 이를 통해 모듈 상호 작용에 대한 더 큰 보안 및 제어를 보장합니다. Leave the Class Path in the Rearview Mirror netflixtechblog.com +1
MAPS: Netflix의 멀티모달 에셋 개인화 대규모 적용 Netflix는 아트워크 및 비디오 미리보기와 같은 개인화된 시각적 자산을 통해 회원들이 좋아할 만한 콘텐츠와 연결하는 것을 목표로 합니다. 새로운 타이틀의 경우, 불충분한 상호작용 데이터로 인해 효과적인 개인화가 불가능해지는, 즉 콜드 스타트 문제로 알려진 문제가 발생합니다. 전통적으로 모델은 자산을 불투명한 ID로 취급하고, 충분한 데이터가 축적될 때까지 인기도 휴리스틱에 의존했습니다. 이는 새로운 콘텐츠에 대한 개인화가 지연되어 발견 경험에 영향을 미쳤습니다.Netflix의 솔루션은 멀티모달 임베딩을 사용하여 모델이 자산을 "보고" "들을" 수 있도록 하는 것입니다. 사전 훈련된 이미지-텍스트 모델인 CLIP으로 아트워크를 인코딩함으로써 자산은 시각적 이해를 얻게 됩니다. 이 CLIP 임베딩은 자산의 ID 임베딩과 연결되어 시각적 테마와 재능을 포착하는 더 풍부한 표현을 생성합니다. 이를 통해 자산이 상호작용 기록이 전혀 없더라도 회원들의 시각적 스타일에 대한 선호도를 기반으로 개인화가 가능해지며, 타이틀 간 지식 이전이 용이해집니다.이 접근 방식은 또한 모델 통합을 가능하게 하여, 서로 다른 아트워크 캔버스에 대한 별도의 모델을 단일 통합 모델로 병합합니다. CLIP 임베딩은 자르기 및 크기 조정에 크게 영향을 받지 않기 때문에, 거의 동일한 아트워크 렌더링이 유사한 벡터에 매핑됩니다. 특히 데이터가 적은 캔버스에 이점을 주는 캔버스 전반의 상호작용 신호 풀링을 통해 단일 모델이 모든 아트워크 배치를 개인화할 수 있습니다. 캔버스 간 데이터 불균형을 해결하기 위해, 노출량보다는 장기적인 가치에 기반한 상호작용을 우선시하는 보상 기반 가중치가 사용됩니다.이 접근 방식의 효과는 역확률 점수(inverse propensity scoring)를 사용한 오프라인 평가와 대규모 A/B 테스트를 통해 검증되었습니다. 이미지 임베딩과 통합 모델(V3)을 결합한 결과는 이 개선 사항 중 하나만 포함한 모델보다 훨씬 뛰어났습니다. 이 결합된 접근 방식은 최소한의 과거 데이터로 지배적인 캔버스가 도입된 주요 Netflix 홈 화면 재설계 중에 중요함이 입증되었습니다. CLIP 임베딩을 갖춘 통합 모델은 이 새로운 레이아웃에 대한 콘텐츠를 성공적으로 개인화했으며, 발견 지표 및 스트리밍 시간에서 통계적으로 유의미한 향상을 보여주며, 콜드 스타트 문제를 극복하는 데 있어 멀티모달 임베딩의 힘을 강조했습니다. MAPS: Netflix’s Multimodal Asset Personalization at Scale netflixtechblog.com +1
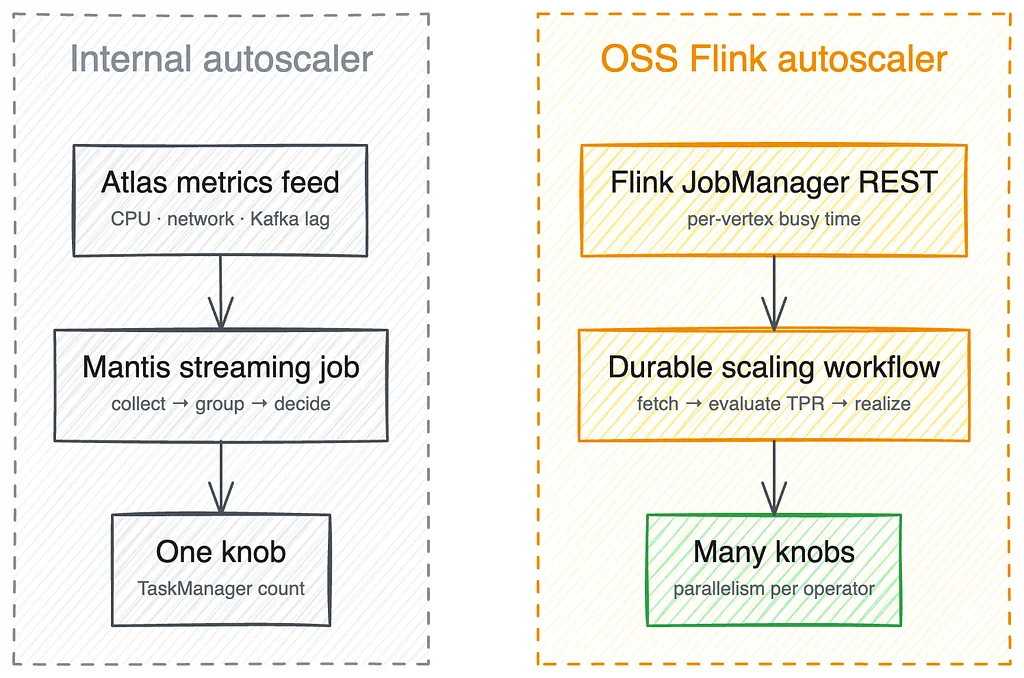
두 개의 플링크 자동 스케일러 이야기 Netflix는 현재 두 개의 Flink autoscaler를 운영 중이며, 이를 하나의 오픈소스 솔루션으로 통합하는 것을 목표로 하고 있습니다. 처음에는 수천 개의 Flink 작업을 관리하기 위해 자체 autoscaler를 구축했는데, 이는 효과적이었지만 복잡한 멀티-오퍼레이터 작업을 처리하는 데는 한계가 있었습니다. 이 자체 개발 시스템은 외부 메트릭에 의존했는데, 이는 부정확하거나 내부 작업 문제를 놓칠 수 있었습니다. 이후 Apache Flink 커뮤니티는 작업 자체 내부에서 추론하는 더 정교한 autoscaler를 개발했습니다. 이 두 번째 autoscaler는 오퍼레이터의 실제 처리율을 추정하여 각 버텍스별 최적의 병렬성을 결정합니다. Netflix는 상태 저장 작업을 확장하고 세분화된 구성을 허용하는 능력 때문에 이 오픈소스 솔루션으로 수렴하고 있습니다. Netflix에 OSS autoscaler를 구현하는 데는 기존 제어 평면에 통합하는 것을 포함하여 상당한 조정이 필요했습니다. 또한 메트릭 수집을 개선하고 순방향 연결된 서브그래프 및 싱크 제한과 같은 특정 작업 구조를 처리하기 위해 Flink 런타임을 수정했습니다. OSS autoscaler를 채택함으로써 Netflix는 상당한 비용 절감과 리소스 활용도 향상을 달성했습니다. 학습된 교훈은 메트릭 품질이 중요하며, 조정 가능한 기본값이 유익하고, 기존 솔루션을 확장하기 전에 채택하는 것이 현명한 전략임을 강조합니다. 운영을 간소화하기 위해 OSS 기반 autoscaler로 완전히 마이그레이션할 계획입니다. A Tale of Two Flink Autoscalers netflixtechblog.com +1
Netflix는 실시간 분산 그래프를 어떻게 구축하고 왜 구축했는가: 3부 — gRPC를 사용한 그래프 쿼리… Netflix는 내부 파트너를 위한 실시간 인사이트를 제공하기 위해 Real-Time Distributed Graph를 구축했으며, 이 블로그 시리즈의 세 번째 부분은 그래프를 효율적으로 쿼리하는 데 중점을 둡니다. 이 그래프는 수십억 개의 노드와 엣지로 이루어진 복잡한 네트워크이며, 이를 쿼리하려면 빠르고 유연한 서빙 레이어가 필요합니다. 저자들은 광범위한 액세스 패턴을 처리하고 얕고 넓은 쿼리와 깊고 좁은 쿼리를 모두 지원하는 것을 포함하여 그래프 쿼리의 어려움에 대해 논의합니다. 그들은 지연 시간을 최소화하기 위해 너비 우선 접근 방식과 비동기 컴포지션을 사용하여 그래프를 효율적으로 쿼리하기 위한 서빙 레이어를 설계하는 방법을 설명합니다. 저자들은 또한 쿼리 레이어 설계에서 캐싱, 옵트인 강화, 최종 일관성의 중요성에 대해 논의합니다. 쿼리 레이어는 그래프 쿼리 서비스, 스토리지 추상화 레이어, 강화 레이어의 세 가지 레이어로 구성되며, 이들은 함께 쿼리를 효율적으로 실행합니다. 저자들은 쿼리 레이어가 실제로 작동하는 방식을 보여주기 위해 예제 쿼리를 통해 설명하며, 요청을 읽고 해석하는 것, 스토리지에서 효율적으로 읽는 것, 너비 우선 레벨로 순회를 실행하는 것, 많은 작업을 병렬로 실행하는 것, 스마트하게 필터링하는 것, 캐싱으로 반복 쿼리를 더 빠르게 만드는 것의 중요성을 강조합니다. 쿼리 레이어의 목표는 100ms 미만으로 쿼리를 완료하는 것이며, 저자들은 그들의 설계가 이 목표를 어떻게 달성하는지 보여줍니다. 쿼리 레이어는 초당 수만 건의 쿼리를 처리하도록 설계되었으며, 각 쿼리는 잠재적으로 다를 수 있습니다. 저자들은 이 수준의 성능을 달성하기 위해 쿼리 레이어를 설계하면서 내린 절충안에 대해 논의합니다. 전반적으로 저자들은 대규모 분산 그래프를 위한 고성능 쿼리 레이어를 구축하는 데 관련된 어려움과 절충안을 강조하면서 쿼리 레이어의 설계 및 구현에 대한 자세한 개요를 제공합니다. 쿼리 레이어는 Real-Time Distributed Graph의 중요한 구성 요소이며, 저자들의 설계 및 구현은 Netflix가 내부 파트너를 위한 실시간 인사이트를 제공할 수 있도록 했습니다. How and Why Netflix Built a Real-Time Distributed Graph: Part 3 — Querying the graph with gRPC… netflixtechblog.com +1
분석을 위한 장치 기능 모델링 Netflix는 다양한 기기에서 폭넓은 기능과 콘텐츠 유형을 제공하지만, 하드웨어 제약으로 인해 특정 기기에서는 일부 기능이 제한될 수 있습니다. 이를 해결하기 위해 회사는 기기 기능을 이해하고 최상의 사용자 경험을 보장하기 위한 포괄적인 기기 기능 데이터 모델을 개발했습니다. 이 데이터 모델은 내부 시스템의 기능 플래그를 통합하여 전 세계 기기 환경 전반에 걸쳐 스마트한 기능 관리를 가능하게 합니다. 기기 기능(예: 화면 해상도, 비디오 프로필, RAM 크기)에 대한 정보를 저장하기 위해 누적 테이블이 사용되며, 이는 분석 및 보고에 이상적입니다. 이 테이블은 각 기기와 관련 기능의 최신 상태를 캡처하도록 구성되어 있어 정보 처리를 효율적으로 할 수 있습니다. 집계 분석을 위해 히스토그램 테이블이 사용되어 지난 28일 동안의 활성 기기 수를 기기 모델 및 소프트웨어 버전별로 분류하여 캡처합니다. 이 테이블은 특정 기능을 지원하는 기기 수도 기록하여 상세한 분포 분석을 가능하게 합니다. 히스토그램 데이터는 HD 또는 UHD 프로필을 지원하는 기기 비율과 같은 외부 디스플레이 기능의 분포를 분석하는 데 사용될 수 있습니다. 이러한 데이터 세트를 활용하여 Netflix는 4K Ultra HD, Netflix Spatial Audio, Cloud Gaming을 포함한 기능 도달 범위에 대한 포괄적인 보기를 제공하는 분석 제품을 구축했습니다. 회사는 데이터 기반 통찰력을 사용하여 특정 기기에서 어떤 기능을 활성화할지에 대한 정보에 입각한 결정을 내리고 성능과 안정성을 모두 보장합니다. Modeling Device Capabilities for Analytics netflixtechblog.com +1
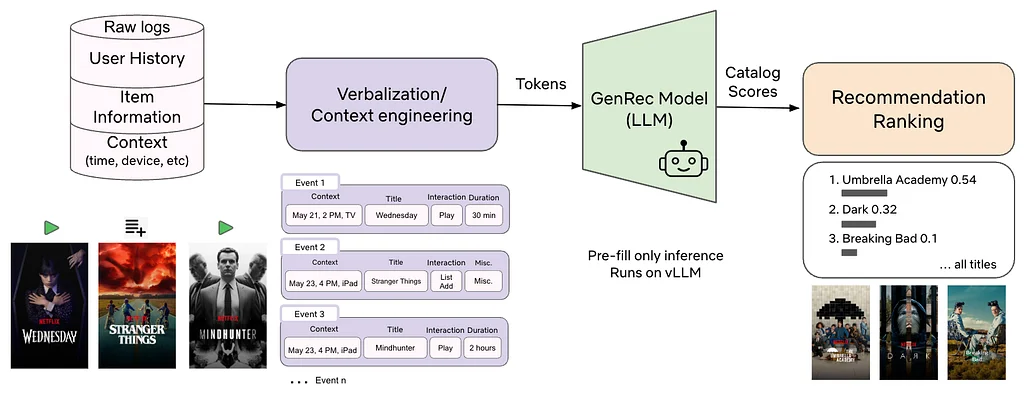
GenRec: 넷플릭스의 LLM 네이티브 추천을 향해 추천은 Netflix 경험의 중요한 부분이며, 회사는 수천 개의 수작업 기능과 특화된 아키텍처에 의존하는 복잡한 프로덕션 모델을 사용해 왔습니다. 그러나 이러한 모델은 유지 관리 및 업데이트 비용이 많이 들기 때문에 회사는 더 효율적이고 효과적인 솔루션을 찾고 있습니다. 대규모 언어 모델은 이 분야에서 가능성을 보여주었지만, 아직 프로덕션 준비가 되지 않았으며 인기 콘텐츠를 과도하게 추천하거나 비즈니스 제약을 무시하는 등의 한계가 있습니다. 이를 해결하기 위해 Netflix는 Netflix별 데이터 및 목표에 대해 내부 기반 LLM을 후속 학습시키는 LLM 기반 추천 랭커인 GenRec을 구축했습니다. GenRec은 사용자 기록, 항목 메타데이터 및 컨텍스트를 텍스트로 구체화하고 카탈로그 인식 점수 헤드를 사용하여 항목의 순위를 매깁니다. 이 모델은 비즈니스 목표 및 장기적인 회원 만족도에 부합하기 위해 순위, 언어 및 보상 신호를 결합한 다중 목표 손실로 학습됩니다. GenRec은 잘 조정된 프로덕션 랭커에 비해 단기 및 장기 온라인 지표 모두에서 통계적으로 유의미한 개선을 보여주었으며, 레이블이 지정된 데이터 및 입력 신호의 일부만 사용했습니다. 이 모델은 vLLM을 사용하여 Netflix의 내부 LLM 스택에서 제공되며, 회사는 더 작은 모델, 공격적인 컨텍스트 압축 및 사전 채우기 전용 추론과 같은 서빙 비용을 제어하기 위한 전략을 구현했습니다. 전반적으로 GenRec은 Netflix의 추천을 위한 보다 LLM 중심적인 미래를 향한 중요한 발걸음을 나타내며, 그 성공은 회사가 추천 및 개인화에 접근하는 방식을 변화시킬 잠재력을 가지고 있습니다. 자연어 입력을 학습하고 개인화된 순위를 생성하는 모델의 능력은 사용자 경험을 개선하고 참여를 늘릴 잠재력을 가지고 있습니다. 대규모 언어 모델의 힘을 활용함으로써 Netflix는 비즈니스 성공을 이끄는 보다 효과적이고 효율적인 추천 시스템을 만들 수 있습니다. GenRec: Towards LLM-Native Recommendation at Netflix netflixtechblog.com +1
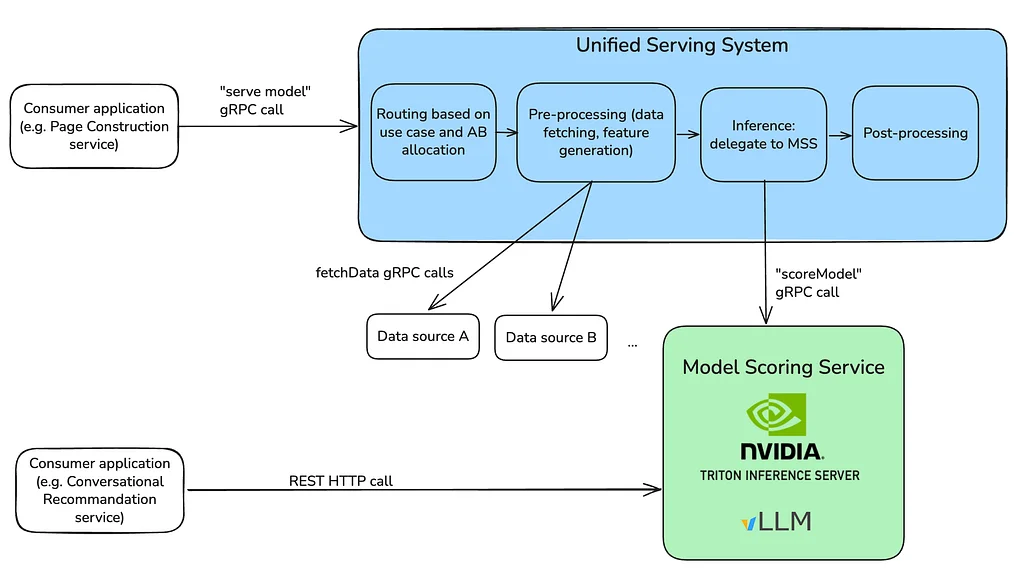
넷플릭스 사내 LLM 근무 Netflix는 전체 대규모 언어 모델 스택을 내부적으로 운영하며 배포 및 추론을 직접 관리합니다. 이들은 별도의 머신러닝 사일로 대신 기존 프로덕션 환경에 이를 통합했습니다. 이 접근 방식에는 추론 엔진의 신중한 선택, 모델 패키징 방식 결정, API 표면 설계, 배포 전략 정의, 출력 제약 조건 시행이 포함되었습니다.선택된 추론 엔진은 vLLM으로, 운영 적합성, 사용자 정의 아키텍처 로드 능력, 확장성, 디버깅 용이성, 실무자들의 익숙함 때문에 선택되었습니다. 모델은 Triton의 vLLM 백엔드를 사용하여 패키징되어 동적 I/O 텐서 사양을 허용하고 모델과 프론트엔드의 독립적인 발전을 촉진합니다. 더 넓은 생태계 호환성을 위해 기존 gRPC 인터페이스와 함께 OpenAI 호환 HTTP 프론트엔드가 추가되었습니다.배포를 위해 Netflix는 모델 버전 간의 잠재적인 스키마 변경을 처리하기 위해 Versioned 전략을 사용하여 소비자가 독립적으로 업데이트할 수 있도록 합니다. 모델 인터페이스가 안정적일 때는 비용이 덜 드는 Red-Black 배포 전략을 사용합니다. 한 가지 주요 운영 과제는 느린 모델 시작 시간이었으며, 이는 Amazon FSx에 대규모 모델을 구체화하여 더 빠른 액세스를 가능하게 함으로써 해결했습니다.vLLM과 Triton 모두의 데이터를 집계하는 통합 /metrics 엔드포인트를 생성하여 관찰 가능성을 개선했습니다. 중요한 기능은 vLLM의 사용자 정의 로짓 프로세서를 통해 구현된 대규모 제약 디코딩입니다. 이를 통해 모델은 추론 후 보정 없이 직접 규정을 준수하는 출력을 생성할 수 있습니다.제약 디코딩의 초기 순수 Python 구현은 Global Interpreter Lock (GIL)과 CPU에서의 순차 처리로 인해 확장성 문제가 있었습니다. 이는 높은 동시성에서만 명확해졌고 상당한 꼬리 지연 시간을 초래했습니다. 시스템은 배포, 버전 관리 및 자동 확장을 관리하기 위해 Java 제어 평면에 의존합니다. 실시간 및 캐시된 배치 추론 경로 모두 서비스 시스템에서 지원됩니다. 이 통합 시스템은 라우팅, 후보 생성 및 로깅을 포함한 전체 다운스트림 소비자 흐름을 처리합니다. In-House LLM Serving at Netflix netflixtechblog.com +1
대규모 서비스 토폴로지 구축: 아키텍처, 과제 및 교훈 Netflix는 엔지니어들이 분산 아키텍처를 문제 해결하고 이해하는 데 도움을 주기 위해 실시간 서비스 종속성 맵을 개발했습니다. 이 시스템은 eBPF 네트워크 흐름, IPC 메트릭, 분산 추적을 독립적인 그래프 레이어로 결합합니다. 초기 버전은 로컬에서 작동했지만, 프로덕션 환경에서는 Kafka 소비자 지연 및 메모리 문제와 같은 상당한 확장성 문제를 드러냈습니다.핵심 아키텍처 결정은 시간당 배치 처리 대신 거의 실시간에 가까운 토폴로지 업데이트를 제공하는 스트리밍 우선 접근 방식이었습니다. 이는 사고 대응 및 실시간 이벤트 모니터링에 중요했습니다. 초당 수백만 개의 흐름 기록을 데이터 손실 없이 처리하기 위해 이 시스템은 백프레셔를 갖춘 반응형 스트림을 사용하여 다운스트림 시스템이 과부하될 때 업스트림 구성 요소에 속도를 늦추도록 신호를 보냅니다. 이는 데이터 손실이나 충돌 대신 점진적인 성능 저하를 보장합니다.이 아키텍처는 네트워크, IPC, 추적 레이어에 대한 물리적 스토리지 격리를 갖춘 다층 설계를 사용하여 독립적인 최적화를 가능하게 합니다. 네트워크 레이어의 수집은 3단계 분산 집계 파이프라인에 의존합니다. 1단계는 Kafka에서 초기 집계를 수행하고, 2단계는 네트워크 중개자(로드 밸런서 등)를 직접 애플리케이션 수준 종속성으로 해석하며, 3단계는 최종 집계, 외부 데이터로의 강화, 그래프 데이터베이스에 대한 영구 저장을 처리합니다.3단계 파이프라인은 중개자 해석 및 강화 중에 데이터 집중으로 인해 "핫 노드" 문제가 발생했던 초기 2단계 설계에서 중요한 진화였습니다. 이러한 책임을 3단계로 분할하면 워크로드가 분산되어 병목 현상을 방지합니다. Server-Sent Events(SSE)는 gRPC의 성능 오버헤드로 인해 스테이지 간 통신에 gRPC를 대체했습니다. 이 오버헤드는 대규모 환경에서 과도한 CPU 및 메모리를 소비했습니다. Building Service Topology at Scale: Architecture, Challenges, and Lessons Learned netflixtechblog.com +1
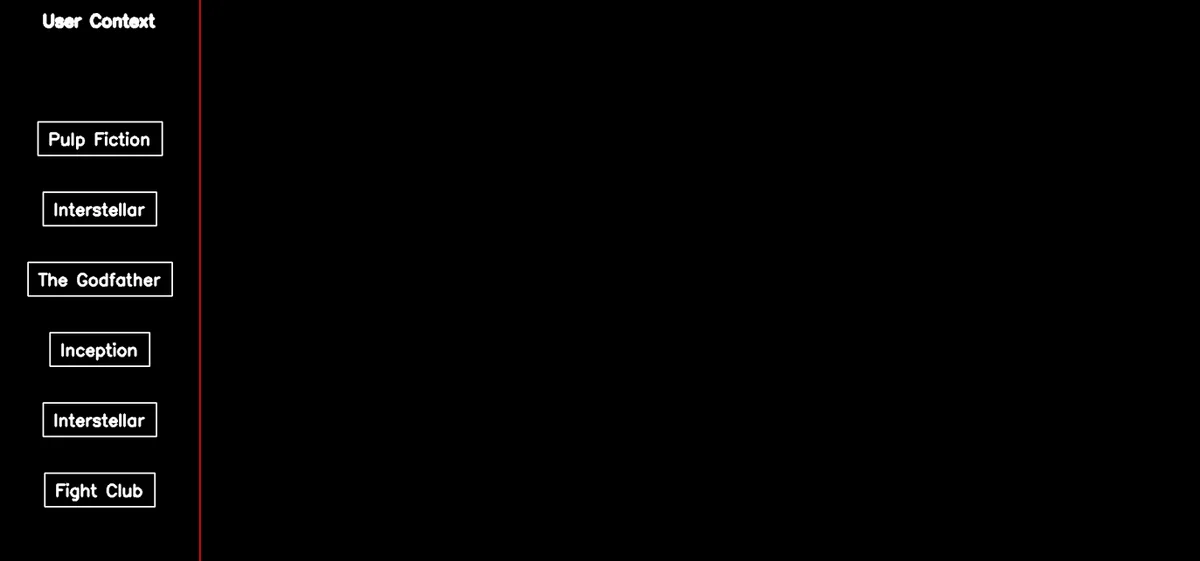
GenPage: Netflix에서의 종단간 생성적 홈페이지 구축을 향하여 넷플릭스 홈페이지는 콘텐츠 탐색을 위한 고도로 개인화되고 구조화된 인터페이스입니다. 전통적으로 홈페이지 생성은 복잡한 다단계 파이프라인을 포함했습니다. 새로운 접근 방식인 GenPage는 단일 생성 트랜스포머 모델을 사용하여 전체 홈페이지를 자기회귀적으로 구성합니다. 이 엔드투엔드 모델은 사용자 컨텍스트를 프롬프트로 받아 행, 엔티티 및 레이아웃을 동시에 생성합니다. 주요 목표는 추천 스택을 단순화하고, 강화 학습을 통한 전체 페이지 최적화를 가능하게 하며, 확장성과 유연성을 향상시키는 것입니다. 프로덕션 과제에는 실시간 서빙 지연 시간, 엔티티 콜드 스타트 및 모델 신선도 유지 등이 포함되었습니다. GenPage는 A/B 테스트에서 사용자 참여도 향상과 서빙 지연 시간 감소라는 상당한 개선을 보여주었습니다. 데이터는 사용자 정보를 나타내는 컨텍스트 토큰과 홈페이지 구조를 위한 페이지 토큰으로 토큰화됩니다. 도메인별 토큰화는 일반 텍스트 토큰화에 비해 계산 효율성과 제품 제어를 향상시킵니다. 사용자 기록, 프로필 및 요청 컨텍스트가 프롬프트를 형성하며, 엔티티와 행은 생성된 페이지의 토큰으로 표현됩니다. 시스템은 사용자 피드백을 기반으로 보상 시스템을 사용하여 추천 가치를 정량화하고 학습을 안내합니다. GenPage는 표준 디코더 전용 트랜스포머 아키텍처를 사용하며, 사전 학습 및 사후 학습의 LLM과 유사한 학습 레시피를 따릅니다. 사전 학습은 다음 토큰 예측을 사용하여 모델에 홈페이지 언어를 학습시키고, 이후 가중 이진 분류 또는 강화 학습으로 사후 학습을 진행합니다. 이 생성적 접근 방식은 넷플릭스 홈페이지 경험 전체를 최적화하는 데 더 통합되고 직접적인 경로를 제공합니다. GenPage: Towards End-to-End Generative Homepage Construction at Netflix netflixtechblog.com +1
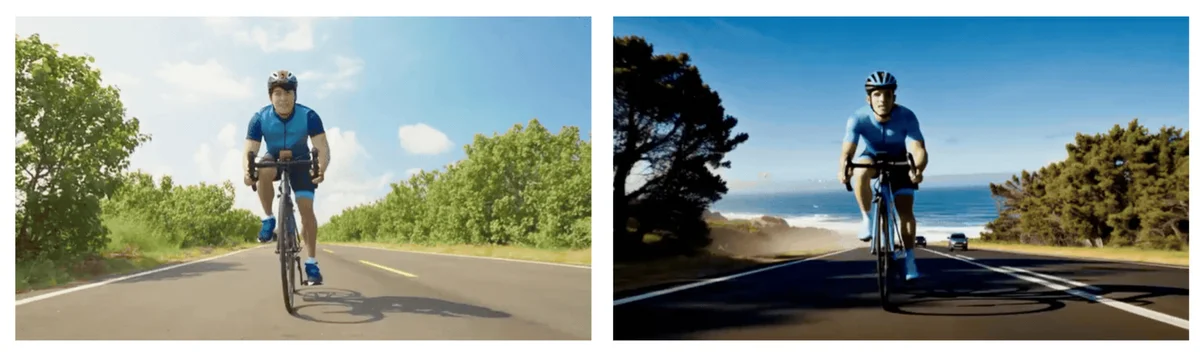
보다 제어 가능한 AI 비디오 편집을 향하여: 넷플릭스에서의 초기 연구 탐색 Netflix 연구원들은 홍보용 에셋 제작 시 비디오 편집자를 지원하기 위한 두 가지 AI 도구를 개발했습니다. 첫 번째 도구인 Vera는 콘텐츠 보존 편집을 위해 설계된 계층형 비디오 확산 모델입니다. Vera는 편집을 별도의 계층으로 생성하여 원본 푸티지의 변경되지 않은 부분을 그대로 유지함으로써 신원과 세부 정보를 보존합니다. Vera를 훈련시키기 위해 특수 데이터셋을 만들고 효율적인 출력 생성을 위해 Mixture-of-Transformers 아키텍처를 사용했습니다. 평가 결과, Vera는 콘텐츠 보존 측면에서 기존 방법보다 훨씬 뛰어난 성능을 보였으며 비디오 품질도 비슷했습니다. 두 번째 도구인 VOID는 비디오 객체 및 상호 작용 삭제 프레임워크입니다. VOID는 상당한 상호 작용이 있는 객체를 제거할 때 발생하는 물리적으로 불가능한 결과의 문제를 해결합니다. 물리적으로 가능한 반사실적 비디오를 생성하는 첫 번째 패스와 아티팩트(예: 객체 변형)를 방지하기 위해 출력을 개선하는 두 번째 패스로 구성된 2단계 추론 파이프라인을 사용합니다. VOID는 시뮬레이션 및 실제 모션 캡처 데이터에서 생성된 합성 데이터를 사용하여 훈련되었습니다. 실험 결과, VOID는 이전 접근 방식에 비해 일관된 장면 역학을 더 잘 보존하는 것으로 나타났습니다. 이러한 연구 탐구는 아티스트에게 힘을 실어주면서 AI 비디오 편집을 책임감 있게 발전시키는 것을 목표로 합니다. Vera와 VOID 모두 공개된 연구 논문에 자세히 설명되어 있습니다. Toward More Controllable AI Video Editing: An Early Research Exploration at Netflix netflixtechblog.com +1
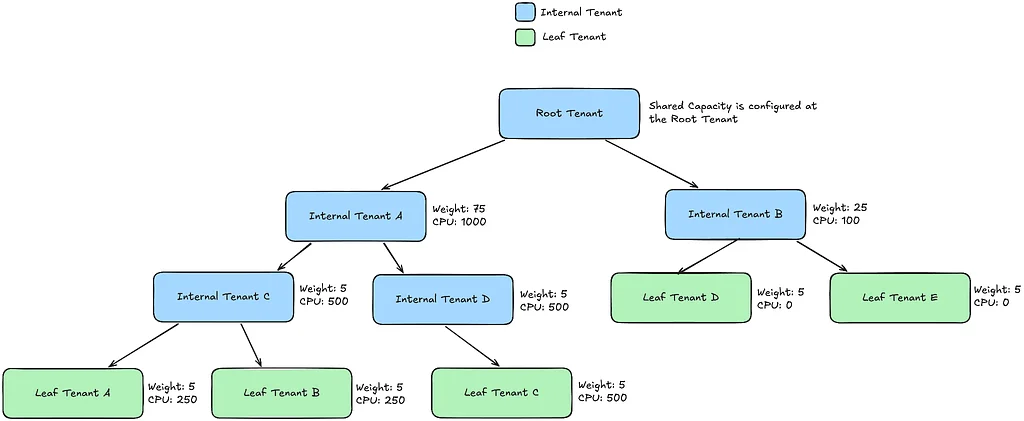
넷플릭스가 Kueue를 통해 배치 컴퓨팅을 어떻게 간소화했는지 넷플릭스는 컴퓨팅 인프라를 쿠버네티스 네이티브 모델로 전환하며, Kueue와 같은 구성 요소를 자사의 Titus 플랫폼에 통합하고 있습니다. 클라우드 네이티브 작업 큐 시스템인 Kueue는 넷플릭스가 자체 개발한 배치 솔루션인 Compute Managed Batch(CMB)의 맞춤형 로직을 대체했습니다. 이러한 마이그레이션의 동기로는 CMB의 노후화, 쿠버네티스의 진화, 그리고 기존 시스템에 선점(preemption)과 같은 기능을 추가하기가 점점 더 어려워진 점 등이 꼽혔습니다. Kueue는 기존 Titus 스케줄링 프로필과의 호환성, 도입 확산 추세, 그리고 선점과 같은 기능을 네이티브로 지원한다는 점 때문에 다른 대안들보다 선택되었습니다.‘Netflix Batch’로 알려진 이번 마이그레이션은 사용자에게 미치는 영향을 제로로 하고 처리량을 저하시키지 않는 것을 목표로 했습니다. 이 과정에서는 작업 제출을 Kueue가 활성화된 Titus 셀로 재라우팅하고, Titus 페더레이션이 작업 분배를 처리하도록 했습니다. 운영자 측의 조정은 최소한으로 이루어졌으며, 주로 테넌트를 Kueue에 등록하기 위한 간단한 UI 토글 설정에 국한되었습니다. 이 등록 과정을 통해 CMB의 기존 테넌트 계층 구조와 용량 구성이 Kueue의 코호트(Cohorts), 클러스터 큐(ClusterQueues), 로컬 큐(LocalQueues) 개념으로 변환됩니다.주요 교훈으로는 원활한 사용자 경험을 보장하기 위해 기존 시스템과의 API 호환성을 유지한 점과, 신뢰를 구축하기 위해 복잡한 사용 사례를 조기에 마이그레이션한 점이 있습니다. 또한 Kueue가 넷플릭스의 높은 처리량 요구 사항을 처리할 수 있는지 확인하기 위해 부하 테스트를 수행하는 것이 중요했으며, 이를 위해 기본 구성을 조정해야 했습니다. 현재 Kueue는 완전히 가동 중이며 수백만 건의 배치 워크로드를 관리하고 있으며, 향상된 공정한 공유 및 선점 기능을 지원하고 있습니다. 이러한 개선 사항을 통해 예약된 용량의 활용도를 높이고, 작업 대기 현상을 줄이며, 중요 워크로드의 처리 속도를 향상시켜 평균 리소스 활용도를 크게 높였습니다. How Netflix Simplified Batch Compute with Kueue netflixtechblog.com +1
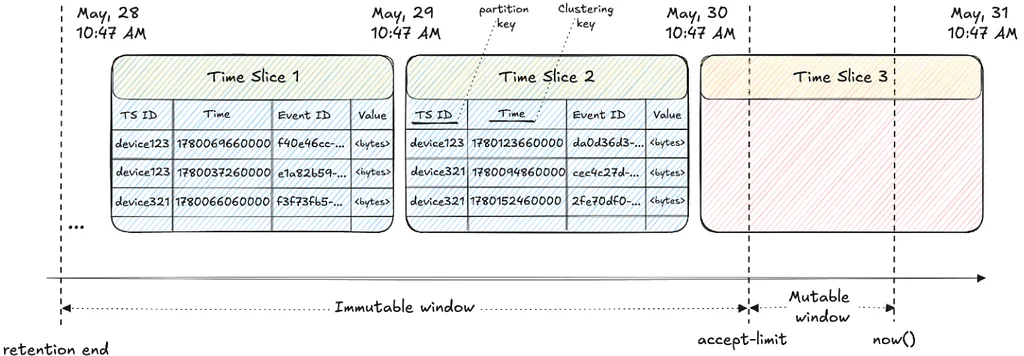
시계열 워크로드를 위한 카산드라의 와이드 파티션 동적 분할 Netflix의 TimeSeries Abstraction은 Apache Cassandra를 스토리지로 사용하여 밀리초 지연 시간으로 페타바이트 규모의 시간 이벤트 데이터를 수집하고 쿼리합니다. 단일 파티션이 시간이 지남에 따라 대량의 이벤트를 축적하는 와이드 파티션은 TimeSeries 워크로드에 상당한 문제를 야기합니다. 이는 Cassandra 클러스터에서 높은 읽기 지연 시간, 타임아웃, CPU 사용량 증가 및 가비지 컬렉션 일시 중단을 초래합니다. 이를 해결하기 위해 TimeSeries 데이터는 개별 시간 청크로 분할되어 관리 가능한 세그먼트를 생성합니다.초기 프로비저닝 전략은 사용자 지정 워크로드 특성과 몬테카를로 시뮬레이션을 사용하여 최적의 인프라 및 파티션 구성을 결정하는 데 의존했습니다. 그러나 이 접근 방식은 워크로드를 알 수 없거나, 부정확하게 추정하거나, 시간이 지남에 따라 진화하거나, 데이터 이상치를 포함하는 경우 불충분했습니다. 조정을 자동화하기 위해 백그라운드 워커를 도입하여 파티션 히스토그램을 모니터링하고 관찰된 데이터 밀도를 기반으로 향후 시간 슬라이스를 동적으로 재분할했습니다. 이 Time Slice Re-Partitioning 전략은 대부분의 데이터가 유사한 와이드 파티션 동작을 보일 때 읽기 지연 시간과 타임아웃을 효과적으로 줄입니다.그러나 이 전략은 테이블 내 ID의 작은 비율만 와이드한 시나리오를 해결하지 못합니다. 이러한 경우와 호출자가 높은 지연 시간에도 불구하고 모든 데이터를 필요로 하는 경우, Dynamic Partitioning per ID가 개발되었습니다. 이 비동기 파이프라인은 읽기 작업 중에 와이드 파티션을 감지하고 투명하게 최적의 크기로 분할합니다. 이 프로세스는 감지, 계획 및 분할, 분할된 파티션으로 쿼리를 재라우팅하여 읽기를 제공하는 것을 포함합니다.감지는 구성된 바이트 임계값을 초과하는 읽기 작업이 발생할 때 이루어지며, Kafka로 이벤트를 내보냅니다. 시스템은 단순성을 위해 처음에 불변 파티션에 집중합니다. 계획 단계에서는 전체 파티션을 읽어 분할 계획을 생성하며, 체크포인팅을 사용하여 실패를 처리합니다. 분할은 이벤트 버킷을 시간 버킷에 할당하는 것과 같은 특정 전략에 데이터 분할을 위임하는 것을 포함합니다. 분할을 검증하는 것이 중요하며, 체크섬은 분할이 완료된 것으로 표시하기 전에 데이터 무결성을 보장합니다. 마지막으로 TimeSeries 서버는 인메모리 Bloom 필터를 사용하여 읽기 쿼리를 분할된 파티션으로 효율적으로 전환하여 호출자에게 거의 눈에 띄지 않게 Dynamically Splitting Wide Partitions in Cassandra for Time Series Workloads netflixtechblog.com +1
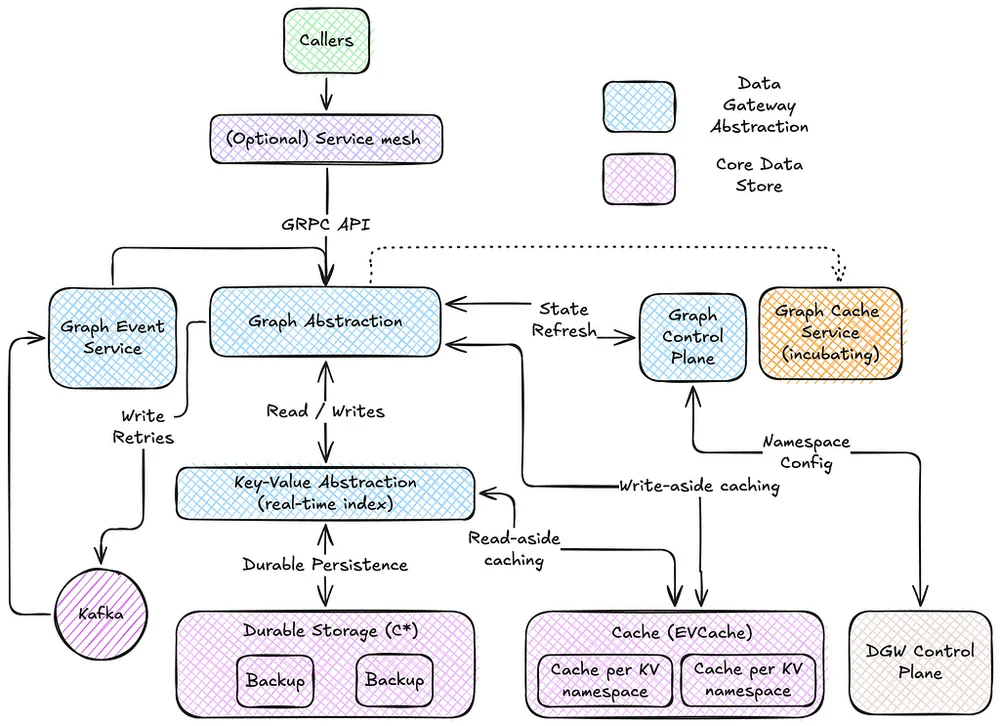
넷플릭스의 고처리량 그래프 추상화: 1부 Netflix는 실시간 분산 그래프 및 소셜 그래프와 같은 사용 사례에 특히 활용하기 위해 고처리량, 저지연 그래프 작업을 처리하기 위한 그래프 추상화를 구축했습니다. 이는 심층 분석을 위한 OLAP와 스트리밍 사용자 경험을 위한 OLTP의 두 가지 범주 내에서 작동합니다. 이 추상화는 강력하게 타입화된 노드와 엣지를 가진 속성 그래프 모델을 사용하며, 격리된 네임스페이스로 구성됩니다. 각 네임스페이스는 데이터 게이트웨이 제어 플레인을 통해 관리되는 사전 정의된 그래프 스키마를 가지고 있습니다. 이 스키마는 데이터 품질 강제 및 효율적인 쿼리 계획과 같은 최적화를 가능하게 합니다. 실시간 인덱스는 노드와 엣지를 위해 키-값 스토리지를 사용하며, 링크와 속성에 대해 별도의 인덱스를 사용합니다. 엣지 링크는 소스-대상 관계별로 인덱싱됩니다. 방향에 관계없이 액세스를 보장하기 위해 식별자를 사전순으로 구성합니다. 캐싱은 쓰기 및 읽기 증폭을 최소화하는 데 사용됩니다. 추상화 아키텍처는 고성능을 우선시하며 쓰기 분리 캐싱과 같은 전략을 통합합니다. High-Throughput Graph Abstraction at Netflix: Part I netflixtechblog.com +1
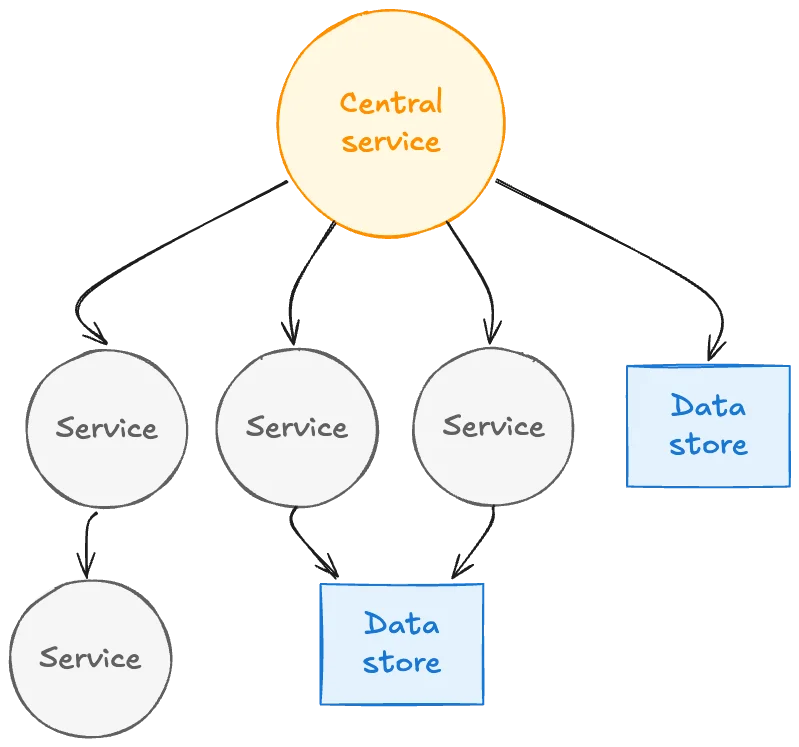
사일로에서 서비스 토폴로지로: 넷플릭스가 실시간 서비스 맵을 구축한 이유 Netflix는 엔지니어들이 서비스 종속성을 이해하고 문제를 해결하는 데 도움을 주기 위해 Service Topology라고 불리는 분산 인프라의 "살아있는 지도"를 개발했습니다. 이 지도는 서비스 관계와 장애 발생 시 잠재적 영향을 더 빠르게 식별해야 하는 필요성을 해결합니다. 이는 어떤 서비스가 서로에게 의존하는지, 그리고 문제의 근원을 파악하는 것과 같은 중요한 질문에 답합니다. 그들은 eBPF 네트워크 흐름, IPC 메트릭, 엔드투엔드 추적의 세 가지 소스에서 데이터를 수집했습니다. 각 데이터 소스는 고유한 관점을 제공합니다. 즉, 네트워크 연결성, 애플리케이션 수준의 세부 정보, 실제 요청 흐름입니다. 이 다층 아키텍처는 이러한 뷰를 통합된 실시간 지도로 결합합니다. 시스템은 각 데이터 소스에 대해 별도의 그래프 데이터베이스를 사용하여 독립성을 유지하고 병렬 쿼리를 가능하게 합니다. 엔지니어들은 각 그래프를 개별적으로 보거나 결합하여 서비스 상호 작용에 대한 포괄적인 이해를 얻을 수 있습니다. 시스템은 여러 지역의 Kafka에서 흐름 로그를 수집하고, 처리하고, 그래프 데이터베이스에 데이터를 저장합니다. 이 살아있는 지도는 Netflix 엔지니어들이 문제를 신속하게 진단하고 해결하여 원활한 스트리밍 경험을 보장하는 데 도움이 됩니다. From Silos to Service Topology: Why Netflix Built a Real-Time Service Map netflixtechblog.com +1
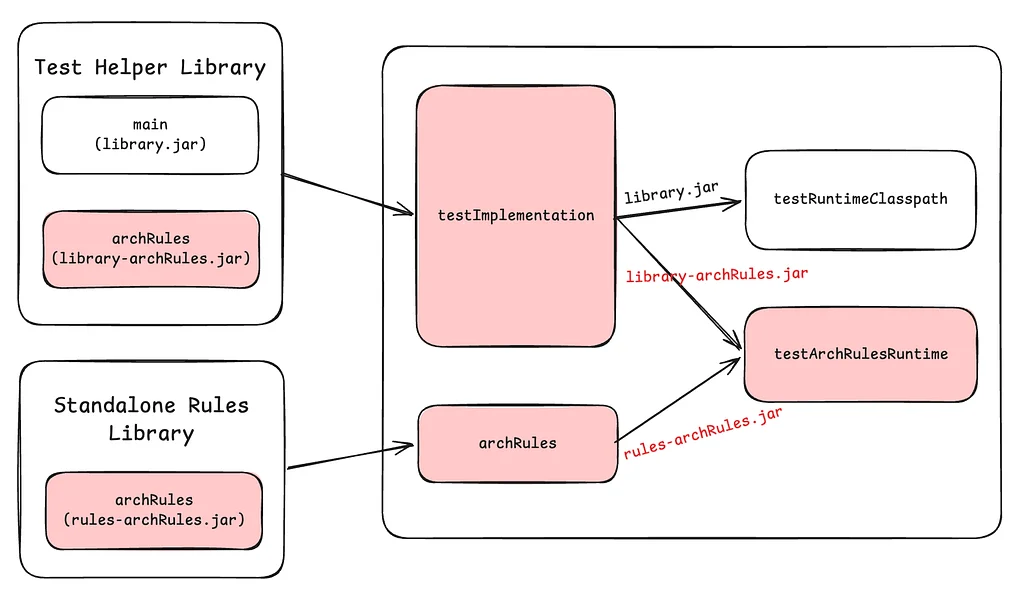
Nebula ArchRules와 함께 ArchUnit 확장하기 Netflix는 수천 개의 Java 리포지토리를 사용하는 폴리 리포(polyrepo) 전략을 사용하며, 효율적인 빌드 로직 공유가 필요합니다. 이들은 종속성을 관리하고 코드 표준을 강제하기 위해 ArchRules를 포함한 Nebula Gradle 플러그인 제품군을 구축했습니다. 이 이니셔티브는 이전 버전과 호환되지 않는 변경 사항 사고 이후 Java 라이브러리 수명 주기 관리를 개선해야 할 필요성에서 비롯되었습니다. Netflix는 API 수명 주기 주석(@Deprecated, @Public, @Experimental)을 활용하여 폐기된 코드의 잠재적인 문제를 식별합니다. 아키텍처 규칙을 강제하는 데 널리 사용되는 라이브러리인 ArchUnit은 이러한 주석의 오용 및 기타 기술 부채 문제를 감지하기 위해 선택되었습니다. Nebula ArchRules 플러그인을 통해 여러 리포지토리에 걸쳐 ArchUnit 규칙을 공유하고 적용할 수 있으며, 향상된 기능을 제공합니다. ArchRules는 언어 간 지원을 위해 바이트코드 분석(ASM)을 사용하고, 규칙 생성을 단순화하는 사용하기 쉬운 빌더 패턴을 사용합니다. 규칙은 라이브러리와 함께 번들링되거나 독립적인 규칙 라이브러리에 정의될 수 있으며, 플러그인에 의해 자동으로 감지되고 실행됩니다. ArchRules Runner 플러그인은 소스 세트에 대해 규칙을 평가하고 JSON 및 콘솔 보고서를 생성하여 더 나은 보고 기능을 제공합니다. ArchRules를 사용함으로써 Netflix는 라이브러리 작성자가 API 사용을 추적하고 폐기된 API 사용을 감지할 수 있는 플랫폼을 제공합니다. Scaling ArchUnit with Nebula ArchRules netflixtechblog.com +1
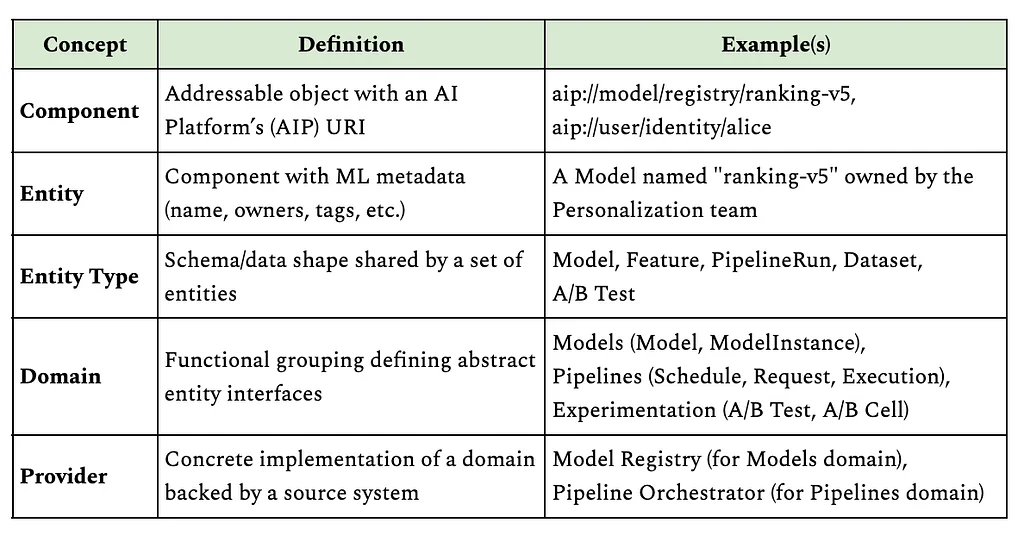
넷플릭스에서의 머신러닝 민주화: 모델 라이프사이클 그래프 구축 Netflix는 개인화, 스튜디오 제작, 결제, 광고와 같은 다양한 비즈니스 도메인에 걸쳐 머신러닝을 활용합니다. ML 채택이 증가함에 따라 모델과 데이터가 사일로화되어 협업과 검색을 방해하는 파편화된 환경이라는 문제가 발생했습니다. ML 실무자들은 다양한 시스템에 걸쳐 모델 계보, 기능 소스 및 영향을 이해하는 데 어려움을 겪었습니다. 이러한 파편화로 인해 기존 기능, 데이터 소스, 파이프라인 종속성 및 변경 효과에 대한 질문에 쉽게 답할 수 없었습니다.핵심적인 어려움은 메타데이터를 생성하는 분산된 ML 인프라 구성 요소를 연결하는 데 있었습니다. 파이프라인 오케스트레이터부터 실험 플랫폼 및 기능 스토어에 이르기까지 수십 개의 시스템이 다양한 형식으로 데이터를 생성했습니다. 이를 해결하려면 이기종 메타데이터를 수집하고, 이를 통합된 모델로 변환하고, 탐색을 위한 연결된 그래프를 구축해야 했습니다.해결책은 Netflix에서 ML 엔티티를 상호 연결하는 모델 수명 주기 그래프를 구축하는 메타데이터 서비스(MDS)입니다. MDS는 ML 메타데이터를 실시간으로 수집하여 특정 모델을 사용하는 실험을 식별하거나 특정 기능을 공유하는 모델과 같은 도메인 간 쿼리를 가능하게 합니다. 비전은 모든 ML 자산을 회사 전체에서 검색 가능하고, 이해 가능하며, 재사용 가능하게 만드는 것입니다.MDS는 고유한 AIP URI를 가진 구성 요소, 속성을 가진 ML별 자산인 엔티티, 데이터 모양을 정의하는 엔티티 유형, 관련 엔티티 유형을 그룹화하는 도메인, 소스 시스템의 도메인에 대한 구체적인 구현인 공급자와 같은 핵심 추상화를 기반으로 작동합니다. 이 URI 기반 주소 지정 방식을 통해 모든 서비스가 모든 ML 자산을 보편적으로 참조할 수 있습니다. 그래프를 구축하는 과정은 여러 단계를 거칩니다.첫째, MDS는 Kafka 및 AWS SNS/SQS를 통해 소스 시스템과 통합하여 변경 사항을 나타내는 얇은 이벤트를 소비합니다. 전용 이벤트 핸들러는 파이프라인 오케스트레이션, 모델 레지스트리, 기능 스토어, 실험 플랫폼, ID 플랫폼과 같은 시스템의 이벤트를 처리합니다. 둘째, MDS는 수분 계약을 구현하여 이벤트를 검증하고 소스 시스템 API를 호출하여 전체 상태를 가져온 다음, 이를 정규화된 엔티티로 변환합니다. 이 "변경 알림" 패턴은 이벤트 순서 문제에 대한 견고성을 보장하지만 소스 시스템에 읽기 부하를 줍니다.셋째, 원시 이벤트는 표준화된 필드를 가진 통합 엔티티 모델로 변환되어 다운스트림 소비자에게 일관된 인터페이스를 생성합니다. 정규화된 엔티티는 필드 이름, 형식을 표준화하고 플랫폼별 ID를 전역 AIP URI로 변환합니다. 마지막으로 정규화된 엔티티는 캐싱 및 관계 저장을 위해 Datomic에 지속되고 동시에 Elasticsearch에 인덱싱됩니다. 불변 사실 모델을 가진 Datomic은 복잡한 그래프 순회 및 엔티티 관계를 지원하여 비효율적인 N+1 쿼리 패턴 없이 여러 도메인에 걸친 쿼리를 가능하게 합니다. Democratizing Machine Learning at Netflix: Building the Model Lifecycle Graph netflixtechblog.com +1
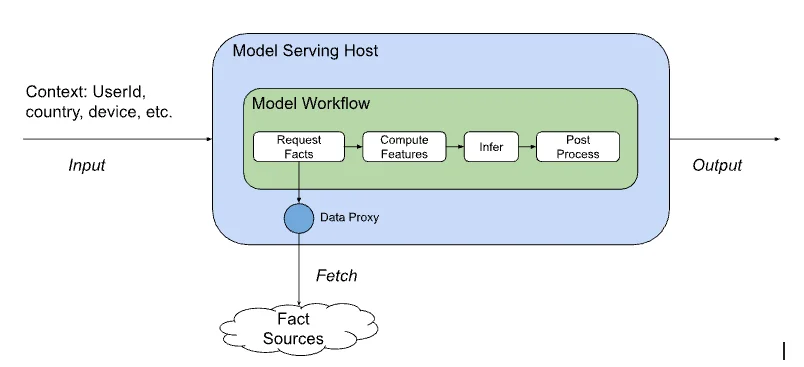
모델 서빙에서의 라우팅 상태 이 블로그 게시물은 Netflix의 ML 모델 서빙 인프라가 다양한 도메인에 걸쳐 대규모 개인화된 경험을 어떻게 지원하는지에 대한 기술적인 통찰력을 논의합니다. 중앙 ML 모델 서빙 플랫폼은 모델 추론을 위해 여러 도메인별 마이크로서비스에 도메인 독립적인 API 추상화 및 트래픽 라우팅 기능을 제공합니다. 이 단일 API는 기존 ML 경험의 최신 버전을 반복하는 혁신 속도를 높이고 ML을 통한 새로운 제품 경험을 가능하게 했습니다. ML 모델 서빙 인프라의 성공은 연구자들이 새로운 가설을 신속하게 실험하고 모델을 프로덕션에 안전하게 출시할 수 있도록 하는 데 달려 있습니다. 이 플랫폼은 수백 가지의 모델 유형과 버전을 처리하며 초당 100만 건의 요청을 처리하고, 개별 채점 함수뿐만 아니라 워크플로 수준에서 작동합니다.모델 정의에는 기능을 계산하는 데 필요한 사실 목록이 포함되어 있으며, 서빙 시점에 여러 다른 마이크로서비스를 호출하여 이러한 사실을 제공하도록 모델 서빙 플랫폼에 의존합니다. 호출하는 서비스는 표준 요청 컨텍스트와 관련 도메인 컨텍스트만 제공하면 되며, 모델 자체는 실행 흐름의 일부로 기능을 계산하고 추론을 수행할 수 있습니다. 이 플랫폼은 신속한 ML 혁신의 촉진자 역할을 하며 클라이언트 앱에 대한 ML 모델 반복의 노출을 제한합니다. 플랫폼의 핵심 원칙에는 클라이언트 앱과 독립적인 모델 혁신, 클라이언트를 모델 샤딩에서 분리, 유연한 트래픽 라우팅 규칙이 포함됩니다.이 플랫폼은 Switchboard라는 사용자 정의 서비스를 사용하며, 이는 초당 100만 건 이상의 요청을 처리하면서 높은 가용성과 신뢰성을 유지하는 모든 트래픽에 대한 유연한 프록시 계층 역할을 합니다. Switchboard는 모든 클라이언트의 모델 요구에 대한 단일 접점을 제공하며 풍부한 컨텍스트 기능 세트를 기반으로 요청을 라우팅할 수 있습니다. 이 플랫폼은 또한 "Objective"라는 개념을 도입하는데, 이는 서빙 플랫폼에서 정의한 열거형으로 시스템에 대한 모든 요청이 제공해야 합니다. Objective는 클라이언트를 구체적인 모델에서 분리하고 플랫폼의 라우팅 및 모델 선택 결정을 안내합니다.Switchboard Rules는 연구자들이 클라이언트 코드를 변경하지 않고도 Objective에 모델 변형, 실험 및 트래픽 분할을 연결할 수 있도록 하는 JavaScript 구성입니다. 규칙은 주어진 Objective에 대한 기본 모델, 일련의 Objective에 대한 A/B 실험 구성, 새 모델로 트래픽을 점진적으로 전환하기 위한 사용자 정의를 지시합니다. 규칙은 Switchboard와 Model Serving 클러스터 모두에서 사용되며, 서빙 플랫폼 구성 요소는 이러한 규칙을 기반으로 다양한 작업을 수행할 수 있습니다. 전반적으로 이 플랫폼은 Netflix에서 ML 모델을 서빙하기 위한 확장 가능하고 유연한 솔루션을 제공하여 클라이언트 앱에 대한 영향을 최소화하면서 신속한 혁신과 실험을 가능하게 합니다. State of Routing in Model Serving netflixtechblog.com +1
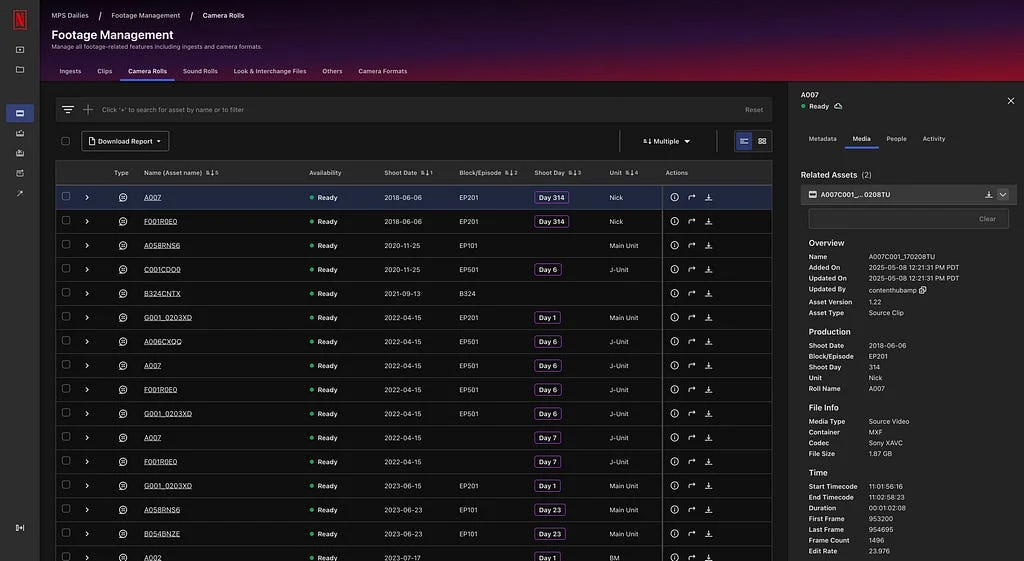
넷플릭스에서의 카메라 파일 처리 규모 확장 Netflix는 전 세계 프로덕션의 미디어 워크플로우를 간소화하기 위해 Media Production Suite(MPS)를 구축했으며, 효율성과 일관성을 목표로 합니다. MPS의 핵심은 이미지 처리를 위해 FilmLight의 API(FLAPI)를 활용하며, 이는 모든 것을 처음부터 구축하는 것을 피하는 협업입니다. MPS는 파일 관리 및 일관되지 않은 미디어 처리와 같은 문제를 해결하고, 작업을 자동화하며 오류를 최소화합니다. FLAPI는 카메라 파일 메타데이터를 검사하고, 이를 정규화하며, 검색 가능하게 만들어 일관성을 보장합니다. FLAPI는 또한 정확한 색상 관리 및 디베이어링을 통해 VFX 플레이트와 결과물을 생성합니다. MPS는 Cosmos를 사용하여 클라우드에 통합되며, Docker화된 환경에서 CPU 전용 인스턴스를 사용할 수 있어 효율성을 극대화합니다. 프로덕션 워크로드는 필요에 따라 확장 가능하도록 탄력적으로 처리되어 빠른 처리 시간을 보장합니다. MPS는 숙련된 팀과 안내가 필요한 팀 모두를 위해 설계되었으며, FLAPI가 복잡성을 처리합니다. 이 파트너십은 개방적인 소통, 공동 검증을 가능하게 하며 표준화 생태계에 이점을 제공합니다. 전반적인 영향은 지연 감소, 처리 시간 단축, 그리고 보다 효율적인 프로덕션 프로세스입니다. Scaling Camera File Processing at Netflix netflixtechblog.com +1
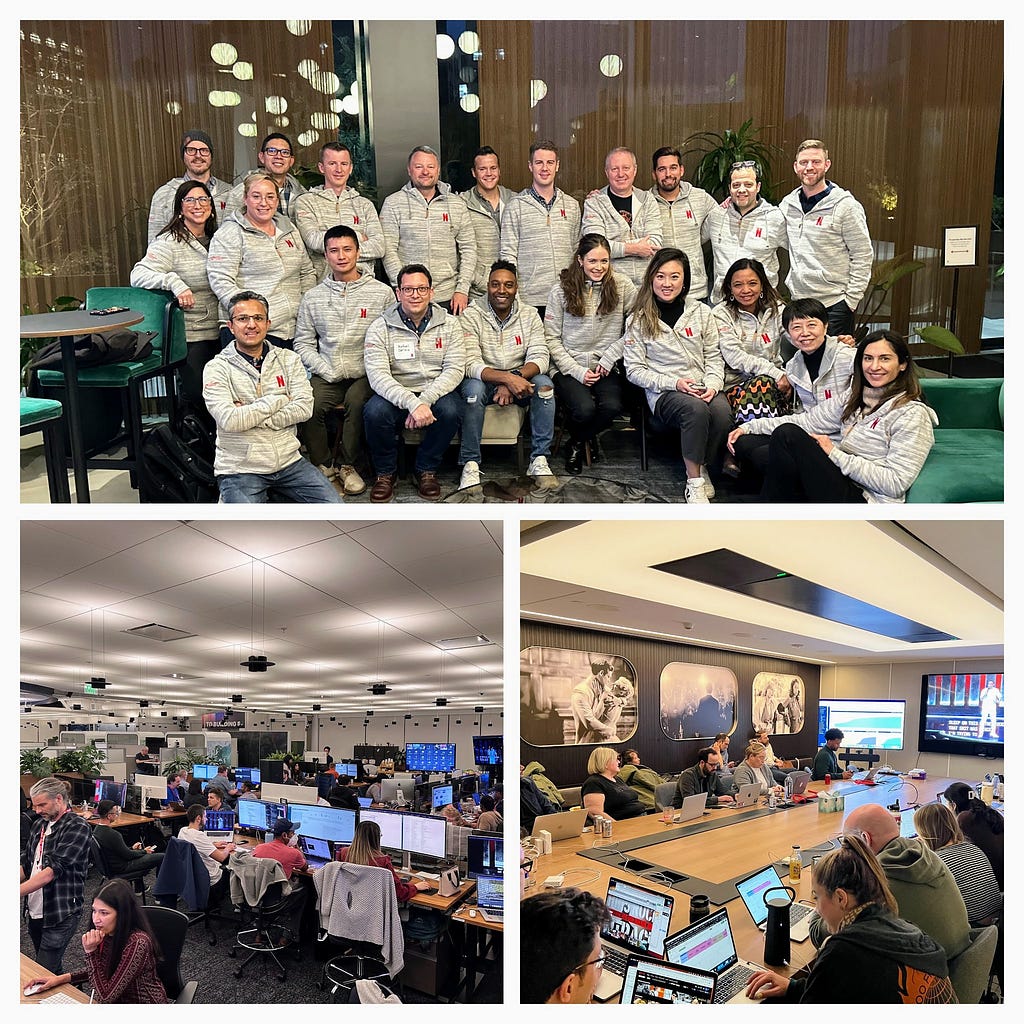
인프라의 인간적인 면모: 넷플릭스가 어떻게 라이브 서비스를 위한 대규모 운영 레이어를 구축했는가 넷플릭스의 라이브 스트리밍 운영은 첫 라이브 쇼 이후 급속도로 확장되어 현재 매일 여러 이벤트를 스트리밍하고 있습니다. 초기 라이브 쇼는 엔지니어와 즉흥적인 설비에 의존했으며, 전담 운영팀이 부족했습니다. 이러한 발전은 라이브 방송 프로세스를 관리하기 위한 전담 방송 운영 센터(BOC) 구축을 필요로 했습니다. 신호 안정성을 보장하기 위해 넷플릭스는 행사장에서 제공되는 비디오 및 오디오 피드에 대해 엄격한 사양을 적용합니다. 넷플릭스의 운영 모델은 엔지니어링 주도 운영에서 전문 엔지니어링 팀으로 여러 단계를 거쳐 발전했습니다. 전송 운영 센터(TOC) 모델은 효율성을 개선하고 많은 양의 이벤트를 동시에 관리하기 위해 개발되었습니다. TOC 모델 내에서 전송, 스트리밍, 방송 제어 운영자와 같은 역할이 중요합니다. 주요 이벤트의 경우, 전문적인 "빅 베팅" 모델이 전담 리소스를 제공합니다. 라이브 커맨드 센터(LCC)는 전체 라이브 스트리밍 파이프라인을 모니터링하여 운영자에게 실시간 데이터를 제공합니다. LCC는 대량의 데이터를 관리하고 문제에 신속하게 대응하기 위해 맞춤형 관찰 스택을 사용합니다. LCC 운영 리드 및 기술 런칭 매니저는 사고 대응을 담당합니다. The Human Infrastructure: How Netflix Built the Operations Layer Behind Live at Scale netflixtechblog.com +1
LLM을 심사위원으로 활용한 넷플릭스 쇼 시놉시 평가 넷플릭스는 방대한 콘텐츠 라이브러리의 시놉시스 선정 프로세스를 개선하고자 합니다.수천 개의 타이틀은 사용자의 선택을 복잡하게 만들며, 시놉시스는 의사 결정에 중요한 역할을 합니다.고품질 시놉시스는 사용자 참여를 높이는 반면, 저품질 시놉시스는 좌절감과 이탈로 이어집니다.과제는 수십만 개의 시놉시스에 걸쳐 품질 검증을 확장하는 데 있습니다.넷플릭스는 네 가지 핵심 차원에서 시놉시스 품질을 평가하기 위해 LLM 기반 접근 방식을 개발했습니다.이 시스템은 창작 작가들과 85% 이상의 일치율을 달성하여 전문가 주도의 품질 표준을 보장합니다.시놉시스 품질은 작가들이 정의한 창의적 품질과 스트리밍 지표를 통한 회원들의 암묵적 피드백을 통해 평가됩니다.LLM-as-a-Judge 시스템은 정확도를 최적화하기 위해 계층적 근거, 합의 점수, 사실성 에이전트와 같은 기술을 사용합니다.이러한 LLM에서 파생된 품질 점수는 취득률 및 이탈률과 같은 주요 스트리밍 지표와 상관 관계가 있습니다.이를 통해 넷플릭스는 시놉시스 문제를 사전에 파악하고 수정하여 회원 경험과 콘텐츠 검색을 개선할 수 있습니다. Evaluating Netflix Show Synopses with LLM-as-a-Judge netflixtechblog.com +1
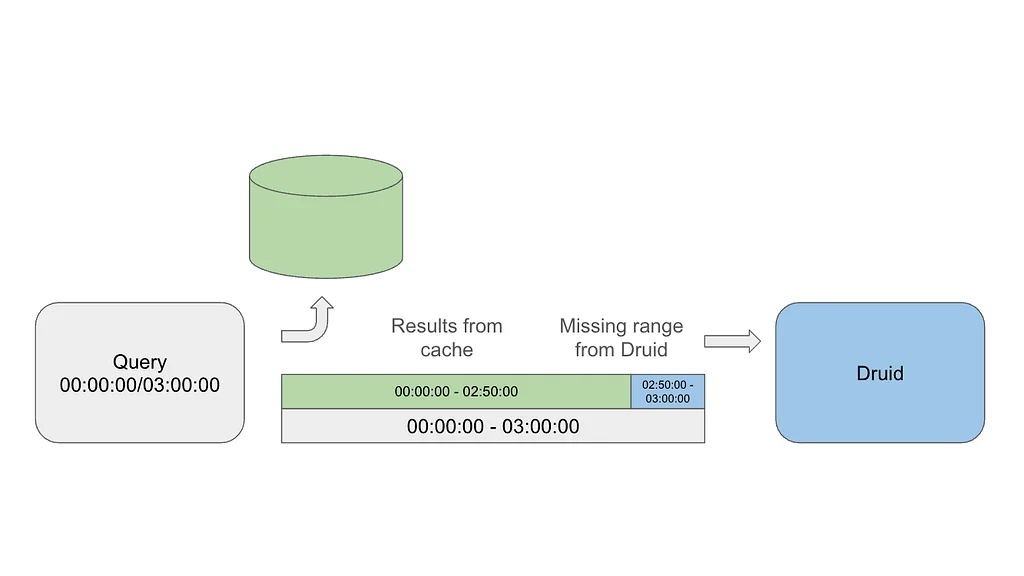
같은 질문에 두 번 답하지 마세요: 넷플릭스 규모의 Druid를 위한 간격 인식 캐싱 넷플릭스는 대규모 환경에서 Druid 쿼리 성능을 향상시키기 위해 실험적인 캐싱 레이어를 구현했습니다. 이 캐싱 시스템은 특히 대규모 이벤트 발생 시 대시보드에서 발생하는 중복 쿼리 문제를 해결합니다. 핵심 아이디어는 결과의 일부를 캐싱하고, 가장 최신 데이터에 대해서만 Druid에 쿼리하여 약간의 오래된 데이터(staleness)를 감수하는 것입니다. 지수 시간-생존(TTL) 값을 사용하여, 늦게 도착하는 이벤트를 처리하기 위해 오래된 데이터는 더 오래 캐싱됩니다. 캐싱 시스템은 캐시된 데이터의 효율적인 범위 스캔을 위해 맵-오브-맵 구조를 사용합니다. 캐시는 Druid 라우터에서 요청을 가로채 필요에 따라 결과를 제공하거나 Druid에 쿼리합니다. 이 솔루션은 캐시된 데이터와 최신 데이터를 결합하여 완전한 결과를 반환하고, 최신 데이터를 비동기적으로 캐싱합니다. 빈 버킷에 대한 부정 캐싱(negative caching)이 사용되며, 후행 빈 버킷을 캐싱하는 것에 대한 예방 조치가 취해집니다. 이 시스템은 넷플릭스의 키-값 데이터 추상화 계층(KVDAL)을 사용하며, Cassandra를 기반으로 하여 각 데이터 포인트에 대해 독립적인 TTL을 제공합니다. 캐싱 레이어는 Druid 쿼리 부하를 크게 줄이고 쿼리 시간을 개선했으며, 특히 대량의 이벤트 발생 시 효과가 컸습니다. 이 캐싱 시스템은 아직 실험 단계에 있으며, 향후 목표는 Druid 자체에 통합하는 것입니다. Stop Answering the Same Question Twice: Interval-Aware Caching for Druid at Netflix Scale netflixtechblog.com +1
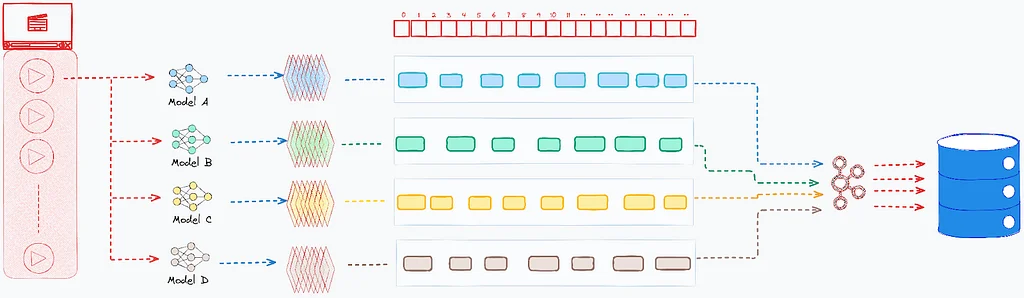
비디오 검색을 위한 멀티모달 인텔리전스 구동 이 기사는 고급 비디오 검색 엔진 구축에 대한 과제와 해결책을 논의합니다. 핵심 문제는 방대한 양의 비디오 영상과 관련 순간을 추출하는 어려움입니다. 해결책은 다양한 AI 모델을 통합하여 비디오 콘텐츠의 여러 측면을 분석하는 다중 모드 접근 방식입니다. 이 접근 방식은 전문 모델에서 얻은 다양한 데이터를 일관된 실시간 인텔리전스 시스템으로 통합해야 합니다. 시스템 아키텍처는 대규모 처리에 중점을 두고 있으며, 수십억 개의 데이터 포인트를 효율적으로 처리합니다. 트랜잭션 지속성, 오프라인 데이터 융합, 실시간 검색을 위한 인덱싱을 포함하는 3단계 프로세스는 데이터 무결성과 응답성을 보장합니다. 이 프로세스는 데이터 수집 과정에서 병목 현상을 방지하기 위해 분리된 파이프라인을 사용합니다. 검색 서비스는 쿼리 전처리, 의미 검색 미세 조정, 정확한 결과를 위한 고급 텍스트 분석과 같은 기능을 제공합니다. 또한 검색 정확도를 향상시키기 위해 구문 일치, N-gram 분석, 퍼지 일치를 포함합니다. 시스템은 보다 미묘한 검색을 가능하게 하기 위해 집계 및 유연한 그룹화를 제공합니다. 전반적으로 목표는 관련 비디오 콘텐츠를 발견할 수 있는 강력한 도구를 제공하여 영화 제작자를 지원하는 것입니다. Powering Multimodal Intelligence for Video Search netflixtechblog.com +1
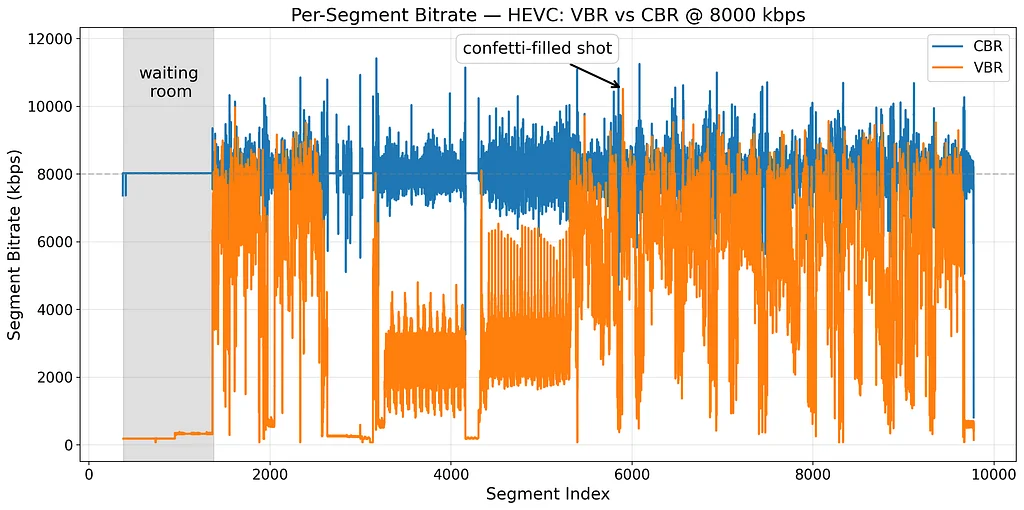
대규모 라이브 스트리밍의 스마트화: 모든 넷플릭스 라이브 이벤트에 VBR 도입 넷플릭스는 효율성 향상을 위해 라이브 이벤트를 고정 비트 전송률(CBR)에서 가변 비트 전송률(VBR) 인코딩으로 전환했습니다. VBR은 장면의 복잡성에 따라 비트 전송률을 동적으로 조정하여 평균 트래픽을 줄이고 사용자 경험의 품질을 향상시킵니다. VBR의 주요 과제는 트래픽의 예측 불가능성으로, 이는 큰 비트 전송률 변동으로 인해 서버 과부하 및 불안정성을 초래할 수 있습니다. 이를 해결하기 위해 넷플릭스는 공칭 비트 전송률을 기반으로 하는 새로운 용량 예약 시스템을 구현하여 VBR의 가변적인 특성과 관련된 위험을 완화했습니다. 또한 VMAF를 지표로 사용하여 CBR 스트림의 품질에 맞춰 스트리밍 계층 전반의 공칭 비트 전송률을 조정했습니다. VBR로의 전환은 버퍼링 감소 및 초기 시작 지연 감소와 같은 효율성 향상을 가능하게 했습니다. 넷플릭스는 현재 VBR을 더욱 최적화하기 위해 적응형 비트 전송률 알고리즘과 용량 예약을 개선하기 위해 노력하고 있습니다. VBR의 구현은 여러 팀과 기여자가 참여한 회사 전체의 프로젝트였습니다. Smarter Live Streaming at Scale: Rolling Out VBR for All Netflix Live Events netflixtechblog.com +1
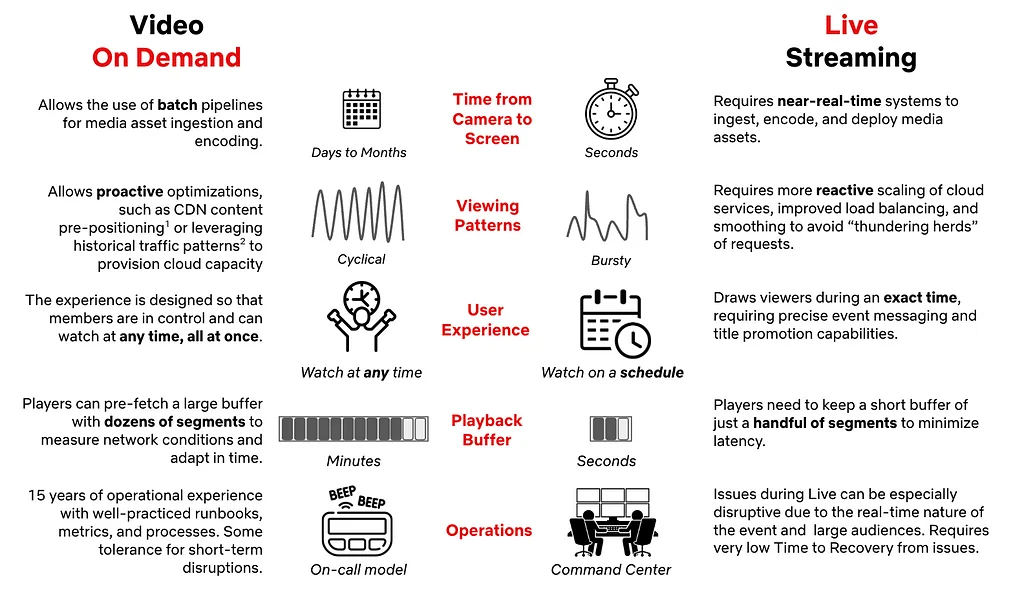
스트림 뒤에서: 넷플릭스 라이브. 파트 1 "3년 전, 넷플릭스는 텔레비전만큼이나 오래된 형식인 라이브 스트리밍을 통해 전 세계를 어떻게 즐겁게 할 수 있는지 물었습니다. 이 질문은 코미디 쇼, 스포츠, WWE 이벤트를 포함한 수백 개의 라이브 이벤트 개발로 이어졌습니다. "Behind the Streams"라는 시리즈에서 넷플릭스는 라이브 스트리밍 기능을 구축하는 기술적 여정을 공유할 예정입니다. 라이브 스트리밍은 아키텍처 및 기술 선택에 대한 새로운 고려 사항을 도입했으며, 넷플릭스에서 잘 작동하도록 만들기 위해 상당한 구축이 필요했습니다. 넷플릭스의 라이브 아키텍처의 핵심 기둥에는 전용 방송 시설, 클라우드 기반의 중복 트랜스코딩 및 패키징 파이프라인, 라이브 콘텐츠 전달 확장, 라이브 재생 최적화, 클라우드에서 검색 및 재생 제어 서비스 실행이 포함됩니다. 넷플릭스는 또한 전문 도구와 시설을 사용하여 클라우드에서 실시간 메트릭을 중앙 집중화했습니다. 라이브 기능을 구축하는 것은 새로운 도전과 학습 기회를 가져왔으며, 넷플릭스는 여전히 라이브 이벤트를 더 효과적으로 제공하는 방법을 매일 배우고 있습니다. 지금까지의 주요 학습 내용은 광범위한 테스트, 정기적인 연습, 시청률 예측, 우아한 성능 저하 및 재시도 폭풍의 중요성입니다. 넷플릭스는 견고한 라이브 스트리밍 시스템 구축에 상당한 진전을 이루었지만, 여전히 배우고 개선해야 할 점이 많이 남아 있습니다." Behind the Streams: Live at Netflix. Part 1 netflixtechblog.com +1
넷플릭스 투둠 아키텍처: 카프카를 사용한 CQRS에서 RAW 홀로우를 사용한 CQRS로 Tudum.com는 넷플릭스의 공식 팬 대상지로, 매월 2000만 명 이상의 회원에게 독점 콘텐츠, 비하인드 스토리, 상호작용 경험을 제공합니다. 이 플랫폼의 아키텍처는 유지 가능, 확장 가능, 유연성을 위해 설계되었으며, Command Query Responsibility Segregation (CQRS)에 유사한 서버 주도 UI 접근 방식을 사용합니다. Tudum의 에디터리얼 팀은 콘텐츠를 생성하고, 이를 쓰기 데이터베이스에 저장한 후, 사용자들이 소비하는 읽기 최적화 형식으로 변환합니다. 초기 아키텍처는 Kafka를 사용하여 쓰기 및 읽기 데이터베이스를 분리하여 독립적인 확장 및 최종 일관성을 허용했습니다. 그러나 이 접근 방식은 콘텐츠 편집과 웹 사이트 반영 사이에 지연을 초래했습니다. 팀은 페이지 데이터 서비스의 근 캐시를 사용하여 페이지 구축을 가속화하는 데 사용되는 지연의 원인을 확인했습니다. 이 문제를 해결하기 위해 넷플릭스는 RAW Hollow, 즉 메모리 내, 공동위치, 압축 객체 데이터베이스를 개발했습니다. 이는 강한 읽기-쓰기 일관성 및 낮은 지연을 제공합니다. Tudum은 RAW Hollow를 테스트하는 완벽한 후보였으며, 이는 I/O를 크게 줄이고 O(1) 시간에 동기식 데이터 액세스를 가능하게 했습니다. 업데이트된 아키텍처는 Kafka 인프라의 필요성을 제거하고 데이터 전파 시간을 줄였으며, 작가 및 에디터가 초 단위로 변경을 미리 볼 수 있게 되었습니다. 마이그레이션은 또한 요청 시간을 줄였으며, 홈페이지 구축 시간이 1.4초에서 0.4초로 줄었습니다. Netflix Tudum Architecture: from CQRS with Kafka to CQRS with RAW Hollow netflixtechblog.com +1
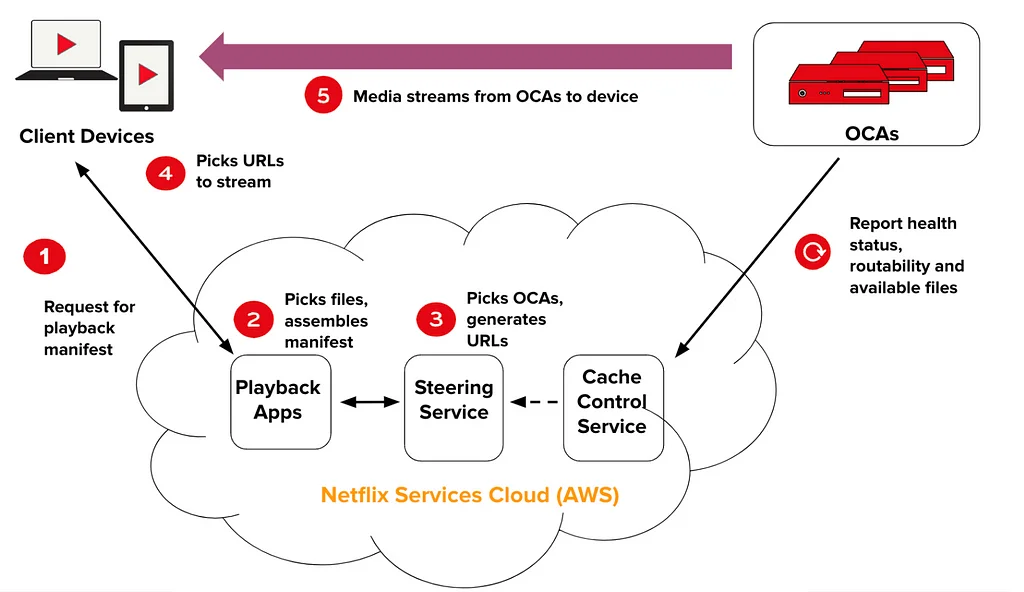
캐시 미스 분류를 통해 콘텐츠 전송 효율성 제고 넷플릭스의 오픈 커넥트 프로그램은 인터넷 서비스 공급자(ISP)와의 파트너쉽을 통해 콘텐츠 전달을 지역화하여 회원들에게 최상의 경험(QoE)을 제공하는 콘텐츠 전달 네트워크(CDN)입니다. 이 프로그램은 효율성과 비용 효율성을 위해 특별히 설계된 서버인 오픈 커넥트 어플라이언스(OCAs)를 사용합니다. 오픈 커넥트의 효율성을 평가하기 위해 넷플릭스는 캐시 미스, 즉 클라이언트에게 가장 적절한 OCA에서 바이트가 제공되지 않는 경우를 식별하는 프레임워크를 사용합니다. 캐시 미스는 세 가지 카테고리로 분류됩니다. 콘텐츠 미스는 로컬 사이트의 OCA에 파일이 없는 경우, 헬스 미스는 로컬 사이트의 OCA 하드웨어 리소스가 포화된 경우, 기타 미스는 기타 경우입니다. 넷플릭스는 캐시 미스를 계산하기 위해 두 가지 중요한 데이터 컴포넌트를 로깅합니다. 스티어링 플레이백 매니페스트 로그와 OCA 서버 로그입니다. 이러한 로그는 다양한 집계 수준에서 캐시 미스 메트릭스를 계산하는 데 사용됩니다. 캐시 미스를 계산하는 시스템 아키텍처는 로그 발송, 로그 통합, 로그 강화, 스트리밍 창 기반 조인으로 구성됩니다. 캐시 미스를 평가하는 데이터 모델은 오프라인 및 시뮬레이션에서 변수 매개변수와 함께 논리를 재생할 수 있도록 허용하여 프로덕션 트래픽에 영향을 주지 않고 새로운 조건 및 기능을 테스트할 수 있습니다. Driving Content Delivery Efficiency Through Classifying Cache Misses netflixtechblog.com +1
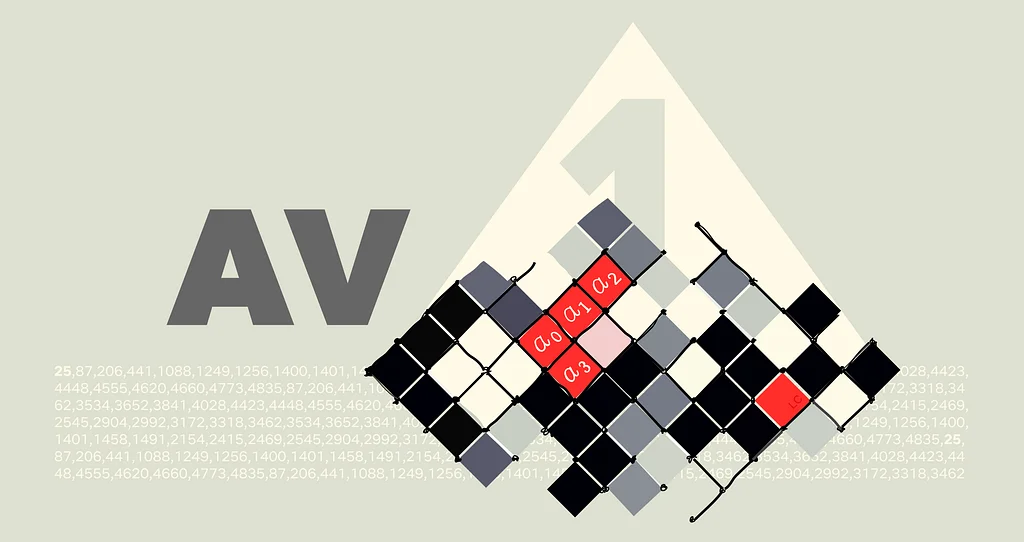
AV1 규모: 필름 그레인 합성, 깨어남 넷플릭스는 데이터 효율성을 최적화하면서도 영화적 질감의 예술적 무결성을 보존하는 AV1 필름 그레인 합성(FGS) 스트림을 도입했습니다. 필름 그레인은 스토리텔링의 핵심 요소로서 영화에 깊이와 사실감을 더하지만, 기존 알고리즘으로는 압축하기 어렵습니다. AV1 FGS 도구는 필름 그레인 패턴과 필름 그레인 강도라는 두 가지 구성 요소를 통해 필름 그레인을 모델링합니다. 필름 그레인 패턴은 자기 회귀 모델을 사용하여 복제되고, 필름 그레인 강도는 스케일링 함수에 의해 제어됩니다. 인코딩 과정에서는 비디오에서 필름 그레인을 제거하고 압축한 다음, 그레인의 패턴과 강도를 압축된 비디오 데이터와 함께 전송합니다. 재생 중에는 블록 기반 방법을 사용하여 필름 그레인을 다시 생성하여 비디오에 다시 통합합니다. AV1 FGS를 활성화하면 비트 전송률이 크게 줄어들어 더 적은 데이터로 고품질 비디오 스트리밍이 가능해졌습니다. 또한 합성된 노이즈가 압축 아티팩트를 효과적으로 가려 시각적 품질도 향상되었습니다. 넷플릭스는 플랫폼 전반에 걸쳐 FGS를 출시했으며, 이제 지원되는 장치에서 FGS 지원 스트림을 즐길 수 있습니다. 이 출시로 인해 넷플릭스 회원들은 더 낮은 비트 전송률, 감소된 재생 오류 및 향상된 재생 안정성을 통해 더 부드럽고 안정적인 품질의 경험을 누릴 수 있게 되었습니다. AV1 @ Scale: Film Grain Synthesis, The Awakening netflixtechblog.com +1
넷플릭스의 UDA (통합 데이터 아키텍처): "한 번 모델링, 모든 곳에서 표현" Netflix의 서비스가 성장함에 따라 이를 지원하는 시스템의 복잡성도 증가하여 중복되고 일관되지 않은 모델, 일관되지 않은 용어, 데이터 품질 문제 및 데이터 간의 일관되지 않은 관계로 이어집니다. 이러한 문제를 해결하려면 모델을 한 번 정의한 후 해당 정의를 모든 곳에서 재사용하고, 개념을 실제 시스템에 연결하고 이러한 정의를 외부로 프로젝션하고, 스키마를 생성하고, 시스템 전반에 걸쳐 일관성을 적용할 수 있는 새로운 기반이 필요합니다. 이는 UDA(Unified Data Architecture)의 개발로 이어졌으며, 이 UDA는 도메인을 한 번 모델링하고 시스템 전반에 걸쳐 일관되게 표현하여 자동화, 검색 가능성 및 의미론적 상호 운용성을 강화합니다. UDA를 통해 사용자와 시스템은 도메인 모델을 등록 및 연결하고, 도메인 모델을 데이터 컨테이너에 카탈로그 및 매핑하고, 도메인 모델을 스키마 정의 언어로 변환하고, 데이터 컨테이너 간에 데이터를 충실하게 이동하고, 도메인 개념을 검색 및 탐색하고, 프로그래밍 방식으로 지식 그래프를 검사할 수 있습니다. UDA는 비즈니스 개념을 스키마 및 데이터 컨테이너에 연결하는 지식 그래프로, UDA에서 도메인 모델링을 위한 언어를 정의하는 Upper라는 사내 메타모델을 기반으로 합니다. Upper는 도메인과 그 개념을 공식적으로 설명하는 언어이며 데이터 컨테이너 표현 및 매핑을 모델링하는 데 사용됩니다. UDA는 명명된 그래프 우선 정보 모델을 채택하여 전체 그래프에서 해상도, 모듈성 및 거버넌스를 보장합니다. Model Once, Represent Everywhere: UDA (Unified Data Architecture) at Netflix netflixtechblog.com +1
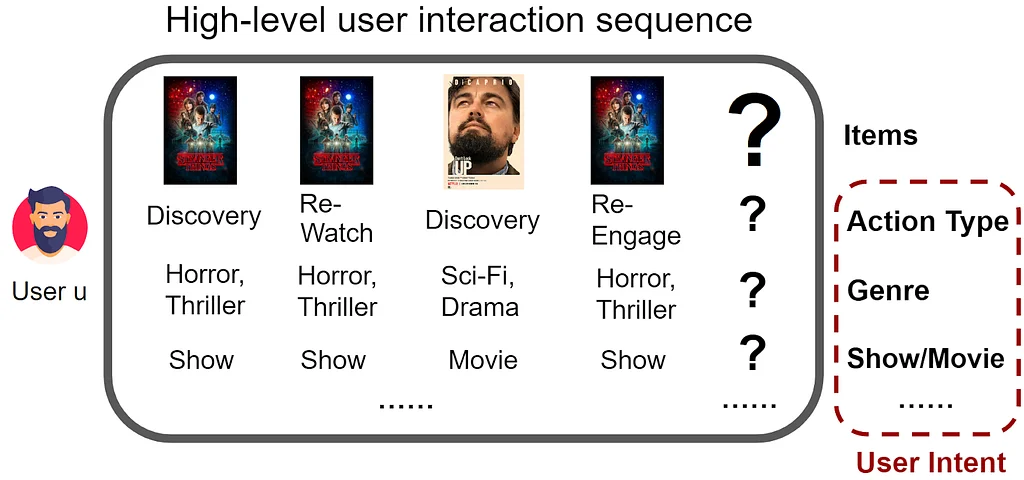
FM-Intent: 계층적 다중 태스크 학습으로 사용자 세션 의도 예측 추천 시스템은 전자 상거래, 스트리밍 미디어, 소셜 네트워크의 필수 구성 요소로 제품 및 비즈니스에 큰 영향을 미칩니다. 넷플릭스에서는 이러한 시스템이 적절한 콘텐츠를 회원에게 적시에 제공합니다. 추천 기초 모델은 사용자 선호도를 이해하는 데 상당한 진전을 이루었습니다. 그러나 사용자 세션의 이해를 넘어 다음 항목 예측을 넘어선 사용자 의도 예측을 통합하여 모델의 기능을 추가로 향상시킬 수 있습니다. 최근 연구에서는 온라인 플랫폼에서 사용자 의도를 이해하는 것이 더 정확하고 개인화된 추천을 이끌어내는 데 중요하다는 것을 강조했습니다. FM-Intent는 새로운 추천 모델로, 사용자의 짧은 기간 및 장기적인 신호를 대리하여 잠재적인 사용자 의도를 포착하고, 이를 다음 항목 추천을 개선하는 데 사용합니다. 이 모델은 의도 예측과 다음 항목 추천 간에 계층적 관계를 설정하여 더 일관되고 효과적인 추천 파이프라인을 생성합니다. FM-Intent는 세 가지 주요 기여를 합니다. 새로운 추천 모델, 계층적 다중 작업 학습 접근 방식, 그리고 최첨단 모델보다 유의미한 개선 사항을 보여주는 포괄적인 실험 검증입니다. FM-Intent는 넷플릭스의 추천 생태계에 성공적으로 통합되어 있으며, 개인화된 UI 최적화, 분석 및 향상된 추천 신호와 같은 다양한 다운스트림 애플리케이션에 활용할 수 있습니다. FM-Intent: Predicting User Session Intent with Hierarchical Multi-Task Learning netflixtechblog.com +1
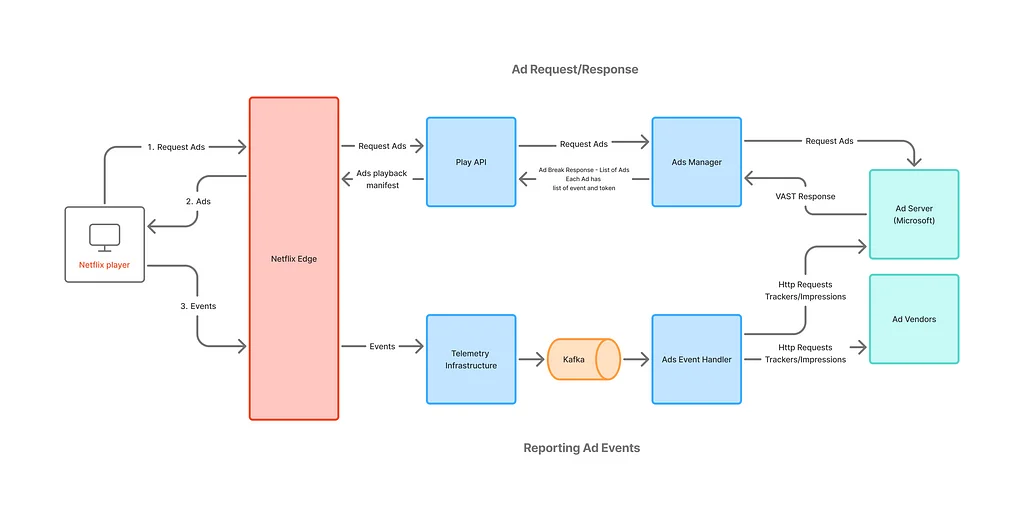
뒤쪽에서: 강력한 광고 이벤트 처리 파이프라인을 구축하는 과정 넷플릭스는 광고 캠페인을 모니터링, 측정 및 최적화하기 위해 강력한 이벤트 처리 플랫폼을 구축했습니다. 광고 서빙 시스템은 의사결정, 빈도 제한, 페이싱 및 개인화를 조정하기 위해 꾸준한 광고 이벤트 스트림에 의존합니다. 초기 광고 이벤트 처리 시스템은 마이크로소프트 광고 서버, 넷플릭스 광고 관리자 및 광고 이벤트 핸들러라는 세 가지 주요 구성 요소로 구성되었습니다. 이 시스템은 노출 수, 빈도 제한 및 수익 창출 프로세스에 대한 통찰력을 제공하여 피드백 루프가 효과적으로 작동하도록 설계되었습니다. 사업이 확장됨에 따라 데이터 볼륨 증가 및 타사 추적 URL과 같은 과제를 해결하기 위해 키-값 추상화를 사용하는 새로운 지속성 계층이 도입되었습니다. 이벤트 처리 파이프라인은 빈도 제한, 가격 정보 및 강력한 보고 시스템과 같은 기능을 통합하여 자체 광고 기술을 지원하도록 더욱 발전했습니다. 소비자에게 단일 통합 데이터 계약을 제공하고 상위 시스템과 소비자 간의 우려 사항을 분리하는 중앙 집중식 광고 이벤트 수집 시스템이 계획되었습니다. 새로운 파이프라인은 측정, 재무/청구, 보고, 빈도 제한 및 광고 서버로의 필수 피드백 루프 유지와 같은 다양한 기능을 지원했습니다. 광고 이벤트 처리 시스템의 개발은 다양한 팀 간의 팀워크, 계획 및 조정을 보여주는 신중하게 조율된 여정이었습니다. 새로운 시스템은 프로그래매틱 구매 기능 지원, 옵트아웃 신호 공유 및 정확한 보고 및 측정 보장을 통해 비즈니스를 위한 새로운 기능을 출시하는 능력을 크게 향상시켰습니다. Behind the Scenes: Building a Robust Ads Event Processing Pipeline netflixtechblog.com +1
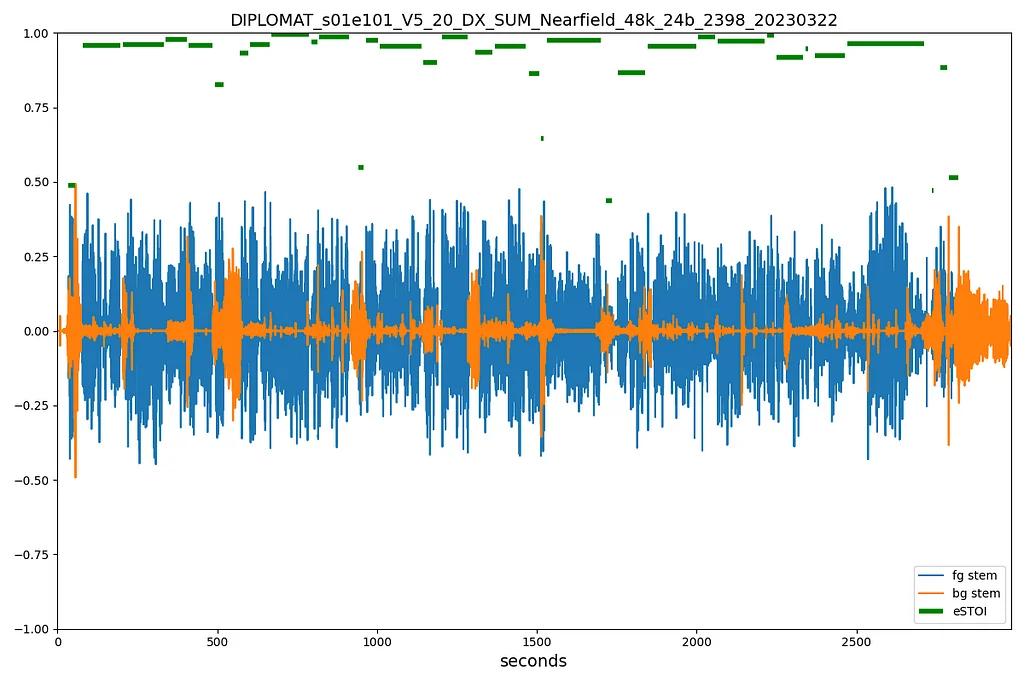
넷플릭스 콘텐츠 대사 명료도 측정 넷플릭스는 기술 파트너와의 협력을 통해 도구와 워크플로우를 개선함으로써 회원 경험 향상에 우선순위를 둡니다. 이 협력은 제작 과정 전반에 걸쳐 대화 명료성을 향상시키는 데 초점을 맞추고 있으며, 촬영 현장에서 스크린에 이르기까지 발생하는 문제를 해결합니다. 주요 이니셔티브는 대화 무결성 파이프라인(Dialogue Integrity Pipeline)으로, 시끄러운 환경 및 오디오 믹싱과 같이 명료성에 영향을 미치는 요인을 식별하고 완화합니다. 넷플릭스는 업계 표준 음량 측정기를 사용하고, 대화 명료성을 분석하기 위해 eSTOI 기반 측정 시스템을 개발했습니다. 사전 전달 최적화를 개선하기 위해 넷플릭스는 Fraunhofer IDMT 및 Nugen Audio와 파트너십을 맺고 DialogCheck 플러그인을 개발했습니다. 이 플러그인은 디지털 오디오 워크스테이션(DAW)에 통합되어 사운드 엔지니어에게 실시간 피드백을 제공합니다. 이 협력은 Fraunhofer의 머신러닝 기반 음성 명료성 솔루션과 Nugen Audio의 오디오 플러그인 전문 지식을 활용합니다. DialogCheck 플러그인을 통해 대화 명료성 문제를 조기에 감지하고 해결하여 예술적 의도가 훼손되지 않도록 보장합니다. 궁극적인 목표는 청취 환경에 관계없이 모든 시청자에게 몰입적이고 접근성 높은 스토리텔링을 제공하는 것입니다. 이러한 협력적 접근 방식은 넷플릭스의 오디오 우수성 및 스토리텔링 혁신에 대한 헌신을 강조합니다. Measuring Dialogue Intelligibility for Netflix Content netflixtechblog.com +1
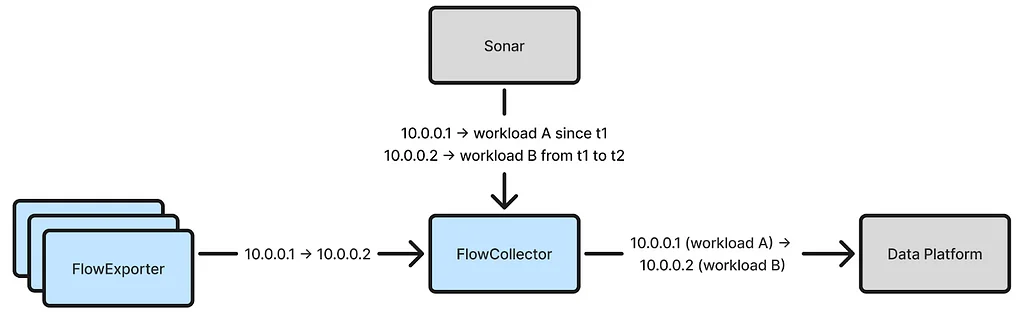
넷플릭스가 정확하게 eBPF 흐름 로그를 속성짓는 방법 넷플릭스는 확장된 네트워크 통찰력을 위해 eBPF를 사용하여 대규모로 TCP 플로우 로그를 수집하지만, 플로우 IP 주소를 워크로드 ID에 정확하게 연결하는 것은 상당한 과제였습니다. 초기 연결 방식은 내부 IP 주소 추적 서비스인 Sonar에 의존했지만, 분산 시스템의 지연 및 장애로 인해 잘못된 연결이 발생했습니다. 잘못된 연결로 인해 플로우 데이터의 신뢰성이 떨어져 의사결정에 활용할 수 없었으며, 연결하기 전에 수신된 플로우를 15분 동안 보류하는 해결 방법으로도 문제가 해결되지 않았습니다. 이 문제를 해결하기 위해 넷플릭스는 로컬 워크로드 ID를 환경에서 판별하여 로컬 IP 주소를 연결하는 새로운 연결 방식을 개발했습니다. 컨테이너 워크로드의 경우, 넷플릭스는 컨테이너 IP 주소 할당 서비스인 IPMan을 활용하여 로컬 IP 주소를 연결했습니다. 로컬 IP 주소가 연결되면, 각 워크로드가 특정 IP 주소를 소유하는 시간 범위를 학습하여 원격 IP 주소를 연결할 수 있습니다. FlowCollector는 이러한 정보를 나타내는 인메모리 해시맵을 유지하고, Kafka를 사용하여 학습된 시간 범위를 다른 노드와 공유합니다. 이 새로운 방식은 정확한 연결을 달성하고 일시적인 문제를 효과적으로 처리하며, 단순성과 인메모리 조회 덕분에 비용 효율적입니다. 이 방식은 해당 지역의 노드로 플로우를 전달하여 지역 간 IP 주소 연결로 확장되었습니다. 마지막으로, 넷플릭스의 콘텐츠 전송 네트워크에 속한 것과 같은 비워크로드 IP 주소 연결로도 확장되었습니다. How Netflix Accurately Attributes eBPF Flow Logs netflixtechblog.com +1
넷플릭스의 미디어 프로덕션 스위트로 글로벌 생산 확장 영화 산업이 클라우드 기반 워크플로우로 전환하는 데는 전 세계적인 구현에 어려움이 따릅니다. 넷플릭스는 영화 제작자를 위해 설계된 Media Production Suite (MPS)를 통해 이러한 문제점을 해결하고자 합니다. MPS는 미디어 관리를 간소화하여 지루한 작업을 없애고 창의적인 집중력을 높여줍니다. 물리적 테이프를 사용하는 기존 워크플로우는 느리고 번거로워 협업을 방해합니다. 디지털 워크플로우 또한 배포 및 표준화에 어려움을 겪습니다. 클라우드는 이러한 문제에 대한 해결책을 제시하지만 운영 및 기술적 장애물을 극복해야 합니다. 넷플릭스는 사람과 애플리케이션을 미디어에 가져오는 방식으로 이 문제를 해결합니다. 즉, 그 반대가 아닌 것이죠. MPS는 다양한 시장의 요구를 고려하여 기술 및 표준화의 글로벌 격차를 해소합니다. 이 스위트는 업계 표준을 사용하여 색상 관리 및 프레임 작업과 같은 프로세스를 자동화합니다. 인프라는 사용자 성능에 최적화된 클라우드 및 물리적 기능을 결합합니다. MPS에는 섭취(ingest), 미디어 라이브러리, 데일리, 원격 워크스테이션 등을 위한 도구가 포함되어 있습니다. 350개 이상의 작품이 MPS 도구를 활용했으며, 다양한 글로벌 지역에서 피드백을 받았습니다. 브라질 시리즈 "Senna"는 MPS를 채택하여 지리적 장벽을 극복하는 능력을 보여주었습니다. Globalizing Productions with Netflix’s Media Production Suite netflixtechblog.com +1
개인화 추천을 위한 기반 모델 넷플릭스는 회원 선호 학습을 중앙 집중화하고 다양한 추천 모델 전반의 효율성을 향상시키기 위해 추천을 위한 파운데이션 모델을 개발하고 있습니다. 현재 시스템은 유지 관리에 비용이 많이 들고 혁신을 공유하는 데 어려움을 겪는 특화된 모델을 가지고 있습니다. 파운데이션 모델은 광범위한 사용자 상호작용 기록과 콘텐츠 데이터를 학습하여 이러한 학습 내용을 다른 모델에 배포하는 것을 목표로 합니다. 대규모 언어 모델에서 영감을 얻어, 이 접근 방식은 반지도 학습을 사용하여 데이터 중심 전략으로 전환합니다. 넷플릭스는 사용자 상호작용을 토큰화하여 데이터 세분성과 시퀀스 압축의 균형을 맞춰 긴 상호작용 기록을 처리합니다. 희소 어텐션 메커니즘과 슬라이딩 윈도우 샘플링을 사용하여 훈련 중에 계산 효율성을 관리합니다. 각 토큰에는 액션 및 콘텐츠에 대한 풍부하고 이질적인 정보가 포함되어 있으며, 요청 시점 및 액션 후 기능을 활용합니다. 이 모델은 GPT와 유사하게 자기 회귀적 다음 토큰 예측 목표를 사용하지만, 다양한 상호작용 중요성을 고려하도록 수정되었습니다. 모델은 여러 토큰을 예측하고 보조 예측 목표를 사용하여 장기적인 종속성을 포착하고 정확도를 향상시킵니다. 엔티티 콜드 스타팅 문제를 해결하기 위해, 이 모델은 증분 훈련을 통해 구축되었으며, 엔티티와 입력의 메타데이터 정보를 사용하여 보이지 않는 엔티티로 추론할 수 있습니다. Foundation Model for Personalized Recommendation netflixtechblog.com +1
넷플릭스에서 HDR10+ 스트리밍 지원 시작 넷플릭스가 AV1 지원 기기에서 HDR10+ 콘텐츠 스트리밍을 시작하여 인증된 HDR10+ 기기에서 더욱 향상된 시청 경험을 제공합니다. 이는 정적 메타데이터만 사용했던 기존 HDR10 콘텐츠를 개선한 것입니다. HDR10+의 동적 메타데이터는 화질과 정확도를 향상시킵니다. 넷플릭스는 HDR 기술 도입의 선구자였으며, 지난 5년간 HDR 스트리밍은 300% 이상 증가했습니다. 현재 넷플릭스는 11,000시간 이상의 HDR 콘텐츠를 제공하고 있습니다.넷플릭스는 가장 효율적인 코덱 중 하나인 AV1 비디오 코덱을 사용하여 HDR10+를 활성화했습니다. AV1은 이미 넷플릭스에서 두 번째로 많이 스트리밍되는 코덱이며, HDR10+ 스트림이 추가됨에 따라 곧 가장 많이 스트리밍되는 코덱이 될 것으로 예상됩니다. 넷플릭스는 새로운 출시작과 기존 인기 HDR 콘텐츠 모두에 HDR10+ 스트림을 추가하고 있으며, 연말까지 모든 HDR 콘텐츠에 HDR10+ 경험을 제공하는 것을 목표로 하고 있습니다.HDR10+는 돌비 비전, HDR10과 함께 널리 사용되는 세 가지 HDR 포맷 중 하나입니다. HDR10+와 돌비 비전은 프레임 단위로 콘텐츠 이미지 통계를 제공하는 동적 메타데이터를 사용하여 각 장면에 최적화된 톤 매핑 조정을 가능하게 합니다. 이를 통해 원본에 대한 더 높은 인지적 충실도를 달성하여 창작자의 의도를 보존합니다. HDR10+를 시청하려면 넷플릭스 프리미엄 요금제에 가입되어 있어야 하며, 해당 콘텐츠가 HDR10+ 포맷으로 제공되어야 하고, 회원 기기가 AV1과 HDR10+를 지원해야 합니다.HDR10+ 출시에는 넷플릭스의 여러 팀이 협력했으며, 이 아이디어를 현실로 만드는 데 기여한 모든 분들께 감사드립니다. 혁신과 품질에 대한 헌신은 모든 회원에게 몰입감 있고 진정한 시청 경험을 제공하려는 넷플릭스의 노력을 강조합니다. HDR10+ Now Streaming on Netflix netflixtechblog.com +1
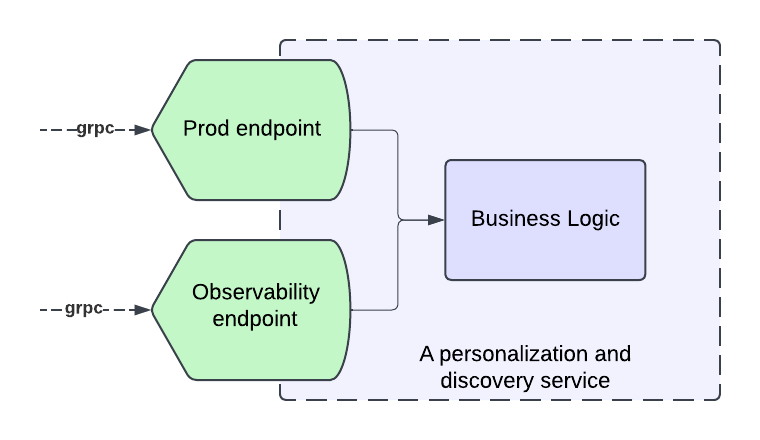
넷플릭스 규모의 타이틀 출시 관측가능성 넷플릭스는 포괄적인 타이틀 관찰성을 달성하기 위해 개인화 및 발견 스택 내 모든 서비스에 관찰성 엔드포인트를 도입했습니다. 스택에 포함된 각 마이크로서비스는 실제 동작을 정확하게 반영하고, 표준화하며, 인사이트 삼각형(Insight Triad)에 답하는 새로운 "타이틀 상태(Title Health)" 엔드포인트를 도입해야 했습니다. 인사이트 삼각형은 엔드포인트가 타이틀이 홍보에 적합한지 여부, 적합하지 않은 이유, 문제 해결 방법을 답해야 함을 의미합니다.관찰성 서비스와 개인화 스택의 관찰성 엔드포인트 간 통신을 표준화하기 위해 안정적인 프로토콜 요청/응답 형식이 개발되었습니다. 이 솔루션의 상위 아키텍처는 관찰성 엔드포인트 구축, 사전 예방적 모니터링, 실시간 타이틀 노출 추적, 최적화된 데이터 저장소에 데이터 저장, 대시보드를 위한 쉽게 통합 가능한 API 제공을 포함합니다.타이틀 상태 마이크로서비스는 30분마다 예약된 수집 작업을 실행하여 할당된 로우 서비스에서 관련 타이틀 상태 정보를 가져옵니다. 실시간 타이틀 노출 데이터는 Kafka 큐에서 처리되며, 2분마다 큐를 폴링하여 노출 데이터를 가져옵니다. 그런 다음 데이터가 집계되어 이해관계자에게 추가적인 상태 표시기로 표시됩니다.데이터는 각 수집기마다 전용 Hollow 피드에 저장됩니다. 이를 통해 고성능 읽기 전용 액세스가 가능하고 전반적인 상태 모니터링과 타이틀 기록 추적이 가능합니다. 관찰성 대시보드는 타이틀 상태 서비스를 사용하여 이해관계자에게 타이틀 상태를 표시하며, 시스템에는 문제가 회원에게 영향을 미치기 전에 문제를 파악하고 해결하기 위해 트래픽을 미리 시뮬레이션하는 "타임 트래블(Time Travel)" 기능도 있습니다.이 시스템의 아키텍처와 전략을 통해 넷플릭스는 타이틀 출시 관찰성을 향상시켜 흥미진진한 시청 경험을 보장하고 콘텐츠 제작자 및 파트너와의 신뢰를 구축했습니다. 또한 이 솔루션은 미래 혁신을 위한 기반을 마련하여 모든 스토리가 의도된 대상에게 도달하고 모든 회원이 넷플릭스에서 좋아하는 타이틀을 즐길 수 있도록 합니다. Title Launch Observability at Netflix Scale netflixtechblog.com +1
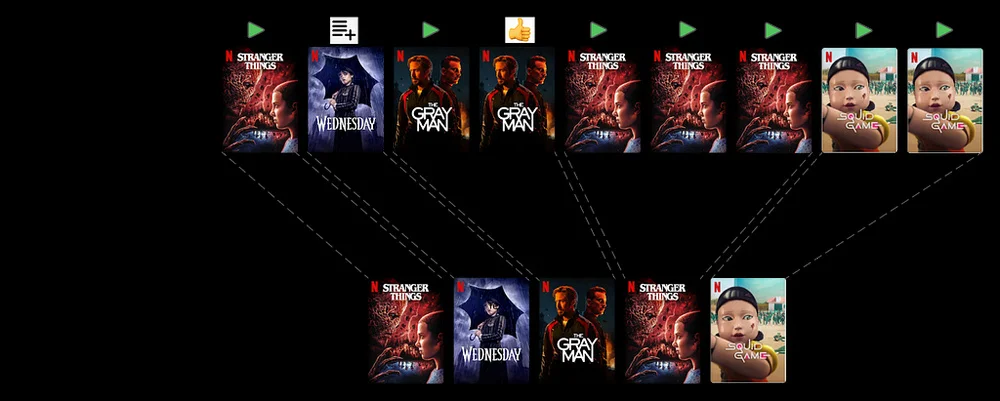
넷플릭스의 인상 소개 넷플릭스에서 플랫폼의 이미지들은 "노출"이라고 불리며 사용자 경험을 개인화하는 데 중요한 역할을 합니다. 이러한 노출을 캡처하고 처리하는 것은 복잡한 작업으로, 정교한 시스템이 필요합니다. 시스템은 일일로 수십억 개의 노출을 추적하고 처리하며, 각 프로필의 노출에 대한 자세한 기록을 유지합니다. 이 노출 기록은 향상된 개인화, 빈도 제한, 새로운 릴리스 강조, 분석적 통찰력을 얻는 데 필수적입니다. 노출을 관리하는 첫 번째 단계는 Source-of-Truth(SOT) 데이터셋을 생성하는 것입니다. 이는 다양한 다운스트림 워크플로우를 지원하고 여러 사용 사례를 가능하게 합니다. 원시 노출 이벤트는 클라이언트 측에서 수집되어 사용자 지정 이벤트 추출기, 아파치 카프카, 아파치 아이스버그를 통해 처리됩니다. 그런 다음 데이터는 아파치 플링크를 사용하여 필터링, 풍부화, 구조화되어 넷플릭스의 노출 데이터에 대한 확고한 진실의 근거가 됩니다. 시스템은 자세한 메트릭스를 수집하고 잠재적인 문제가 발생할 경우 팀에 경고를 보내며, 높은 품질의 노출을 보장합니다. 아키텍처는 대량의 노출 이벤트를 실시간으로 처리하는 데 설계되었으며, 확장성, 유연성, 높은 가용성을 중점으로 합니다. 향후 작업에는 비스키마 이벤트를 처리하는 것, 성능 튜닝을 자동화하는 것, 데이터 품질 경고를 개선하는 것이 포함됩니다. Introducing Impressions at Netflix netflixtechblog.com +1
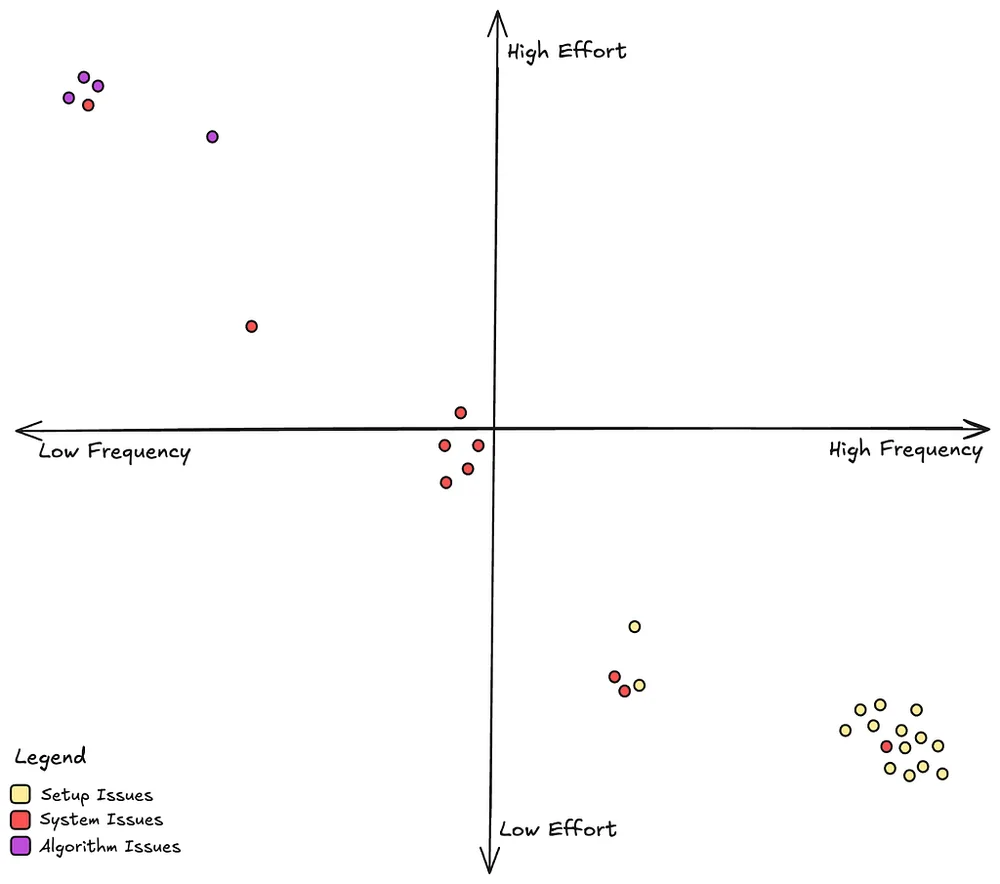
넷플릭스 규모의 관찰 가능성 런칭 넷플릭스에서 무결한 제목 출시와 검색 가능성을 보장하기 위해선, 솔루션에 뛰어들기 전에 더 넓은 맥락을 이해하는 것이 필수적입니다. 이러한 생각 있는 접근 방식은 미래의 탄력성과 확장성을 구축합니다. 첫 번째 단계는 더 큰 그림을 이해하는 것입니다. 즉, 이해 관계자, 현재의 경관, 핵심 문제, 비즈니스 우선순위를 확인하는 것입니다. 주요 이해 관계자는 제목 출시 운영자, 개인화 시스템 엔지니어, 제품 매니저, 크리에이티브 대 diện입니다.현재의 경관을 매핑하는 과정에서 제목 출시 관찰 가능성에 대한 확립된 솔루션이 없었음을 알게 되었습니다. 이는 cả 도전과 기회를 제시합니다. 핵심 문제는 개인화 스택에서 모든 제목이 공정하게 대우받는 것을 보장하는 것이었습니다. 이를 해결하기 위해 "제목 건강"이라는 공유된 이해를 도입했습니다. 이는 검색 가능성 및 회원 참여 측면에서 제목의 성과를 반영하는 다양한 지표와 지표를 포함합니다.제목 건강은 각 제목의 수명 주기 모니터링 및 최적화를 허용하여 파트너와 원칙 및 요구 사항에 대한 조정을 가능하게 했습니다. 제목 출시 관찰 가능성을 위한 강력한 계획을 구축하기 위해 문제를 세 가지 주요 영역으로 분류했습니다. 즉, 제목 설정, 개인화 시스템, 알고리즘입니다. 문제를 분류하면 도전을 체계적으로 해결할 수 있고, 모든 제목에 대한 신뢰할 수 있는 개인화 경험을 제공할 수 있습니다.문제 분석 결과, 설정 문제가 가장 일반적이나 가장 쉽게 해결할 수 있는 반면, 알고리즘 문제는 드물지만 해결하기 어려운 것으로 나타났습니다. 옵션 평가 결과, 첫 번째로 proactice 문제 감지에 초점을 두기로 결정했습니다. 즉, 출시 전에 문제를 잡아 더 매끄러운 출시, 더 나은 회원 경험, 더 강한 시스템 신뢰성을 보장하는 것입니다. 이러한 결정은 플랫폼의 복잡성이 증가하는 것에 따라 성장할 수 있는 확장 가능하고 강력한 시스템의 기초를 마련했습니다. Title Launch Observability at Netflix Scale netflixtechblog.com +1