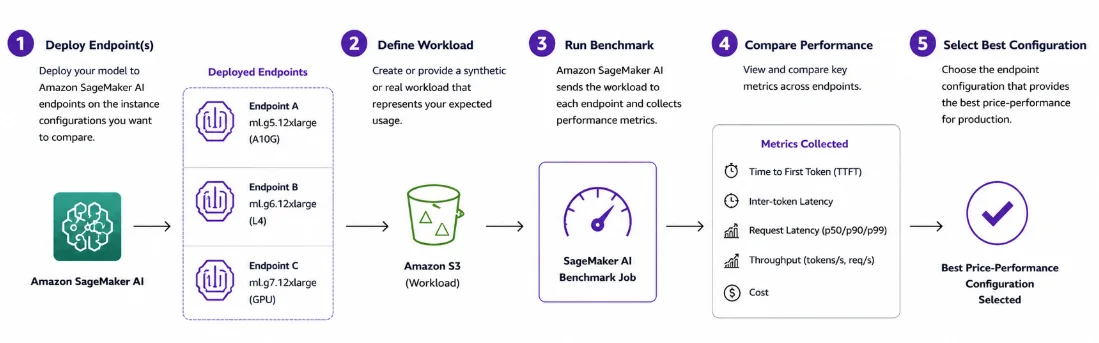
SageMaker AI에서 소형 LLM 추론 벤치마킹: G7 vs G5 및 G6
Amazon SageMaker AI의 G5, G6, G6e 및 G7 GPU 인스턴스에서 두 개의 30B Mixture-of-Experts 모델인 Qwen3-Coder-30B와 NVIDIA Nemotron-3-Nano-30B를 벤치마킹합니다. 처리량, 지연 시간 및 토큰당 비용을 비교하고 G7의 NVIDIA Blackwell GPU가 실시간 LLM 추론에 대해 측정 가능한 가격 대비 성능 향상을 제공하는 방법을 확인합니다.