AWS Machine Learning Blog на русском
Подписаться
Инженерия ядер "Смесь экспертов" на Amazon SageMaker AI
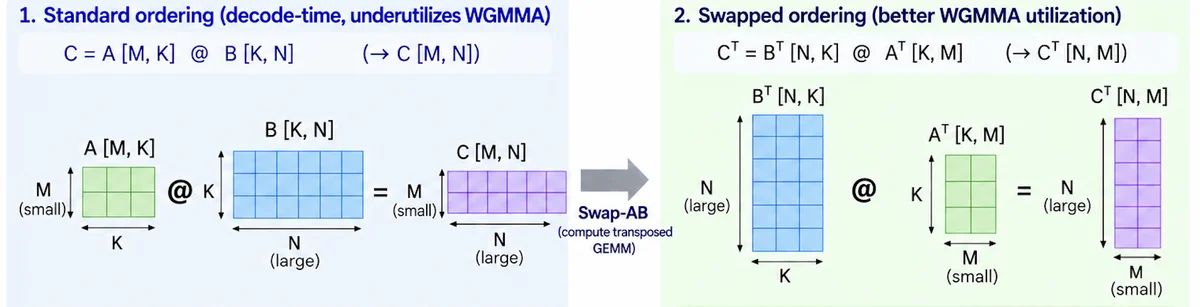
Инженеры AWS делятся оптимизациями ядра для моделей с объединенными смесями экспертов (MoE) на Amazon SageMaker AI: Swap-AB для использования WGMMA, маршрутизация бэкенда Triton для квантования FP8 и устранение повторной компиляции Triton JIT. Вместе они обеспечивают до 10% более высокую пропускную способность и до 9% более быстрое время до первого токена на GPU H200.