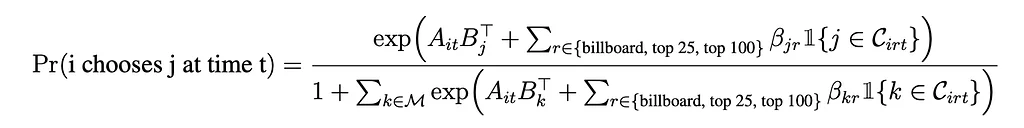Netflix TechBlog | Medium на р... Заметка

Netflix TechBlog | Medium на русском

Блог Netflix Tech Blog рассказывает о том, как Netflix работает с технологиями. Они проводят исследования в области науки о данных, инженерии, дизайна и технологических инноваций. Они демонстрируют свои инновации, такие как собственная сеть доставки контента, и рассказывают о своих усилиях по обеспечению надежности сервиса.

Трэд заметок

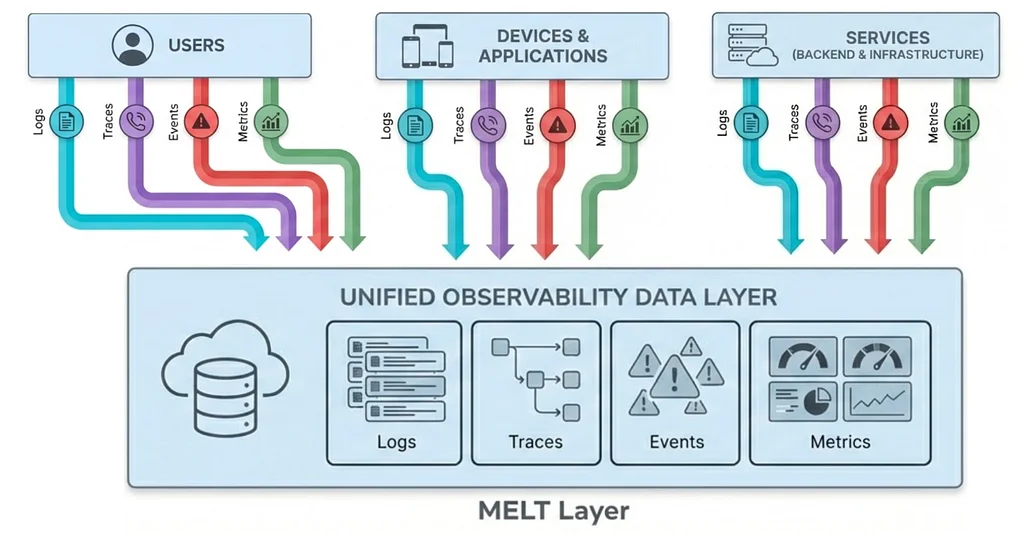
Компания сталкивается с трудностями в понимании своей массивной, сложной инфраструктуры, особенно во время прямых трансляций, таких как бой Джейка Пола и Майка Тайсона, который привлек 65 миллионов просмотров. Отладка проблем, таких как медленная отрисовка домашнего экрана, может занимать часы, поскольку информация разрознена по разным системам. Эти системы собирают данные с помощью метрик, событий, логов и трассировок (MELT), но эффективная корреляция этих данных затруднена. Основная проблема заключается в отсутствии общего, машиночитаемого понимания операционных сущностей.Для решения этой проблемы была разработана "Онтология наблюдаемости" — формальная спецификация типов, свойств и отношений в операционном мире. Эта онтология использует стандарты, такие как RDF, OWL, SHACL и SPARQL, храня данные в виде графа знаний. Ключевым решением при проектировании было избегать общего типа "Сервис", вместо этого используя конкретные, проверенные типы, такие как ops:Application. Также было принято решение моделировать рассуждения и контекст из обсуждений инцидентов, преобразуя неструктурированный чат в структурированные тройки.Онтология создает детерминизм из изначально стохастических процессов, таких как LLM и нечеткое сопоставление, с помощью конвейерного подхода. Этот конвейер использует "обогатители", которые снижают энтропию, преобразуя зашумленные входные данные в типизированные тройки, следуя строгим контрактам. Эти обогатители гарантируют, что каждая сущность имеет тип, URI следуют схеме именования, а приложения проверяются по каталогу. Конвейер выполняется последовательно, чтобы избежать состояний гонки, при этом внешние вызовы выполняются по возможности, чтобы предотвратить блокировку.Затем "Движок корреляции" объединяет сигналы из различных источников, выявляя причинно-следственные или корреляционные цепочки событий. Он анализирует тринадцать типов сигналов, предлагая гипотезы с доказательствами и оценками уверенности, сохраняя поддерживающие записи графа. Каждый цикл наблюдения, обогащения, корреляции и хранения формирует "Маховик знаний", непрерывно обогащая граф знаний и улучшая контекст системы. Этот маховик призван сократить время отладки, предоставляя унифицированное и взаимосвязанное представление операционной деятельности системы.
CdXz5zHNQW_iZ7761FCA3.png
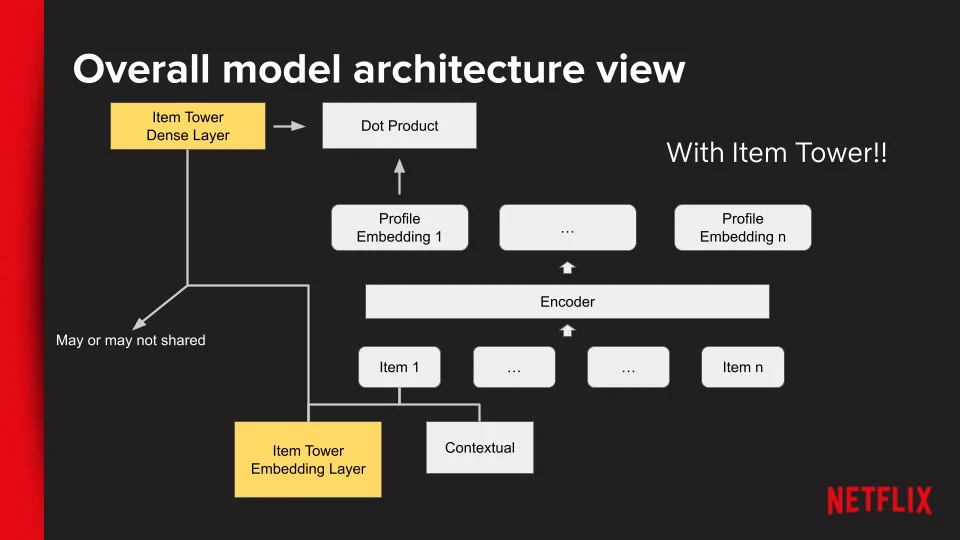
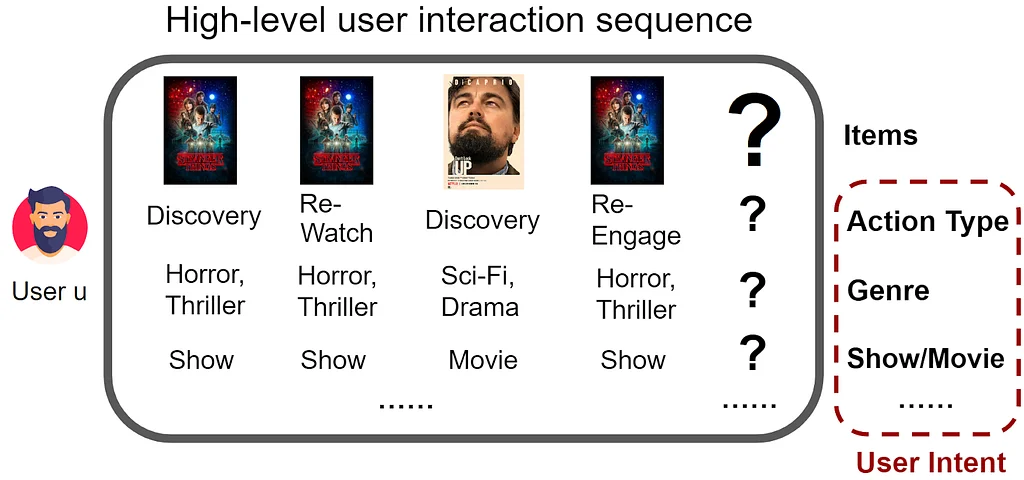
Netflix разработала фундаментальную модель для персонализации, чтобы централизовать обучение предпочтениям участников. Эта мощная модель, обученная на обширных данных о взаимодействии пользователей и контенте, распределяет свои знания другим моделям. Интеграция этой большой модели в производственные системы представляла собой проблему, что побудило Netflix экспериментировать с тремя различными подходами: эмбеддингами, подграфом и дообучением. Каждый метод отвечает различным потребностям приложений в отношении задержки, технологического стека и использования модели.Подход с эмбеддингами использует предварительно вычисленные представления профилей пользователей и элементов из фундаментальной модели, хранящиеся в хранилище эмбеддингов. Хотя этот подход прост и экономичен, он может приводить к устаревшим рекомендациям из-за временного разрыва между вычислением и выводом. Netflix улучшает это ежедневным дообучением и техникой стабилизации эмбеддингов. Разрабатывается фреймворк почти в реальном времени для устранения устаревания и повышения адаптивности.Интеграция подграфа рассматривает декодер фундаментальной модели как компонент в графе модели приложения. Это позволяет глубже интегрироваться, использовать актуальные знания и раскрывать ценность, специфичную для приложения, получая доступ к конкретным слоям фундаментальной модели. Однако это усложняет генерацию признаков и увеличивает размер модели и время вывода. Этот подход зарезервирован для случаев использования с высоким влиянием, где улучшения метрик оправдывают затраты.Подход дообучения адаптирует фундаментальную модель для конкретных приложений, дополнительно обучая ее на данных и целях, специфичных для продукта. Это обеспечивает оптимизированную производительность и служит базовым уровнем для новых приложений. Хотя это требует тщательной оптимизации для задержки и соглашений об уровне обслуживания (SLA), это может привести к распространению моделей и конвейеров. Netflix предоставляет фреймворк дообучения для упрощения этого процесса.Текущие инновации включают вывод эмбеддингов почти в реальном времени и меньшие, "дистиллированные" версии фундаментальной модели для снижения задержки. Стандартизированные API и надежный фреймворк дообучения призваны упростить использование фундаментальной модели для команд приложений. Эти три шаблона интеграции обеспечивают комплексную стратегию для приложений Netflix, позволяющую извлечь выгоду из фундаментальной модели.
CdXz5zHNQW_hmBwk8f7S1.png
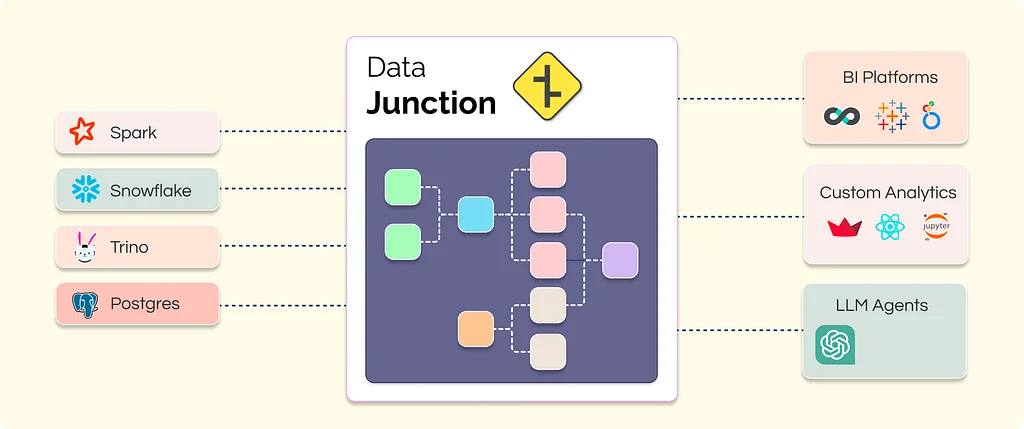
Netflix столкнулась с проблемами разрозненных, непоследовательно определенных и ненадежных метрик, особенно в своей платформе экспериментов. Эта сложность мешала специалистам по данным и инженерам аналитики, из-за чего процесс внедрения метрик в предыдущей системе занимал недели. Для решения этой проблемы Netflix исследовала решения семантического слоя и выбрала DataJunction благодаря его надежному движку разбора и генерации SQL, а также хранилищу метаданных на основе графов. DataJunction возник на Facebook для решения проблем переносимости метрик, а затем был открыт и доработан инженерами Netflix. Ключевым архитектурным решением стало приоритетное использование подхода "API-first", сфокусированного на надежном движке семантического слоя и API с возможностью ввода и вывода SQL. Платформа приняла многомерные кубы как первоклассную функцию для привычных пользовательских интерфейсов и эффективной доставки данных. Способность DataJunction связывать определения метрик с источником упрощает устранение неполадок и ад-хок анализ. Интеграция платформы в домен экспериментов Netflix упростила определение и управление метриками и измерениями. Будущие планы включают унификацию общей аналитики в Netflix путем создания более тесных интеграций с другими инструментами. Это позволит упростить обнаружение, использование и экспериментирование с метриками во всем стеке данных Netflix.
CdXz5zHNQW_l7K4dKBoxE.png
Персонализация — ключевая особенность онлайн-платформ, таких как Netflix, влияющая на обнаружение контента пользователями и их вовлеченность. Однако оценка истинной ценности персонализации представляет собой значительную проблему, поскольку рекомендации нацелены на основе предполагаемых предпочтений пользователя, что затрудняет отделение эффектов рекомендаций от привлекательности самого контента для пользователя. Наивный подход, заключающийся в подсчете просмотров рекомендованного контента, недостаточен, поскольку он не устанавливает причинно-следственную связь. Проведение экспериментов с полным отключением персонализации негативно скажется на пользовательском опыте и поэтому не является жизнеспособной стратегией измерения.Вместо этого исследователи разработали гибридный подход, сочетающий поведенческую модель с маломасштабными A/B-тестами. Эта модель оценивает, как рекомендации влияют как на решения о просмотре, так и на выбор контента, отделяя основные предпочтения пользователя от дополнительного влияния рекомендации. Модель динамически представляет предпочтения участников, фиксируя, как история просмотров формирует текущие вкусы. Она явно моделирует "бонусный" эффект рекомендаций на выбор контента, отражая повышенную осведомленность и информацию.Для проверки точности модели в прогнозировании паттернов замещения она была сравнена с результатами рандомизированных экспериментов. Эти эксперименты вводили экзогенные вариации в видимость контента, имитируя изменения в алгоритмах рекомендаций. Модель продемонстрировала высокую предсказательную силу, а ее смоделированные коэффициенты переключения показали высокую корреляцию с экспериментальными оценками.Используя валидированную модель, исследователи провели контрфактический анализ для сравнения текущей системы рекомендаций Netflix с базовыми уровнями, такими как случайные рекомендации, рекомендации на основе популярности и базовые рекомендации матричной факторизации. Текущая система значительно превзошла эти базовые уровни по совокупной вовлеченности, снизив ее на 16% для случайных рекомендаций и на 12% для рекомендаций на основе популярности. Даже по сравнению с матричной факторизацией, текущая система показала прирост вовлеченности на 4%.Помимо простого увеличения просмотров, модель также оценила разнообразие потребляемого контента. Текущая система поддерживала более широкое распределение просмотров по контенту, в отличие от рекомендаций на основе популярности и матричной факторизации, которые привели к увеличению концентрации просмотров. Случайные рекомендации обеспечивали большее разнообразие, но ценой значительного снижения вовлеченности. Таким образом, персонализация не только стимулирует большее количество просмотров, но и подбирает для пользователей более разнообразный набор контента, отражающий различные вкусы.
CdXz5zHNQW_s7Y4CacbU5.png
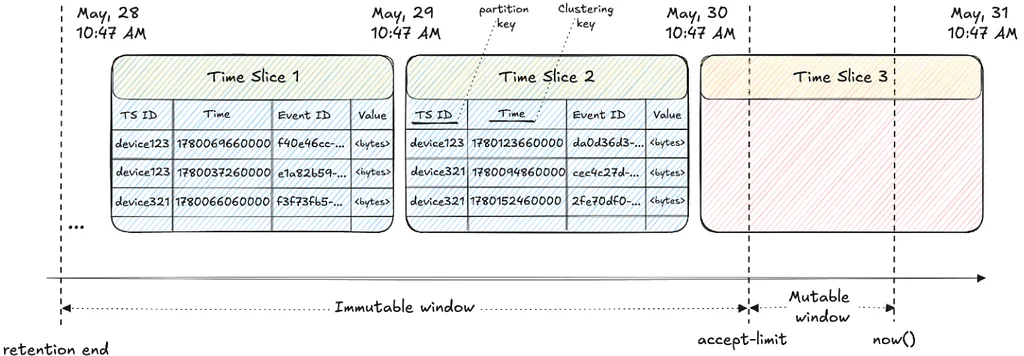
Платформа абстракции временных рядов Netflix, имеющая решающее значение для обработки петабайтных объемов временных данных, сталкивается со значительными проблемами стоимости хранения. Для решения этой проблемы были реализованы два решения для перемещения старых, менее используемых данных в более дешевое объектное хранилище при сохранении доступа с низкой задержкой. Первое решение использует Apache Kafka и Flink для потоковой передачи данных в S3, за которой следует ежедневная задача компактизации, объединяющая и оптимизирующая файлы Parquet. Этот процесс компактизации включает создание небольших групп строк, сортировку событий по времени и использование фильтров Блума для эффективного чтения. Затем компактизированные файлы регистрируются в управляющей плоскости, что позволяет усекать горячее хранилище. Чтения распределяются между горячим и холодным уровнями, причем холодный уровень использует метаданные компактизации для минимизации чтений из S3.Несмотря на успех, потоковая инфраструктура привела к усложнению и увеличению затрат. Это привело к разработке второго, более интегрированного решения, использующего резервные копии Cassandra. Этот подход направлен на чтение данных непосредственно из резервных копий S3 без отдельной передачи данных. Он представил новую стратегию компактизации Cassandra под названием ReadOnlyCompactionStrategy (ROCS) для неизменяемых временных срезов. ROCS выравнивает SSTable по диапазонам токенов, уменьшая разветвление чтений и улучшая задержку на всех уровнях.Cassandra создает резервные копии своих данных в S3, создавая манифесты, которые перечисляют пути к SSTable. Второе решение настраивает Cassandra для чтения непосредственно из этих резервных копий S3 для неизменяемых временных срезов. Оно использует подключаемые Memtable, в частности "backupmemtable", для перенаправления чтений. Этот резервный Memtable загружает необходимые файлы индексов и метаданных из S3 на узел. Надежные механизмы отказоустойчивости обеспечивают надежную загрузку и инициализацию компонентов. Как только локальные компоненты готовы, Cassandra обслуживает чтения из этих резервных копий, параллелизуя чтения из S3 и используя кэширование для дальнейшей оптимизации. Эта стратегия значительно снижает операционные расходы и затраты на инфраструктуру, устраняя отдельную потоковую инфраструктуру.
CdXz5zHNQW_qmkDWPsHdU.png
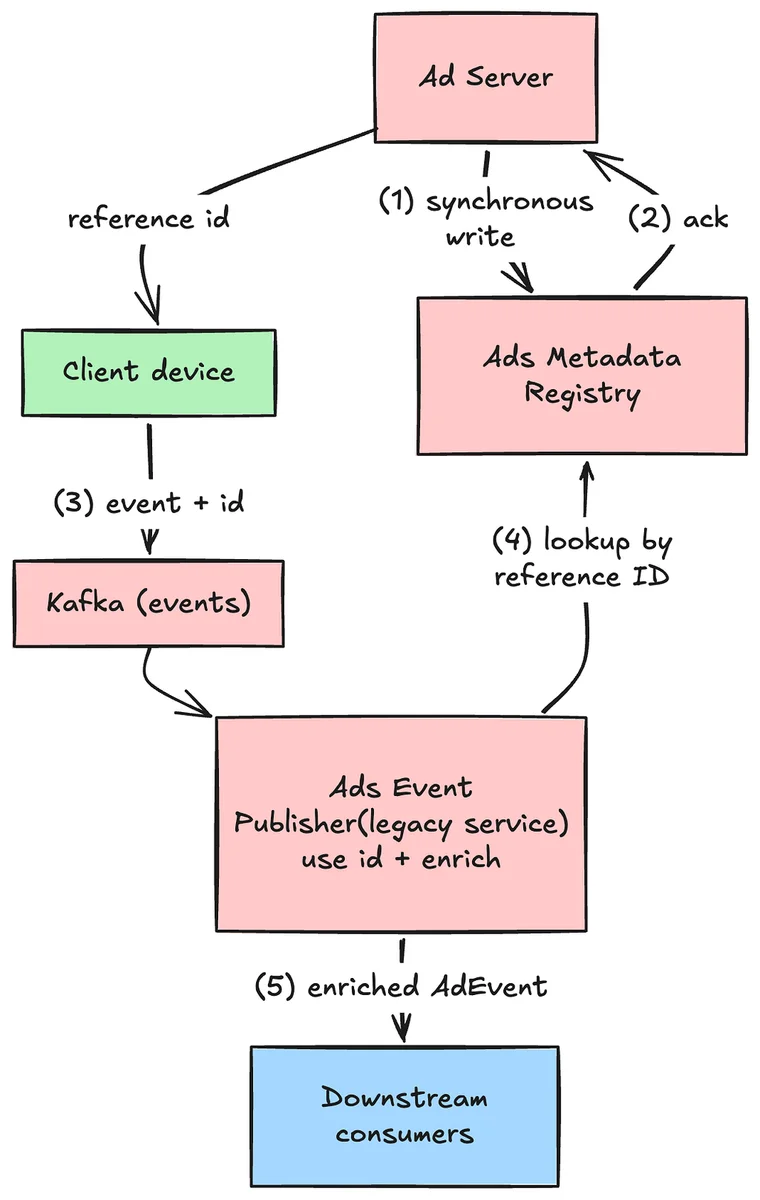
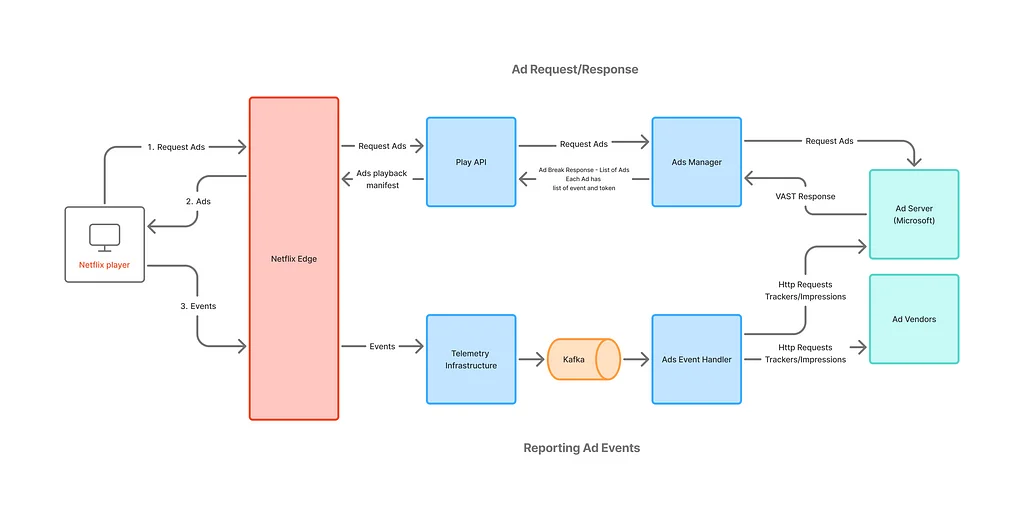
Netflix перестроила свой издатель событий рекламы для обработки возросшего масштаба и сложности, особенно для рекламы в прямом эфире. Предыдущая система полагалась на хранилище типа "ключ-значение" для обогащения рекламных метаданных. Этот подход, хотя и функциональный, создавал узкие места в масштабировании и критические зависимости, которые не подходили для прямых трансляций. Прямые трансляции генерируют огромный, пиковый трафик, требующий более надежного и эластичного решения.Новая архитектура использует Apache Flink, фреймворк для обработки потоков с сохранением состояния, для обогащения в режиме, близком к реальному времени. Логи ответов рекламного сервера отправляются в Kafka вместо базы данных. Затем Flink выполняет потоковое соединение в реальном времени между этими ответами и рекламными событиями, сгенерированными клиентом. Это исключает прямые записи в базу данных на критическом пути обслуживания, предотвращая сбои и повышая масштабируемость.Задание Flink нормализует события, направляет их в соответствующий регион обработки и, что важно, выполняет соединение с сохранением состояния. Оно хранит недавние ответы рекламного сервера в памяти и сопоставляет входящие клиентские события с ними в пределах настраиваемых окон, обычно 60 минут. Этот подход позволяет обогащать данные на месте, когда оба события доступны. Если событие приходит первым, оно удерживается до появления соответствующего ответа.Для обеспечения межрегионального обогащения система направляет клиентские события в регион, который обслуживал рекламу, вместо глобального реплицирования всех ответов обслуживания, что более экономично. Токен рекламы теперь включает информацию о регионе обслуживания. Хотя 60-минутное окно охватывает большинство событий, существует отдельный путь для восстановления поздно прибывших событий, обеспечивающий полноту данных для выставления счетов и отчетности. Эта архитектура обработки потоков с сохранением состояния обеспечивает необходимую масштабируемость и отказоустойчивость для меняющихся потребностей Netflix в рекламе.
CdXz5zHNQW_vv6mcOQtqA.png
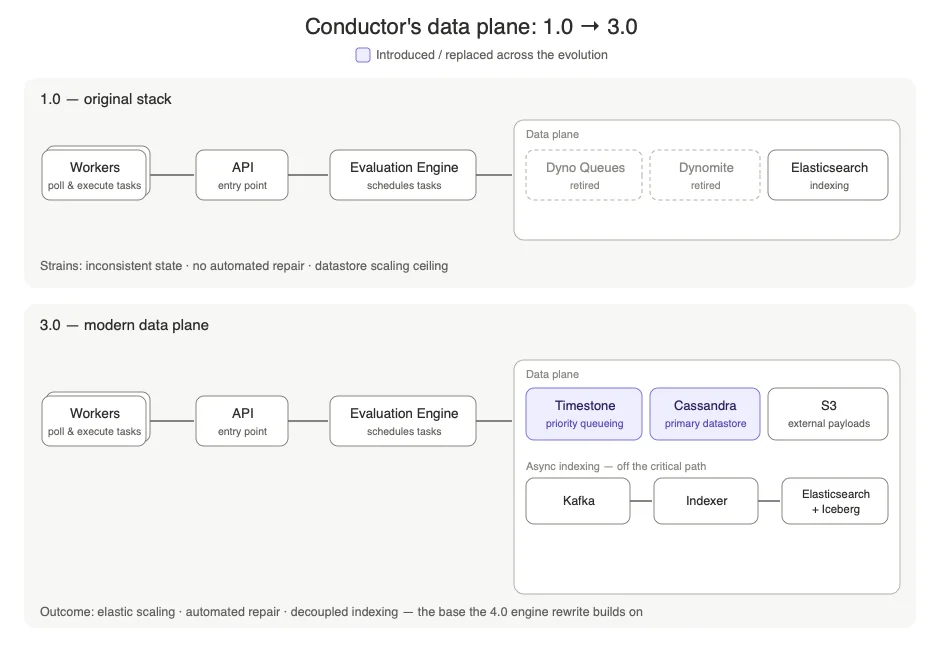
Netflix Conductor значительно эволюционировал с момента своего первого выпуска с открытым исходным кодом. Хотя поддержка версии с открытым исходным кодом прекратилась, внутренние разработки ускорились, что привело к полной перестройке. Масштабы Conductor резко возросли, обрабатывая миллиарды выполнений рабочих процессов ежегодно, что резко контрастирует с его более ранними достижениями. Этот рост потребовал модернизации почти каждого системного уровня, от плоскости данных до механизма оценки. Теперь Conductor поддерживает огромное количество определений рабочих процессов и является неотъемлемой частью различных бизнес-направлений Netflix, включая разработку контента и студий, рекламу и игры. Например, Media Production Suite полагается на Conductor для критически важных конвейеров приема и обработки медиаданных. Архитектурно Conductor перешел от стека на базе Dynomite к использованию Cassandra в качестве основного хранилища данных и Timestone для очередей, что значительно повысило масштабируемость и надежность. Введение Conductor 3.0 решило фундаментальные проблемы, а Conductor 4.0 перестроил основной механизм оценки. Эта перепись разделила данные для повышения эффективности использования памяти и производительности, а также ввела асинхронную модель оценки для устранения синхронных узких мест. В результате получился более надежный, масштабируемый и производительный механизм оркестровки рабочих процессов, способный удовлетворить огромные операционные потребности Netflix.
CdXz5zHNQW_fpGlfFLsWS.png
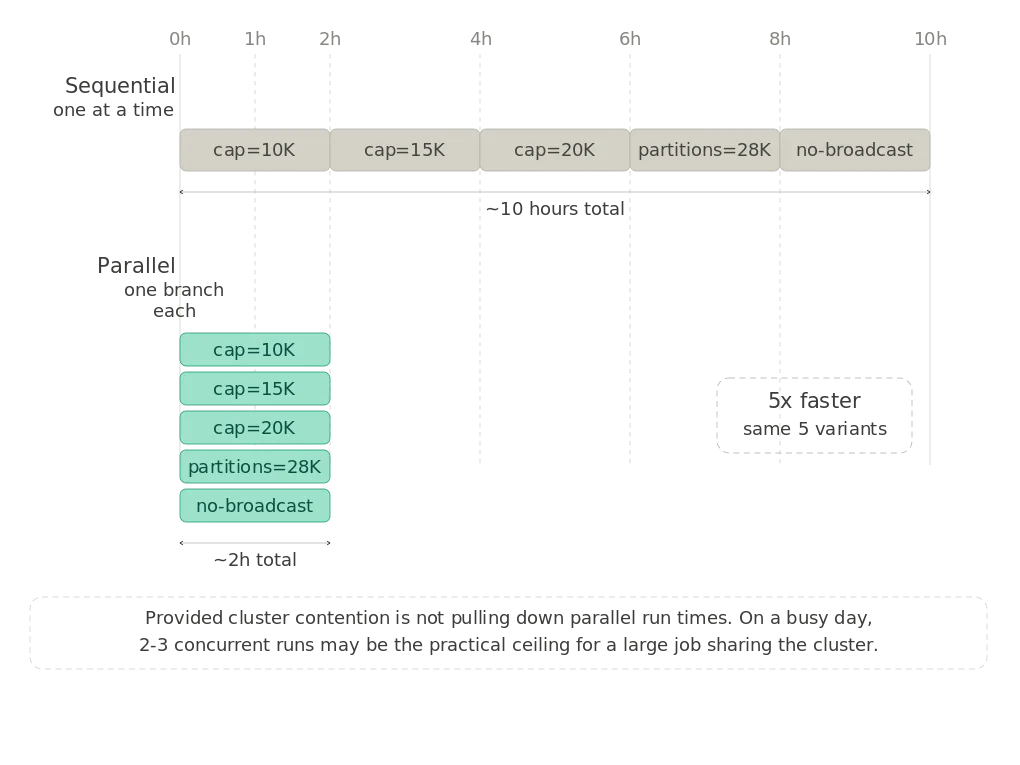
"member-sessionizer" от Netflix, критически важный конвейер данных, обрабатывает миллиарды событий для создания пользовательских сессий просмотра. Стандартные подходы к отладке оказались неэффективными в производственном масштабе Netflix, поскольку такие проблемы, как ошибки нехватки памяти (Out-Of-Memory), проявлялись только на больших, невыборочных наборах данных из-за перекоса данных. Прорывом автора стало смещение фокуса с ускорения одиночных запусков на возможность проведения множества одновременных экспериментов. Это было достигнуто за счет использования ветвления разработки Dataflow для изоляции каждого тестового варианта.Параметризовав планировщик и назначив каждому эксперименту свою ветку и выходную таблицу, можно было одновременно запускать несколько тестов. Это резко сократило общее время выполнения с часов на тест до продолжительности самого длительного одиночного задания. Был использован ИИ-агент для управления операционной сложностью запуска множества параллельных экспериментов, автоматизируя обновление конфигурации, запуск заданий и опрос метрик. Это освободило автора от утомительных ручных проверок, позволив немедленно сравнивать результаты.Постоянные сессии tmux в облачной среде разработки Netflix оказались решающими для предотвращения прерывания многочасовых заданий Spark из-за сбоев сети или закрытия ноутбука. Основными узкими местами производительности были определены оператор collect_list, буферизующий целые пакеты событий в памяти, и неэффективные структуры данных. В частности, изменение идентификаторов сессий на строки UUID и использование Scala Options для полей значительно увеличили потребление памяти. Кроме того, раздутые строковые атрибуты добавляли ненужный вес каждому событию.Исправления включали распаковку примитивных полей из Options и уменьшение пакетов событий путем удаления неиспользуемых атрибутов. Метаданные, не зависящие от сессии, были вынесены в заголовок сессии. Два контринтуитивных вывода подчеркнули сложность управления памятью Spark: сужение строк могло привести к более быстрым OOM, вынуждая использовать широковещательные соединения (broadcast joins), а Adaptive Query Execution (AQE) молчаливо накапливал большие объемы данных в памяти через широковещательные хэш-соединения. Настройка порога широковещания AQE решила эту проблему.Дисциплинированная система журналирования отслеживала каждый эксперимент, его конфигурацию и ключевые метрики, создавая единый источник истины и заставляя вносить изолированные изменения переменных. Была допущена ошибка при тестировании исправления ограничения сессии перед стадией Spark Window, которая буферизовала память перед усечением. Окончательное исправленное исправление переместило усечение вверх по конвейеру, чтобы предотвратить раздувание памяти. Хотя эти усилия по настройке решили непосредственные проблемы, фундаментальная форма данных агрегирования целых сессий в отдельные строки представляет собой будущую проблему масштабирования.
CdXz5zHNQW_imDTAsvHQS.png
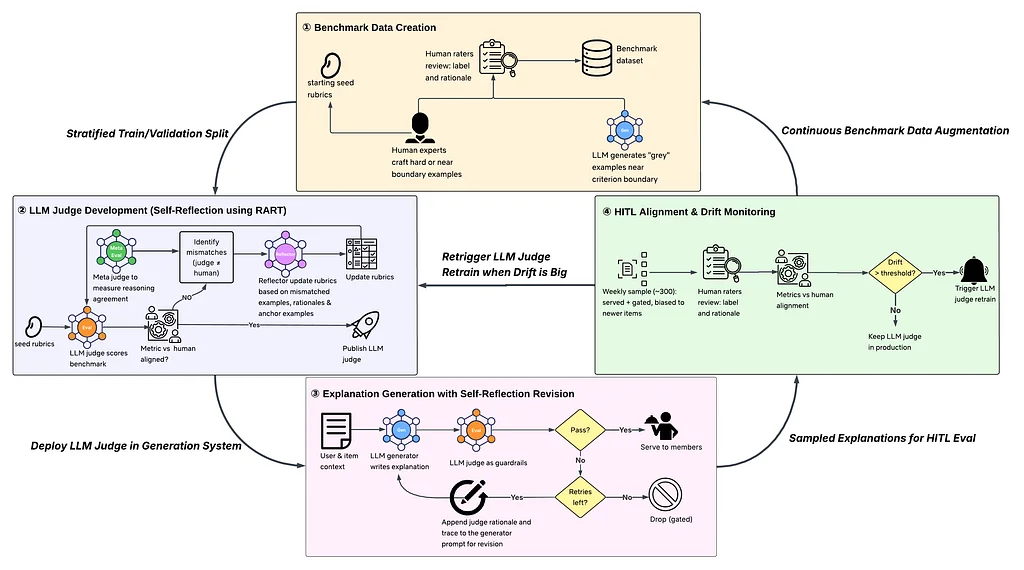
Масштабная генерация текста с помощью больших языковых моделей (LLM) требует автоматизированной оценки из-за ограничений ручной проверки. Подход "LLM как судья" использует вторую LLM для оценки вывода основной LLM, но вызывает опасения относительно надежности оценщика. Эта проблема решается путем создания, согласования и постоянного мониторинга LLM-судей, гарантируя, что они остаются привязанными к человеческим суждениям на каждом этапе. Люди определяют стандарты качества, создают размеченные наборы данных, отслеживают поведение судей и утверждают обновления.Надежный LLM-судья не статичен; он имеет жизненный цикл, включающий человеческое участие в его создании, согласовании, эксплуатации и обслуживании. Этот процесс иллюстрируется на примере генерации объяснений рекомендаций, которые представляют собой короткие сообщения, объясняющие рекомендации товаров. Качество имеет решающее значение, поскольку вводящие в заблуждение объяснения подрывают доверие пользователей.Жизненный цикл LLM-судьи состоит из четырех фаз: Рождение, Обучение, Развертывание и Согласование с участием человека и мониторинг дрейфа. Рождение включает в себя создание экспертами эталонных данных, включая состязательные и граничные примеры, которые затем размечаются людьми-оценщиками. Обучение дорабатывает LLM-судью для согласования с человеческими метками и обоснованиями, используя саморефлексию и обновления рубрик. Развертывание интегрирует судью в качестве контролера и критика в системе генерации объяснений.Согласование с участием человека и мониторинг дрейфа обеспечивают постоянную надежность путем периодического сравнения судьи с людьми-оценщиками и требования одобрения человеком любых изменений в системе. Эта фаза использует Мета-Судью для сравнения обоснований LLM-судьи с человеческими обоснованиями, выявляя случаи, когда судья приходит к правильному ответу по неправильной причине. Этот непрерывный цикл обратной связи, включающий новые размеченные человеком данные и сигналы, возвращается к этапам бенчмаркинга и разработки. Компоненты системы включают Генератор, Судью, Рефлектор, Мета-Судью, а также экспертов и оценщиков-людей, которые совместно работают на всех этапах жизненного цикла для поддержания целостности судьи.
CdXz5zHNQW_pa8iRRxAOL.png
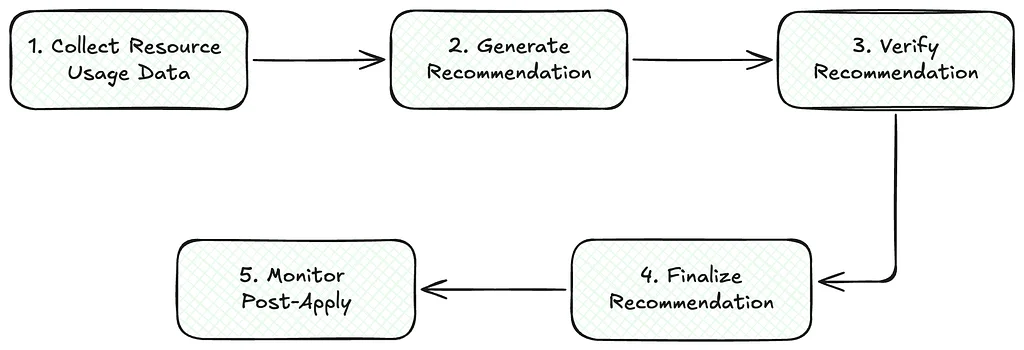
Stratum — это внутренняя бессерверная платформа обработки медиа от Netflix, имеющая решающее значение для обработки различных медиа-задач, таких как кодирование и упаковка. Инженеры определяют функции Stratum как OCI-образы, которые затем планируются как пакетные задания на вычислительной платформе Titus. Управляя сотнями тысяч контейнеров, Stratum нуждается в динамическом масштабировании для новых форматов контента, таких как подкасты и прямые трансляции. Запросы на ресурсы, указанные в YAML, часто избыточно выделяются из-за меняющейся инфраструктуры и изменений в приложениях, что приводит к неэффективности и увеличению операционных расходов.Для решения этой проблемы Netflix разработал Stratum Resource Tuner (SRT) — автоматизированную систему, предназначенную для правильного определения размеров ресурсов контейнеров в производственной среде. SRT нацелен на устранение ручной настройки ресурсов, первоначально фокусируясь на рабочих нагрузках с высокой пропускной способностью и нестрогими требованиями к задержке, которые составляют 70-80% использования ресурсов. Владельцы функций могут выбрать автоматическое определение оптимальных размеров для каждого типа ресурсов (ЦП, память, диск, сеть).Рабочий процесс SRT состоит из пяти этапов: сбор метрик использования ресурсов, генерация рекомендаций, проверка рекомендаций посредством экспериментов, применение или отклонение рекомендаций и мониторинг метрик после применения. Рекомендации проходят через состояния: CREATED (создано), EVALUATING (оценивается), APPLIED (применено), REJECTED (отклонено) и MONITORED (под наблюдением). Например, избыточно выделенная память и ЦП для функции VideoEncoder.encodeV1 были успешно оптимизированы.Сбор метрик надежен: сводки по выполнению хранятся в Elasticsearch для краткосрочного поиска, а необработанные метрики использования с высоким разрешением — в таблицах Iceberg для долгосрочного анализа тенденций. Ежедневно запускается рабочий процесс Conductor, который использует данные Iceberg за месяц для генерации рекомендаций для всех функций и типов ресурсов. Этот процесс включает фильтрацию рабочих нагрузок с высокой пропускной способностью, агрессивную настройку ЦП и сети (использование p99) и консервативную настройку памяти и диска (использование p99.9 с буфером безопасности).Предусмотрены меры предосторожности, такие как отбрасывание рекомендаций, если сокращение слишком мало, и ограничение максимального сокращения памяти и диска до 15% за цикл. Рекомендации создаются в состоянии CREATED и становятся неизменяемыми после продвижения за этот этап. Пример показывает, как рекомендации по ЦП сокращаются с 8 до 4, а по памяти — с 18000 МБ до 15300 МБ за один шаг, что иллюстрирует практическое применение SRT в оптимизации затрат.
CdXz5zHNQW_2pPMwVXJcD.png
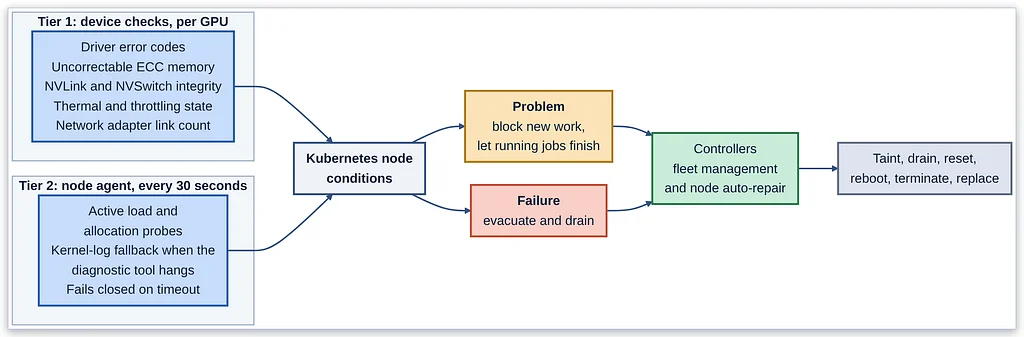
Netflix в значительной степени полагается на графические процессоры (GPU) для персонализированных рекомендаций контента и других приложений машинного обучения. Эти GPU имеют решающее значение для обучения и предоставления контента, что делает их надежность императивом для бизнеса как с точки зрения доступности, так и с точки зрения экономической эффективности. Базовые проверки работоспособности облачных провайдеров недостаточны, поскольку они не обнаруживают тонкие сбои GPU или сетевой фабрики, которые могут парализовать длительные задания обучения. Такие сбои могут проявляться в виде медленной производительности или полного прекращения работы задания, что влияет на пользовательский опыт и приводит к пустой трате ресурсов.Netflix использует многоуровневый подход для обеспечения работоспособности инфраструктуры GPU. Первый уровень фокусируется на обнаружении и устранении сбоев оборудования, такого как GPU и сетевые адаптеры. Второй уровень включает планировщик и платформу, которые повторно запускают задачи и проверяют машины перед их использованием. Третий уровень позволяет длительным заданиям переживать потерю машины благодаря контрольным точкам и эластичным рабочим процессам. Четвертый уровень — это наблюдаемость, которая отслеживает эффективность трех других уровней.Проверки работоспособности работают на двух уровнях: проверки на уровне устройств для отдельных GPU и проверки на уровне узлов, выполняемые агентом. Эти проверки сообщают результаты в виде условий узла Kubernetes. При обнаружении проблемы состояние машины обновляется, и контроллеры принимают меры. Первоначальные проблемы терпятся, но постоянные сбои приводят к эвакуации машины, ее очистке и замене.Устранение неисправностей градационное, действия соответствуют степени серьезности неисправности, от перезапуска одного GPU до завершения работы и замены всей машины. Для постоянно сбоящего оборудования записываются неизменяемые идентификаторы, чтобы предотвратить его повторное включение в пул. Машины проверяются перед выпуском на работу, чтобы убедиться, что они прошли все диагностические тесты. Наконец, длительные задания делаются устойчивыми благодаря контрольным точкам, что позволяет им возобновляться с последнего стабильного состояния в случае потери машины.
CdXz5zHNQW_gLdQGMuM0X.png
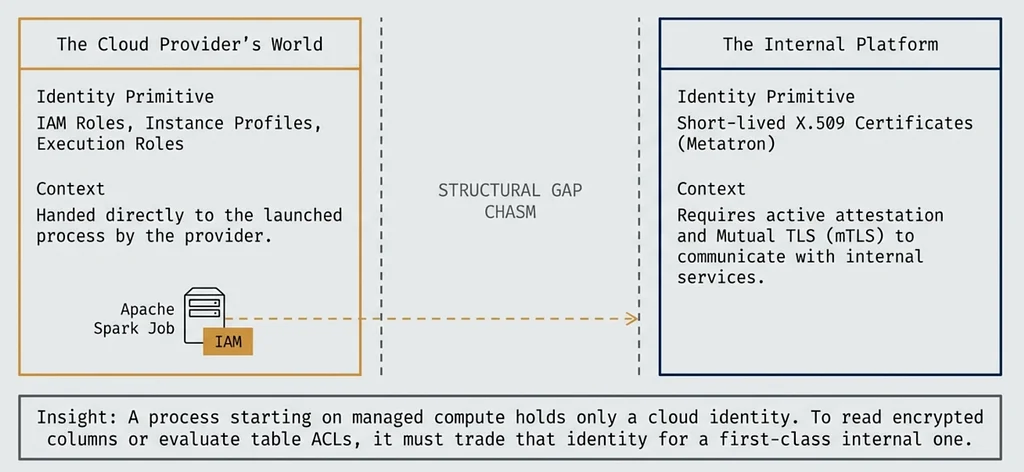
Организации часто поддерживают две параллельные системы идентификации: одну от облачных провайдеров, таких как AWS, и другую для внутренних сервисов. В этой статье подробно рассказывается, как рабочие нагрузки Apache Spark на Amazon EMR устраняют этот разрыв, позволяя им получить первоклассную внутреннюю идентификацию из исходной облачной идентификации. Netflix использует частную PKI под названием Metatron для аутентификации между сервисами через взаимный TLS, что требует процесса аттестации для проверки идентификаторов рабочих нагрузок. Они также используют концепцию "Проект данных", который владеет данными и имеет свою собственную идентификацию, обеспечивая согласованность в управлении доступом и аудите.Основная задача заключается в преобразовании облачной роли выполнения AWS в необходимую внутреннюю идентификацию для заданий Spark на управляемых вычислительных ресурсах. Это решение устанавливает прямое соответствие один к одному между каждым идентификатором Проекта данных и выделенной ролью IAM, при этом сервис Проекта данных выступает в качестве авторитета для этого соответствия. Это соответствие имеет решающее значение для преобразования утверждений из лексикона облачного провайдера в лексикон организации. Для решения проблемы масштабируемости управления многочисленными ролями IAM эти роли детерминированно шардируются по небольшому пулу выделенных учетных записей AWS.В процессе задействованы пять компонентов: плоскость управления (запускает задания и подписывает метаданные), сервис Проекта данных (управляет соответствием идентификатор-роль), сервис идентификации (проверяет аттестации и выдает сертификаты), плагин Spark (интегрируется в загрузку процесса) и AWS STS (действует как нотариус). Процесс начинается с того, что плоскость управления подписывает пакет метаданных, содержащий сведения о рабочей нагрузке. Затем плагин драйвера Spark использует учетные данные AWS для создания предварительно подписанного URL-адреса из AWS STS, доказывая владение облачной идентификацией.Затем сервис идентификации подтверждает эти два независимых утверждения: роль, идентифицированную AWS по предварительно подписанному URL-адресу, и подписанные метаданные от плоскости управления. Если они совпадают, для рабочей нагрузки выдаются сертификаты. Это подтверждение имеет жизненно важное значение, поскольку ни одно из утверждений само по себе недостаточно; утверждение провайдера является подделываемым, но недостаточно детализированным, в то время как утверждение плоскости управления хорошо детализировано, но потенциально может быть воспроизведено. Система решает проблему распараллеливания для исполнителей, позволяя драйверу аттестоваться один раз и безопасно распределять учетные данные. Сертификаты имеют короткий срок действия и обновляются посредством повторяемого процесса аттестации внутри JVM драйвера. Модель доверия гарантирует, что ни один участник не сможет выдать идентификацию независимо, и рабочая нагрузка сама никогда не требуется для подтверждения своей легитимности.
CdXz5zHNQW_E3OfGUk31B.png
Новый предварительный просмотр ja и его составных инструментов командной строки призван модернизировать разработку на Java. Эти инструменты используют систему модулей Java для упрощения создания и использования модулей. Дескриптор модуля расширен для полного описания проекта, включая версии зависимостей и метаданные. Такие инструменты, как jig, обрабатывают разрешение модулей, компиляцию и сборку, выступая в качестве моста к репозиториям Maven. jfmt обеспечивает соблюдение соглашений о форматировании кода для более чистого кода Java. jist предлагает поиск символов с учетом исходного кода для более легкой навигации по коду. jdocserver обеспечивает локальный просмотр документации API. Эти инструменты интегрируются с возможностями обнаружения и выполнения инструментов JDK. Они обеспечивают плавный переход к стандартным инструментам JDK, таким как jdeps и jlink. Система решает проблемы с существующими артефактами Maven, выводя координаты модулей и устанавливая канонические координаты. Целостность по умолчанию обеспечивается путем разрешения явного объявления и авторизации требований к доступу во время выполнения, предотвращая несанкционированные мутации. Это обеспечивает большую безопасность и контроль над взаимодействием модулей.
CdXz5zHNQW_eFUEHFgz6j.png
Netflix стремится предоставлять участникам контент, который им понравится, с помощью персонализированных визуальных материалов, таких как обложки и видеопревью. Значительная проблема возникает с новыми названиями, где недостаток данных о взаимодействии препятствует эффективной персонализации, что известно как проблема холодного старта. Традиционно модели рассматривали материалы как непрозрачные идентификаторы, полагаясь на эвристику популярности до накопления достаточного количества данных. Это означало, что персонализация для нового контента задерживалась, влияя на опыт обнаружения.Решение Netflix заключается в использовании мультимодальных вложений, позволяющих моделям "видеть" и "слышать" материалы. Кодируя обложки с помощью CLIP, предварительно обученной модели изображения-текста, материалы приобретают визуальное понимание. Это вложение CLIP объединяется с вложением идентификатора материала, создавая более богатое представление, которое улавливает визуальные темы и таланты. Это позволяет персонализировать контент на основе предпочтений участников в отношении визуальных стилей, еще до того, как у материала появится история взаимодействий, способствуя передаче знаний между названиями.Этот подход также позволяет консолидировать модели, объединяя отдельные модели для разных холстов обложек в одну унифицированную модель. Поскольку вложения CLIP в значительной степени инвариантны к обрезке и изменению размера, почти идентичные рендеринги обложек отображаются в схожие векторы. Это объединение сигналов взаимодействия по холстам, особенно выгодное для холстов с малым количеством данных, позволяет одной модели персонализировать все размещения обложек. Для решения проблемы дисбаланса данных по холстам используется взвешивание на основе вознаграждения, при котором взаимодействия приоритизируются на основе их долгосрочной ценности, а не объема показов.Эффективность этого подхода была подтверждена в ходе офлайн-оценок с использованием обратного взвешивания по вероятности и крупномасштабных A/B-тестов. Объединение вложений изображений с унифицированной моделью (V3) значительно превзошло модели, имеющие только одно из этих улучшений. Этот комбинированный подход оказался решающим во время крупного редизайна домашней страницы Netflix, где был представлен доминирующий холст с минимальными историческими данными. Унифицированная модель с вложениями CLIP успешно персонализировала контент для этого нового макета, показав статистически значимые улучшения в метриках обнаружения и часах просмотра, подчеркнув силу мультимодальных вложений для преодоления проблемы холодного старта.
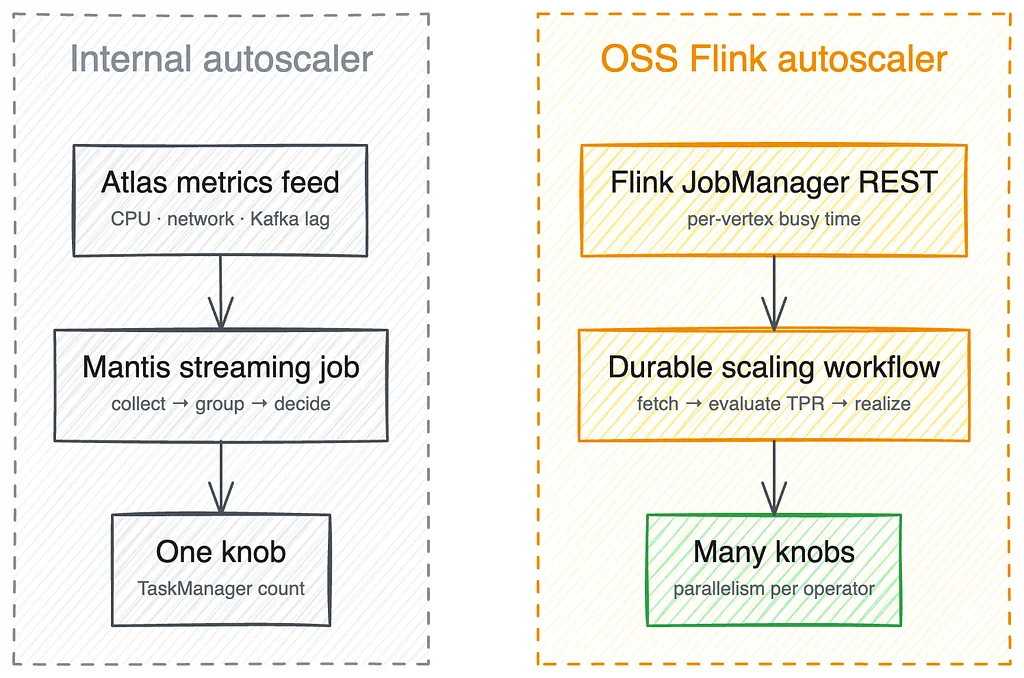
Netflix в настоящее время использует два автоскейлера Flink, стремясь перейти к одному решению с открытым исходным кодом. Изначально они разработали собственный автоскейлер для управления тысячами заданий Flink, который оказался эффективным, но имел ограничения в обработке сложных заданий с несколькими операторами. Эта самодельная система полагалась на внешние метрики, которые могли быть неточными или упускать внутренние проблемы заданий. Позже сообщество Apache Flink разработало более совершенный автоскейлер, который анализирует данные непосредственно из самого задания. Этот второй автоскейлер оценивает фактическую скорость обработки оператора для определения оптимальной параллельности на вершину. Netflix склоняется к этому решению с открытым исходным кодом из-за его способности масштабировать задания с состоянием и обеспечивать гранулированную настройку. Внедрение автоскейлера OSS в Netflix потребовало значительной адаптации, включая интеграцию его в существующую плоскость управления. Они также внесли изменения в среду выполнения Flink для лучшего сбора метрик и обработки специфических структур заданий, таких как графы с прямыми связями и ограничения приемников. Приняв автоскейлер OSS, Netflix добился существенной экономии средств и улучшил использование ресурсов. Извлеченные уроки подчеркивают, что качество метрик имеет решающее значение, настраиваемые значения по умолчанию полезны, а принятие существующих решений перед их расширением является мудрой стратегией. Они планируют полностью перейти на автоскейлер на базе OSS для оптимизации операций.
CdXz5zHNQW_HJCpS7bDND.png
Netflix создала распределенный граф в реальном времени для предоставления аналитики в реальном времени своим внутренним партнерам, а третья часть этой серии статей посвящена эффективному запросу к графу. Граф представляет собой сложную сеть из миллиардов узлов и ребер, и для запроса к нему требуется быстрый и гибкий слой обслуживания. Авторы обсуждают проблемы запроса к графу, включая обработку широкого спектра шаблонов доступа и поддержку как "мелких-широких", так и "глубоких-узких" запросов. Они объясняют, как спроектировали слой обслуживания для эффективного запроса к графу, используя обход в ширину и асинхронную композицию для минимизации задержки. Авторы также обсуждают важность кэширования, опциональных обогащений и конечной согласованности при проектировании слоя запросов. Слой запросов состоит из трех уровней: Сервис запросов к графу, Слой абстракции хранения и Слой обогащения, которые работают вместе для эффективного выполнения запросов. Авторы подробно рассматривают пример запроса, чтобы продемонстрировать, как слой запросов работает на практике, подчеркивая важность чтения и интерпретации запроса, эффективного чтения из хранилища, выполнения обхода с уровнями обхода в ширину, параллельного выполнения многих операций, умной фильтрации и ускорения повторных запросов с помощью кэширования. Цель слоя запросов — завершать запросы менее чем за 100 мс, и авторы демонстрируют, как их дизайн достигает этой цели. Слой запросов разработан для обработки десятков тысяч запросов в секунду, каждый из которых потенциально отличается, и авторы обсуждают компромиссы, на которые они пошли при проектировании слоя запросов для достижения такого уровня производительности. В целом, авторы предоставляют подробный обзор проектирования и реализации слоя запросов, подчеркивая проблемы и компромиссы, связанные с созданием высокопроизводительного слоя запросов для крупномасштабного распределенного графа. Слой запросов является критически важным компонентом распределенного графа в реальном времени, а дизайн и реализация авторов позволили Netflix предоставлять аналитику в реальном времени своим внутренним партнерам.
CdXz5zHNQW_1lL53FS8TQ.png
Netflix предлагает широкий спектр функций и типов контента на различных устройствах, но аппаратные ограничения могут ограничивать определенные функции на конкретных устройствах. Для решения этой проблемы компания разработала комплексную модель данных о возможностях устройств, чтобы понимать их и обеспечивать наилучший пользовательский опыт. Модель данных интегрирует флаги функций из внутренних систем, что позволяет более эффективно управлять функциями в глобальном ландшафте устройств. Для хранения информации о возможностях устройств, таких как разрешение экрана, видеопрофили и объем оперативной памяти, используется накопительная таблица, что делает ее идеальной для аналитики и отчетности. Таблица структурирована таким образом, чтобы фиксировать последнее состояние каждого устройства и связанные с ним возможности, обеспечивая эффективную обработку информации. Для агрегированной аналитики используется гистограммная таблица для подсчета активных устройств за последние 28 дней, с разбивкой по моделям устройств и версиям программного обеспечения. Эта таблица также записывает количество устройств, поддерживающих определенные возможности, что позволяет проводить детальный анализ распределения. Данные гистограммы могут использоваться для анализа распределения возможностей внешних дисплеев, таких как процент устройств, поддерживающих профили HD или UHD. Используя эти наборы данных, Netflix создала аналитические продукты для предоставления полного обзора охвата функций, включая 4K Ultra HD, Netflix Spatial Audio и Cloud Gaming. Компания использует аналитические данные, основанные на данных, для принятия обоснованных решений о том, какие функции включать на конкретных устройствах, обеспечивая как производительность, так и надежность.
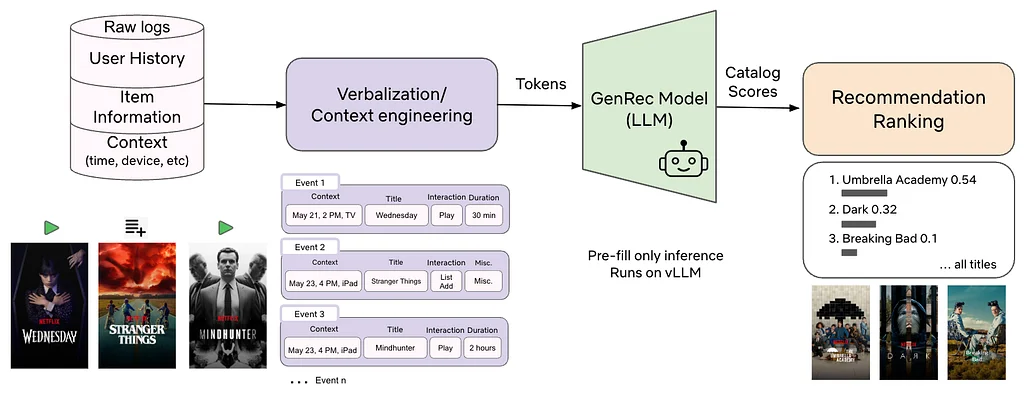
Рекомендации — важнейшая часть работы Netflix, и компания использовала сложные производственные модели, основанные на тысячах вручную созданных функций и специализированных архитектур. Однако эти модели дороги в обслуживании и обновлении, и компания ищет более эффективные решения. Большие языковые модели показали многообещающие результаты в этой области, но они еще не готовы к производству и часто имеют ограничения, такие как чрезмерное рекомендование популярного контента и игнорирование бизнес-ограничений. Для решения этой проблемы Netflix создал GenRec, систему ранжирования рекомендаций на основе LLM, которая дообучает внутреннюю базовую LLM на данных и целях, специфичных для Netflix. GenRec вербализует историю пользователя, метаданные элементов и контекст в виде текста и использует головку оценки, осведомленную о каталоге, для ранжирования элементов. Модель обучается с использованием многоцелевой функции потерь, которая объединяет сигналы ранжирования, языка и вознаграждения для соответствия бизнес-целям и долгосрочному удовлетворению участников. GenRec продемонстрировал статистически значимые улучшения как в краткосрочных, так и в долгосрочных онлайн-метриках по сравнению с хорошо настроенным производственным ранжировщиком, используя при этом лишь небольшую часть размеченных данных и входных сигналов. Модель обслуживается на внутреннем стеке LLM Netflix с использованием vLLM, и компания внедрила стратегии для контроля затрат на обслуживание, такие как использование меньших моделей, агрессивное сжатие контекста и вывод только предварительного заполнения. В целом, GenRec представляет собой значительный шаг к более LLM-центричному будущему рекомендаций в Netflix, и его успех может трансформировать подход компании к рекомендациям и персонализации. Способность модели обучаться на входах на естественном языке и генерировать персонализированные ранжирования может улучшить пользовательский опыт и повысить вовлеченность. Используя мощь больших языковых моделей, Netflix может создавать более эффективные и действенные системы рекомендаций, которые способствуют успеху бизнеса.
CdXz5zHNQW_VHtw7eOaqU.png
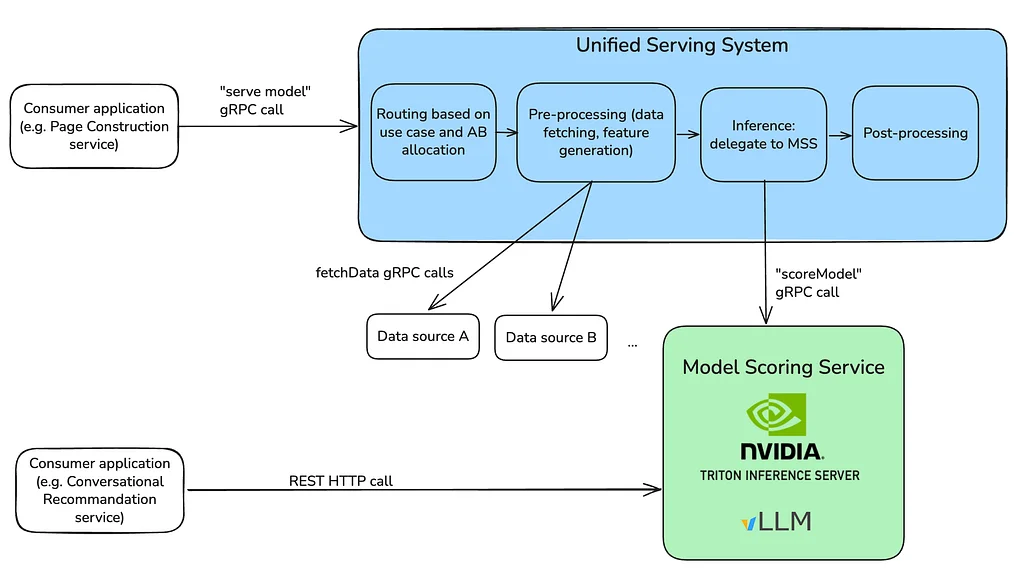
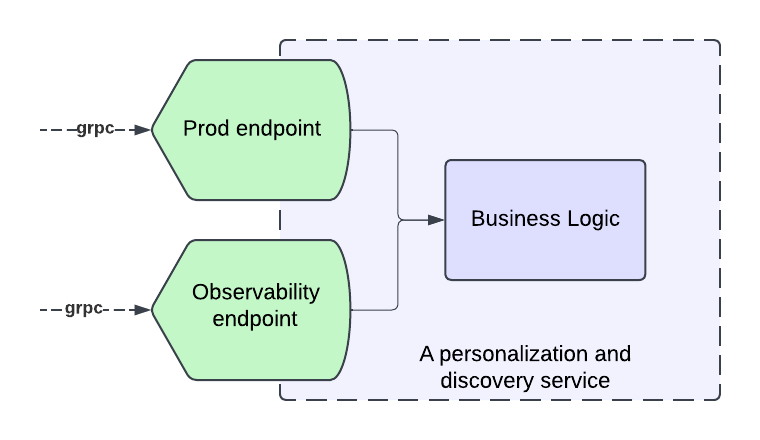
Netflix самостоятельно управляет всем стеком больших языковых моделей, осуществляя развертывание и инференс напрямую. Они интегрировали это в существующую производственную среду, а не в отдельный "силос" машинного обучения. Этот подход включал тщательный выбор движка инференса, решение о том, как будут упаковываться модели, проектирование интерфейса API, определение стратегий развертывания и обеспечение ограничений на вывод.Выбранный движок инференса — vLLM, отобранный за его операционную пригодность, способность загружать пользовательские архитектуры, расширяемость, отлаживаемость и знакомство среди специалистов. Модели упаковываются с использованием бэкенда vLLM в Triton для обеспечения динамической спецификации входных/выходных тензоров, способствуя независимому развитию моделей и фронтендов. Наряду с существующим gRPC-интерфейсом был добавлен HTTP-фронтенд, совместимый с OpenAI, для более широкой совместимости с экосистемой.Для развертывания Netflix использует стратегию версионирования для обработки потенциальных изменений схемы между версиями моделей, позволяя потребителям обновляться независимо. Когда интерфейсы моделей стабильны, применяется менее затратная стратегия развертывания "красное-черное". Одной из ключевых операционных проблем было медленное время запуска моделей, которое они решили путем материализации больших моделей на Amazon FSx для более быстрого доступа.Наблюдаемость была улучшена путем создания унифицированной конечной точки /metrics, которая агрегирует данные как из vLLM, так и из Triton. Важной функцией является масштабируемое ограниченное декодирование, реализованное с помощью пользовательского процессора логитов vLLM. Это позволяет моделям напрямую генерировать соответствующие требованиям выходные данные, избегая коррекции после инференса.Первоначальная реализация ограниченного декодирования на чистом Python столкнулась с проблемами масштабирования из-за Global Interpreter Lock (GIL) и последовательной обработки на ЦП. Это стало очевидным только при высокой конкуренции, что привело к значительным задержкам в хвосте. Система полагается на Java-площадку управления для управления развертыванием, версионированием и автоматическим масштабированием. Система обслуживания поддерживает как пути инференса в пакетном режиме в реальном времени, так и с кэшированием. Эта унифицированная система обрабатывает полный поток потребителей, включая маршрутизацию, генерацию кандидатов и логирование.
CdXz5zHNQW_CmjJjU7Bih.png
Netflix разработала карту зависимостей сервисов в реальном времени, чтобы помочь инженерам в устранении неполадок и понимании их распределенной архитектуры. Система объединяет сетевые потоки eBPF, метрики IPC и распределенное трассирование в независимые слои графа. Хотя первоначальная версия работала локально, в производственной среде выявились значительные проблемы с масштабированием, включая отставание потребителей Kafka и проблемы с памятью.Основным архитектурным решением стал подход, ориентированный на потоковую передачу, обеспечивающий обновления топологии практически в реальном времени вместо ежечасной пакетной обработки. Это было критически важно для реагирования на инциденты и мониторинга событий в реальном времени. Для обработки миллионов записей потоков в секунду без потери данных система использует реактивные потоки с обратным давлением, сигнализируя вышестоящим компонентам замедлиться, когда нижестоящие системы перегружены. Это обеспечивает плавное снижение производительности, а не сбои или потерю данных.Архитектура использует многослойную конструкцию с физической изоляцией хранилища для сетевых, IPC и трассировочных слоев, что позволяет проводить независимую оптимизацию. Прием данных в сетевом слое основан на трехэтапном распределенном конвейере агрегации. Этап 1 выполняет первоначальную агрегацию из Kafka, Этап 2 разрешает сетевые посредники (такие как балансировщики нагрузки) в прямые зависимости на уровне приложений, а Этап 3 выполняет окончательную агрегацию, обогащение внешними данными и сохранение в графовой базе данных.Трехэтапный конвейер стал критическим развитием по сравнению с первоначальной двухэтапной конструкцией, которая страдала от "горячих узлов" из-за концентрации данных во время разрешения посредников и обогащения. Разделение этих обязанностей между тремя этапами распределяет рабочую нагрузку, предотвращая узкие места. Server-Sent Events (SSE) заменили gRPC для межэтапной связи из-за накладных расходов на производительность gRPC, которые потребляли чрезмерное количество ЦП и памяти в масштабе.
CdXz5zHNQW_FXxC4JJL7E.png
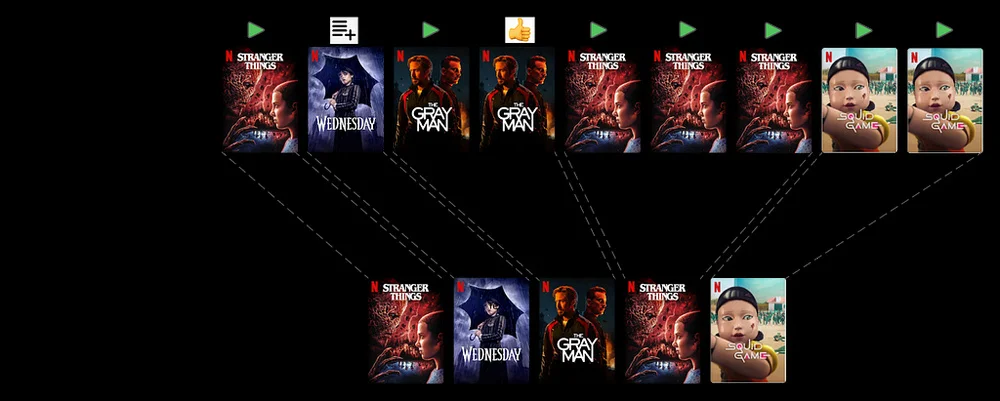
Главная страница Netflix представляет собой высокоперсонализированный и структурированный интерфейс для поиска контента. Традиционно ее генерация включала сложный многоэтапный конвейер. GenPage, новый подход, использует единую генеративную трансформерную модель для авторегрессивного построения всей главной страницы. Эта сквозная модель принимает контекст пользователя в качестве подсказки и одновременно генерирует строки, сущности и макет. Основные цели включают упрощение стека рекомендаций, обеспечение оптимизации всей страницы с помощью обучения с подкреплением, а также повышение масштабируемости и гибкости. Производственные проблемы включали задержку обслуживания в реальном времени, проблему холодного старта сущностей и поддержание актуальности модели. GenPage продемонстрировал значительные улучшения во вовлеченности пользователей и сокращении задержки обслуживания в A/B-тестах. Данные токенизируются на токены контекста, представляющие информацию о пользователе, и токены страницы для структуры главной страницы. Доменно-специфичная токенизация повышает вычислительную эффективность и контроль над продуктом по сравнению с общей текстовой токенизацией. История пользователя, профиль и контекст запроса формируют подсказку, в то время как сущности и строки представлены в виде токенов в сгенерированной странице. Система использует систему вознаграждений, основанную на обратной связи с пользователем, для количественной оценки ценности рекомендаций и управления обучением. GenPage использует стандартную архитектуру трансформера только с декодером и следует рецепту обучения, похожему на LLM, включающему предварительное обучение и последующее обучение. Предварительное обучение использует предсказание следующего токена, чтобы научить модель языку главной страницы, за которым следует последующее обучение с взвешенной бинарной классификацией или обучением с подкреплением. Этот генеративный подход предлагает более интегрированный и прямой путь к оптимизации всего пользовательского опыта на главной странице Netflix.
CdXz5zHNQW_XlipK7GYZj.gif
Исследователи Netflix разработали два инструмента на базе искусственного интеллекта для помощи видеоредакторам в создании рекламных материалов. Первый инструмент, Vera, представляет собой многослойную диффузионную модель для видео, предназначенную для редактирования с сохранением контента. Vera генерирует правки в виде отдельных слоев, оставляя нетронутыми части оригинального видеоряда, тем самым сохраняя идентичность и детали. Для обучения Vera был создан специализированный набор данных и использована архитектура Mixture-of-Transformers для эффективной генерации выходных данных. Оценки показали, что Vera значительно превосходит существующие методы в сохранении контента при сопоставимом качестве видео. Второй инструмент, VOID, представляет собой фреймворк для удаления объектов и взаимодействий в видео. VOID решает проблему физически неправдоподобных результатов при удалении объектов со значительными взаимодействиями. Он использует двухэтапный конвейер вывода, где первый этап генерирует физически правдоподобное контрфактическое видео. Второй этап уточняет результат, чтобы предотвратить артефакты, такие как искажение объектов. VOID обучался с использованием синтетических данных, сгенерированных из симуляций, и данных реальной захвата движения. Эксперименты показывают, что VOID лучше сохраняет согласованную динамику сцены по сравнению с предыдущими подходами. Эти исследовательские работы направлены на ответственное развитие редактирования видео с помощью ИИ, одновременно расширяя возможности художников. Оба инструмента, Vera и VOID, подробно описаны в общедоступных исследовательских работах.
CdXz5zHNQW_YZ3adN1Eip.gif
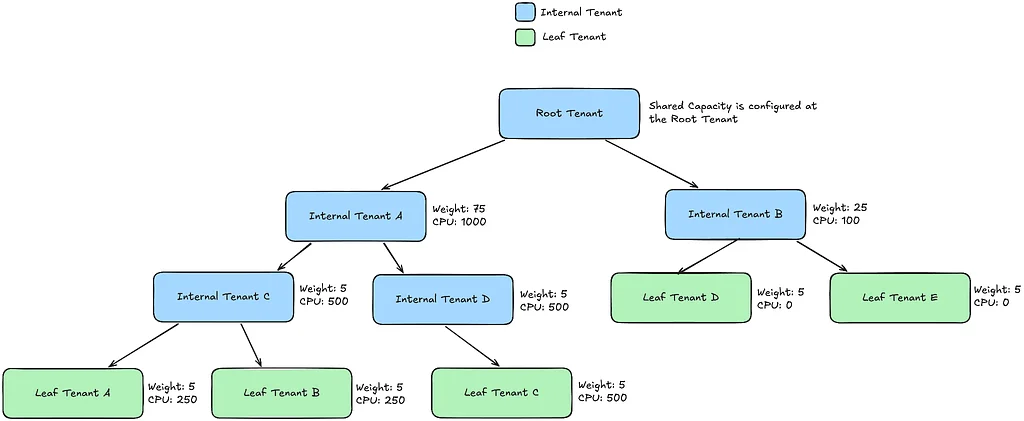
Netflix переводит свою вычислительную инфраструктуру на модель, основанную на Kubernetes, интегрируя такие компоненты, как Kueue, в свою платформу Titus. Kueue — облачная система очередей заданий — в значительной степени заменила пользовательскую логику собственного решения для пакетной обработки Compute Managed Batch (CMB). Среди причин для этой миграции были устаревание CMB, развитие Kubernetes и растущие сложности с добавлением таких функций, как преемпция, в существующую систему. Kueue был выбран из числа альтернатив благодаря совместимости с существующими профилями планирования Titus, динамике внедрения и встроенной поддержке таких функций, как преемпция.Миграция, получившая название Netflix Batch, была направлена на то, чтобы не оказать никакого влияния на пользователей и не снизить пропускную способность. Процесс включал перенаправление отправленных заданий в ячейки Titus с поддержкой Kueue, при этом распределением заданий занималась федерация Titus. Настройки со стороны операторов были минимальными и сводились в основном к простому переключению в пользовательском интерфейсе для подключения арендаторов к Kueue. Это подключение преобразует существующую иерархию арендаторов и конфигурации мощностей CMB в концепции Kueue: Cohorts, ClusterQueues и LocalQueues.Ключевые извлеченные уроки включают поддержание совместимости API со старой системой для обеспечения плавного пользовательского опыта, а также раннюю миграцию сложных сценариев использования для укрепления доверия. Также было крайне важно провести нагрузочное тестирование Kueue, чтобы убедиться в его способности справляться с высокими требованиями Netflix к пропускной способности, что потребовало корректировки конфигураций по умолчанию. В настоящее время Kueue работает в полном объеме, управляя миллионами пакетных рабочих нагрузок, и обеспечивает расширенные функции справедливого распределения ресурсов и преемственности. Эти усовершенствования позволяют более эффективно использовать зарезервированные ресурсы, сократить количество задержек в выполнении заданий и ускорить обработку критически важных рабочих нагрузок, что значительно повышает средний коэффициент использования ресурсов.
CdXz5zHNQW_CNU9jjDeMi.png
Абстракция TimeSeries от Netflix обрабатывает и запрашивает петабайты временных данных событий с миллисекундной задержкой, используя Apache Cassandra в качестве хранилища. Широкие разделы, где один раздел накапливает большой объем событий с течением времени, представляют собой серьезную проблему для рабочих нагрузок TimeSeries. Это приводит к высоким задержкам чтения, тайм-аутам, увеличению загрузки ЦП и паузам сборки мусора в кластерах Cassandra. Для решения этой проблемы данные TimeSeries разделяются на дискретные временные блоки, создавая управляемые сегменты.Первоначальная стратегия предоставления ресурсов полагалась на указанные пользователем характеристики рабочей нагрузки и симуляции Монте-Карло для определения оптимальной инфраструктуры и конфигураций разделов. Однако этот подход оказался недостаточным, когда рабочие нагрузки были неизвестны, неточно оценены, менялись со временем или содержали выбросы данных. Для автоматизации корректировок был введен фоновый рабочий процесс для мониторинга гистограмм разделов и динамического перераспределения будущих временных срезов на основе наблюдаемой плотности данных. Эта стратегия перераспределения временных срезов эффективно снижает задержки чтения и тайм-ауты, когда большинство данных демонстрирует схожее поведение широких разделов.Однако эта стратегия не решает проблемы, когда только небольшой процент идентификаторов в таблице является широким. Для таких случаев, а также когда вызывающие стороны требуют все данные, даже при повышенных задержках, была разработана динамическая разбивка по идентификаторам. Этот асинхронный конвейер обнаруживает широкие разделы во время операций чтения и прозрачно разбивает их на оптимальные размеры. Процесс включает обнаружение, планирование и разбиение, а также обслуживание чтений путем перенаправления запросов на разбитые разделы.Обнаружение происходит, когда операция чтения превышает заданный пороговый объем байтов, отправляя событие в Kafka. Система изначально фокусируется на неизменяемых разделах для простоты. Этап планирования считывает весь раздел для создания плана разбиения, используя контрольные точки для обработки сбоев. Разбиение включает делегирование разделения данных конкретным стратегиям, например, назначение большего количества корзин событий временной корзине. Проверка разбиений имеет решающее значение, при этом контрольные суммы обеспечивают целостность данных перед завершением разбиения. Наконец, серверы TimeSeries используют встроенные в память фильтры Блума для эффективного перенаправления запросов на чтение на разбитые разделы, делая перенаправление практически незаметным для вызывающих сторон.
CdXz5zHNQW_JhVMWuRvRR.png
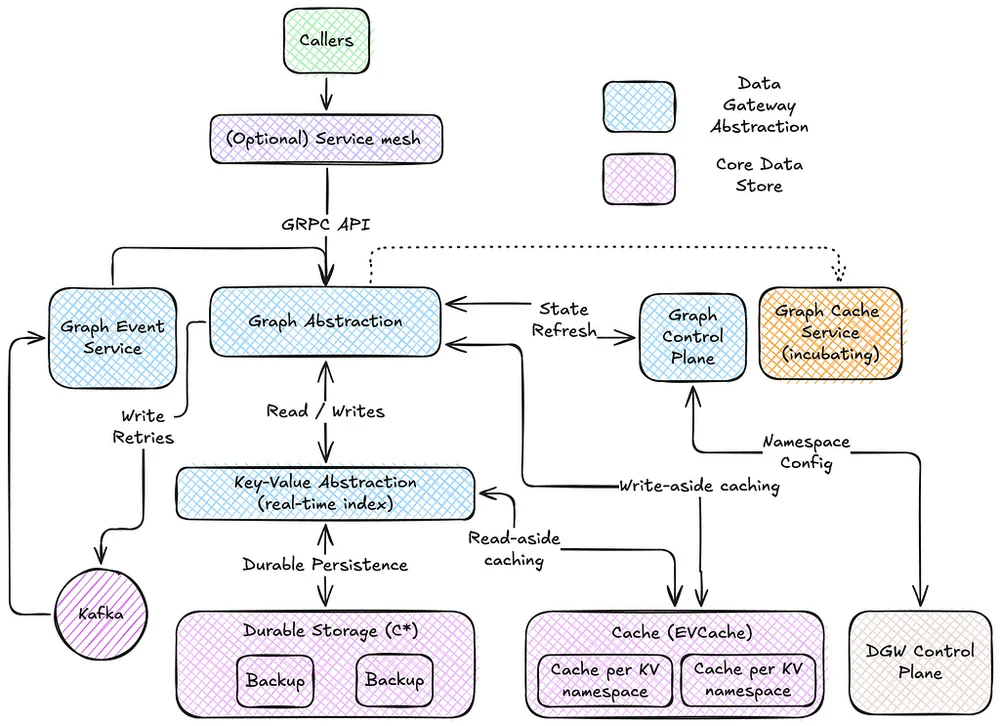
Netflix разработал абстракцию графа для обработки операций с графами с высокой пропускной способностью и низкой задержкой, особенно для случаев использования, таких как распределенные графы в реальном времени и социальные графы. Он работает в двух категориях: OLAP для глубокого анализа и OLTP для потоковых пользовательских опытов. Абстракция использует модель графа свойств с узлами и ребрами сильной типизации, организованными в изолированные пространства имен. Каждое пространство имен имеет предварительно определённую схему графа, управляемую через контрольную плоскость шлюза данных. Эта схема позволяет оптимизации, такие как обеспечение качества данных и эффективное планирование запросов. Реальное индексирование использует хранилище ключ-значение для узлов и ребер, используя отдельные индексы для ссылок и свойств. Ссылки ребер индексируются по отношениям источник-назначение. Чтобы обеспечить доступ независимо от направления, это организует идентификаторы лексикографически. Кэширование используется для минимизации усиления записи и чтения. Архитектура абстракции отдает приоритет высокой производительности и включает стратегии, такие как кэширование write-aside.
CdXz5zHNQW_cFaJPOpvqm.png
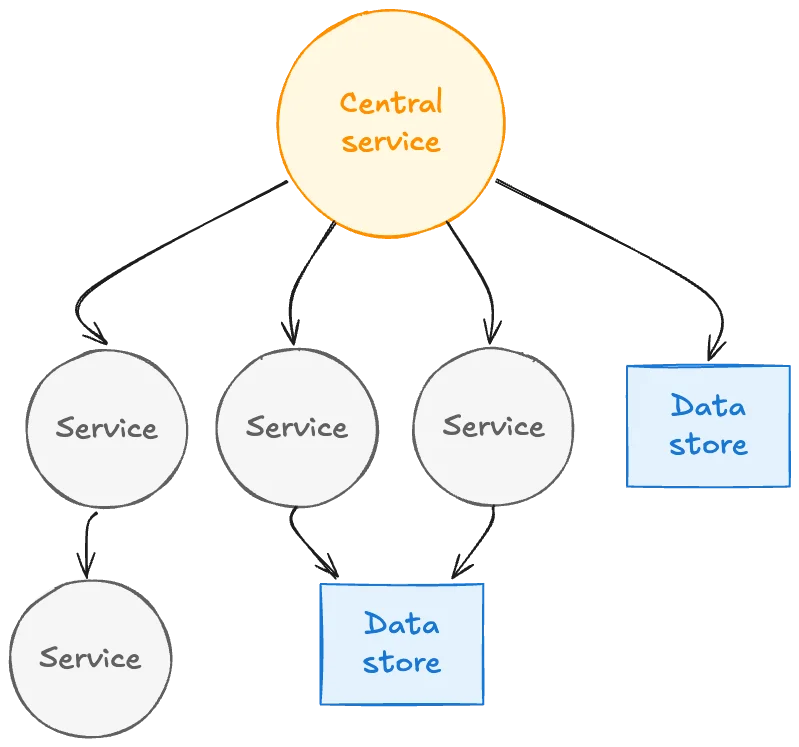
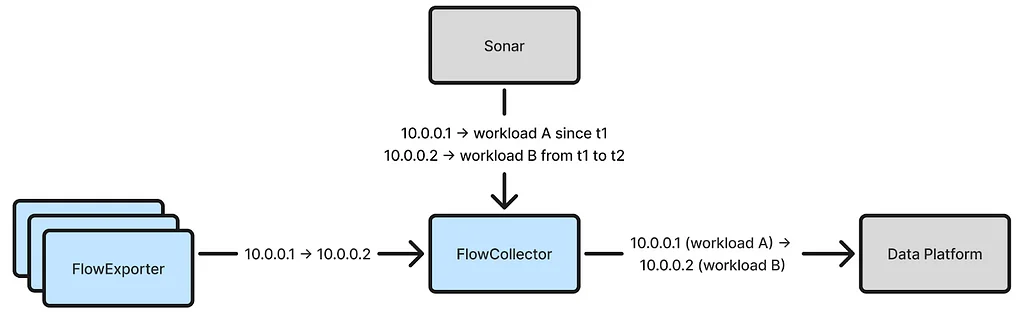
Netflix разработал "динамическую карту" своей распределенной инфраструктуры, называемую Service Topology, чтобы помочь инженерам понять зависимости между сервисами и устранять проблемы. Карта решает проблему более быстрого определения отношений между сервисами и потенциального воздействия во время простоев. Она дает ответы на важные вопросы, такие как какие сервисы зависят друг от друга и где находится источник проблем. Они собрали данные из трех источников: сетевых потоков eBPF, метрик IPC и трассировки от конца до конца. Каждый источник данных дает уникальную перспективу - сетевое подключение, детали на уровне приложения и фактические потоки запросов. Эта многослойная архитектура объединяет эти представления в единую, реальную карту. Система использует отдельные графические базы данных для каждого источника данных, чтобы сохранять независимость и обеспечивать параллельные запросы. Инженеры могут просматривать каждый граф отдельно или объединять их для всестороннего понимания взаимодействия сервисов. Система получает журналы потоков из Kafka в нескольких регионах, обрабатывает их и хранит данные в графических базах данных. Эта динамическая карта помогает инженерам Netflix быстро диагностировать и решать проблемы, обеспечивая бесперебойный просмотр потокового видео.
CdXz5zHNQW_fZOTLLTM4l.png
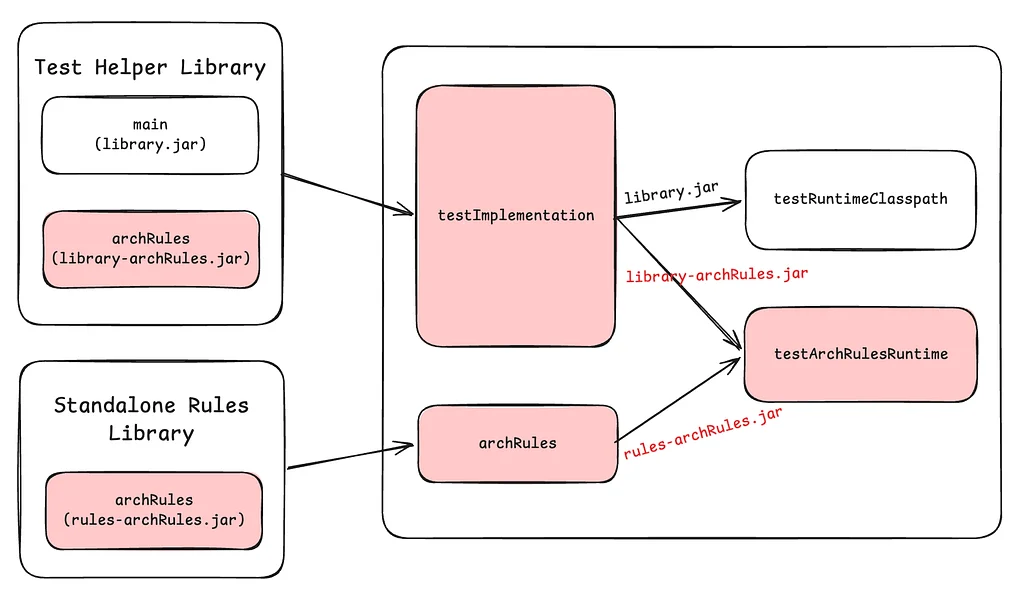
Netflix использует стратегию polyrepo с тысячами Java-репозиториев, требующую эффективного обмена логикой сборки. Они создали набор плагинов Gradle Nebula, включая ArchRules, для управления зависимостями и обеспечения соблюдения стандартов кодирования. Эта инициатива возникла из-за необходимости улучшить управление жизненным циклом Java-библиотек после инцидента с обратно несовместимыми изменениями. Netflix использует аннотации жизненного цикла API (@Deprecated, @Public, @Experimental) для выявления потенциальных проблем с устаревшим кодом. ArchUnit, популярная библиотека для обеспечения соблюдения архитектурных правил, была выбрана для обнаружения неправильного использования этих аннотаций и других проблем с техническим долгом. Плагины Nebula ArchRules позволяют обмениваться правилами ArchUnit и применять их в нескольких репозиториях, предоставляя расширенные возможности. ArchRules использует анализ байт-кода (ASM) для поддержки нескольких языков и простой в использовании шаблон builder, упрощающий создание правил. Правила могут быть включены в библиотеки или определены в отдельных библиотеках правил, автоматически обнаруживаться и запускаться плагином. Плагин ArchRules Runner оценивает правила по наборам исходных кодов и генерирует отчеты в формате JSON и консоли, обеспечивая улучшенные возможности отчетности. Используя ArchRules, Netflix предоставляет платформу для авторов библиотек, позволяющую отслеживать использование API и обнаруживать использование устаревших API.
CdXz5zHNQW_UkqZEpugr5.png
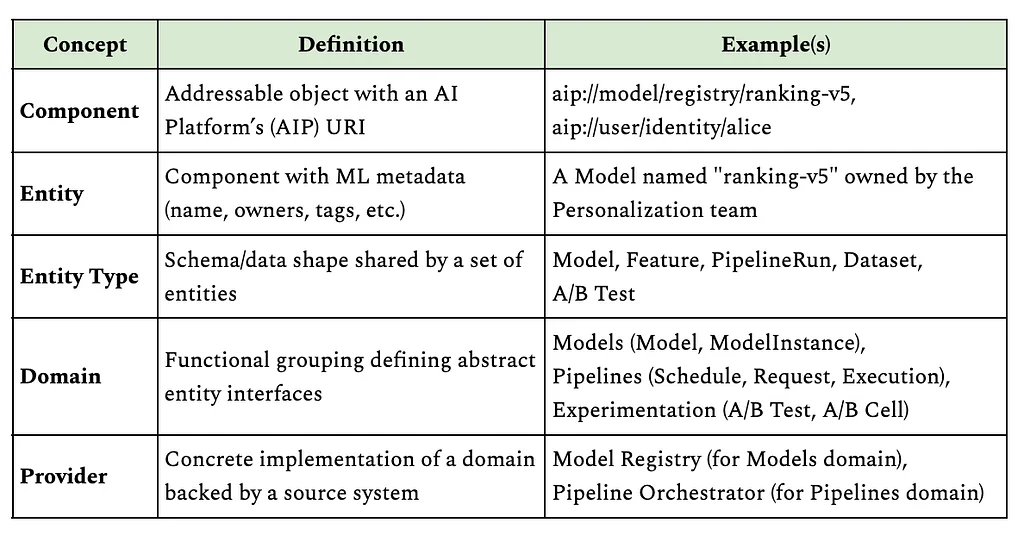
Netflix использует машинное обучение в различных областях бизнеса, таких как персонализация, студийное производство, платежи и реклама. По мере роста использования машинного обучения возникла проблема: фрагментированная среда, где модели и данные были изолированы, что препятствовало сотрудничеству и обнаружению. Специалисты по машинному обучению испытывали трудности с пониманием происхождения моделей, источников признаков и их влияния в различных системах. Эта фрагментация мешала получить простые ответы на вопросы о существующих признаках, источниках данных, зависимостях конвейеров и последствиях изменений.Основная трудность заключалась в соединении разрозненных компонентов инфраструктуры машинного обучения, которые генерировали метаданные. Десятки систем, от оркестраторов конвейеров до платформ экспериментов и хранилищ признаков, производили данные в различных форматах. Решение этой задачи требовало сбора разнородных метаданных, преобразования их в единую модель и построения связанного графа для исследования.Решением является Сервис Метаданных (MDS), который строит Граф Жизненного Цикла Модели для взаимосвязи сущностей машинного обучения в Netflix. MDS в реальном времени обрабатывает метаданные машинного обучения, позволяя выполнять междоменные запросы, такие как идентификация экспериментов, использующих определенную модель, или моделей, имеющих общие признаки. Цель состоит в том, чтобы сделать все активы машинного обучения обнаруживаемыми, понятными и повторно используемыми по всей компании.MDS работает на основе основных абстракций: Компоненты, каждый с уникальным AIP URI; Сущности, которые являются специфичными для машинного обучения активами со свойствами; Типы Сущностей, определяющие формы данных; Домены, которые группируют связанные типы сущностей; и Поставщики, конкретные реализации доменов из исходных систем. Такое адресование на основе URI позволяет любой службе универсально ссылаться на любой актив машинного обучения. Процесс построения графа включает несколько этапов.Во-первых, MDS интегрируется с исходными системами через Kafka и AWS SNS/SQS для потребления легких событий, указывающих на изменения. Специальные обработчики событий обрабатывают события из таких систем, как Оркестратор Конвейеров, Реестр Моделей, Хранилище Признаков, Платформа Экспериментов и Платформа Идентификации. Во-вторых, MDS реализует контракт гидратации, проверяя события и вызывая API исходных систем для получения полного состояния, которое затем преобразуется в нормализованную сущность. Эта модель "уведомления об изменении" обеспечивает надежность против проблем с порядком событий, но создает нагрузку на чтение исходных систем.В-третьих, необработанные события преобразуются в единую модель сущностей со стандартизированными полями, создавая согласованный интерфейс для последующих потребителей. Нормализованные сущности стандартизируют имена полей, форматы и преобразуют идентификаторы, специфичные для платформы, в глобальные AIP URI. Наконец, нормализованные сущности сохраняются в Datomic для кэширования и хранения связей, и одновременно индексируются в Elasticsearch. Datomic, с его неизменяемой моделью фактов, поддерживает сложные обходы графа и связи сущностей, позволяя выполнять запросы по нескольким доменам без неэффективных паттернов запросов N+1.
CdXz5zHNQW_EXeyjNVmx8.png
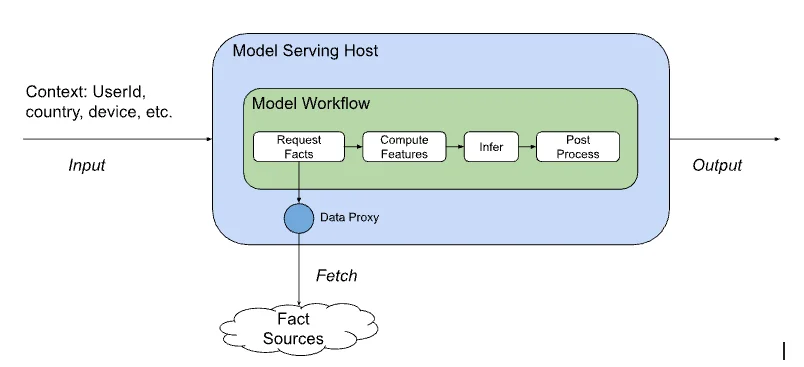
Пост в блоге обсуждает технические аспекты того, как инфраструктура обслуживания моделей машинного обучения (ML) Netflix обеспечивает персонализированные trải nghiệm в масштабе различных доменов. Центральная платформа обслуживания моделей ML предоставляет доменно-независимое абстрактное API и возможности маршрутизации трафика для нескольких доменно-специфических микросервисов для вывода моделей. Это единственное API увеличило скорость инноваций для итерации новых версий существующих trải nghiệm ML и включения новых trải nghiệm продуктов с ML.Успех инфраструктуры обслуживания моделей ML зависит от того, чтобы обеспечить исследователям возможность быстро экспериментировать с новыми гипотезами и безопасно выпускать свои модели в производство. Платформа обслуживает сотни типов и версий моделей, обрабатывая 1 миллион запросов в секунду, и работает на уровне рабочих процессов, а не только отдельных функций оценки.Определение модели содержит список фактов, которые необходимо вычислить для вычисления признаков, и оно полагается на платформу обслуживания моделей для предоставления этих фактов во время обслуживания, вызывая несколько других микросервисов. Вызывающие сервисы только cần предоставить стандартный контекст запроса и соответствующий доменный контекст, и модель может сама вычислить признаки и выполнить вывод как часть потока выполнения.Платформа действует как средство быстрой инновации ML и ограничивает воздействие итераций моделей ML на клиентские приложения. Ключевые принципы платформы включают инновации моделей, независимые от клиентских приложений, декуплинг клиентов от шардирования моделей и гибкие правила маршрутизации трафика.Платформа использует пользовательский сервис под названием Switchboard, который служит гибким прокси-слоем для всего трафика, обрабатывая более 1 миллиона запросов в секунду при сохранении высокой доступности и надежности. Switchboard предоставляет единую точку контакта для всех потребностей моделей клиентов и может маршрутизировать запрос на основе богатого набора контекстных признаков.Платформа также вводит понятие "Цель", которое является перечислением, определенным платформой обслуживания, которое каждый запрос в систему должен предоставить. Цель декуплирует клиентов от конкретных моделей и руководит решениями платформы по маршрутизации и выбору моделей.Правила Switchboard - это конфигурация на JavaScript, которая позволяет исследователям присоединять варианты моделей, эксперименты и разделы трафика к Целям без изменения кода клиента. Правила диктуют модель по умолчанию для использования для данной Цели, эксперименты A/B для настройки для набора Целей и настройки для постепенного перенаправления трафика на новую модель.Правила потребляются как Switchboard, так и кластерами обслуживания моделей, и компоненты платформы обслуживания могут выполнять различные действия на основе этих правил. В целом, платформа обеспечивает масштабируемое и гибкое решение для обслуживания моделей ML в Netflix, обеспечивая быструю инновацию и экспериментирование при минимизации воздействия на клиентские приложения.
CdXz5zHNQW_XdCPf6klQA.png
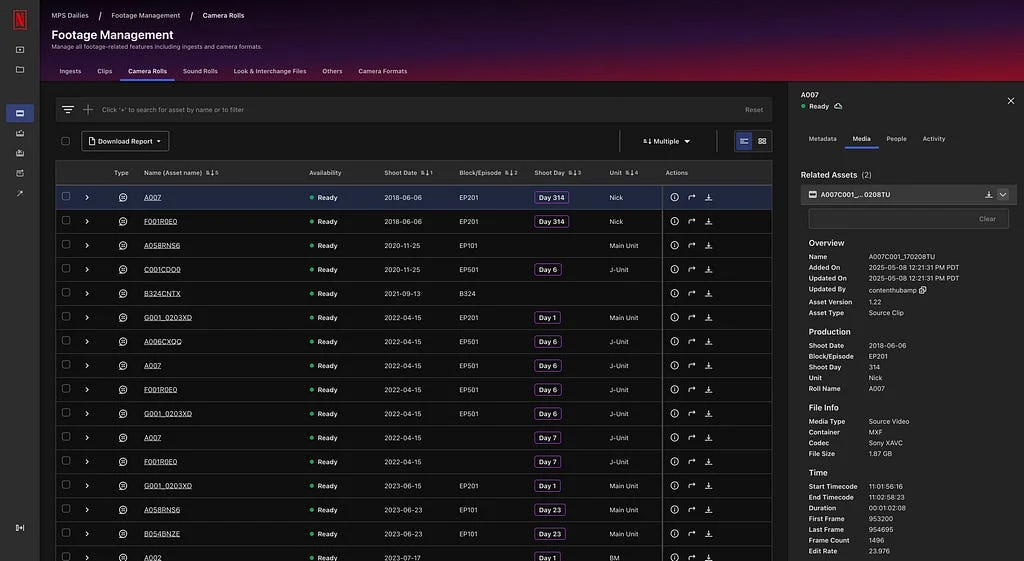
Netflix создала свой пакет для производства медиа (MPS), чтобы оптимизировать рабочие процессы медиа для глобальных производств, стремясь к эффективности и последовательности. Основа MPS использует API FilmLight (FLAPI) для обработки изображений, что является результатом сотрудничества, позволяющего избежать создания всего с нуля. MPS решает такие проблемы, как управление файлами и непоследовательная обработка медиа, автоматизируя задачи и минимизируя ошибки. FLAPI используется для проверки метаданных файлов камер, их нормализации и обеспечения возможности поиска, гарантируя последовательность. FLAPI также генерирует VFX-пластины и конечные продукты с точным управлением цветом и дебайерингом. MPS интегрирован с облаком с использованием Cosmos, что позволяет использовать экземпляры только с ЦП в контейнеризированной среде, максимизируя эффективность. Производственные нагрузки обрабатываются эластично, масштабируясь по требованию, что обеспечивает быстрое выполнение заказов. MPS разработан как для опытных команд, так и для тех, кому нужна помощь, при этом FLAPI берет на себя сложности. Это партнерство обеспечивает открытое общение, совместную валидацию и способствует развитию экосистемы стандартизации. Общий результат — сокращение задержек, ускорение выполнения заказов и повышение эффективности производственных процессов.
CdXz5zHNQW_aUoM5pxXdJ.jpeg
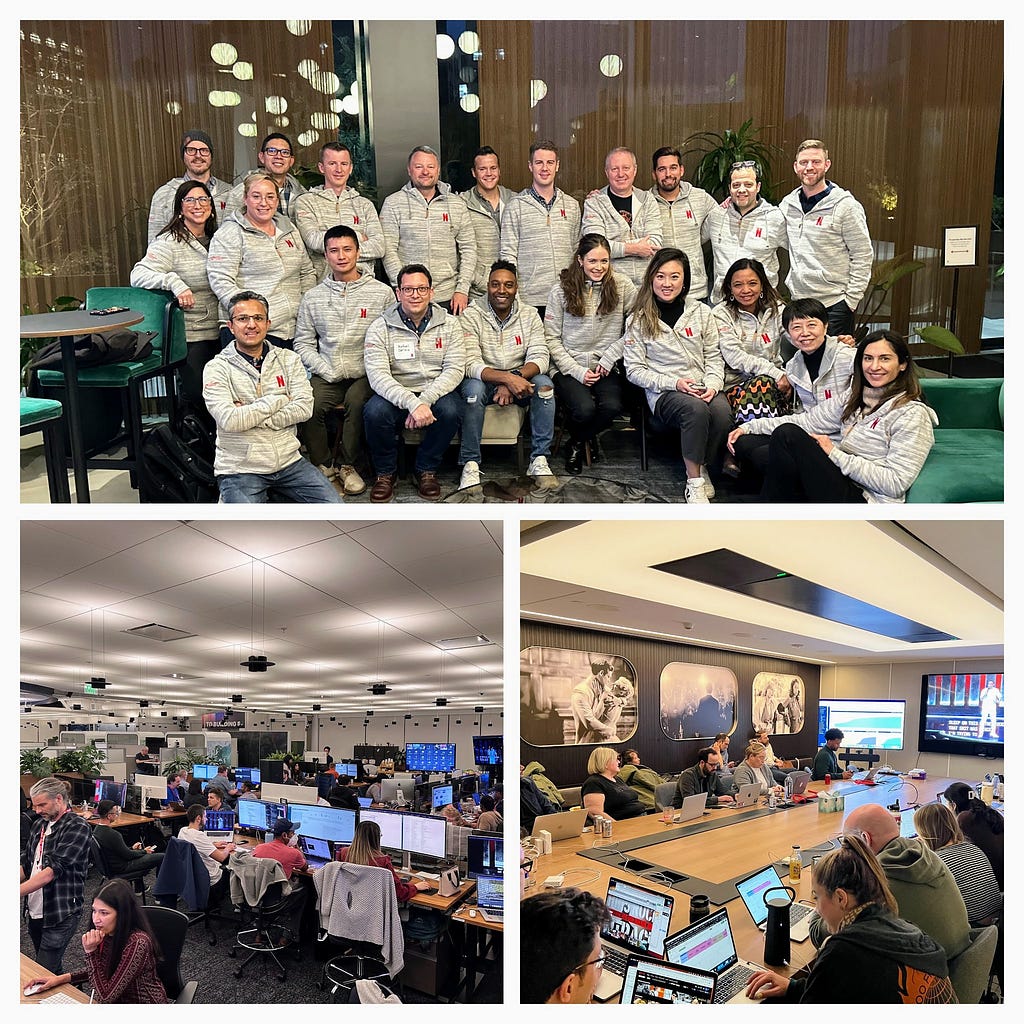
Операции Netflix по прямой трансляции быстро расширились с момента их первого прямого шоу, теперь транслируя несколько событий ежедневно. Первоначальные прямые шоу полагались на инженеров и импровизированные настройки, не имея специальных операционных команд. Эволюция требовала создания специальных Центров вещательных операций (BOC), чтобы управлять процессом прямой трансляции. Чтобы обеспечить надежность сигнала, Netflix устанавливает строгие спецификации для видео- и аудиопотоков от площадок. Операционная модель Netflix прошла через несколько фаз, от инженерно-ориентированных операций до специализированных инженерных команд. Была разработана модель Центра передачи (TOC), чтобы повысить эффективность и управлять большим объемом событий одновременно. В рамках модели TOC отдельные роли, такие как операторы передачи, потоковой передачи и управления вещанием, имеют решающее значение. Для высокопрофильных событий специализированная модель "Большой риск" предоставляет выделенные ресурсы. Центр управления прямой трансляцией (LCC) отслеживает всю цепочку прямой трансляции, предоставляя операторам данные в режиме реального времени. LCC использует индивидуальный стек наблюдаемости для управления огромными объемами данных и оперативно реагировать на проблемы. Руководители операций LCC и технические менеджеры запуска отвечают за реагирование на инциденты.
CdXz5zHNQW_kK6Y54I9YV.jpeg
Netflix стремится улучшить процесс выбора краткого содержания для своей огромной библиотеки контента. Тысячи названий усложняют выбор пользователя, делая краткие содержания важными для принятия решений. Высококачественные краткие содержания повышают вовлеченность пользователей, а плохие приводят к разочарованию и отказу. Проблема заключается в масштабировании проверки качества на сотни тысяч кратких содержаний. Netflix разработала подход на основе модели крупномасштабного языка (LLM) для оценки качества кратких содержаний по четырем ключевым направлениям. Эта система достигает более 85% согласия с творческими писателями, обеспечивая стандарты качества, основанные на мнении экспертов. Качество краткого содержания оценивается как через творческую ценность, определяемую писателями, так и через неявную обратную связь пользователей посредством метрик потокового вещания. Система LLM-as-a-Judge использует методы, такие как многоуровневые обоснования, оценка консенсуса и агенты фактичности, для оптимизации точности. Эти баллы качества, полученные из LLM, коррелируют с ключевыми метриками потокового вещания, такими как доля просмотра и коэффициент отказа. Это позволяет Netflix проактивно выявлять и исправлять проблемы с краткими содержаниями, улучшая опыт пользователя и открытие контента.
CdXz5zHNQW_s8spGD1mD0.png
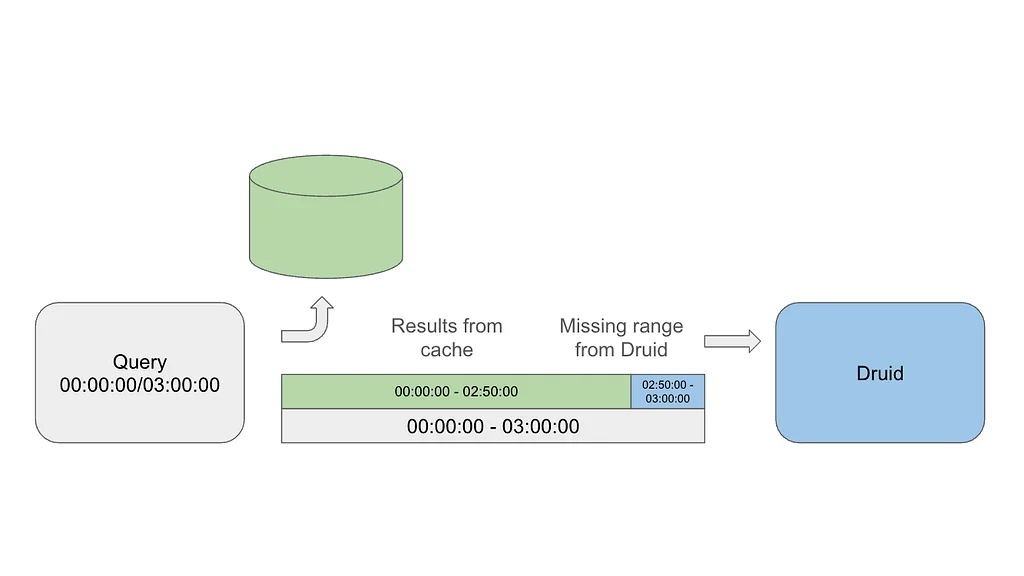
Netflix внедрила экспериментальный слой кэширования для повышения производительности запросов Druid в огромном масштабе. Эта система кэширования решает проблему избыточных запросов с панелей мониторинга, особенно во время громких событий. Основная идея заключается в кэшировании частей результатов и запросе Druid только для самых свежих данных, что приводит к небольшому компромиссу со степенью устаревания. Используются значения времени жизни (TTL) по экспоненте, при этом более старые данные кэшируются дольше для обработки поздних событий. Система кэширования использует структуру "карта-карт" для эффективного сканирования диапазонов кэшированных данных. Кэш перехватывает запросы в Druid Router, обслуживая результаты или запрашивая Druid по мере необходимости. Решение объединяет кэшированные и свежие данные, возвращая полный результат и асинхронно кэшируя свежие данные. Отрицательное кэширование используется для пустых сегментов, с мерами предосторожности против кэширования конечных пустых сегментов. Система использует слой абстракции данных "ключ-значение" (KVDAL) Netflix, поддерживаемый Cassandra, который предлагает независимые TTL для каждой точки данных. Слой кэширования значительно снизил нагрузку на запросы Druid и улучшил время запросов, особенно во время событий с большим объемом. Система кэширования все еще экспериментальная, и будущие цели включают интеграцию в сам Druid.
CdXz5zHNQW_ZIJYgW0wPc.png
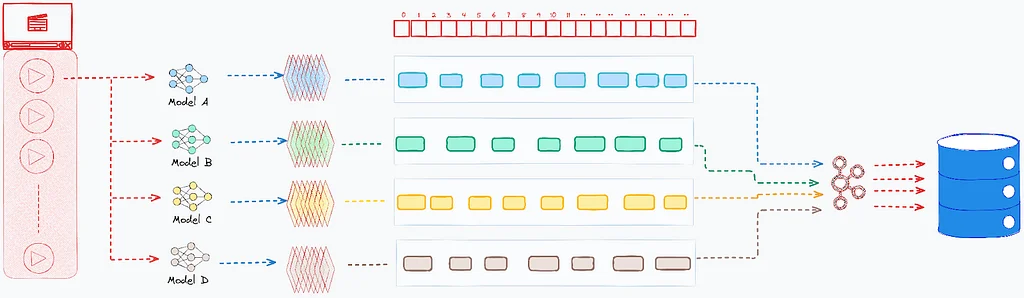
В статье обсуждаются проблемы и решения для создания продвинутой системы поиска видео. Основная проблема заключается в огромном объеме видеоматериалов и сложности извлечения релевантных моментов. Решение предполагает мультимодальный подход, интегрирующий различные модели ИИ для анализа различных аспектов видеоконтента. Этот подход требует объединения разнообразных данных из специализированных моделей в целостную систему интеллекта реального времени. Архитектура системы ориентирована на обработку в масштабе, эффективную обработку миллиардов точек данных. Трехэтапный процесс, включающий транзакционное сохранение, автономное объединение данных и индексирование для поиска в реальном времени, обеспечивает целостность данных и оперативность. Процесс использует разделенный конвейер, чтобы избежать узких мест во время процесса приема данных. Служба поиска предлагает такие функции, как предварительная обработка запросов, точная настройка семантического поиска и расширенный текстовый анализ для получения точных результатов. Она также включает сопоставление фраз, анализ N-грамм и нечеткое сопоставление для повышения точности поиска. Система предоставляет агрегации и гибкую группировку, чтобы обеспечить более нюансированный поиск. В целом, цель состоит в том, чтобы расширить возможности кинематографистов, предоставив мощный инструмент для обнаружения релевантного видеоконтента.
CdXz5zHNQW_YdZx5oYSdr.png
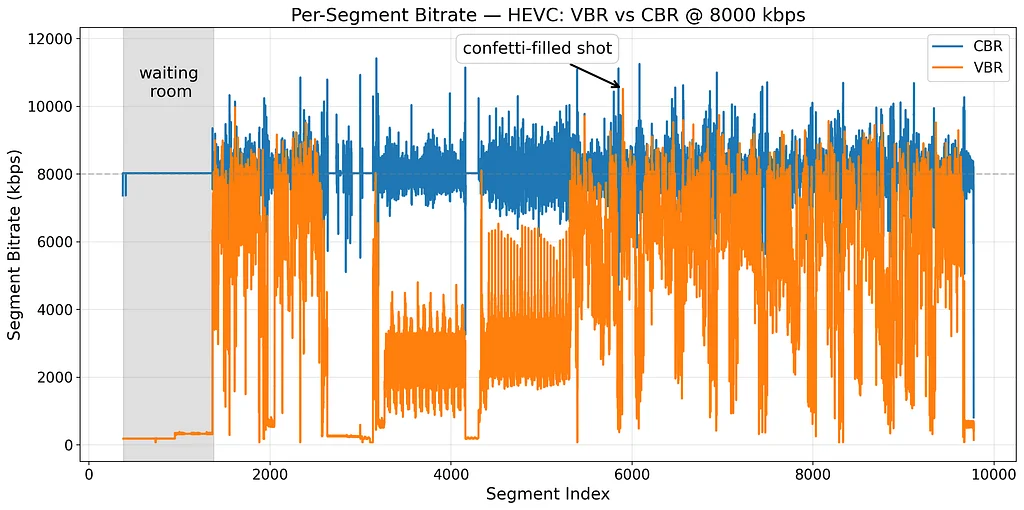
Netflix перешла от постоянной скорости битовой передачи (CBR) к переменной скорости битовой передачи (VBR) для кодирования своих прямых трансляций, что улучшило эффективность. VBR динамически регулирует скорость битовой передачи в зависимости от сложности сцены, что приводит к уменьшению среднего трафика и улучшению качества обслуживания. Основной проблемой VBR является непредсказуемость трафика, которая может привести к перегрузке сервера и нестабильности из-за больших колебаний скорости битовой передачи. Чтобы решить эту проблему, Netflix реализовала новую систему резервирования емкости на основе номинальных скоростей битовой передачи, смягчив риски, связанные с переменной природой VBR. Они также скорректировали номинальные скорости битовой передачи по всей своей потоковой лестнице, чтобы они соответствовали качеству потоков CBR, используя VMAF в качестве руководящего показателя. Переход на VBR позволил достичь таких преимуществ, как снижение задержек буферизации и начальных задержек запуска. Теперь Netflix работает над улучшением своих алгоритмов адаптивной скорости битовой передачи и резервирования емкости, чтобы еще больше оптимизировать VBR. Реализация VBR была проектом компании, в котором участвовали несколько команд и участников.
CdXz5zHNQW_f7OyE9DYza.png
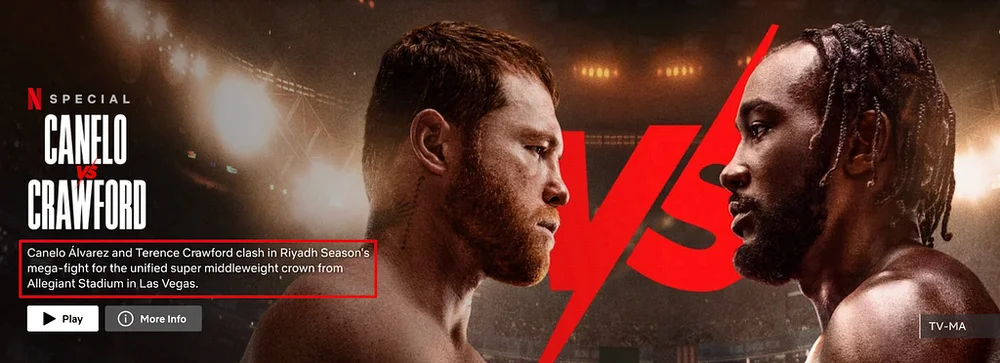
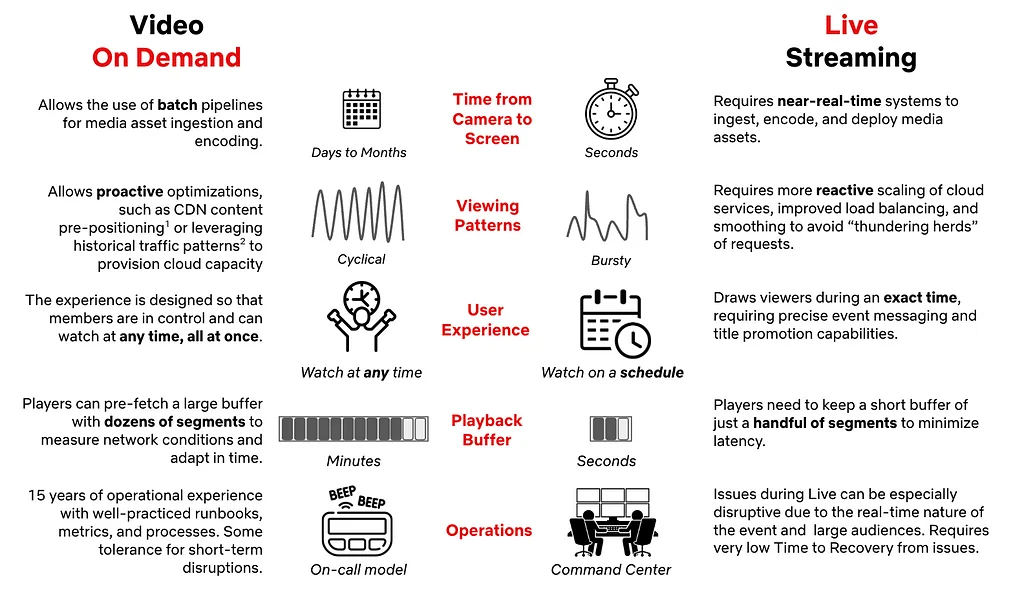
Три года назад Netflix задался вопросом, как они могут развлекать мир с помощью прямой трансляции – формата, который почти так же стар, как и само телевидение. Этот вопрос привел к разработке сотен прямых трансляций, включая комедийные шоу, спортивные мероприятия и события WWE. В серии под названием "За кулисами стримов" Netflix расскажет о техническом пути создания возможностей для прямой трансляции. Прямая трансляция потребовала новых подходов к архитектуре и выбору технологий, а также значительных усилий для ее эффективной работы на Netflix. Ключевые составляющие архитектуры прямой трансляции Netflix включают выделенные студии вещания, облачные резервные конвейеры для транскодирования и упаковки, масштабирование доставки живого контента, оптимизацию воспроизведения в реальном времени и облачные сервисы управления обнаружением и воспроизведением. Netflix также централизовал в облаке метрики в реальном времени с помощью специализированных инструментов и средств. Создание функционала для прямой трансляции принесло новые вызовы и возможности для обучения, и Netflix продолжает ежедневно учиться тому, как более эффективно доставлять прямые трансляции. Основные уроки, полученные на данный момент, включают важность всестороннего тестирования, регулярных тренировок, прогнозирования просмотров, поэтапного снижения нагрузки и "штормов повторных попыток". Netflix добился значительного прогресса в создании надежной системы прямой трансляции, но еще многое предстоит узнать и улучшить.
CdXz5zHNQW_JBiedm3Ejv.png
Tudum.com - это официальное место для фанатов Netflix, предлагающее эксклюзивный контент, информацию из-за кулис и интерактивные опыты более чем 20 миллионам пользователей каждый месяц. Архитектура платформы спроектирована для обеспечения поддержки, масштабируемости и гибкости, используя подход серверного интерфейса пользователя, похожий на Command Query Responsibility Segregation (CQRS). Команда редакторов Tudum создает контент, который хранится в базе данных для записи, а затем преобразуется в формат, оптимизированный для чтения, для потребления пользователями. Первоначальная архитектура использовала Kafka для разделения баз данных для записи и чтения, что позволяло масштабировать независимо и обеспечивать консистентность в конечном счете. Однако этот подход ввел задержку между редактированием контента и его отражением на сайте. Команда определила источник задержки как Сервис данных страницы, который использовал кэш для ускорения сборки страниц. Чтобы решить эту проблему, Netflix разработала RAW Hollow, базу данных объектов в памяти, ко-локализованную и сжатую, которая обеспечивает сильную консистентность чтения после записи и низкую задержку. Tudum был идеальным местом для тестирования RAW Hollow, который значительно уменьшил ввод-вывод и обеспечил синхронный доступ к данным за время O(1). Обновленная архитектура устранила необходимость в инфраструктуре Kafka и уменьшила время распространения данных, позволяя писателям и редакторам просматривать изменения в течение секунд. Миграция также привела к более быстрым временам запросов, время сборки домашней страницы уменьшилось с 1,4 секунды до 0,4 секунды.
CdXz5zHNQW_0cHOBDLN2F.jpeg
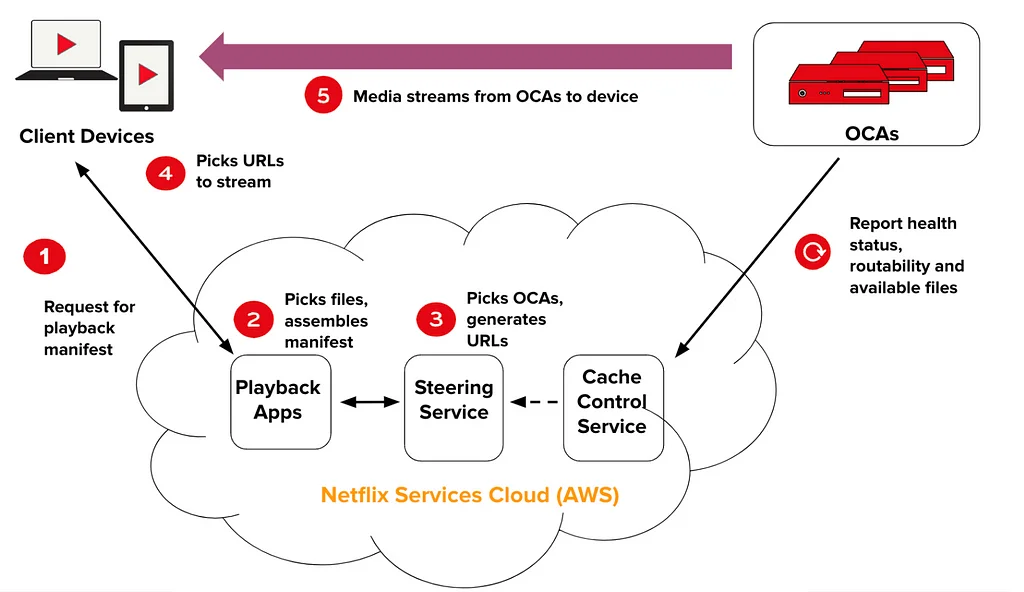
Программа Open Connect Netflix - это сеть доставки контента (CDN), которая стремится обеспечить лучшее качество опыта (QoE) для своих членов путем локализации доставки контента через партнерства с интернет-провайдерами (ISP) по всему миру. Программа использует серверы с.custom-разработанными серверами, называемыми аппаратными устройствами Open Connect (OCAs), которые спроектированы для эффективности и экономичности. Чтобы оценить эффективность Open Connect, Netflix использует фреймворк для выявления источников неэффективности, а именно пропусков кэша, которые возникают, когда байты не обслуживаются из лучшего доступного OCA для данного клиента. Пропуски кэша классифицируются на три категории: пропуски контента, пропуски здоровья и другие пропуски. Пропуски контента возникают, когда файлы не найдены на OCA в локальном сайте, а пропуски здоровья возникают, когда аппаратные ресурсы OCA в локальном сайте насыщены. Netflix регистрирует два критических компонента данных для вычисления пропусков кэша: журналы манифеста воспроизведения и журналы сервера OCA. Эти журналы объединяются для вычисления подробных метрик пропусков кэша на различных уровнях агрегации. Архитектура системы для вычисления пропусков кэша включает в себя эмиссию журналов, консолидацию журналов, обогащение журналов и соединения на основе потокового окна. Модель данных, используемая для оценки пропусков кэша, позволяет повторять логику офлайн и в симуляциях с переменными параметрами для тестирования новых условий и функций без влияния на производственный трафик.
CdXz5zHNQW_u3pdU106U1.png
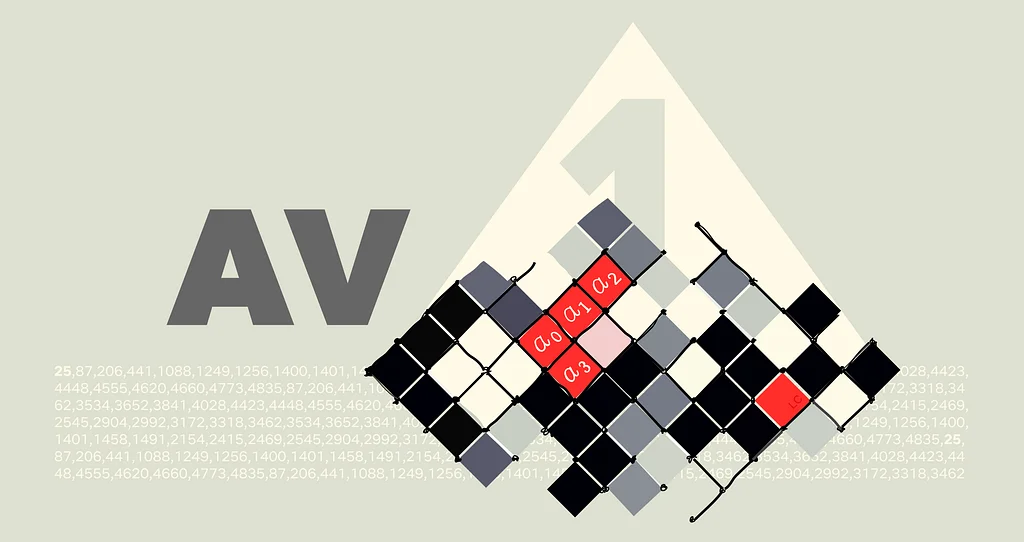
Netflix представила потоки AV1 Film Grain Synthesis (FGS), которые сохраняют художественную целостность зерна пленки, оптимизируя при этом эффективность использования данных. Зерно пленки является ключевым элементом в рассказывании историй, добавляя глубину и реализм фильмам, но его трудно сжимать с помощью традиционных алгоритмов. Инструмент AV1 FGS моделирует зерно пленки через два компонента: узор зерна пленки и интенсивность зерна пленки. Узор зерна пленки воспроизводится с помощью авторегрессивной модели, а интенсивность зерна пленки контролируется функцией масштабирования. Процесс кодирования удаляет зерно пленки из видео, сжимает его и передает узор и интенсивность зерна вместе с сжатыми видеоданными. Во время воспроизведения зерно пленки воссоздается и повторно интегрируется в видео с помощью блочного метода. Включение AV1 FGS привело к значительному уменьшению битрейта, что позволяет осуществлять высококачественное потоковое видео с меньшим количеством данных. Эта технология также улучшила визуальное качество, поскольку синтезированный шум эффективно маскирует артефакты сжатия. Netflix внедрила FGS на всей своей платформе, и пользователи теперь могут наслаждаться потоками с поддержкой FGS на поддерживаемых устройствах. Внедрение FGS привело к более гладкому и надежному качеству обслуживания для членов Netflix, с более низким битрейтом, уменьшением ошибок воспроизведения и улучшением стабильности воспроизведения.
CdXz5zHNQW_VP7NReszvY.png
По мере роста предложений Netflix растет и сложность систем, поддерживают его, что приводит к дублированию и несовместимости моделей, несовместимости терминологии, проблемам качества данных и несовместимости отношений между данными. Для решения этих задач требуется новая основа, которая позволяет определить модель один раз и использовать эти определения везде, связывая концепции с реальными системами и проецируя эти определения наружу, генерируя схемы и обеспечивая согласованность по всей системе. Это привело к разработке UDA - Единая Архитектура Данных), которая позволяет моделировать домены один раз и представлять их постоянно по всей системе, обеспечивая автоматизацию, обнаружение и семантическую совместимость. UDA позволяет пользователям и системам регистрировать и связывать модели доменов, каталогизировать и сопоставлять модели доменов с контейнерами данных, транслировать модели доменов в языки определения схем, перемещать данные надежно между контейнерами данных, обнаруживать и исследовать концепции доменов и программно просматривать граф. UDA - это граф связей, который связывает бизнес-концепции с схемами и контейнерами данных, основанный на внутренней метамодели под названием Upper, который определяет язык для моделирования доменов в UDA. Upper - это язык для описания доменов и их концепций, и он используется для моделирования представлений контейнеров данных и сопоставлений. UDA использует модель графа с именованными графами, обеспечивая разрешение, модульность и управление по всему графу.
CdXz5zHNQW_aXb9bCvUTK.png
Системы рекомендаций являются неотъемлемыми компонентами электронной коммерции, потокового медиа и социальных сетей, оказывая значительное влияние на продукт и бизнес. В Netflix эти системы соединяют членов с релевантным контентом в нужное время. Модель фундамента рекомендаций достигла значительного прогресса в понимании предпочтений пользователей, но есть возможность дальнейшего улучшения ее возможностей. Расширив модель фундамента для включения прогнозирования скрытых намерений пользователей, модель может обогатить свое понимание сессий пользователей за пределами прогнозирования следующий элемент. Недавние исследования подчеркнули важность понимания намерений пользователей на онлайн-платформах, что приводит к более точным и персонализированным рекомендациям. FM-Intent, новая модель рекомендаций, улавливает скрытые намерения пользовательской сессии с помощью краткосрочных и долгосрочных неявных сигналов в качестве прокси, а затем использует это прогнозирование намерений для улучшения рекомендаций следующего элемента. Модель устанавливает иерархические отношения между прогнозированием намерений и рекомендациями следующего элемента, создавая более согласованный и эффективный pipeline рекомендаций. FM-Intent вносит три основных вклада: новую модель рекомендаций, иерархический подход к многозадачному обучению и всестороннюю экспериментальную валидацию, демонстрирующую значительные улучшения по сравнению с моделями уровня искусства. FM-Intent была успешно интегрирована в экосистему рекомендаций и может быть использована для нескольких приложений, включая оптимизацию пользовательского интерфейса, аналитику и усиленные сигналы рекомендаций.
CdXz5zHNQW_QduYXjmsjM.png
В Netflix была разработана мощная платформа обработки событий для мониторинга, измерения и оптимизации рекламных кампаний. Система показа рекламы опирается на стабильный поток рекламных событий для корректировки решений, ограничения частоты показов, темпа и персонализации. Изначальная система обработки рекламных событий состояла из трех основных компонентов: Microsoft Ad Server, Netflix Ads Manager и Ad Event Handler. Система была разработана для обеспечения эффективной работы петли обратной связи, предоставляя информацию об показах, ограничении частоты показов и процессах монетизации. По мере расширения бизнеса был введен новый уровень персистентности с использованием Key-Value абстракции для решения таких задач, как рост объема данных и URL-адресов сторонних систем отслеживания. Конвейер обработки событий был дополнительно усовершенствован для поддержки собственной рекламной технологии, включая такие функции, как ограничение частоты показов, информация о ценах и надежная система отчетности. Было запланировано создание централизованной системы сбора рекламных событий, предоставляющей единый унифицированный контракт данных для потребителей и разделяющей зоны ответственности между восходящими системами и потребителями. Новый конвейер поддерживал различные функции, такие как измерение, финансы/биллинг, отчетность, ограничение частоты показов и поддержание важной петли обратной связи с рекламным сервером. Разработка систем обработки рекламных событий стала тщательно организованным путешествием, демонстрирующим командную работу, планирование и координацию между различными командами. Новая система значительно ускорила возможность запуска новых возможностей для бизнеса, поддерживая возможности программной закупки, обмена сигналами отказа от отслеживания и обеспечивая точную отчетность и измерения.
CdXz5zHNQW_x4VyedRjxa.png
Netflix уделяет первостепенное внимание улучшению пользовательского опыта, сотрудничая с технологическими партнерами для совершенствования инструментов и рабочих процессов. Это сотрудничество направлено на повышение разборчивости диалогов на протяжении всего производственного процесса, решая проблемы от съемочной площадки до экрана. Ключевой инициативой является Pipeline целостности диалогов (Dialogue Integrity Pipeline), который выявляет и смягчает факторы, влияющие на ясность, такие как шумная обстановка и сведение звука. Netflix использует стандартные для отрасли измерители громкости и разработала систему измерений на основе eSTOI для анализа разборчивости диалогов. Чтобы улучшить оптимизацию перед доставкой, Netflix сотрудничал с Fraunhofer IDMT и Nugen Audio для создания плагина DialogCheck. Этот плагин, интегрированный в цифровые звуковые рабочие станции (DAW), обеспечивает обратную связь в реальном времени для звукоинженеров. Сотрудничество использует решение Fraunhofer по разборчивости речи на основе машинного обучения и опыт Nugen Audio в области аудиоплагинов. Плагин DialogCheck позволяет рано выявлять и устранять проблемы с ясностью диалогов, гарантируя, что художественный замысел не будет нарушен. Конечная цель - предоставление захватывающего и доступного повествования для всех зрителей, независимо от условий прослушивания. Этот совместный подход подчеркивает приверженность Netflix к совершенству звука и инновациям в повествовании.
CdXz5zHNQW_u9iv4wSU0L.png
Netflix использует eBPF для захвата журналов потоков TCP в крупном масштабе для улучшения сетевых сведений, но точная атрибуция IP-адресов потоков к идентификаторам рабочей нагрузки была значительной проблемой. Первоначальный подход к атрибуции основывался на Sonar, внутренней службе отслеживания IP-адресов, но он привел к неправильной атрибуции из-за задержек и сбоев в распределенных системах. Неправильная атрибуция сделала данные потоков ненадежными для принятия решений, а обходной путь, при котором полученные потоки сохранялись в течение 15 минут перед атрибуцией, не решил проблему. Чтобы решить эту проблему, Netflix разработал новый метод атрибуции, который атрибутирует локальные IP-адреса, определяя локальную идентификатор рабочей нагрузки из ее окружения. Для контейнерных рабочих нагрузок Netflix использовал IPMan, службу назначения IP-адресов контейнеров, для атрибуции локальных IP-адресов. Как только локальные IP-адреса атрибутируются, удаленные IP-адреса можно атрибутировать, изучая временные диапазоны, в течение которых каждая рабочая нагрузка владеет данным IP-адресом. FlowCollector поддерживает в памяти хэш-карту для представления этих знаний и делится изученными временными диапазонами с другими узлами с помощью Kafka. Новый метод обеспечивает точную атрибуцию и корректно обрабатывает временные проблемы, и он также экономически эффективен благодаря своей простоте и поиску в памяти. Метод расширен для атрибуции межрегиональных IP-адресов путем перенаправления потоков на узлы в соответствующем регионе. Наконец, метод еще больше расширен для атрибуции IP-адресов, не принадлежащих рабочим нагрузкам, таких как те, которые принадлежат сети доставки контента Netflix.
CdXz5zHNQW_ODQpwXb03K.png
"Переход киноиндустрии на облачные рабочие процессы сталкивается с проблемами при глобальном внедрении. Netflix стремится решить эти проблемы с помощью своего Media Production Suite (MPS), предназначенного для кинематографистов. MPS упрощает управление медиа, устраняя скучные задачи и повышая творческий потенциал. Традиционные рабочие процессы, использующие физические кассеты, медленные и неудобные, препятствующие сотрудничеству. Цифровые рабочие процессы также сталкиваются с проблемами в распространении и стандартизации. Облачные технологии предлагают решения, но требуют преодоления операционных и технологических барьеров. Netflix решает эти проблемы, привлекая людей и приложения к медиа, а не наоборот. MPS решает глобальные различия в технологиях и стандартизации, учитывая различные потребности рынка. Этот пакет автоматизирует процессы, такие как управление цветом и кадрирование, используя отраслевые стандарты. Инфраструктура сочетает облачные и физические возможности, оптимизированные для производительности пользователя. MPS включает инструменты для ингеста, медиа-библиотеки, дневных съёмок, удалённых рабочих станций и многое другое. Более 350 тайтлов использовали инструменты MPS, с отзывами из разных глобальных регионов. Бразильский сериал "Сенна" принял MPS, продемонстрировав свою способность преодолеть географические барьеры."
Netflix разрабатывает базовую модель для рекомендаций, чтобы централизовать изучение предпочтений пользователей и повысить эффективность различных моделей рекомендаций. Существующая система использует специализированные модели, которые дорого поддерживать и в которых сложно делиться инновациями. Базовая модель направлена на извлечение знаний из обширной истории взаимодействия пользователей и данных о контенте, а также на распространение этих знаний на другие модели. Вдохновленный большими языковыми моделями, подход переходит к стратегии, ориентированной на данные, с использованием полу-автоматического обучения. Netflix токенизирует взаимодействие пользователей, балансируя между детализацией данных и сжатием последовательности для обработки длительной истории взаимодействия. Для управления вычислительной эффективностью во время обучения используются механизмы разреженного внимания и выборка скользящим окном. Каждый токен содержит богатую, разнородную информацию о действии и контенте, используя признаки, полученные как во время запроса, так и после действия. Модель использует авторегрессивную цель предсказания следующего токена, аналогичную GPT, но с модификациями, учитывающими различную важность взаимодействия. Модель предсказывает несколько токенов и использует вспомогательные цели предсказания для захвата долгосрочных зависимостей и повышения точности. Для решения проблемы "холодного старта" новых объектов, модель построена с использованием инкрементного обучения и возможностью делать выводы о ранее невидимых объектах, используя метаданные объектов и входных данных.
CdXz5zHNQW_VZmJPzyqeS.png
Netflix начал транслировать контент HDR10+ на устройствах с поддержкой AV1, обеспечивая лучший просмотровой опыт для сертифицированных устройств HDR10+. Это улучшение существующего контента HDR10, который использовал только статические метаданные. Динамические метаданные в HDR10+ улучшают качество и точность изображения. Netflix всегда была пионером в внедрении технологии HDR, и за последние пять лет потоковая передача HDR увеличилась более чем на 300%. Компания теперь имеет более 11 000 часов HDR-контента.Netflix включил поддержку HDR10+ с помощью видеокодека AV1, который является одним из самых эффективных кодеков. AV1 уже является вторым по популярности кодеком на Netflix, и с добавлением потоков HDR10+ ожидается, что он скоро станет самым популярным кодеком. Компания добавляет потоки HDR10+ как к новым релизам, так и к существующим популярным HDR-тайтлам, с целью обеспечения HDR10+-опыта для всех HDR-тайтлов к концу года.HDR10+ является одним из трёх распространённых форматов HDR, наряду с Dolby Vision и HDR10. HDR10+ и Dolby Vision используют динамические метаданные, которые обеспечивают статистику изображения контента на основе каждого кадра, позволяя оптимизировать коррекцию тона для каждой сцены. Это достигает большей перцептивной точности исходного изображения, сохраняя творческий замысел. Чтобы получить HDR10+, члены должны иметь подписку на тарифный план Netflix Premium, тайтл должен быть доступен в формате HDR10+, а устройство члена должно поддерживать AV1 и HDR10+.Запуск HDR10+ был совместным усилием нескольких команд в Netflix, и компания благодарна всем, кто внёс свой вклад в реализацию этой идеи. Комитет к инновациям и качеству подчеркивает приверженность Netflix к обеспечению погружающего и аутентичного просмотрового опыта для всех своих членов.
CdXz5zHNQW_x7iQNmTXt1.png
Чтобы достичь всеобъемлющей наблюдаемости названий на Netflix, компания ввела конечные точки наблюдаемости во всех сервисах внутри своего стека персонализации и обнаружения. Каждый микросервис, участвующий в стеке, должен был ввести новую конечную точку "Здоровье названия", которая соответствует принципам точного отражения поведения в производстве, стандартизации и ответа на триаду прозрачности. Триада прозрачности требует от конечной точки ответа на вопросы, подходит ли название для продвижения, почему оно не подходит, и что можно сделать, чтобы исправить проблемы.Была разработана стабильная формат запроса/ответа протокола для стандартизации связи между сервисом наблюдаемости и конечными точками наблюдаемости стека персонализации. Высокоуровневая архитектура решения включает в себя создание конечных точек наблюдаемости, активное мониторинг, отслеживание реального времени показов названий, хранение данных в оптимизированном хранилище данных и предоставление простых в интеграции API для панели управления.Микросервис "Здоровье названия" запускает запланированную задачу сбора данных каждые 30 минут для получения соответствующей информации о здоровье названия из назначенных сервисов. Реальные данные о показах названий обрабатываются из очереди Kafka, которая опрашивается каждые две минуты для получения данных о показах. Данные затем агрегируются и представляются в качестве дополнительного индикатора состояния здоровья для заинтересованных сторон.Данные хранятся в выделенном потоке Hollow для каждого сбора, что позволяет обеспечить высокопроизводительный доступ только для чтения и позволяет отслеживать общее состояние здоровья и историю названий. Панель управления наблюдаемости использует сервис "Здоровье названия" для представления состояния названий заинтересованным сторонам, а система также имеет функцию "Путешествие во времени", которая имитирует трафик заранее, чтобы обнаружить и исправить проблемы до того, как они повлияют на членов.Архитектура системы и стратегии позволили Netflix улучшить наблюдаемость запуска названий, обеспечив захватывающий просмотровый опыт и укрепив доверие с создателями контента и партнерами. Решение также закладывает основу для будущих инноваций, обеспечивая то, чтобы каждая история достигла своей целевой аудитории и чтобы каждый член наслаждался своими любимыми названиями на Netflix.
CdXz5zHNQW_bbTwixEEHc.png
В Netflix изображения на платформе называются "впечатлениями" (impressions) и играют решающую роль в персонализации пользовательского опыта. Захват и обработка этих впечатлений - сложная задача, требующая сложной системы. Система отслеживает и обрабатывает миллиарды впечатлений ежедневно, сохраняя подробную историю воздействия на каждый профиль. Эта история впечатлений имеет решающее значение для улучшения персонализации, ограничения частоты показа, выделения новых релизов и аналитических данных. Первым шагом в управлении впечатлениями является создание набора данных "Источник истины" (Source-of-Truth, SOT), который поддерживает различные рабочие процессы и позволяет использовать несколько сценариев. Сырые события впечатлений собираются с клиентской стороны и обрабатываются с помощью пользовательского извлекателя событий, Apache Kafka и Apache Iceberg. Затем данные фильтруются, обогащаются и структурируются с помощью Apache Flink, что устанавливает определенный источник истины для данных о впечатлениях Netflix. Система обеспечивает высокое качество впечатлений, собирая подробные метрики и оповещая команду о потенциальных проблемах. Архитектура разработана для обработки огромного объема событий впечатлений в реальном времени, с упором на масштабируемость, гибкость и высокую доступность. Будущая работа включает в себя решение проблемы несхематизированных событий, автоматизацию настройки производительности и улучшение оповещений о качестве данных.
Чтобы обеспечить бесперебойный запуск названий и их обнаружение на Netflix, важно сделать шаг назад и понять более широкий контекст, прежде чем приступить к поиску решений. Такой вдумчивый подход создает устойчивость и масштабируемость для будущего. Первым шагом является понимание общей картины путем определения заинтересованных сторон, картографирования текущего ландшафта, уточнения основной проблемы и оценки бизнес-приоритетов. Основными заинтересованными сторонами являются операторы запуска названий, инженеры персонализации, менеджеры продукта и творческие представители.Картографирование текущего ландшафта показало, что не существует установленного решения для наблюдаемости запуска названий, что представляет как проблемы, так и возможности. Основная проблема заключалась в том, чтобы обеспечить справедливое отношение к каждому названию со стороны персонализации. Для решения этой проблемы была введена общая концепция "Здоровье названия", охватывающая различные метрики и индикаторы, отражающие производительность названия в плане обнаружения и вовлечения пользователей.Здоровье названия предоставило основу для мониторинга и оптимизации жизненного цикла каждого названия, позволяя согласовывать принципы и требования с партнерами до создания решений. Чтобы разработать прочный план наблюдаемости запуска названий, проблемы были категоризированы в три основные области: настройка названия, системы персонализации и алгоритмы. Категоризируя проблемы, можно систематически решать проблемы и предоставлять надежный, персонализированный опыт для каждого названия.Анализ проблем показал, что проблемы настройки являются наиболее распространенными, но также самыми легкими для исправления, в то время как проблемы алгоритмов редки, но трудны для решения. Оценка вариантов привела к решению сосредоточиться на проактивном обнаружении проблем, выявлении проблем до запуска для обеспечения более гладких запусков, лучшего опыта пользователей и более сильной надежности системы. Это решение заложило основу для масштабируемой, прочной системы, которая может расти вместе с сложностями постоянно развивающейся платформы.
CdXz5zHNQW_aUcN7HOcn2.png