AWS Machine Learning Blog на русском
Подписаться
SageMaker Inference теперь поддерживает Multi-Instance GPU для максимального использования GPU для конечных точек моделей.
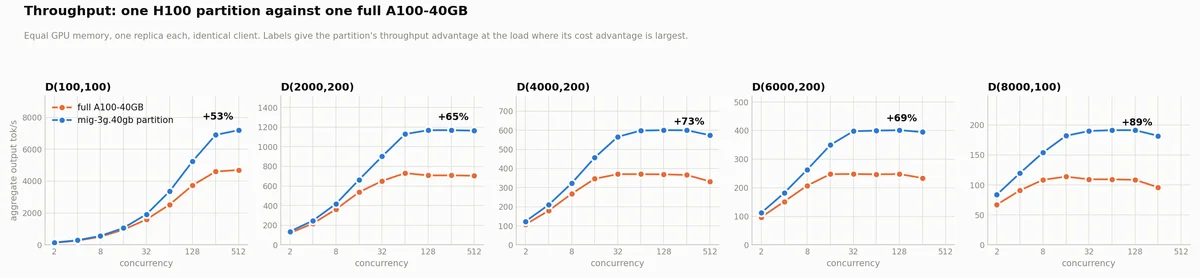
Amazon SageMaker Inference теперь поддерживает разделение GPU с помощью NVIDIA Multi-Instance GPU (MIG), которая разделяет один GPU на аппаратно изолированные разделы, позволяя запускать разные модели в каждом или использовать подходящую часть нового ускорителя. В этой статье показано, как два необязательных поля API размещают одну модель на раздел, и что мы измерили по сравнению с целым старым GPU.