AWS Big Data Blog на русском
Подписаться
Создайте динамическое потоковое озеро данных с помощью Apache Iceberg и Apache Flink
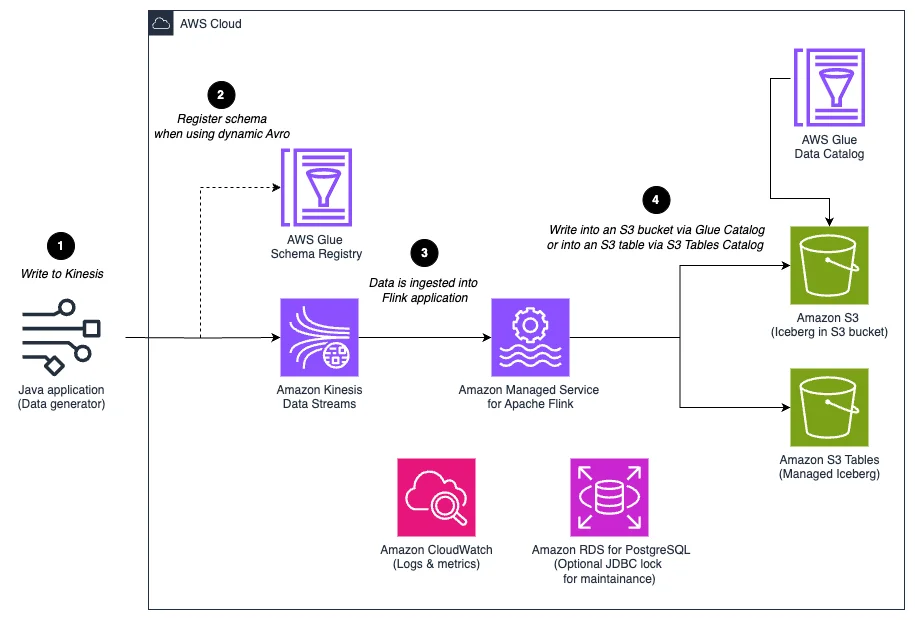
Узнайте, как построить динамическое озеро потоковых данных на Amazon Managed Service for Apache Flink, которое адаптируется к новым типам событий и изменениям схемы без остановки конвейера, используя Dynamic Iceberg Sink Apache Iceberg для маршрутизации таблиц по записям и автоматической эволюции схемы.