AWS Big Data Blog на русском
Подписаться
Ускорение запросов Spark с помощью материализованных представлений Iceberg
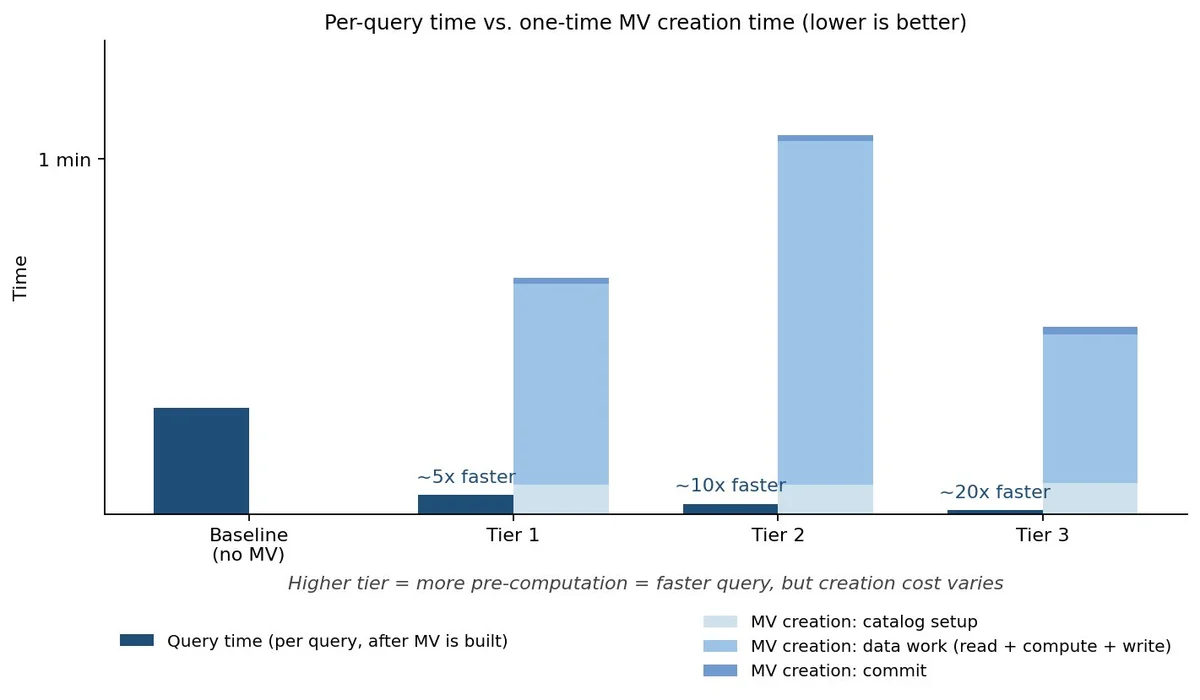
Ускорьте медленные, повторяющиеся аналитические запросы Apache Spark к таблицам Apache Iceberg без переписывания SQL. В этой статье показано, как автоматическое переписывание запросов в Amazon EMR и AWS Glue использует материализованные представления Iceberg в AWS Glue Data Catalog для прозрачной подстановки соответствующих планов запросов, а также как проектировать материализованные представления для максимального ускорения.