RSS DEV-Gemeinschaft
Folgen
Integrieren von Vision-Sprach-Modellen in agentenbasierte RAG-Systeme mit ColPali
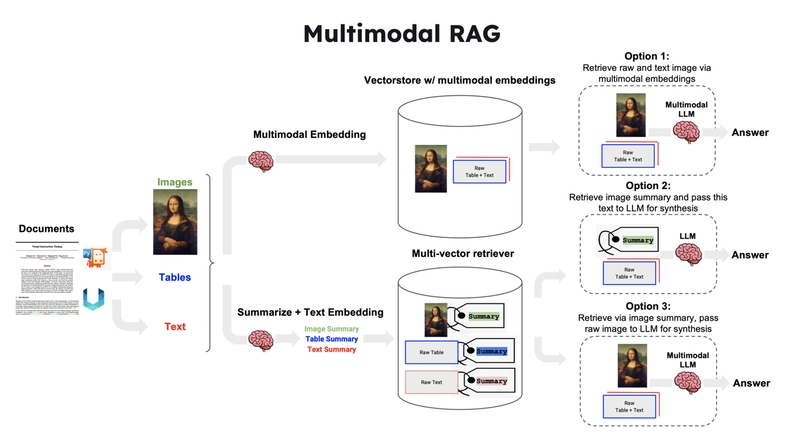
Dieses Tutorial erklärt, wie man eine Retrieval-Augmented-Generation- (RAG-) Pipeline mit einem vision-basierten Modell namens ColPali aufbaut, das die Herausforderungen traditioneller RAG-Systeme bei multimodalen Daten löst. Traditionelle RAG-Systeme haben Schwierigkeiten mit Dokumenten, die Bilder und Tabellen enthalten, weil sie die Daten fragmentieren und den Kontext verlieren. ColPali verarbeitet im Gegensatz zu traditionellen Methoden ganze Dokumentseiten visuell, wodurch räumliche Beziehungen und Kontext durch die Verwendung von Vision-Language-Modellen (VLMs) erhalten bleiben. Das System teilt Dokumente in Patches auf, generiert Embeddings mit VLMs und berechnet Ähnlichkeitsscores zwischen Abfragen und Dokument-Patches. Es verwendet Komponenten wie Bild-Encoder, Text-Encoder und LLMs, um sowohl visuelle als auch textuelle Daten zu verstehen, wodurch reiche Embeddings für effizientes Retrieval erstellt werden. Das Tutorial behandelt auch die Berechnung der ColBERT-Bewertungsmatrix, um die Top-K relevanten Seiten für die Antwortgenerierung zu rangieren und auszuwählen. Es integriert CrewAI, um einen kollaborativen agentischen Workflow zu erstellen, bei dem spezialisierte KI-Agenten das Retrieval, die Vernunft und die Antwortgenerierung übernehmen. Die Einrichtung umfasst das Installieren notwendiger Bibliotheken und das Laden des ColPali-Modells von Hugging Face, wobei GPU oder MPS für effizientes Verarbeiten verwendet werden. Das Tutorial verwendet ein Wissenschaftsbuch der Klasse X von NCERT als Beispiel-Datensatz. Schließlich betont das Tutorial die praktische Implementierung dieses Systems mit Python.