DEV Community 日本語
フォロー
AIモデル評価:テストと検証のためのベストプラクティス
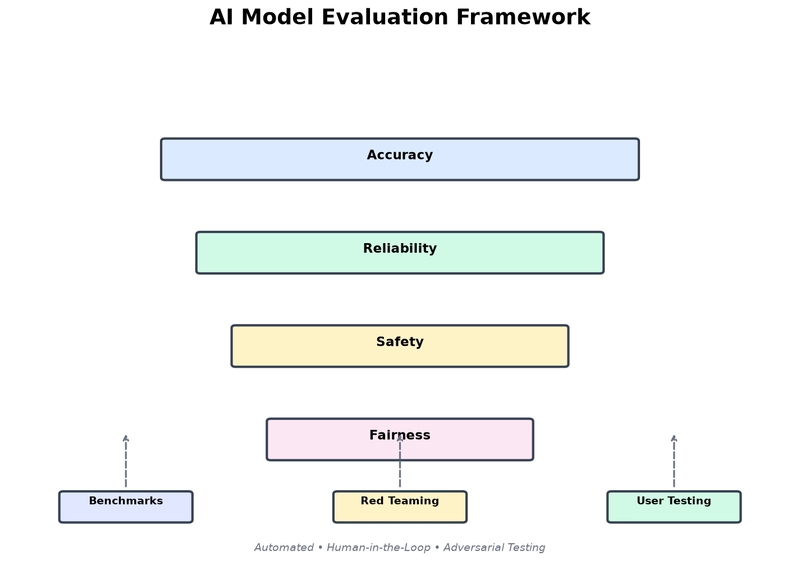
AIモデルの評価は、その品質、安全性、信頼性を確保するために不可欠です。これにより、間違い、バイアス、予期せぬ動作を特定することができます。主な利点には、品質の検証、バイアスの検出、安全性の確保、実世界のパフォーマンスの測定が含まれます。堅牢な評価フレームワークには、知識のためのMMLUやコード生成のためのHumanEvalのような標準化されたベンチマークが含まれます。レッドチーミングは、セキュリティの脆弱性、潜在的なジェイルブレイク、堅牢性の問題を明らかにするための敵対的テストを伴います。ユーザーテストは、A/Bテストやアンケートなどの方法を通じて、重要な実世界のフィードバックを収集します。重要な評価指標には、精度、レイテンシ、公平性、堅牢性、安全性があります。ベストプラクティスは、多次元テスト、継続的な評価、人間のレビューの組み込みを強調しています。評価結果の文書化と共有は、改善と集合的な学習にとって不可欠です。MLflow(実験追跡用)やDeepEval(評価用)など、さまざまなツールとフレームワークがこのプロセスをサポートしています。AI評価の未来は、自動化されたレッドチーミングやリアルタイム監視のような、より洗練された方法へと向かっています。最終的に、モデル評価は単一のイベントではなく、継続的で多面的なプロセスです。