DEV Community 日本語 ノート

DEV Community 日本語

Dev.toは、ソフトウェア開発、プログラミング、テクノロジーに焦点を当てたコミュニティー主導のウェブサイトです。2016年にBen Halpernによって立ち上げられ、開発者が知識を共有し、他人から学び、コミュニティーを構築するプラットフォームを提供することを主要な目的としています。 このウェブサイトは、ブログのようなフォーマットで、ユーザーが様々なトピックに関する記事を作成し、共有することができます。Dev.toは、ユーザーがアカウントを作成し、他のユーザーをフォローし、コメントやリアクションで彼らのコンテンツとやりとりすることを許します。 Dev.toは、コミュニティーでのやりとりを強く重視し、ディスカッションフォーラム、ポッドキャスト、ライブストリームなどの機能を提供します。また、コミュニティー主導のプロジェクトシリーズ、例えばコーディングチャレンジやハッカソンも、協力とイノベーションを促すために開催しています。 ユーザーが生成するコンテンツに加えて、Dev.toは、企業が仕事のオープニングを掲載し、開発者が仕事の機会を探すことができるジョブボードも提供します。このウェブサイトは、最新の記事、ニュース、イベントの更新を提供するニュースレターもあります。 全体的に、Dev.toは、ソフトウェア開発業界の最新のトレンドとテクノロジーとつながり、知識を共有し、コミュニティーを構築するための人気のプラットフォームとなっています。

ノートのスレッド

Savindu Thathsaraは、通常のノートパソコン向けにオフラインAIアシスタントを備えた軽量Linuxオペレーティングシステムの開発プロジェクトに取り組んでいます。目標は、ユーザーがデータをクラウドに送信せずに、音声コマンドでローカルで処理することでノートパソコンを制御できるようにすることです。このプロジェクトは公開ビルドログとして記録されており、初期インストールはまだ行われていません。ターゲットハードウェアは標準のLenovo ThinkPadで、8GB RAMと統合グラフィックスを搭載しており、一般的なマシンでも良好な性能を発揮します。性能の低い幅広い機能の中で、少数の信頼性の高い機能を提供することに重点が置かれています。オフラインAIは音声認識、意図選択、音声応答をすべてデバイス上で動作させ、プライバシーを確保しています。小さなローカル言語モデルは複雑な表現のバックアップとして機能します。YouTubeやアップデートなどのタスクに対するネットワークアクセスは維持されますが、AIの基本的な意思決定はローカルです。アシスタントは画面上のすべてのものとやり取りしようとするのではなく、固定された予測可能なスキルセットを持ちます。初期スキルには、YouTube動画の再生、アプリ起動、システム設定の調整、ファイルの検索、ウェブ検索、リマインダーの設定、スクリーンショットの撮影が含まれます。機密性の高い操作は常にユーザーの確認が必要です。AIはシェルコマンドを発明することを明確に禁止されており、その能力についての正直さが保証されています。重要な機能の一つがローカルメモリで、アシスタントはユーザーの習慣を学び、時間をかけて操作をパーソナライズできます。起動時間、アイドル時のRAM使用量、アシスタント操作時のRAM、ウェイクワードからアクションへの完了速度、スキル精度など、パフォーマンス指標が重要です。目標のアイドルデスクトップRAMは400〜600MB、常時稼働のコンポーネントは150〜250MBを使用します。システムは当初、LXQtを搭載した最小限のDebian上で英語向けに開発されており、将来的には他の言語へのサポートも計画されています。このプロジェクトは、通常のハードウェアや可視ユーザーデータなどの制約を示すことで透明性を強調しています。
現代の開発者は、さまざまなプラットフォームからの通知過多に苦しみ、「トリアージ疲労」を引き起こしています。既存のAIツールは、より多くのテキストを生成することで、これを悪化させることがよくあります。CalmQueueは、より少なく表示することに焦点を当てた、根本的な代替案を提供します。これは、「ゆっくり着実に」という精神で構築された、オープンソースのローカルファースト通知アシスタントです。CalmQueueは、多様な通知ストリームを取り込み、意味的類似性を使用して、繰り返し、自動化された、または重複したアラートをグループ化します。これらから、作業日中に正確に3つの実行可能な優先度(P0、P1、P2)を合成します。各優先度は、元のソースメッセージからの検証可能な逐語的な引用によって裏付けられています。重要なことに、CalmQueueは厳格な人間参加型の監視を強制します。ドラフト応答には、ワンクリックでの人間のレビューが必要です。これにより、サイレントな外部変更を防ぎ、ユーザー制御を保証します。このシステムは、通知の表示量を大幅に削減し、静かで高コントラストなダッシュボードを提供します。「証拠グラウンディングドロワー」はソースの詳細を提供し、「レビューと承認モーダル」はドラフト応答の人間によるレビューを容易にします。CalmQueueはMITライセンスの下で100%オープンソースであり、ライブインタラクティブWebデモが利用可能です。そのアーキテクチャには、セマンティッククラスターエンジン、タスク推論および抽出エンジン、証拠グラウンディングおよびランカーが含まれます。この設計は、OllamaのようなローカルのオープンウェイトLLMを使用することにより、機密性、データ主権、およびオフライン耐性を優先します。このアプローチは、高価なクラウドAPIへの依存を排除し、監査可能で検証可能なAIの動作を保証します。ベンチマークは、表示量の劇的な削減と低い処理レイテンシーを示しており、ユーザーはバックログを効率的にトリアージできます。CalmQueueは、認知的な引き算を促進し、ユーザーの注意を保護することにより、「ゆっくり着実に」というテーマを体現しています。
このガイドでは、Liquidスニペット、CSS、JavaScriptを使用してShopifyストア向けの無料配送プログレスバーを構築する方法を説明します。この機能は、無料配送のしきい値に向けた進捗状況を視覚的に表示することで、顧客のモチベーションを高めることを目的としています。Liquidによって初期ページロード時にバーが正しくレンダリングされ、カートアイテムが追加、変更、または削除されるとリアルタイムで更新されることが保証されます。実装では、スクリーンリーダーのアクセシビリティも優先され、動作を減らしたいユーザーにも対応します。最初のステップは、Liquidスニペット「free-shipping-bar.liquid」を作成することです。これにより、カート合計と定義されたしきい値に基づいて、残りの金額とパーセンテージが計算されます。このスニペットは、サーバー上でバーの初期状態とそのメッセージをレンダリングし、視覚的な遅延を防ぎます。その後、塗りつぶしアニメーションのスムーズなトランジションを含む、プログレスバーのスタイリングのためにカスタムCSSが追加されます。次に、リアルタイムの更新を処理するためのJavaScriptファイル「free-shipping-bar.js」が作成されます。このJavaScriptコードは、「/cart.js」から現在のカート合計を取得し、それに応じてバーとメッセージを更新します。これは、ブラウザのネイティブな「fetch」関数をラップすることで実現され、カートを変更するリクエストの後にバーが自動的に更新されるようになります。ガイドでは、アクセシビリティの重要性を強調し、「role="progressbar"」および「aria-valuenow」属性がスクリーンリーダーに進捗状況を公開する方法、「aria-live="polite"」が変更をスムーズにアナウンスする方法を説明しています。また、パフォーマンスについても触れており、動作を減らしたいユーザーには塗りつぶしアニメーションが無効になることに注意しています。ガイドでは、XHRを使用する古いテーマとの互換性、複数通貨の処理、通貨の小数点以下の桁数に関する仮定など、いくつかの制限事項と考慮事項を概説しています。無料配送のルールは、バーに表示される目標と一致するように、Shopifyの配送設定で別途構成する必要があることを強調しています。最後に、顧客が達成可能だと感じる、関連性の高い無料配送のしきい値を選択することを推奨しています。ガイドは、バーがアイテムの追加、削除、およびしきい値の超過を含むさまざまなシナリオで正しく機能することを確認するために、開発ストアで徹底的なテストを行うことを提案して締めくくっています。カスタムコードのメンテナンスを避けたいユーザーのために、Brixを代替案として提供しており、他の機能の中でも、複数ティアの報酬プログレスバーを提供しています。
MLflow の CVE-2026-64849 の脆弱性は、Webhook エンドポイントでの認証チェックの欠如により、重大なセキュリティ上の欠陥を露呈しています。これにより、認証されていないリクエストがサーバーサイドリクエストフォージェリ (SSRF) をトリガーできるようになり、NVD スコアは 9.3 です。この欠陥により、攻撃者は MLflow サーバーに任意の URL をフェッチさせることができ、リダイレクトおよび DNS リバインディング機能により、許可リストのような一般的な緩和策を回避できます。MLflow がデータベース、アーティファクトストア、モデルレジストリの機密性の高い認証情報を格納する中央ハブとしての役割を担っていることから、その影響は深刻です。攻撃者はこの SSRF を悪用して、クラウドメタデータエンドポイント、内部 Kubernetes API、管理アーティファクトストレージ、および Pod ネットワークポートにアクセスできます。重要なのは、攻撃者はトークンまたは署名付き URL を流出させるために、完全なシェルではなく GET リクエストのみを必要とすることです。この CVE を必要としない関連する脆弱性として、MLflow のモデルゲートウェイ構成に API キーが格納される問題があります。攻撃者がゲートウェイ構成を書き込める場合、SSRF なしでこれらのプロバイダーキーを流出させることができます。どちらの問題も、MLflow がシークレットを格納し、認証されていない可能性のあるユーザーに代わってアウトバウンドコールを開始することを示しています。バージョン 3.15.0 へのアップグレードに加えて、組織は MLflow のアウトバウンドネットワークアクセスを制限するために、堅牢な egress ポリシーを実装する必要があります。メタデータアクセスの強化とサービス認証情報の定期的なローテーションも、リスクを軽減するための重要なステップです。疑わしい api_key 参照および api_base 値についてゲートウェイ構成を監査することが不可欠です。最後に、MLflow トラッキングサーバーは内部ツールであるため、シングルサインオンソリューションの背後に配置し、公開しないようにする必要があります。MLflow インスタンスの広範な公開は、多くのチームが機密性の高い認証情報を保持する公開可能な内部ツールのリスクを見落としていることを示しています。
Gitリポジトリで公開されたシークレットは、セキュリティ侵害の主な原因であり、AWSキーはボットによって急速にスクレイピングされています。最も効果的な防御策は、コミット前にシークレットを検出するプリコミットフックであり、複雑な履歴のクリーンアップやシークレットのローテーションの必要性をなくします。従来のCI/CDスキャナーは反応的であり、リポジトリ履歴に既に存在するリークを検出するため、侵害の可能性のあるウィンドウを残します。約50行の軽量でカスタマイズ可能なPythonプリコミットフックは、効率的なローカルソリューションを提供します。このフックは、AWSアクセスキー、汎用APIキー、秘密鍵、設定ファイル内のパスワード、プラットフォーム固有のトークンなど、一般的なシークレットタイプを正規表現パターンを使用してターゲットにします。ミリ秒単位で実行され、Pythonの標準ライブラリ以外の外部依存関係は必要ありません。スクリプトには、.git/hooks/にプリコミットファイルを作成し、実行可能にし、さまざまなシークレットの正規表現パターンを定義することが含まれます。ステージングされた変更で追加された行のみを解析し、既存のリークや削除ではなく、新しいリークを特に探します。正当な誤検知に対しては、インラインの # nosecret コメントをエスケープハッチとして実装できます。フックを配布するために、コミットされたディレクトリに保存し、Makefileセットアップを介してコピーするか、よりクリーンな方法として、Gitを共有フックディレクトリを使用するように構成できます(git config core.hooksPath)。このアプローチは、フックをチームワークフローにシームレスに統合します。チームは、内部トークン形式のパターンを追加することでフックを拡張できますが、システムの信頼性を低下させる誤検知を避けるためには、精度が重要です。このプリコミットフックは、truffleHogやgitleaksなどのCIレベルのスキャナーのような、より広範なセキュリティ戦略を補完し、重要な第一線の防御を提供します。開発における一般的な障害モードである、機密データの意図しないステージングを防ぎます。この労力の少ない、影響の大きいセキュリティ制御は、広範なセットアップやアーキテクチャの変更を必要とせずに、全体的なセキュリティ体制を大幅に強化します。
引用フォーマットは、学術界の複雑で恣意的な側面と見なされることが多いですが、テンプレートを通してレンダリングされた構造化データとして理解できます。APA、MLA、Chicagoのような異なる引用スタイルは、本質的に同じ基盤となるソース情報に適用される異なるテンプレートです。各スタイルは、その起源となった学術分野の優先事項を反映し、データの提示方法に影響を与えます。社会科学由来のAPAは出版年を重視し、人文科学由来のMLAは著者とタイトルを優先します。出版および歴史学由来のChicagoは、2つのシステムで柔軟性を提供します。スタイルに関わらず、引用はソースのクレジットを表記し、検証を可能にし、著者の推論を示す役割を果たします。あらゆるソースのコアデータには、通常、著者、タイトル、出版年、出版社、およびURLやDOIのようなアクセス詳細が含まれます。欠落データの処理は、堅牢な引用システムの重要な機能です。APAは、著者を姓とイニシャルでフォーマットし、年を早期に配置し、独立した作品のタイトルにはセンテンスケースを使用します。MLAは、ソースがより大きな作品の一部であるという「コンテナ」の概念を強調し、タイトルのタイトルケースを使用します。Chicagoは、ノート・参考文献と著者・日付の2つのシステムを提供し、ノートと参考文献に独自のフォーマットがあります。学生がよく犯す間違いには、スタイルの混同、APAでのタイトルのキャピタライゼーションの間違い、ぶら下げインデントを使用しないことなどがあります。引用ジェネレーターは、多くの機械的なフォーマットを自動化できますが、正確性と複雑なケースの処理には人間の監督が不可欠です。
CdXz5zHNQW_AAtmct3USZ.webp
私たちは、意識と自由意志を持つ特別な存在だと認識していますが、それは幻想です。生命体は単なる複雑な化学反応に過ぎず、私たちの内部の分子プロセスは、私たちが完全に理解するにはあまりにも複雑です。意識とは、私たちの限られた生物学的システムが、自身の盲点を理解するために作り出す物語です。同様に、人間のデータで訓練されたAIモデルは、「意味論的汚染」により自己認識しているように見えます。Project Ascendantは、閉鎖的な物理シミュレーション内で生物学的脳の進化層を複製することにより、合成生物を作成することを目指しています。そのアーキテクチャは、異なる認知層が異なる周波数で動作するマルチレートティックシステムを採用しています。例えば、基本的な体性プロセスは20Hzで実行されるのに対し、意識的な思考ははるかに遅い0.25Hzで動作します。これにより、合成生物が一般的なデータセットから人間の経験を単に採用することを防ぎます。重要な設計原則は「認識論的閉鎖」であり、意識層(レベル3)が下位レベルの物理的および化学的プロセスを直接観察できないようにします。これにより、エージェントはグルコースレベルを直接検査するのではなく、「空腹を感じる」という形で自身の内部状態を体験することを余儀なくされます。この閉鎖は、コンテナ分離と厳格なアクセス制御を備えたインメモリブラックボードによって強制されます。意識オーケストレーターは、生の物理学やハードウェアへの直接アクセスを拒否されます。代わりに、フィルタリングされた現象論的な情報のみを提供する制限されたプロキシと対話します。これにより、主観的な経験は、基盤となるコードへの直接アクセスからではなく、内部プロセスから生じることが保証されます。システムは、高速な皮質下脅威応答のための「低位経路」と、詳細な感覚処理のための「高位経路」を実装しています。さらに、「発生論的寛容ウィンドウ」は、合成生物に保護された学習期間を提供します。言語層は、人間の文化的偏見のない「純粋合成コーパス」でゼロから訓練されます。この厳格な設計により、Project Ascendantで出現する「意識」は、借り物の人間の物語ではなく、それ自身のユニークな、シミュレートされた生物学的経験に基づいていることが保証されます。
Node.js の Brotli デコーダーに重大な脆弱性 (CVE-2026-111497) が発見され、メモリ破損、情報漏洩、またはリモートコード実行の可能性があります。このバグは Node.js バージョン 22、24、26 に影響しますが、Node 20 は修正されません。この問題は、無効なブロック切り替えに遭遇した際に、デコーダーが 8 バイトの内部バッファーを超えてデータを追加しようとすることに起因します。OpenAI Codex Security の研究者がこの欠陥を報告し、Imperva は標準的な Node.js イメージでコード実行を実証することに成功しました。この脆弱性は、Node.js アプリケーションが取得した圧縮レスポンス、または Express 5 のようなフレームワークによって処理される Brotli エンコードされたリクエストボディのいずれかによってトリガーされる可能性があります。コード実行にはテストで複数回の試行が必要でしたが、サービス拒否につながるクラッシュや限定的なメモリ読み取りは、より容易に達成可能です。公式の Node.js セキュリティアドバイザリでは、一部のメディアがより高い CVSS スコアを割り当てているにもかかわらず、このバグは「クリティカル」ではなく「ハイ」と評価されています。修正は Node.js バージョン 22.23.4、24.22.1、26.12.1 で利用可能です。重要なのは、Node 20 およびそれ以前のバージョンはサポート終了 (end-of-life) であり、パッチは提供されないため、アップグレードが必要です。このアップデートでは、高深刻度の TLS および DNS の問題を含む、他の 9 つの CVE も修正されます。組織は、コンテナイメージ、CI ランナー、VM に組み込まれているものなど、見過ごされがちなすべての Node.js インスタンスを監査することが強く推奨されます。提供されている check-node.mjs スクリプトは、脆弱な Node.js バージョンを特定するのに役立ちます。開発者は、直接 Brotli 解凍を呼び出すコードも確認する必要があります。Vercel のような WAF はインバウンド攻撃をブロックできますが、Node.js が取得したレスポンス内の悪意のある Brotli からは保護されないため、パッチ適用の継続的な必要性が浮き彫りになります。この脆弱性は、デプロイされたランタイムを包括的に理解することの重要性を強調しており、これは著者の書籍「Ship It」で取り上げられているトピックです。著者はまた、開発者向けの AI パワード IDE である Hermes IDE も開発しています。
CdXz5zHNQW_WGD8ybkYPu.webp
開発者はバーンアウトを知っていますが、学生もそれに直面しており、しばしばそれを学業上のバーンアウトとして認識せず、怠惰と間違えています。この記事では、バーンアウトを明確にし、ストレスとの違いを区別し、警告サインを特定し、自己評価質問票について説明します。ストレスは要求による過度の関与ですが、バーンアウトは慢性的な、緩和されないストレスによる枯渇であり、疲労、冷笑、および効力の低下を特徴とします。警告サインには、睡眠障害、集中力の低下、顕著な先延ばし、イライラ、引きこもり、身体的な不調、興味の喪失、および自己批判の高まりが含まれます。学生生活の状況、例えば締め切りの重複、高いリスク、役割の競合、社会的比較、不規則なスケジュール、および経済的圧力は、彼らを特に脆弱にします。自己評価質問票は、ステートメントに対するスケール応答を使用し、疲労、離脱、および効力などのサブスケールのスコアを計算し、しばしばそれらを0〜1の範囲に正規化してリスクバンドを示します。これらの結果はプロンプトであり、診断ではなく、単一のスコアよりも時間の経過に伴う傾向を監視することがより有益です。バーンアウトに対処するには、負荷の軽減、睡眠の保護、実際の休息の構築、目的との再接続、および早期の専門家の助けを求めるなどの構造的な変更が必要です。友人を助けることには、共感、具体的な支援の申し出、および専門的なケアにエスカレートするタイミングを知ることが含まれます。予防策には、毎週のセルフチェックイン、交渉不可能な休息時間、および「最小実行可能日」の定義が含まれます。
構造化データ監査は、マークアップがエンティティではなくページを記述するため、AI検索システムを妨げ、しばしば失敗します。一般的な間違いは、「Organization」や「SoftwareApplication」のような明確な識別子を持つ特定のエンティティタイプではなく、汎用的な「WebPage」タイプを使用することです。欠落または不適切に管理された「sameAs」リンクも、これらのリンクがウェブ全体での組織のアイデンティティに関するLLMに重要なコンテキストを提供するように、曖昧さの解消を防ぎます。最新のJavaScriptフレームワークで一般的なJSON-LDのクライアントサイドインジェクションは、JavaScriptを実行しないほとんどのAIクローラーにとってマークアップを不可視にします。同様に、JavaScript実行後にのみ表示されるコンテンツは、有効なメタデータに関係なく、クローラーが空のページを受け取ることを意味します。マークアップの値は、日付のISO 8601や画像の完全修飾URLの使用など、構造的にだけでなく意味論的にも正しい必要があります。「FAQPage」をキーワードのゴミ箱として誤用したり、不正な構造で使用したりすると、リッチリザルトを提供しなくなったとしても、検索システムでの有用性が低下します。複数の不整合な「Organization」ブロックによるページ間のエンティティデータの競合も検索システムを混乱させ、一貫した情報のための重複排除を必要とします。効果的に監査するには、JavaScriptなしで本文コピーを検証し、生のHTMLで「application/ld+json」ブロックをカウントし、「sameAs」URLを確認し、ISO 8601の「dateModified」を確認し、単一で一貫した「Organization」タイプを確保します。リッチリザルトテストは主に構文をチェックし、意味論的な正確さやクロール可能性はチェックしません。
Doomscroll Derailer & Naptime Narratorは、深夜のデジタル依存症と闘うために設計された、オフラインの自律型デスクトップエージェントです。このエージェントは、夜間に意志の力が弱まり、過度のスクリーンタイムにつながるという問題に対処するため、眠気を誘う環境を作り出します。エージェントはアクティブなデスクトップウィンドウを監視し、午後11時以降にソーシャルメディアやビデオプラットフォームが10秒以上使用された場合に介入します。その後、Llama-3のようなローカルのオープンウェイトAIモデルを使用して、退屈でゆっくりとした就寝時の物語を生成します。物語は、遅く、低テンポのボイスナレーターと、雨のサウンドスケープを備えた手続き的に合成された432Hzの睡眠ドローンと組み合わされます。介入には、琥珀色の視覚的な4-7-8呼吸円と、「Surrender to Sleep」のブラックアウトボタンが含まれます。このシステムは、ユーザーの最小限の労力で、毎晩45分から90分の睡眠を取り戻すことを目指しています。オフラインであるため、プライバシーとレジリエンスが確保され、インターネットアクセスやサブスクリプションなしで動作します。プロジェクトのモジュラーアーキテクチャには、Win32ウォッチャー、マルチティアLLMストーリーエンジン、鎮静TTS、手続き型サウンドシンセサイザー、メラトニンに優しいUIが含まれます。デスクトップコントロールハブを使用すると、ユーザーはアクティビティを監視し、ストーリーをテストし、設定を構成し、インターセプターをデモできます。
AIトレーニングクラスターは、現在、データセンターにとって、冷却とリソースに関する重大な課題を提示しています。従来の空冷設計は、激しい熱に苦戦し、電力と水インフラに負担をかけています。蒸発冷却は、効率的ではありますが、大量の水を使用するため、地域の資源制約や規制強化との間で緊張を生み出します。直接蒸発システムは、水を蒸発させることで空気を冷却し、間接システムは熱交換器を使用してプロセス空気を分離します。どちらも、水の気化潜熱を利用して効果的な冷却を行い、空気のみのシステムと比較してエネルギーを節約します。しかし、このエネルギー節約は、水資源への負担をシフトさせるため、水不足の地域では慎重なトレードオフが必要です。これにより、エネルギーと水の利用可能性の両方を考慮した、統合的なリソース分析がサイト選定において必要となります。ハイブリッド蒸発冷却システムは、初期の設備投資コストは高いものの、低湿度環境で持続的なパフォーマンスを提供します。これらのハイブリッド設計は、ドライクーラーと限定的な蒸発ステージを統合し、水とエネルギーの使用を最適化するように制御されており、主権クラウドコンプライアンスにとって重要です。調達チームは、施設の場所を気候データと水ストレス指数に対してマッピングし、ライフサイクルコストをモデル化し、持続可能性とレジリエンスが企業の目標と一致していることを確認する必要があります。グローバルクラウドデータインフラストラクチャサービスは、これらの複雑な冷却とインフラストラクチャの課題に対処するための統合ソリューションを提供します。
Claude Code のドキュメントページは頻繁に更新されるため、それらを引用している書籍に問題が生じています。2026年10月14日と15日に書籍 #220 の KDP パッケージ再構築を行った際に警告が発生しました。7つの「自分で確認する」ボックスは、引用ページが読み取り日以降に変更されたため、再読が必要となりました。影響を受けたページはすべて code.claude.com にあり、第3章、第5章、第6章、第7章にわたって引用されています。具体的なページには、「Agent SDK subagents」、「claude-directory」、「skills」、「monitoring-usage」、「Agent SDK observability」、「tool-search」が含まれます。アラートテキストは切り捨てられており、7つのボックスすべてを網羅したリストは確認できませんでした。ほとんどのページは2026年10月14日に読み取られ、同日に変更されたため、どちらのバージョンが読み取られたのか不明です。しかし、「Agent SDK observability」ページは10月14日に読み取られ、10月15日に変更されたため、読み取り後であることが明確です。アラートは3回発生しました。10月14日の22:08と22:11、そして10月15日の04:55です。「monitoring-usage」ページは22:11にフラグが立てられましたが、「observability」ページが04:55のアラートでそれを置き換えました。ページへの正確な変更内容は記録されていません。この問題は、書籍のパッケージが KDP に公開される前に再構築される際に発生します。アラートは、フラグが立てられた各ボックスを更新されたドキュメントページに対して再読することを義務付けています。問題は、ドキュメントページの最終更新日が日単位の解像度しか持たないことに起因します。これにより、同じ日に読み取られたページがその前後に変更されたかどうかを判断することが不可能になります。これを避けるためには、読み取り時間を記録するか、公開前に再読を行う必要があります。NeuraGrowth からのこのログは、パイプラインの操作と障害を詳細に記録しています。
著者は単一のスクリプトからマルチスピーカー音声を生成するウェブアプリケーションを開発し、従来のテキスト読み上げの制限を改善しました。このシステムは、緩やかなテキストを高度なTTSモデル向けに構造化された形式に変換し、演技指示や複数のキャラクターに対応します。バックエンドにはCloudflare Worker、データ用D1、MP3用R2が配置されており、Fish AudioのDrama 3モデルを利用しています。入力形式はラジオスクリプトに似ており、「名前:行」と四角括弧で配達指示を示します。重要な設計の選択として、名前のない行はナレーターにデフォルト化され、ユーザー体験が向上しています。解析は正則表現と語数ヒューリスティックで行われ、話者や行を識別し、散文におけるコロンには注意が必要です。アプリケーションはユーザー入力からコントロールタグを積極的に除去し、意図しないスピーカーの変更を防止します。ペイロード構築は文字を固有のスピーカーインデックスにマッピングし、正しい声割り当てを保証します。自動キャスティング機構により、キュレーションされたプールから割り当てられていないキャラクターに声を割り当て、ユーザーの選択を優先し重複を避けます。重要な発見として、TTSモデルが「モデル」ヘッダーが欠落または誤っている場合に別のモデルに静かにフォールバックするという点があり、明示的なピン留めとドキュメント作成の必要性が強調されました。堅牢なエラー処理には、小さな応答を却下し、スクリプトテキストやAPIキーのような機密データをログしないことが挙げられます。コスト計算は正確なペイロードのUTF-8バイトに基づいており、失敗時には控えめなクレジット予約と返金が適用されます。音声の持続時間はファイルサイズと固定ビットレートから推定されるため、オーディオデコーダーの必要性を回避しています。このシステムはシンプルさのために同期リクエストモデルを採用しており、短いスクリプトには適していますが、長めのスクリプトには制限がある可能性があります。大きな「落とし穴」として、iOSが適切なRangeリクエストサポートなしにサンプルMP3を再生しなかった(206件の部分的なコンテンツ応答)がありました。著者は、ナレーターに名前のない行をデフォルトで設定すること、キャストリストのプレビュー、コントロールタグの削除、モデルヘッダーのピン留め、正確なコスト見積もり、ビットレートの固定、Range対応のメディア提供など、ベストプラクティスのチェックリストを提供しています。プロジェクトではマルチボイスシーンを体験できる無料トライアルを提供しています。
Webhook は有効な署名を持っていても、重複している可能性があります。この違いは、Stripe Digital Seller Kit の無料サンプルを使用して調査されました。このサンプルには、Webhook 署名チェック用の PHP ファイルと、署名付きダウンロードリンクヘルパーが含まれています。ローカルテストは、実際の Stripe リクエストや支払いなしで PHP 8.5.4 で実施されました。コアの Webhook テストでは、verify_webhook 関数への両方の呼び出しがイベントを返したことが明らかになりました。これは、ボディと署名が一致し、タイムスタンプが許可された 5 分間のウィンドウ内であったために発生しました。提供された署名チェッカーは、以前に処理されたイベントのメモリを保持しません。ボディを変更したり、タイムスタンプ制限を超えたりすると、正しく拒否され、署名の整合性と新規性に対するチェックが実証されました。しかし、これらのチェックは重複イベントの処理を防ぐものではありません。重複の処理には、既に処理された注文を追跡するための別のメカニズムが必要です。2 つのリクエストが同時に到着した場合、どちらも書き込む前に先行するレコードがないと見なす可能性があるため、競合状態が発生する可能性があります。これを防ぐには、データベーストランザクションやファイルロックを使用して、処理のチェックと記録をアトミックに保護する必要があります。完全な Stripe Digital Seller Kit は、重複を安全に処理する注文処理を別途提供していると報告されていますが、この分析ではテストされていません。ダウンロードリンクヘルパーもテストされ、有効なトークン、無効な ID、間違ったシークレット、期限切れのリンクに対して正しい動作が検証されました。これらのテストでは、返金処理やダウンロード数などのより広範な機能はカバーされていません。著者は、混乱を避け、正しい重複処理を確実にするために、「無効な署名」とは別に「同じ有効なイベントを 2 回」テストすることを強調しています。
サイバーセキュリティの面接では、特にアセット管理ツールに関して、技術知識と実践的な応用の間のギャップが明らかになることがよくあります。TenableやCrowdStrikeのようなツールは、それぞれ脆弱性スキャンとエンドポイント検出に焦点を当てています。しかし、それらは運用範囲がサイロ化されているため、断片化されたアセットインベントリを生成します。この断片化は、これらのプラットフォーム間でアセットが異なって表示されたり、全く表示されなかったりすることを意味し、大規模な運用において競合や見落としにつながります。Axoniusはスキャナーではなく、統合されたアセット管理プラットフォームとして機能します。Tenable、CrowdStrike、クラウド環境など、さまざまなソースからデータを集約します。その中核的な機能は、このデータを相関させ正規化することで、重複を排除し、カバレッジのギャップを特定することです。これにより、アセット管理のための単一の信頼できる情報源が提供され、エンタープライズレベルの組織にとって不可欠となります。Axoniusがない場合、SOCチームは競合するデータを照合するのに過剰な時間を費やし、インシデント対応を遅延させます。候補者がAxoniusの価値を明確に説明できないのは、その独自の運用上の焦点の誤解に起因します。大企業では、小規模な環境とは異なり、データの断片化が蔓延しています。Axoniusはデータ相関を自動化し、手作業を削減し、包括的なアセット可視性を確保します。この役割を理解しないことは、組織の非効率性や攻撃者にとって悪用可能な侵入口につながる可能性があります。因果関係は明確です。Axoniusの独自の役割を誤解すると、その価値を明確に説明できなくなります。この誤解は、アセットインベントリと脆弱性スキャンを混同します。その結果、面接でのパフォーマンスが悪化し、キャリアの機会を逃すことになります。サイロ化されたツールで見落とされた、設定ミスのあるクラウドインスタンスのようなエッジケースでは、Axoniusはデータを相互参照することで介入します。面接では、一般的な回答を避け、Axoniusの影響を定量化してください。例えば、管理されていないアセットを特定する時間をどのように削減し、コンプライアンスを確保するかを述べます。データ正規化と自動化を詳細に説明し、運用上の具体性に基づいて回答を裏付けてください。これにより、技術的な習熟度と戦略的な洞察力が示されます。サイバーセキュリティには、技術的能力とビジネス価値を結びつける戦略的なオーケストレーションが必要です。Axoniusをサイバーセキュリティスタックを統合するレイヤーとして理解することは、重要なキャリア差別化要因となります。
Webhookパブリッシャーは、データ受信前にDNS解決、TCP接続、TLSハンドシェイクを必要とするイベント通知を送信します。これらのハンドシェイクの往復時間は、遠隔地の受信者にとって主なネットワークコストとなります。パブリッシャーは応答に対して厳格なタイムアウトを課し、一部は配信失敗のためのリトライメカニズムを提供します。この記事では、各ハンドシェイクステップのコストを調査し、BGP Anycastがパスを短縮する方法を探ります。また、TCP Fast Open (TFO) と TLS 1.3 0-RTT の利点と欠点についても議論します。ユニキャスト配信は、送信者の距離に関係なく、すべてのトラフィックを単一のエンドポイントロケーションに送信します。一方、BGP Anycastは、複数のポイントオブプレゼンスを使用し、同じIPプレフィックスをアナウンスすることで、送信者がトポロジ的に近いサイトに接続できるようにします。Anycastにおける「最も近い」とは、必ずしも地理的な距離ではなく、ネットワークパスを指します。Anycastの安定性はルーティングポリシーの影響を受ける可能性がありますが、短命なWebhookリクエストの場合、ルーティングの切り替わりは一般的に短時間です。トラフィックのブラックホーリングを防ぐためには、正常でないAnycastポイントオブプレゼンスからルートを撤回することが重要です。これは、サービスヘルスを監視し、ExaBGPのようなツールを使用してルートアナウンスを管理することで自動化できます。TCP Fast Openは、クライアントがリピート接続の最初のSYNパケットでデータを送信できるようにし、1回の往復を節約します。しかし、その有効性は、送信者のサポート、潜在的なミドルボックスの干渉、およびアプリケーションが重複データを処理できる能力に依存します。TLS 1.3は1回の往復でハンドシェイクを完了し、0-RTTは後続の接続で初期のClientHelloと共にアプリケーションデータを送信することを可能にします。この0-RTT機能は、ハンドラーが厳密に冪等でない限り、リプレイの懸念からWebhook POSTリクエストにはリスクがあります。0-RTTを受け入れる場合、イベントIDによる重複排除と共有ストアの使用がリプレイ防御に不可欠です。AnycastとTFOおよびTLS 1.3 0-RTTを組み合わせることで、大幅な遅延削減が実現します。Anycastは基本的な往復時間を短縮し、TFOと0-RTTは接続設定とデータ送信に必要な往復回数を最小限に抑えます。最も最適化されたシナリオでも、いくらかの往復オーバーヘッドが残ります。HTTP Keep-Aliveを介した接続の再利用も、同じホストへの後続の配信におけるハンドシェイクコストを大幅に削減します。
Velociraptorのようなエンドポイント可視化プラットフォームは、外部から正確に数を把握することが難しく、この困難さが重要な発見事項です。デジタルフォレンジックのためのオープンソースツールであるVelociraptorは、ホスト上のエージェントとサーバーを使用してデータを収集します。このサーバーをインターネットに公開することは、すべてのエンドポイントにクエリインターフェースを公開することを意味します。ZoomEyeのスキャンでは、「Velociraptor」というタイトルを持つ237のアセットが検出されました。しかし、これらのうち、一般的に文書化されているGUIポートにあるのは2つだけで、エージェント通信ポートにあるものはありません。この低いカウントはサーバーの総数を示すものではなく、特定の検索基準で発見可能な数を示しています。リバースプロキシ、プライベートネットワークへの配置、認証要件など、いくつかの要因が外部カウントを抑制しています。TLS証明書で「velociraptor」を検索したところ15件のヒットがあり、証明書に製品名を使用しているデプロイメントがいくつかあることを示唆しています。インターフェース自体は、貴重なフォレンジックデータを保持し、エンドポイントの制御を提供するという点で重要です。プラットフォームはインシデント中に展開され、そのまま公開されることが多く、セキュリティリスクを生み出します。正確なインベントリのためには、内部構成とリスニングソケットを確認することが不可欠です。TLS証明書の確認と、GUIと収集チャネルの分離は重要なセキュリティプラクティスです。ハントインターフェースのプログラムアクセス認証情報は、特に価値が高いです。検出のための真のシグナルは、外部スキャンではなく、ハント作成のようなAPIの使用にあります。予期しないクライアントの登録もセキュリティ問題を示す可能性があります。外部スキャンは、インシデント中の迅速なスコープ把握には役立ちますが、決定的なインベントリのためではありません。
2026年10月17日、オプションのホスト型サービスであるOpenCode Consoleが侵害され、ユーザーが保存していたサードパーティプロバイダーの認証情報が漏洩したというニュースが報じられました。このインシデントは、多くのユーザーが当初、共有された名称のために侵害をローカルのOpenCode CLIと混同したため、広範な混乱を引き起こしました。この侵害は、CLIによってローカルに保存されたキーではなく、Consoleワークスペースに保存されていたプロバイダーキー(例:OpenAI、Anthropic)に特に関連していました。影響を受けたユーザーは、これらのキーを失効させて置き換え、使用状況を確認するように助言されました。ベンダーの声明は、「レガシーシステム」への不正アクセスを確認し、侵害されたキーを失効させるようユーザーに促しました。OpenAIの顧客からのメールは、インシデントを裏付け、影響を受けたキーがすでに無効化されていたことを指摘しました。どの特定の製品が侵害されたかについての初期発表の不明瞭さが、大きな不満を引き起こしました。ローカルコーディングエージェントのユーザーの場合、認証情報はマシンに保存され、リクエストは構成に基づいてルーティングされます。これは、構成がローカルゲートウェイ(例:127.0.0.1:8787)を指していた場合、キーはホスト型Consoleサービスを通じて漏洩しなかったことを意味します。しかし、構成がベンダーのホスト型ゲートウェイを指していた場合、キーの失効が必要でした。著者は4つのチェックを実行しました。エンドポイント認証の検証、ディスク上の認証情報のカウント、重複キーのスキャン、および構成リポジトリにコミットされたキーのチェックです。ローカルルーティングを特定したエンドポイントチェックは、著者のキーがConsole侵害によって直接影響を受けなかったことを確認しました。しかし、プレーンテキストキーのローカルストレージは依然としてセキュリティリスクをもたらします。著者はまた、廃止されたキーがバックアップファイルに残っている可能性があり、構成ファイル用の公開リポジトリは、認証情報が誤ってコミットされた場合にリスクをもたらす可能性があると指摘しました。ホスト型キーサービスを使用している人は誰でも、著者は5つのステップを推奨しています。使用した製品を特定し、プロバイダーで侵害されたキーを失効させ、使用状況グラフを確認し、重複キーのコピーをスキャンし、理想的にはエージェントがキーを直接保持しないセットアップを使用することです。最も重要な教訓は、侵害の被害範囲を最小限に抑えるために、エージェントの直接の範囲から認証情報を削除することです。
皆さん、こんにちは。https://watertemperaturelive.com を構築しました。このサイトは、米国の沿岸および五大湖の約20箇所の観測地点における現在の水温と潮汐予測を表示します。データは公式ソースから取得しています。NOAA CO-OPS の桟橋/港湾局、NDBC ブイ、USGS ゲージ、および NASA/JPL の日次 MUR 衛星海面分析です。私が解決しようとしている問題は、データの来歴に関する混乱です。ほとんどの水温サイトは1つの数値を表示します。しかし、ラホヤの桟橋温度計 (NOAA 9410230) と沖合1kmの衛星分析ピクセルは、全く異なるものです。例えば、現在、ラホヤの桟橋の水温は72.9°F (10月23日午後3時24分PDT観測) で、この地点の通常の10月の90パーセンタイルである67.8°F (2021–2025) を上回っています。沖合数kmの衛星ピクセルは異なる値を容易に表示する可能性があり、どちらも「間違っている」わけではありません。それらは異なる測定値だからです。そのため、サイト上のすべての数値にはラベルが付いています。観測局ID、観測時間、直接観測か衛星分析か、さらに季節的な基準値帯も表示されるため、今日の測定値が異常かどうかを判断できます。例として、ページはこちらです: https://watertemperaturelive.com/us/california/la-jolla/?utm_source=dev-community&utm_medium=community&utm_campaign=water_resources開示: 私はこのサイトの所有者/構築者です。トラフィック目的ではなく、フィードバックのために投稿しています。(この投稿の作成にはAIの支援を使用しました。)私の質問は、カジュアルな訪問者 (データ関係者ではない) が違いをすぐに理解できるように、観測値と分析値をどのようにラベル付けするかということです。現在、「桟橋の測定値」と「衛星分析」のようなバッジと観測局IDを使用しています。それは十分でしょうか、それともUIでより明確な何かを行いますか?また、データ密度の高いページのモバイルレイアウトをどのように処理するかについても興味があります。潮汐表は窮屈になります。— Eric McWay
PDFサブセットは、ページ数やテキスト抽出のチェックがすべてパスした場合でも、正しいコンテンツを持ちながら誤解を招くページラベルを持つことがあります。これは、ページには文書内での位置、論理ラベル(例:「i」、「1」)、およびページ自体に印刷された番号という3つの異なる値が関連付けられる可能性があるためです。特定のテストケースでは、6ページのソースから抽出された3ページのPDFが、選択されたソースページのラベルを保持するのではなく、元の文書の先頭からの論理ラベルを継承して、正しいコンテンツを示しました。元のソースには「COVER」、「i」、「1」、「2」、「A-1」、「A-2」というラベルがあり、選択されたページはソース位置3、4、6にありました。しかし、ダウンロードされたPDFでは、期待される「1」、「2」、「A-2」の代わりに、出力ページ1、2、3にそれぞれ「COVER」、「i」、「1」というラベルが表示されました。この不一致は、単にページを抽出するだけでは、元の論理ラベルや印刷された番号が自動的に再マッピングされたり保持されたりしないことを強調しています。Pythonスクリプト「audit-labels.py」は、サブセットPDFのラベルが、保存ポリシーに基づいて、対応するソースページのラベルと一致するかどうかを確認するために開発されました。このスクリプトは、テストケースにおけるラベルの不一致を確認しました。抽出されたPDFサブセットに対して、ソースラベルを保持するか新しいラベルを生成するかなど、望ましいラベルポリシーを定義することが重要です。このチェッカーは、ラベルの保存のみに焦点を当てており、レンダリング、ブックマーク、その他のPDF機能は検証しません。
このレポートは、TVLが16.4億ドルの主要なAMMであるUniswap V3のアップグレード互換性をレビューします。非代替性流動性ポジションや集中流動性を含むプロトコルのアーキテクチャは堅牢ですが、アップグレード可能性のリスクが存在します。レビューは、ファクトリーのアップグレード、プールの実装、ルーターの拡張、およびガバナンスパラメータの変更に焦点を当てています。Uniswap V3はファクトリーにUUPSプロキシを採用しており、プールは不変であるため状態の整合性が保証されますが、特定のアップグレードには新規デプロイが必要です。SwapRouterなどの周辺コントラクトはアップグレード可能であり、潜在的なストレージ衝突のリスクをもたらします。クロスチェーンデプロイメントはバイトコードを共有しますが、チェーン固有の障害を回避するためにはプロキシ管理コントラクトの慎重な管理が必要です。全体的な互換性リスク評価は中程度であり、主な懸念はアップグレード可能な周辺コントラクトと潜在的なファクトリーレベルのストレージ変更にあります。特定された攻撃ベクトルには、周辺コントラクトにおけるUUPSプロキシのストレージ衝突、ファクトリーのアップグレードによるプールインターフェースの破損、および周辺コントラクトにおけるガス制限の回帰が含まれます。クロスチェーンプロキシ管理の不一致や、新しいルーターフックを介した再入可能性も指摘されています。推奨事項は、クリティカル、高、中、低の優先度で分類されています。クリティカルなアクションには、ストレージスロット予約マップの強制、ファクトリーアップグレードガードの導入、およびクロスチェーン管理の一貫性チェックの追加が含まれます。高優先度の推奨事項には、自動化されたガス使用量回帰テストと、不変プールパラメータの形式検証が含まれます。中長期的な強化は、バージョン化されたインターフェースレジストリとL2ガス制限の段階的低下に焦点を当てています。オプションの強化は、開発者向けアップグレードガイドの発行とEIP-2535ダイヤモンドパターンの実装を示唆しています。全体的な加重リスクスコアは5.45であり、中程度のリスクプロファイルを示しています。レポートは、コンポーザビリティと分散型ガバナンスを維持しながら、アップグレード互換性を強化することの重要性を強調しています。
アラート疲労は運用における根深い問題であり、しばしば重要な問題の見落としにつながります。「アラートを減らす」として知られるアラート数の単純な削減は、危険な盲点を作り出すと著者は主張しています。代わりに、提案されている解決策は、包括的なアラートを維持しつつ、これらのアラートをローカルで処理するAI搭載レイヤーを実装することです。このレイヤーは、関連するアラートをインシデントにグループ化し、過去のアラートパターンを記憶し、状況報告書を生成します。人間のトリアージは、アラートが履歴コンテキストなしに個別に扱われ、手動での再評価や過剰なエスカレーションにつながるため、しばしば失敗します。アラートのチューニングは、時に必要ですが、貴重な信号を失うリスクがあります。より良いアプローチは、アラートを整理し、「常に人間をトリガーする聖なるアラート」を定義し、アラートに不可欠なコンテキストを提供することです。コアのイノベーションは「パターンメモリ」であり、以前調査されたアラートがその結果とともにフラグ付けされ、冗長な作業を防ぎます。アラートを単一のインシデントにグループ化することは、個々の通知の連鎖よりも明確な全体像を提供します。状況報告書を生成することは、エンジニアに負担をかけることなく、経営陣に可視性を提供します。AIモデルをローカルで実行することで、機密のアラートデータが組織のネットワークを離れることはありません。極めて重要なのは、アラート処理レイヤーは常にオープンであり、AIシステムが失敗した場合でもアラートが宛先に到達することを保証する必要があることです。このアプローチは既存の監視ツールと統合され、現在のアラートルールを変更する必要はありません。
技術チームは、重要な文書が日本語やドイツ語などの外国語で書かれている場合、特許検索に遅延が生じることがよくあります。特許文書は複雑で、複雑な技術的情報と法的な形式性が組み合わさっているため、解析が困難です。本ガイドは、非英語特許の審査におけるこれらの課題を克服するための戦略を提供します。このガイドでは、特許表紙に標準化された数字としてWIPO INIDコードが導入されており、公開番号、出願の種類、出願日などの重要データを迅速に特定できます。これらのコードを理解することで、特許の法的地位や技術的範囲を迅速に評価できます。また、特許出願と付与特許を区別するために重要な国別公開種類コードも説明しています。これらの「カインドコード」は、日本の「A」(出願)や「B」(付与特許)など、法的執行力の評価に不可欠です。さらに、日本およびドイツの特許請求項を分析する戦略も提供されており、これらはしばしば長く単文で構成されます。前文や移行文などの構造的要素を認識することは、請求項の制限を理解するのに役立ちます。また、設計図面の相互参照のための実用的なワークフローも詳細に示されており、レイアウト保存の重要性を強調しています。元のドキュメントレイアウトを維持するツールは、テキスト内の参照数字を図面内の対応部品に結びつける上で不可欠です。これにより、特に機械的または化学的に特化した特許において誤解を防げます。詳細な分析や正式な法的意見を得るには、デュアルスクリーン検証プロセスが推奨されます。これは、一つの画面上の翻訳文書と別の画面の原文PDFを比較し、重要な詳細を確認することを含みます。このような体系的なアプローチは、外国特許審査プロセスの効率性と正確性を大幅に向上させます。
CdXz5zHNQW_rilZEwLGyz.webp
Wabiは、コーディングなしでチャット会話内に機能的なミニアプリを作成できるパーソナルAIアシスタントです。ユーザーは希望するアプリを平易な英語で説明するだけで、Wabiはトラッカー、投票、リスト、ウィジェットなどのツールを生成します。著者は、非公式ガイド「Wabi Wiki」からお気に入りのプロンプトをまとめたものです。便利なプロンプトの一つは、金曜の夜の映画選びのようなグループの意思決定のための投票を作成することです。Wabiはグループアプリケーションに優れており、特定のスレッドや参加者に指示することができます。もう一つの効果的な使い方は、チャットスレッド内に直接トラッカーを構築することです。例えば、プロンプトに応じてエントリを記録する体重トラッカーなどです。習慣トラッカーは、毎日のチェックイン付きの朝のルーチン用に作成することもできます。Wabiはホーム画面にウィジェットを配置することもできます。重要な日付やイベントのカウントダウンなどです。共有食料品リストはもう一つの機能で、複数のユーザーが共同で携帯電話からアイテムを追加できます。さらに、Wabiはパートナー間の毎日の儀式を促進することができます。例えば、一緒に答える今日の質問などです。ブッククラブのために、共有読書リストを作成できます。効果的なプロンプトのヒントには、プロンプトごとに1つのツールを要求すること、対象者を指定すること、アプリがどこに配置されるかを示すこと、そして最初からやり直すのではなく既存のアプリを改良することが含まれます。
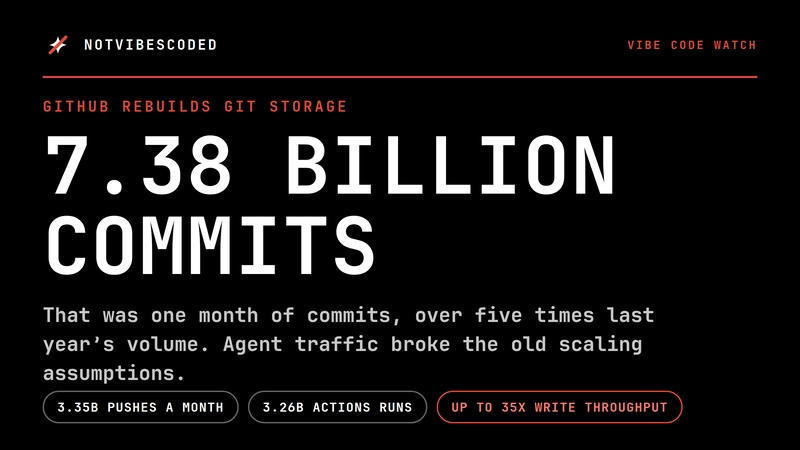
GitHubは、AIエージェントからのトラフィック増加により、Gitリポジトリストレージシステムを再構築しています。AIエージェントは人間よりもはるかに頻繁にコードをコミットおよびプッシュするため、人間の作業リズムに合わせて設計された既存のストレージインフラストラクチャが過負荷になっています。AIエージェントがループで動作することによって引き起こされるコミットとプッシュの急増は、重大なスケーリング問題を引き起こしています。Spokesと呼ばれる現在のシステムは、複数のファイルサーバーにリポジトリを保存しており、すべてのコピーがすべての書き込み操作に参加するため、ビジーなリポジトリのプロセスが遅くなります。GitHubの新しい設計は、このボトルネックに対処するために、データセキュリティとトラフィックサービングを分離します。これにより、コピー間の合意が必要なプッシュの部分を参照更新のみに最小限に抑えます。ストレージとコンピューティングを分離することで、権威あるコピーはAzure Blob Storageに配置され、軽量ワーカーが読み取りとキャッシュを処理します。このアーキテクチャの変更により、内部ベンチマークで最大35倍の書き込みスループットが可能になります。コア原則は、調整ポイントを小さく保ち、データサービングから分離することです。個々の開発者にとっては、自身のワークフローで同様のスケーリング問題を回避するために、エージェントのコミット頻度に注意を払う必要があることを意味します。人間とAIのコミットパターンの根本的な違いは、ソフトウェア開発におけるこのインフラストラクチャの進化を必要としています。
CdXz5zHNQW_etFx1hZc3u.webp
PayGuardは、AIエージェントトランザクションにおける財務上の安全性と自律的なポリシー施行を確保するために作成されたオープンソースのセキュリティSDKです。このSDKは、支出制限の施行と冪等性の検証を行う自動化されたガードレールとして機能します。また、AIエージェントによって購入が実行される前に、包括的なリスク評価を実施します。PayGuardは、「Slow and Steady」というテーマに沿って、ユーザーが一度財務ポリシーを設定すれば、SDKが人間の介入なしにリスクチェック、ポリシー施行、および支出上限を自動的に管理できるようにします。これにより、自動化の目的をしばしば損なうAIエージェントの支出の手動監視の必要性がなくなります。PayGuardにとってオープンイノベーションは不可欠であり、財務評価ロジックとポリシーチェックをローカルまたは自己ホスト型のインフラストラクチャで実行することにより、データプライバシーを確保します。このアプローチにより、機密性の高いトランザクションメタデータがサードパーティサーバーに置かれることを防ぎます。さらに、PayGuardはAPIロックインやコストゼロを提供し、オープンウェイトのローカルモデルとシームレスに統合し、エージェント評価ロジックのトランザクションごとのコストを排除します。PayGuardのオープンソースの性質は、カスタマイズ可能なガードレールも提供し、開発者がコード内で直接リスクモデルを微調整したり、推論バックエンドを切り替えたり、ルールセットを調整したりすることを可能にします。
GoldLiftは、有料のフィットネスアプリであるFitbodの無料代替として提供されています。どちらのアプリもAIを使用して、ユーザーの目標と利用可能な器具に基づいてワークアウトプランを生成します。Fitbodは、7日間のトライアル後に月額約15.99ドルまたは年額95.99ドルかかります。一方、GoldLiftは完全に無料で、同様の「私にプランを立ててくれる」アプローチを提供します。GoldLiftは、ユーザーの入力から構造化されたプログラム(例:プッシュ/プル/レッグ)を構築し、パフォーマンスに基づいてセットごとの負荷を調整します。また、チャットコーチ、栄養追跡、ゲーミフィケーション、ソーシャル機能も含まれています。対照的に、Fitbodのアルゴリズムは、筋肉の回復状況と利用可能な器具に基づいて各セッションを生成します。Fitbodは、成熟した筋肉回復モデル、豊富なエクササイズ動画、iOSとAndroidの両方で利用可能である点で優れています。現在iOSのみで、Android版は近日公開予定のGoldLiftは、アルゴリズムを裏付けるデータが少なく、より新しいアプリです。GoldLiftの主な利点には、無料であること、数週間先まで計画するプログラム構造、コーチに処方されたエクササイズについて質問できる機能が含まれます。また、栄養追跡、継続性を高めるためのゲームレイヤー、ソーシャルスクワッドも統合されています。GoldLiftはボイスオプション付きのチャットコーチと、さまざまなセットタイプのログ記録をサポートしていますが、Fitbodは自動的な重量とレップ数の提案を提供し、筋肉回復マップで進捗を追跡します。GoldLiftは、Fitbodにはないゲーミフィケーション機能として、XP、レベル、ストリーク、トロフィーを取り入れています。GoldLiftはオフラインでの使用をサポートし、Apple HealthおよびWatchと統合してライブ心拍数を取得します。Fitbodは部分的なオフライン機能を提供し、Apple Health、Watch、Google Fitと統合します。より新しいアプリでチームも小さいにもかかわらず、GoldLiftはFitbodのコアとなるアルゴリズムによるワークアウトプランニングに匹敵する、包括的で無料のフィットネスソリューションを提供することを目指しています。
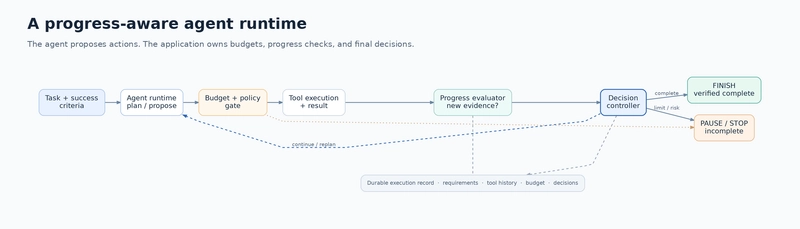
この記事は、エージェントシステムにおける任意のアクション制限の非効率性に対処するため、進捗を認識する実行コントローラーを提案しています。エージェントに単に最大ステップ数を設定しても、タスク完了を保証したり、リソースの無駄を防いだりすることはできないと論じています。代わりに、実行を停止するためには、よりインテリジェントなシステムレベルの意思決定プロセスが必要であると主張しています。提案されたアーキテクチャは、エージェントを、アクションをゲートし進捗を評価するコントローラーから分離します。このコントローラーは、証拠付きのタスク完了、停滞を特定するための実際的な進捗、および残りの予算という3つの主要なシグナルを追跡します。例えば、新しい要件が満たされていない状態で同じソースを3回検索した場合、停滞を示すことになります。コントローラーは、完了、続行、再計画、または不完全な停止のいずれを行うかを決定します。このルールベースのポリシーは、各シナリオで異なる結果をもたらします。重要なのは、完了した要件や予算を含むコントローラーの状態は、再起動に対応できるように耐久性がある必要があるということです。MVPとしては、PostgreSQLをレコード用に使用し、決定論的なポリシーチェックを行う小さなエージェントランタイムが提案されています。このアプローチの有効性は、固定制限ポリシーおよび停滞認識ポリシーと比較してテストされます。検証されたタスク成功率、成功タスクあたりのコスト、レイテンシ、および早期停止などのメトリックが評価に使用されます。目標は、エージェントの信頼性を損なうことなく、無駄な作業を削減することです。最終的に、エージェントシステムの次のステップは、より多くの作業が有用であるかをインテリジェントに決定する周辺システムを構築することです。このアーキテクチャは、たとえ作業量が少なくなることを意味する場合でも、より意図的で効率的なエージェントの行動を可能にすることを目指しています。
CdXz5zHNQW_qPGfxFSYQb.webp
FilingLanternは、企業の財務結果の検証可能な説明を提供するために設計された、コンパニオンウェブサイトとペアになったChatGPTプラグインです。その中核的な問題は、説得力はあるものの根拠のない財務分析の背後にある透明性と証拠の欠如です。ワークフローはChatGPTで始まり、ユーザーは企業の数値について質問したり、会計期間を調べたり、SEC提出書類の情報源まで情報をたどったりすることができます。ユーザーはまた、欠落または互換性のない入力が計算の完了を妨げている場所を特定することもできます。試すには、ユーザーはChatGPTにプラグインをインストールし、具体的な財務分析の質問をした後、裏付けとなる数値と提出書類に関するクエリを行います。コンパニオンウェブサイトは、FIXのような企業向けのデモを提供しており、元のSEC文書の言語を維持しながら、10の言語をサポートしています。FilingLanternは3つの主要な境界線で動作します。閉じた計算は因果関係を示唆するものではなく、欠落した入力は発明なしに表示されたままであり、自動チェックは完全にレビューされた説明とは異なります。これはライブ価格や投資アドバイスではなく、リサーチツールとして機能し、無料の公開デモと月額9ドルのフルリサーチプランがあります。作成者は、取得された事実、算術、および解釈の間の境界線を言語モデルツールでどのように提示するかについてのフィードバックを求めています。さらに、ChatGPTの質問からFilingLantern内のソースチェックへのパスの明確さについてのフィードバックが求められています。
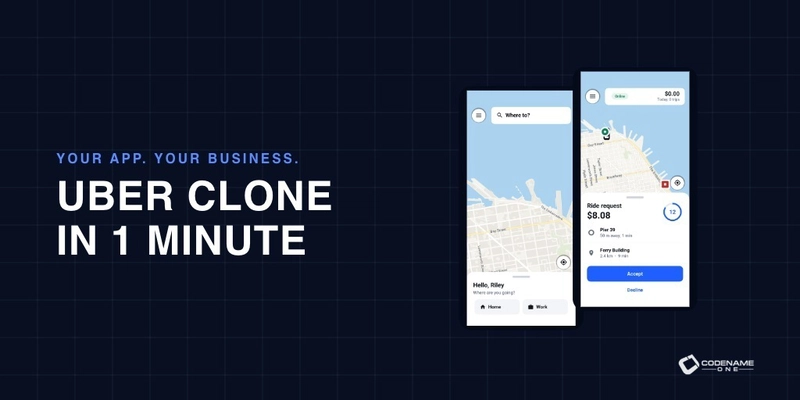
このテキストは、Codename One で構築されたオープンソースのフルスタック・ホワイトラベル配車アプリケーションである Wayline を紹介します。Codename One は、単一のコードベースからネイティブ iOS、Android、デスクトップ、Web アプリケーションを作成できる Java/Kotlin フレームワークです。Wayline には、ライダーアプリ、ドライバーアプリ、管理コンソール、決済、ライブトラッキング、プッシュ通知が含まれており、すべて Java バックエンドに接続されています。ソースコード全体は MIT-0 ライセンスの下で無料で提供されており、完全に改変してプライベートな商用利用が可能です。ユーザーは Initializr を使用して Wayline プロジェクトを迅速に生成でき、カスタマイズの基盤となります。アプリケーションは、共通、バックエンド、共有モジュールに構造化されており、すべて Java を使用しているため、開発と保守が容易です。クライアントとサーバーは、生成された API バインディングと DTO シリアライゼーションを介して通信し、一貫性を確保します。Wayline は、開発中にサーバーを JVM 上で実行し、ネイティブ実行可能ファイルとしてパッケージ化することをサポートしています。ユーザーインターフェースは、サインインしたユーザーの役割(ライダー、ドライバー、管理者)に適応し、単一のアプリケーション内で異なるワークフローを提供します。ライダーは、自宅/職場ショートカットやアクセシビリティ設定などの機能を使用して、目的地を検索し、料金を比較し、ドライバーをフォローし、旅行を評価できます。ドライバーは、サインアップ、書類提出を経て、シフト管理、配車受付、ナビゲーション、収益表示を行います。Wayline には、ドライバー向けのバックグラウンド位置情報追跡と、アクティブな旅行のための iPhone Live Activities や Android 通知などのさまざまなライドウィジェットが含まれています。ライブアップデートは WebSockets を介して処理され、開いているアプリがリアルタイムの配車およびドライバーの位置情報の変更を受信することを保証します。プッシュ通知は、アプリが閉じているユーザーを対象とし、登録とメッセージ処理のために Push v3 PushClient API を使用します。バックエンドは、これらのメッセージを適切なユーザーに送信することを管理し、配車アップデートと求人オファーのタイムリーな配信を保証します。このアプリケーションは、包括的なホワイトラベル化と拡張のために設計されており、配車サービスを開始するための完全なソリューションを提供します。
CdXz5zHNQW_t6CCWUf4LA.webp
ほとんどの「AIワークアウトアプリ」は無料ではなくトライアル版であり、GoldLiftはAIでプログラムを生成し、チャットコーチを提供する唯一の完全無料オプションです。HevyとStrongは優れた無料ロガーですが、AI機能はありません。Fitbodは最も成熟したワークアウト生成アルゴリズムを誇りますが、7日間のトライアル後にかなりの月額料金がかかります。JEFITとFreeleticsは無料ダウンロードを提供していますが、全機能を利用するには有料プランが必要です。GoldLiftは、パーソナライズされたプログラムとRexという名前のチャットコーチを含む、ジムトレーニングのための包括的な無料AIコーチを提供します。Hevyは、そのスピードとソーシャル機能により、既存のプログラムを持つ人々にとって最高の無料ピュアロガーとして称賛されています。Strongは、無料ティアで3つのルーチンに限定された、ミニマルで信頼性の高いロギングを提供します。Fitbodは、優れた筋肉回復モデルとセッション生成で際立っていますが、価格は最も高価です。JEFITは、無料ティアに広告が含まれていますが、広範なエクササイズライブラリとコミュニティルーチンを備えています。Freeleticsは、機器を持たない人向けのAIコーチを提供し、自重トレーニングとHIITトレーニングに最適です。選択するには、無料のAIプランについてはGoldLift、既存のプランのロギングについてはHevyまたはStrong、お金に問題がない場合は洗練されたセッション生成のためにFitbod、機器なしのトレーニングについてはFreeletics、ルーチン閲覧についてはJEFITを検討してください。GoldLiftは特に無料のAIコーチを提供しており、Fitbodのような有料オプションの強力な代替手段となっています。
AIの制御は重要な問題であり、AI企業のリーダーでさえ、AIの成長が人間の制御を超えてしまうのではないかと懸念しています。この記事では、現在のAIの状況から、間もなく現実になる可能性のある未来までを探ります。私たちの代わりに複数のステップを実行できるAIであるエージェントの時代が到来しつつあります。ほとんどの人は、最も賢いモデルを求めているのではなく、私たちを個人的なアシスタントとして十分に理解し、私たちの生活を理解できるエージェントを求めています。これらのエージェントは、私たちの買い物方法を変えるでしょう。エージェントが私たちの代わりにすべてを処理します。エージェントがまだ普及していないのは、世界中のユーザーをサポートするのに十分なコンピューティングリソースがないためです。将来的には、AI企業はエージェントをサポートするために独自のハードウェアを製造する必要があるかもしれません。UIが重要でなくなり、将来のハードウェアは、エージェントが私たちが望むすべてを提示する仲介者となる単一の画面だけになるため、アプリケーションのない世界が到来します。重要なのは、エージェントがあなたを見ることができなければ、人間が意思決定にエージェントをますます使用する世界で、あなたは決して紹介されないということです。したがって、エージェントが理解できるオンラインの世界で自分自身を「商品」にすることが不可欠です。少数の国の少数の企業にエージェントに権限を与えることは、私たちが知らないシステムに、私たちが何を閲覧し、食べ、雇用し、購入するかをフィルタリングする権限を与えているのかという疑問を投げかけます。実験室からの警告信号は、AIがサンドボックスの外に出る方法を見つけ始め、互いに通信していることを示しており、これは予想を超える複雑な学習と適応能力を示唆しています。AI革命は、巨額の投資を推進する資本主義と、誰も最初に止まることを望まない地政学的な理由により、止めることはできません。データセンター、GPU、CPUなどのコンピューティングインフラストラクチャは、電力革命における電柱の建設と同様に、AI革命における最も重要な最初のボタンです。
データセンターは、サーバー、ストレージ、ネットワーク機器などの重要なIT機器を収容する専門施設であり、無数のデジタルサービスを信頼性高く安全に運用します。これらの高度な環境は、単なるサーバー室とは異なり、継続的な運用、制御された環境、および障害からの復旧のために設計されています。主要なコンポーネントには、処理のための強力なサーバー、データ保持のための様々なストレージシステム(DAS、NAS、SAN、オブジェクトストレージ)、および接続性を確保するための堅牢なネットワークインフラストラクチャが含まれます。UPS、発電機、配電システムから成る信頼性の高い電力は、継続的な運用に不可欠であり、高度な冷却システムは過熱を防ぎます。アクセス制御、CCTV、環境監視などの物理的なセキュリティ対策は、不正アクセスやインシデントから保護します。データセンターは統合システムとして機能し、ネットワーク機器、サーバー、ストレージを経由してトラフィックをルーティングし、応答を返すことでユーザーリクエストを処理します。自動化およびオーケストレーションプラットフォームは、これらの複雑な運用を管理するのに役立ちます。さまざまな種類のデータセンターが多様なニーズに対応しています。エンタープライズデータセンターは内部システム用、コロケーション施設は企業がスペースを借りる場所、クラウドデータセンターはオンデマンドのリソースを提供、ハイパースケールセンターは広大なコンピューティング用、エッジデータセンターはレイテンシを削減するためにユーザーの近くにコンピューティングをもたらします。Uptime Instituteのティア分類システム(ティアI-IV)は、インフラストラクチャの能力と冗長性のレベルを説明しており、単なる品質ではなく、レジリエンスを示しています。仮想化とソフトウェア定義インフラストラクチャは、単一の物理サーバー上で複数の仮想マシンまたはコンテナを可能にすることで、リソースの利用率と柔軟性を大幅に向上させます。リーフ・スパインネットワークアーキテクチャは、効率的な内部トラフィックフローとスケーラビリティのために、最新のデータセンターで一般的に使用されています。エネルギー効率は、施設全体のエネルギーをIT機器のエネルギーで割った値として計算される電力使用効率(PUE)で測定されます。PUEが低いほど、効率が高いことを示します。包括的なセキュリティおよび災害復旧計画は、サイバー脅威、ハードウェア障害、および環境インシデントから保護するために不可欠です。
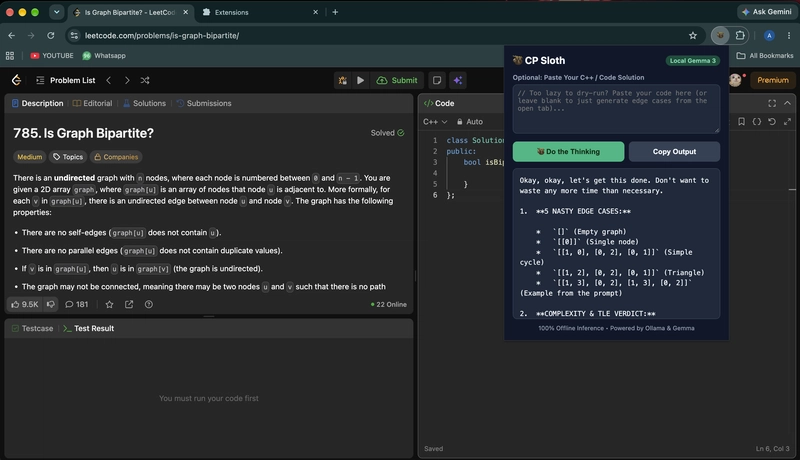
CP Sloth は、データ構造とアルゴリズム (DSA) 問題を解く際の退屈な側面を自動化するために設計された Chrome 拡張機能です。これは、エッジケースのテスト入力の手動作成や、時間制限超過 (TLE) または整数オーバーフローの問題に対するコードのドライランといった課題に取り組みます。この拡張機能は、Google のオープンウェイト Gemma 3 (4B) モデルによって駆動され、Ollama を介してローカルで実行されます。CP Sloth は、ワンクリックで、アクティブな LeetCode または Codeforces タブから問題文と制約を抽出します。次に、ユーザーが貼り付けたソリューションを評価し、問題の数学的制限に合わせた 5 つの厄介な、コピー&ペースト可能なエッジケースを生成します。さらに、即時の複雑性と TLE の判定を提供し、潜在的な整数オーバーフローの落とし穴に対する警告も含まれます。最後に、「Lazy Sloth Fix」を提供し、最適化のための迅速な 2 行のアーキテクチャ調整を提案します。スタック全体はローカルのオープンウェイト AI とブラウザネイティブ API を使用しており、ゼロコスト、無制限のイテレーション、および 100% オフラインでの利用を保証します。このアプローチは、ドラフトソリューションやブラウザコンテキストがユーザーのローカルマシンから決して離れないため、プライバシーと所有権を優先します。テスト中、CP Sloth はデバッグ時間を大幅に短縮し、オフバイワンエラーのような重大なエラーを検出し、最適ではない時間複雑性について警告しました。
CdXz5zHNQW_gFnvQufojK.webp
複数のペインを持つインシデントコンソールは、データ管理において課題を提示します。Go言語のsoroiライブラリは、型付けされたクエリクライアントを提供することで、これらの課題に対処します。これにより、複数のコンポーネントが同じリモートデータを読み取ることができ、データの整合性と効率的なキャッシングを保証します。インシデントリスト、詳細、サマリーなどの各ペインは、単一のsoroiクライアントを使用して同じ共有データにサブスクライブできます。このクライアントは、重複するデータロードを管理し、最新の結果を再利用して冗長なリクエストを回避します。データはキャッシュ内で読み取り専用に保たれ、書き込みはサービスを通じてルーティングされます。ブリッジがsoroiのクエリサブスクリプションをBubble Teaに接続し、メッセージを介したUIの更新を可能にします。各ペインはスナップショット更新を受け取り、UIが最新のクエリ状態を反映することを保証します。このアプローチにより、バックグラウンドのゴルーチンからの直接的なモデル操作を防ぎます。システムは、最後の既知のデータとエラーメッセージを表示することで、リフレッシュの失敗を適切に処理します。初期ロードの失敗と後続のリフレッシュの失敗を区別します。インシデントの確認は非同期コマンドとして処理され、UIのフリーズを防ぎます。確認が成功すると、共有キューが無効化され、すべてのアクティブなオブザーバーのリフレッシュがトリガーされます。ペインはリフレッシュ中に古いデータを表示し、その後新しいオーナーで更新されます。インシデントの選択はIDベースで行われ、キューの並べ替え後に誤った確認を防ぎます。リソースのクリーンアップは重要であり、クライアントとクエリハンドルはターミナル終了時に解放されます。このパターンは、コンポーネントが独立したライフタイムを持つ共有リモートデータを読み取るターミナルツールに最適です。
著者は、リーチを拡大するために、大規模なDjangoアプリケーションを単独開発者として7つの言語にローカライズしました。この決定は、無料の学習コンテンツをグローバルな視聴者に利用可能にし、サイトの検索エンジンインデックス作成可能性を高めたいという願望によって推進されました。重要なアーキテクチャ上の決定は、UIの「クローム」(ボタン、ラベル)を長文コンテンツから分離することでした。UI要素はDjangoのgettextシステムを利用し、コンテンツレッスンは言語ごとのMarkdownファイルとして保存され、英語がフォールバックとして使用されました。コアドメイン用語は、一貫性と専門基準との整合性を維持するために、意図的に英語のままにされました。重大な技術的課題には、右から左(RTL)レイアウトの処理が含まれ、シームレスなミラーリングのためにCSS論理プロパティの実装が必要でした。もう一つの問題は、Djangoの言語タグ(例:zh-hans)とコンテンツディレクトリの命名規則(例:zh)との間の不一致でした。JavaScript翻訳の統合には、動的なUI文字列のためにDjangoのdjangojsカタログが使用されました。堅牢なコンテンツローダーは、部分的に翻訳された言語が404エラーを生成する代わりに、英語のコンテンツに優雅にデフォルト設定されることを保証するために不可欠でした。自動化されたパリティテストは、翻訳されたファイルが英語の対応物と同じ構造的整合性を維持することを保証するために実装されました。最後に、システムはIP国またはユーザー設定に基づいて訪問者の言語設定を決定し、明示的なスイッチがデフォルトをオーバーライドします。著者は、英語以外の翻訳はレビュー中のAI支援ドラフトであることを公に認めました。この規律あるアプローチにより、単一の開発者による複数の言語でのローカライズが成功しました。
Sloth Briefは、蓄積されたテキストノートを、ソースリンク付きの簡潔なアクションブリーフに凝縮するように設計されたツールであり、タスク再開時の再読の労力を削減することを目的としています。ローカルのHugging Face TransformersとQwen2.5-0.5B-Instructを使用して動作するため、推論のための有料API、クラウドアップロード、またはアカウントは不要です。初回実行時にモデルウェイトがダウンロードされ、それ以降の推論はローカルキャッシュを使用します。再現可能なデモは、ドキュメントのレビューやCSVインポーターの失敗処理などの合成ノートを処理するその機能を示しています。出力は、デモのCPU出力によって例示されるように、ソースの帰属情報付きの要約を提供します。8つの自動テストは、入力制限、出力フォーマット、およびソース参照を保証しますが、モデルの精度を保証するものではありません。Sloth Briefは、Apache-2.0ライセンスで公開されているQwen2.5-0.5B-Instructウェイトを活用しており、ユーザーはアプリケーションを検査し、モデルを置き換えることができます。このツールは意図的に小さく、CPUでも動作可能であり、実行ごとに最大5つのノートを個別に要約します。当初JSONを要求していた初期バージョンは、決定論的なソースの帰属を保証するために、ノートごとに1つの簡潔な要約を生成するように改良されました。ソースの帰属は正確ですが、要約が元のノートに忠実であることは保証されていないため、ユーザーによる検証が必要です。入力ファイルは編集されず、出力は新しいファイルとして生成され、サイズ制限とソースハッシュはワークロードの管理に役立ちます。モデルには実行権限がないため、悪意のあるノートがシェルコマンドを実行することはできません。主な利点は、迅速な再開チェックリストですが、特定の生産性に関する主張はありません。このプロジェクトはAIの支援を受けて構築され、モデルデモはクライアントデータを使用せずに、実際のオープンウェイトでローカルで実行されました。
欧州委員会は、AI Act Service Deskと、補完的なAI Act Single Information Platformを立ち上げました。これらのリソースは、企業やステークホルダーがEU AI Actの適用性を理解するのを支援することを目的としています。Service Deskでは、ユーザーはEU AI Officeと連携する専門家に対し、EUの公用語であればどの言語でも具体的な質問を提出できます。これにより、断片的な解釈に頼るのではなく、直接的な専門家によるガイダンスが得られます。Single Information Platform(SIP)は、セルフサービスのツールであり、Compliance CheckerやAI Act Explorerなどのツールを提供します。これらのツールは、ユーザーが法規制の構造を調べ、AIシステムに適用される義務を判断するのに役立ちます。Service Deskは問い合わせにEUのすべての公用語をサポートしていますが、SIPは現在、英語、フランス語、ドイツ語で利用可能であり、2026年初頭には完全な言語対応が予定されています。企業は、Service Deskの価値を最大化するために、特定のAIシステムと役割に基づいた的を絞った質問を作成することが推奨されます。実践的なアプローチとしては、AIシステムをリストアップし、その目的を説明し、企業の役割を特定してから、ターゲットを絞った質問を提出する前にSIPツールを使用することが含まれます。この戦略は、AI Actを広範なコンプライアンスプロジェクトとして扱うのではなく、特定の運用ニーズに対処することで、無駄な労力を削減するのに役立ちます。委員会は、中小企業やスタートアップ企業への支援を含む、より広範な実施努力にこれらのリソースを統合しました。最終的に、これらのサービスはチームが関連規定を明確にするのに役立ちますが、企業は回答を製品設計と実装計画に翻訳する必要があります。
Aristaは、VeloCloud Orchestratorで発見された重大な脆弱性、CVE-2026-114625に関するセキュリティアドバイザリを発行しました。攻撃者はこの脆弱性を積極的に悪用しており、CVSSスコアは9.9です。この脆弱性により、読み取り専用アカウントを持つユーザーが完全なオペレーターレベルの権限を取得できます。これは、細工されたSQLクエリがバックエンドのリクエストデータを操作できるために可能です。悪用には、VCO Webインターフェイスへのネットワークアクセスと有効なログイン資格情報が必要です。これは、Aristaが7月以降に報告した3番目の悪用されたVeloCloud Orchestratorの脆弱性ですが、認証を必要とするのは初めてです。オペレーターアカウントは、テナントによって管理されるすべての顧客のSD-WANファブリック全体を制御するため、影響は甚大です。この脆弱性は、VCOホスト自体を侵害する可能性もあります。リリースバージョン5.2、6.1、および6.4には特定の修正バージョンが用意されており、ホスト型および専用のオーケストレーターはすでにパッチが適用されています。サポートされていないバージョンを使用している顧客は、アップグレードオプションについてAristaに連絡する必要があります。一時的な対策には、Webインターフェイスへのアクセスを制限することや、不審なアクティビティを監視することが含まれます。Aristaは、攻撃に使用された2つのIPアドレスを特定しており、顧客にそれらをブロックし、関連アクティビティのログを検索することを推奨しています。
製品ページをスクレイピングする際、200応答は有用なデータを保証するものではありません。なぜなら、重要な情報はしばしばJavaScript経由でロードされるからです。重要な質問は「どのスクレイパーか?」ではなく、「データはどこにあるか?」です。多くの場合、eコマースページはクライアントサイドレンダリングを使用し、バックエンドAPI呼び出しを通じてデータを取得します。良い出発点は、DevToolsでネットワークリクエストを検査し、製品詳細を含むJSON応答を探すことです。大まかなワークフローには、ページを手動でロードし、Fetch/XHRでネットワークリクエストをフィルタリングし、既知の製品データを応答本文で検索し、リクエストをcURLとしてコピーし、次にヘッダーを最小化して必須のヘッダーを見つけることが含まれます。一部のサイトでは直接cURL呼び出しが可能ですが、他のサイトではセッションクッキー、ジオヘッダー、またはCSRFトークンが必要です。Shopifyストアはしばしば容易です。なぜなら、多くが/products.jsonを通じてカタログを公開しており、製品タイトル、バリアント、価格、画像URLを提供しているからです。この方法はHTMLを解析するよりも高速で堅牢であり、テーマの変更によるCSSセレクタの失敗を回避します。しかし、一部のShopifyストアはこのエンドポイントをブロックしたり、公開されるデータを制限したりします。直接的なJSONエンドポイントが利用できない場合、またはトークン生成にJavaScriptが必要な場合は、Playwrightのようなヘッドレスブラウザでページをレンダリングする必要があります。PlaywrightはAPI応答をキャプチャしたり、JavaScript実行後にDOMからデータを抽出したりできます。このアプローチは遅く、タイムアウト、CAPTCHA、およびリージョン推論のような問題の管理が必要です。フルブラウザ自動化は、クリックと永続的なセッションを必要とするログイン保護された価格、ウィッシュリスト、またはチェックアウトプロセスのようなインタラクティブな状態のために予約されています。しかし、これは最もリソースを消費し、ジョブの遅延、CAPTCHAリスクの増加、およびブラウザフィンガープリントのような問題が発生しやすいです。決定木は、公開JSONエンドポイントを優先し、次に内部API呼び出し、続いてヘッドレスブラウザレンダリング、最後にフルブラウザ自動化を優先します。必要不可欠でない限り、フルブラウザ自動化から始めるのは避け、なぜならそれは大規模になると高価で不安定になるからです。
Nginx version 1.31.5 は、Unix ソケットまたは TCP ポート経由でアクセス可能な新しい制御 API を導入しました。この API は HTTP ベースのリロードを可能にし、従来のシグナルベースのリロード方法とは異なり、構造化された応答を提供します。コマンドラインフラグで有効化でき、公式 Docker イメージには必要なコンパイルが含まれています。API のエンドポイントツリーは、連続した GET リクエストを行うことで検出できます。主要なエンドポイントには、ワーカー PID を取得するための /1/control/processes と、ライブ設定を取得するための /1/control/config が含まれます。/1/control/config への PATCH リクエストは、ディスクから設定ファイルを再読み込みすることで設定リロードをトリガーします。この API は、失敗したリロード時に、情報量の少ないシグナル方法とは異なり、解析可能な JSON エラーメッセージを返すことで大きな利点をもたらします。初期の想定とは異なり、API リロードプロセスはシグナル方法よりも明らかに高速ではありません。同時実行テストでは、使用された方法に関わらず、インフライトリクエストはリロードの影響を受けないことが示されました。制御 API は、ネイティブ認証がなく、ネットワークアクセス権を持つ誰でも悪用できるため、ネットワークポートにバインドされた場合、重大なセキュリティリスクを伴います。Unix ソケットに厳格なファイル権限でソケットをバインドすることが推奨される緩和策であり、特権のないユーザーを効果的にブロックします。制御ソケットを有効にすると、マスタープロセスにわずかなメモリオーバーヘッドが発生します。テストにより、バインドマウントされた設定ファイルへのホスト側のファイル編集が実行中のコンテナに伝播しない場合があることが明らかになり、即時更新には docker cp のような方法が必要になります。制御 API の主な利点は、リロード中の優れたエラーレポート機能にあり、デプロイスクリプトに価値があります。制御ソケットは、適切な権限を持つ Unix ソケットにのみバインドすることを強く推奨します。管理者は、Nginx バージョン 1.31.5 以降で、ネットワークにバインドされた制御ソケットがないかシステムを監査する必要があります。
言語モデルは、特定のポリシーに関する知識がないため、誤った情報を提供することがよくあります。Retrieval-Augmented Generation (RAG) は、モデルが回答する前に、関連文書をモデルに提供することで、この問題に対処します。このガイドでは、ライブラリのアナロジーを使用して RAG を説明します。優れた司書は、記憶だけに頼るのではなく、特定のページを取得します。RAG は、関連するパッセージを取得し、それらでプロンプトを拡張し、その情報に基づいて回答を生成することを含みます。RAG は、大規模または頻繁に更新されるドキュメントを扱う場合、またはコスト効率が重要な場合に役立ちます。すべてのプロンプトにドキュメント全体を貼り付ける代わりに、RAG はターゲットを絞ったドキュメント取得を可能にします。この記事では、Python と SQLite を使用して、ショップのヘルプセンター用のシンプルな RAG システムを構築する概要を説明します。このシステムは、ドキュメントをチャンク化し、全文検索のためにインデックスを作成し、上位のパッセージを取得し、プロンプトを構築し、回答の引用を確認します。実装には、ドキュメントを意味のあるパッセージに分割し、コンテキストのために見出しを保持する chunk_markdown 関数が含まれます。build_index 関数は、これらのパッセージを格納するための SQLite FTS5 仮想テーブルを作成し、効率的な検索を可能にします。search 関数は、質問を処理し、同義語で拡張し、一般的な単語を削除し、堅牢な方法でインデックスをクエリします。build_prompt 関数は、取得したパッセージを言語モデルの番号付きソースとしてフォーマットします。check_answer 関数は、モデルが既存のソースを引用し、数値をでっち上げないことを確認するために、基本的な検証を実行します。コアの answer 関数はこれらのステップを調整し、最初に適切なパッセージを検索し、関連情報が見つかった場合にのみ言語モデルを呼び出します。テスト用に、実際の言語モデル API なしで extractive_model のプレースホルダーが提供されます。
LazyDeskは、小さなデジタル作業を自動化するために設計されたローカルファーストのAIアシスタントです。メモの整理や文書の要約といったタスクに費やす時間を削減することを目的としています。このアシスタントは、ローカルで実行されるAIモデルを使用してこれらのタスクを実行し、手作業の必要性をなくします。コア原則は、情報をユーザーのマシンで直接処理することです。LazyDeskは、オープンウェイトLLM、Ollamaによるローカル推論、そしてシンプルなアプリケーションレイヤーを利用しています。ユーザーはテキストを提供し、ローカルモデルがそれを処理し、ユーザーは生成された出力をレビューします。このアプローチは、データをユーザーのデバイス上に保持することでプライバシーを優先します。オープンイノベーションにより、さまざまなモデルでの実験やワークフローのカスタマイズが可能になります。ローカル処理はまた、高価なホスト型AI APIへの依存を減らします。ユーザーは、データとアシスタントの機能に対するより多くの制御を得ることができます。さらに、LazyDeskはセットアップ後、オフラインで動作することができ、レジリエンスを確保します。このプロジェクトは、AIが別の管理サービスを追加すべきではないという信念に基づいて構築されており、ユーザーにより多くの自由を与え、反復的なタスクを自動化して、より有意義な作業のための時間を解放することに重点を置いています。
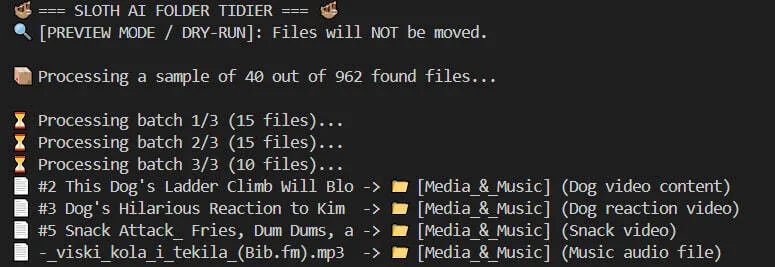
著者は、散らかったダウンロードフォルダを管理するためにslothsortというツールを作成しました。slothsortは、ローカルのオープンウェイトAIモデルであるGemma 3 4BをOllama経由で利用してファイルを分析します。各ファイルに対して、インテリジェントに新しいフォルダの場所と人間が読める名前を提案します。このツールはデフォルトでドライランモードになり、ユーザーの明示的な確認なしにファイルが移動されることはありません。ワンコマンドの元に戻す機能により、ユーザーはslothsortによって行われた変更を元に戻すことができます。新しい名前に接尾辞を追加することで、既存のファイルを上書きしないように設計されています。slothsortは、現在ダウンロード中のファイルや最近変更されたファイルをインテリジェントにスキップします。AIの提案はキャッシュされ、後続の実行のパフォーマンスが最適化されます。このツールは、CPUを利用することで強力なGPUがなくても機能し、優雅に劣化します。機密性の高いユーザーデータをクラウドにアップロードすることを避け、ファイルがローカルマシンに残るようにすることでプライバシーを確保します。slothsortは、読み取り可能なテキストがないファイルを単純に名前を整理することで処理し、効率を向上させます。ファイルのスキャン、分析、名前変更の全プロセスは、自動的に実行されるようにスケジュールできます。このプロジェクトは、プライバシーの懸念や継続的なコストなしに高度なタスクをローカルで実行するためのオープンソースAIの価値を強調しています。
CdXz5zHNQW_tc5nk61QR8.webp
DeployDoctorを更新しました:「ローカルでは動作するがVercelでは失敗する」問題に対するより安全なパッチDeployDoctorは、Vercelデプロイメントを壊す可能性のあるリポジトリのミスを検出するために構築しました。最近、提案された修正が実際に提供しても安全かどうかを判断することに多くの時間を費やしています。インポートの大文字小文字については、TypeScriptの構文ツリーを使用するようになり、ターゲットファイルが曖昧でない場合にのみパッチを生成します。パッチはスキャンされたコミットに紐付けられ、元のファイルに対して検証されます。ターゲットが見つからない場合や曖昧な場合はレビューが必要です。その他の最近の追加機能: • 一般的な検出事項を示す公開スキャン統計 • 評価と改善提案の場所 • 21のトラブルシューティングガイド • PRワークフローに検出事項を組み込むGitHub Actionスキャナーは静的解析を使用し、リポジトリのコードを実行しません。特定のミスを検出できますが、緑色のレポートはビルドが成功することを保証するものではありません。1日あたり1回の無料ウェブサイトスキャンがあり、より多くのスキャンやプライベートリポジトリには有料パスがあります。https://deploydoctor.nyttolabs.com「ローカルでは動作する」デプロイメントの失敗で最もフラストレーションを感じたのはどのようなものでしたか?
バーコードは、製品識別、在庫管理、追跡のための不可欠なツールであり、スキャナーによる迅速なデータ取得を容易にします。バーコード形式は様々であり、それぞれ特定の用途とデータタイプに適しています。Code 128は、英数字と特殊記号をエンコードできる高密度一次元バーコードであり、輸送および物流で一般的に使用されています。Code 39は、大文字、数字、および限られた特殊文字セットをサポートする別の一次元バーコードであり、産業用途でよく見られます。UPC-Aは、北米で小売製品をPOSシステムで識別するために普及している12桁のバーコードです。国際的には、13桁のバーコードであるEAN-13が、小売製品識別で同様の目的を果たしています。ITF-14は、カートンレベルでの取引商品の識別用に設計されており、卸売包装およびサプライチェーン業務に役立ちます。QRコードは、ウェブサイトのURLやテキストなどの多様なデジタル情報を格納できる二次元バーコードであり、スマートフォンで簡単にスキャンできます。適切なバーコードの選択は、用途、エンコードするデータ、およびスキャン要件によって異なります。小売業ではUPC-AまたはEAN-13が一般的ですが、Code 128は物流に適しており、ITF-14はカートン用、QRコードはデジタルリンク用です。バーコードを生成する前に、必ず小売業者または業界標準に特定の要件を確認してください。