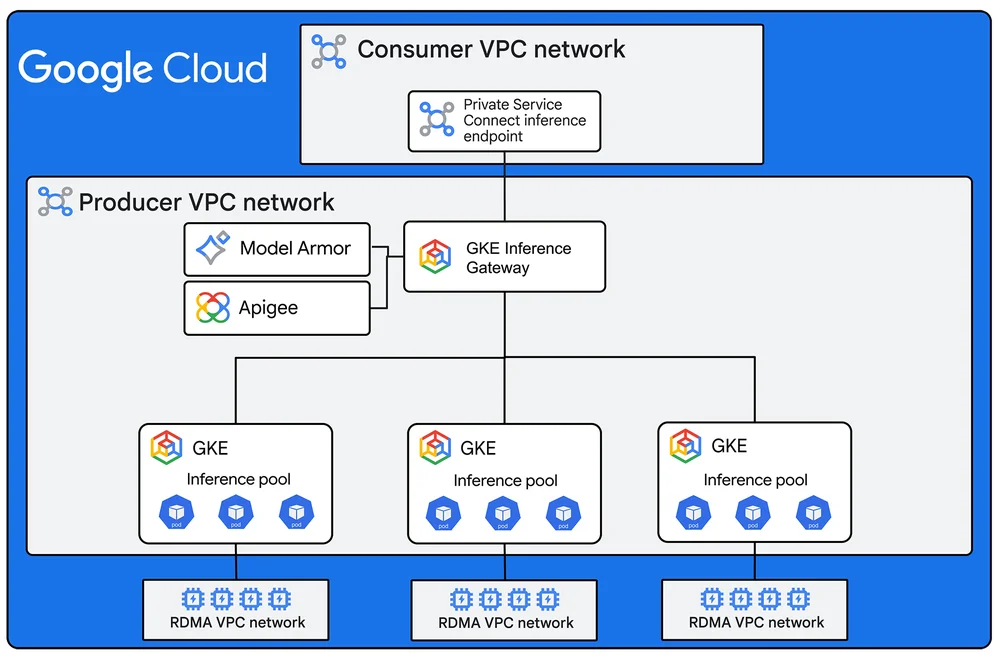
AI推論モデルサービングのためのネットワーキング - GKEのみ、およびその他のすべてのバックエンド向け
エンタープライズは、複数のAI推論モデルを実行することが多く、呼び出しの簡素化と中央集権的なガバナンスのためのアーキテクチャが必要となります。AI推論モデルサービングのネットワーキングのための2つのリファレンスアーキテクチャが提示されています。1つはGoogle Kubernetes Engine (GKE) 用、もう1つはその他のすべてのバックエンドタイプ用です。両方のアーキテクチャは、セキュリティと効率を向上させるために設計された共通のサービスを共有しています。Cloud Load BalancerまたはInference Gatewayのいずれかであるエントリポイントは、推論呼び出しのための安定したセキュアなフロントエンドを提供します。このエントリポイントは、TLS終端を処理し、API管理と統合し、サービス拡張機能で機能を拡張できます。両方の設計に共通するサービスには、コンシューマーVPCネットワーク内にエントリポイントをアンカーするためのPrivate Service Connect推論エンドポイントが含まれます。Apigee API Managementは、クライアントID検証、レート制限、クォータ強制のためのオプションサービスです。Model Armorは、プロンプトと出力をスクリーニングするインラインAIセーフティチェックポイントとして機能します。GKE固有の設計は、特殊なイングレスエンジンとして機能するGKE Inference Gatewayを利用します。このゲートウェイは、HTTPRouteルールに基づいて適切なモデルサービングターゲットにクエリをルーティングします。モデルレプリカの論理的なグループである推論プールが使用され、ゲートウェイはモデル識別子に基づいて正しいプールを選択します。モデルレプリカセットは、さまざまなノードプールにデプロイされた個々のモデルレプリカの均一なグループを表します。複数のバックエンドタイプをサービングするアーキテクチャでは、リージョナル内部Application Load Balancerが中央ルーティングプロキシとして機能します。Service Extensionとして実装されたInference Payload Processorは、受信リクエストペイロードを検査してターゲットモデル識別子を抽出します。Network Endpoint Groups (NEGs) は、この識別子に基づいて異種バックエンドへの柔軟なルーティングを提供します。