Google Cloud Blog 日本語 ノート

Google Cloud Blog 日本語

cloud.google.com/blogは、Google Cloudの公式ブログです。Google Cloudの製品とサービスのニュース、更新、洞察、クラウドコンピューティング業界のトレンドとイノベーションに関する情報を提供します。 このブログは、Google Cloudの専門家、エンジニア、思想リーダーが書いた記事で構成されており、人工知能、機械学習、データアナリティクス、セキュリティなど、広範囲のトピックをカバーしています。記事はしばしば技術的なチュートリアル、ケーススタディ、ベストプラクティスを含むため、Google Cloudを使用する開発者、ITプロフェッショナル、ビジネスリーダーにとって非常に有益なリソースです。 ブログは、トピック、製品、業界別にカテゴリー化されており、最新の記事を閲覧、特定のトピックを検索、RSSフィードにサブスクライブして最新のニュースと更新を追跡することができます。 ブログの主要な特徴として、以下のようなものがあります。 - Google Cloudの製品とサービスの詳細な記事、例えばGoogle Cloud Platform、Google Cloud Storage、Google Cloud AI Platform - Google Cloudサービスの使用に関する技術的なチュートリアルとガイド - Google Cloud顧客のケーススタディと成功事例 - 業界のトレンドとイノベーションに関する洞察と分析 - Google Cloudのパートナーシップと協力に関するニュースと更新 - Google Cloudの専門家と思想リーダーのインタビュー 総のところ、Google Cloudのブログは、クラウドコンピューティング、人工知能、関連技術に興味がある誰にとっても有益なリソースです。

ノートのスレッド

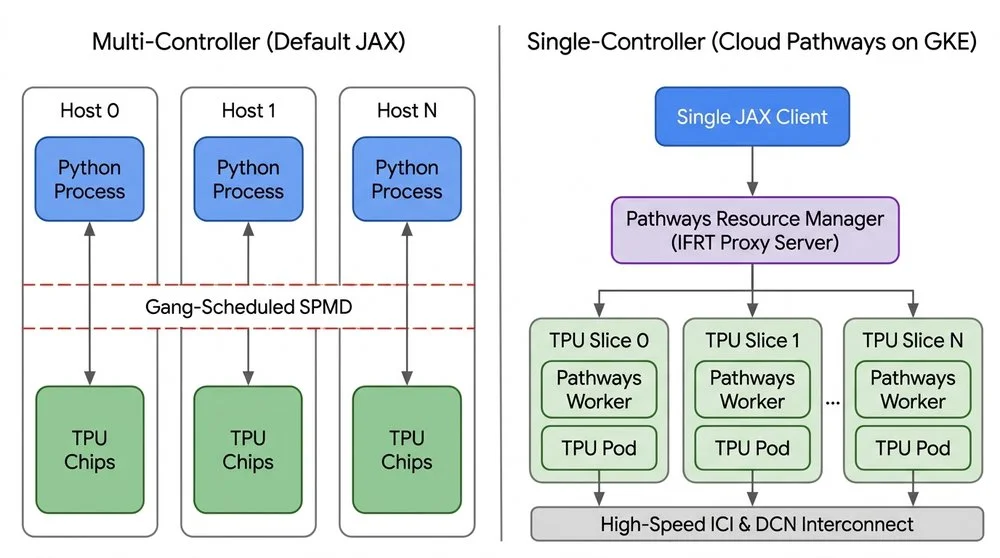
Cloud Pathwaysは、Google Cloud AI Hypercomputerの中核コンポーネントとして、GKEで一般提供が開始されました。当初は、Geminiのような最先端モデルのトレーニングのためにGoogle DeepMindによって開発されました。Pathwaysは、大規模で多様なアクセラレータフリート向けに設計された分散型機械学習ランタイムです。過去90日間で、1億3000万以上のCloud TPUチップ時間(chip-hours)がGKE上のPathwaysを使用して処理されました。すべてのGoogle Cloudのお客様は、そのシングルコントローラーランタイム、コロケーションされたPythonサイドカー、および弾力的な耐障害性を活用できるようになりました。Cluster Directorとのプレビュー統合により、Cloud PathwaysはSlurmクラスターに拡張され、JAXの実行とインタラクティブノートブックの統合が可能になります。Cloud Pathwaysは、数千のアクセラレータにわたるAIワークロードのスケーリングにおける、従来のマルチコントローラーセットアップの複雑さを解決します。オープンソースのInterim Framework Runtime上に構築された統合されたシングルコントローラーアーキテクチャにより、マルチコントローラー管理を置き換えます。これにより、単一のJAXクライアントプロセスが、ローカルに接続されているかのように複数の大規模TPUスライスをオーケストレーションできます。主な機能には、シングルコントローラーオーケストレーション、計算集約型ロジックのためのコロケーションされたPythonサイドカー、および回復力と弾力性のあるトレーニングが含まれます。また、インタラクティブモードとShared Pathways Serviceも提供され、柔軟なマルチユーザーアクセスが可能になります。主要なAIラボや企業、例えば大手コンシューマーテクノロジー企業やZenteiQは、すでにミッションクリティカルな本番ワークロードにCloud Pathwaysを使用しています。Cloud Pathwaysは、本日より、GKE上のCloud TPU v5e、v5p、Trillium、およびIronwoodをサポートするすべてのGoogle Cloudリージョンで利用可能です。
CdXz5zHNQW_Me7SwPag7x.jpeg
Google Compute Engineは、次世代のストレージ最適化Z4Mマシンシリーズをローンチしました。これらのインスタンスは、仮想マシンとベアメタルオプションの両方で利用可能です。Z4Mは、大規模なデータセットを処理する要求の厳しいAI/MLトレーニングおよび推論ワークロード向けに設計されています。最大168,000 GiBのローカルSSDストレージと、毎秒400ギガビットの高速Cloud RDMAネットワーキングを提供します。この構成は、GPUとTPUを完全に活用するために不可欠なデータアクセスレイテンシを最小限に抑えます。Z4M VMは、vCPUあたりのスケーラブルなLSSD容量を提供し、ベアメタルインスタンスは、特殊なニーズに対応するために直接ハードウェアアクセスを提供します。Intel Xeon Scalableプロセッサと強化されたTitanium SSDを搭載したZ4Mは、以前の世代と比較して印象的なIOPSとスループットの向上を実現します。このプラットフォームは、効率的なデータ転送のためにNVIDIA GPUDirect StorageおよびTPUDirect Storageをサポートしています。Cluster Directorは、Z4Mクラスターの簡単なデプロイと管理を容易にします。Z4Mインスタンスは、Google CloudのHyperdiskとも統合されており、柔軟なネットワーク接続ストレージオプションを提供します。これらの新しいインスタンスは、現在、世界の一部の地域で利用可能です。
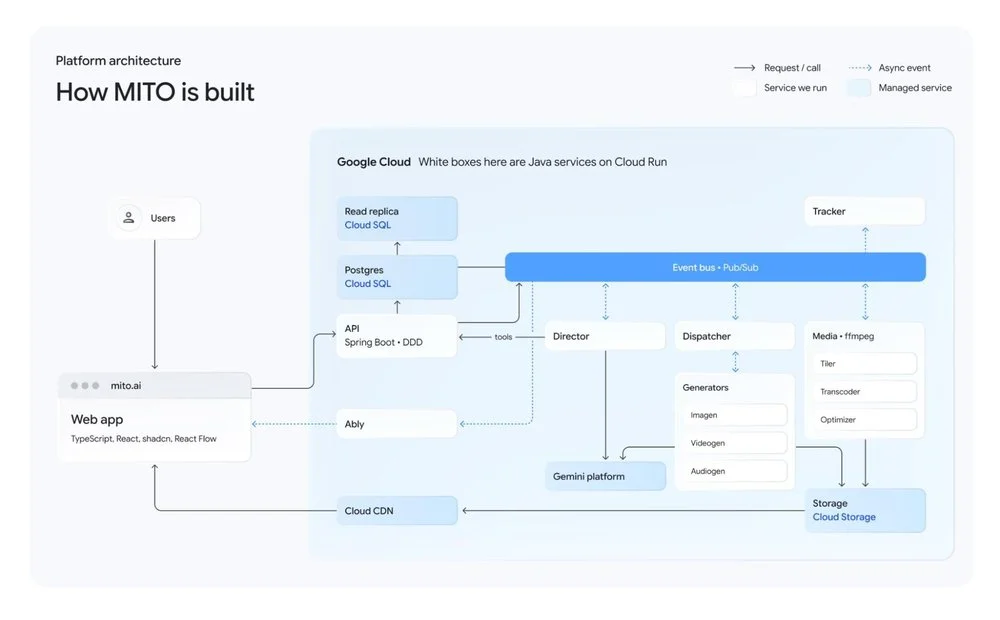
Mitoは、AIを活用した動画制作を民主化し、高度なテクノロジーを誰もが利用できるようにすることを目指しています。彼らの道のりでは、生成AIを用いて長編の物語コンテンツを制作する上で、インフラストとワークフローにおける重大な課題が明らかになりました。これらの課題には、膨大なローカルメディアライブラリの管理、リアルタイムコラボレーションの欠如、そして長時間のレンダリング遅延が含まれていました。生成モデル間の一貫性のなさや、公開APIの容量制限も彼らの取り組みをさらに複雑にしました。これらの問題を克服するため、MitoはGoogle Cloud上にサーバーレスの非同期アーキテクチャを設計しました。彼らはAPIとバックグラウンドワーカーにCloud Runを利用し、スケーラブルな処理を可能にしました。Google Cloud Pub/Subは、ジョブ実行を分離するための中央イベントバスとして機能しました。メディアアセットはGoogle Cloud Storageに保存され、Cloud CDNを介して配信され、遅延を最小限に抑えています。Cloud SQLとPostgreSQLを使用した分離されたデータベースアーキテクチャは、本番環境に影響を与えることなく分析をサポートします。彼らはVertex AIを通じて基盤モデルを活用し、カスタムのシステムプロンプトも使用しています。彼らのフロントエンドは、プロンプト変数を最適化するために「Rule of 6」を適用し、コスト効率のために静止画生成を優先しています。このソリューションにより、Movistar Plus+の画期的な全国放送キャンペーンが成功し、95%がAI生成であると説明されました。このキャンペーンはスペインの主要なテレビチャンネルすべてで放映され、AI Directorの会話能力とリアルタイムコラボレーションが披露されました。Mitoのアーキテクチャは将来性があり、ますます高速なレンダリング時間と高度なAI機能に対応できるようになっています。彼らは、クリエイティブな出力を検証するために、Geminiを搭載した自動評価ハーネスを構築しました。彼らのAI Directorは、インテリジェントな調整のために、複数の専門モデルにタスクを動的にルーティングします。Mitoはまた、本物のストーリーテリングを強化するために「不完全な美学」を取り入れ、シュールな視覚要素を組み込んでいます。
CdXz5zHNQW_tOhDlbvIcv.jpeg
BigQuery DataFrames(BigFrames)は新しい.bigqueryアクセルを導入し、ユーザーが慣れたpandas DataFrame内で直接高度な機械学習を実行できるようにします。この統合により、クラウドインフラ上でBigQueryのエンタープライズ向けAI機能をシームレスに活用できます。線形回帰のようなタスクでは、ローカルトレーニングをバイパスしてBigQueryのデータ上で直接ai.predict()を活用できるようになりました。.bigqueryアクセサはpandasの操作をGoogle Standard SQLに翻訳し、モデルをBigQuery上でネイティブに実行します。環境設定には特定のGoogle Cloud役割とpandasおよびbigframeのインストールが必要です。AI機能はpandas SeriesとDataFrameの両方で利用可能です。Seriesでは、ai.embed()がテキスト埋め込みを計算し、ai.similarity()は余弦類似度スコアを計算します。DataFrame関数は、時系列予測のためのai.forecast()や自然言語行フィルタリング用のai.if_()など、多列操作を扱います。これらの機能はクラウドインフラやモデル実行の複雑さを抽象化します。目標は、データサイエンティストがPythonエコシステムを離れることなく高度なAIタスクを実行できるようにすることです。対応機能には組み込み生成、分類、予測、予測モデリングが含まれます。pandas内のBigQuery AI機能により、機械学習ワークフローのスケーリングが簡素化されます。
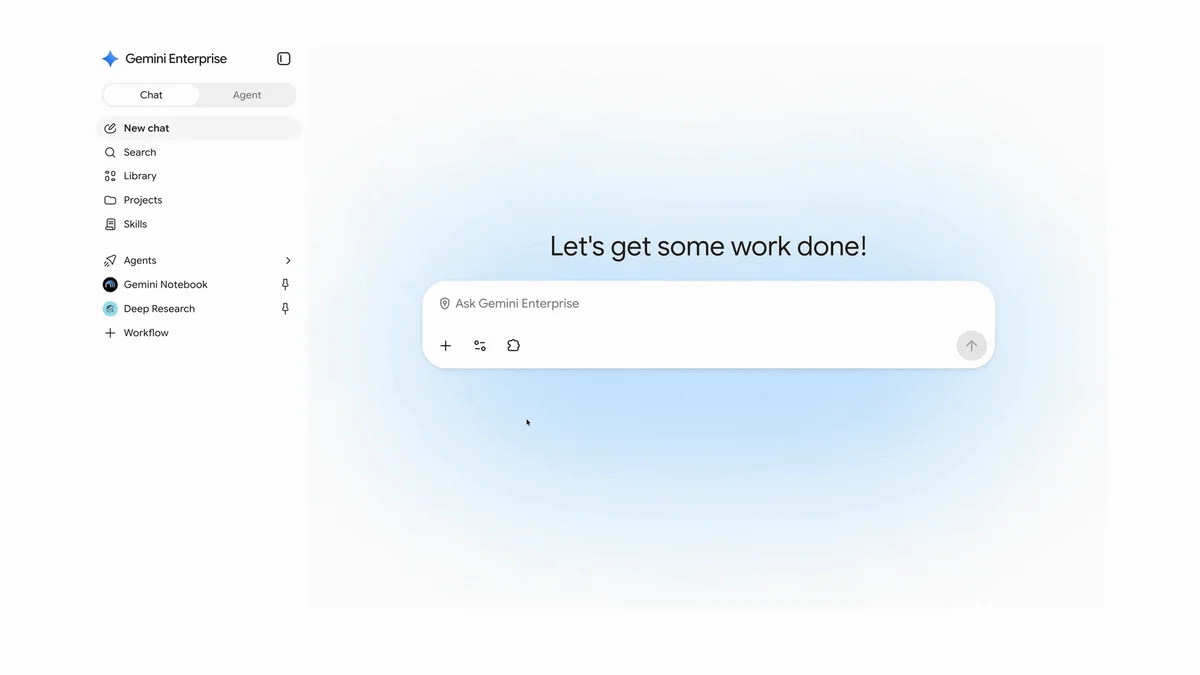
Gemini for Businessは現在、プレビュー版のData Cloudコネクタを提供し、ユーザーが自然言語でライブエンタープライズデータを照会できるようにします。これらのコネクタは、ガバナンスされたデータに直接アクセスすることで、データリクエストのバックログの課題に対応しています。Knowledge Catalogと連携し、関連データの特定、自然言語クエリの解釈、ユーザーのアイデンティティに基づく権限範囲のクエリの実行を可能にします。ユーザーはBigQuery、Spanner、AlloyDB、Cloud SQLなどの運用データベース、Lookerからデータをクエリできます。発見したデータはGoogle Docs、Gmail、Google Slidesなどのツールに直接移行可能です。Geminiはセマンティックディスカバリーとコンテキストマッピングを活用し、技術的なメタデータやビジネス用語集を用いて日常用語をデータベース構造に変換します。Permissionaware Executionにより、行レベルおよびカラムレベルのアクセス制御が尊重されます。Data CloudコネクターはBigQueryとAWS S3間でデータをクエリし、環境を単一の会話インターフェースに統合できます。これらのコネクターは、データをコピーせずにその場でアクセスできるフェデレーテッドクエリモードを提供します。カスタムソリューションと比べて、Data Cloudコネクターは高い応答品質と管理認証によるガイド付きセットアップのための組み込みスキルを提供します。この機能は、データアクセスの民主化とビジネスユーザーやアナリストの洞察の加速を目指しています。
CdXz5zHNQW_RxiqwDQ3xG.gif
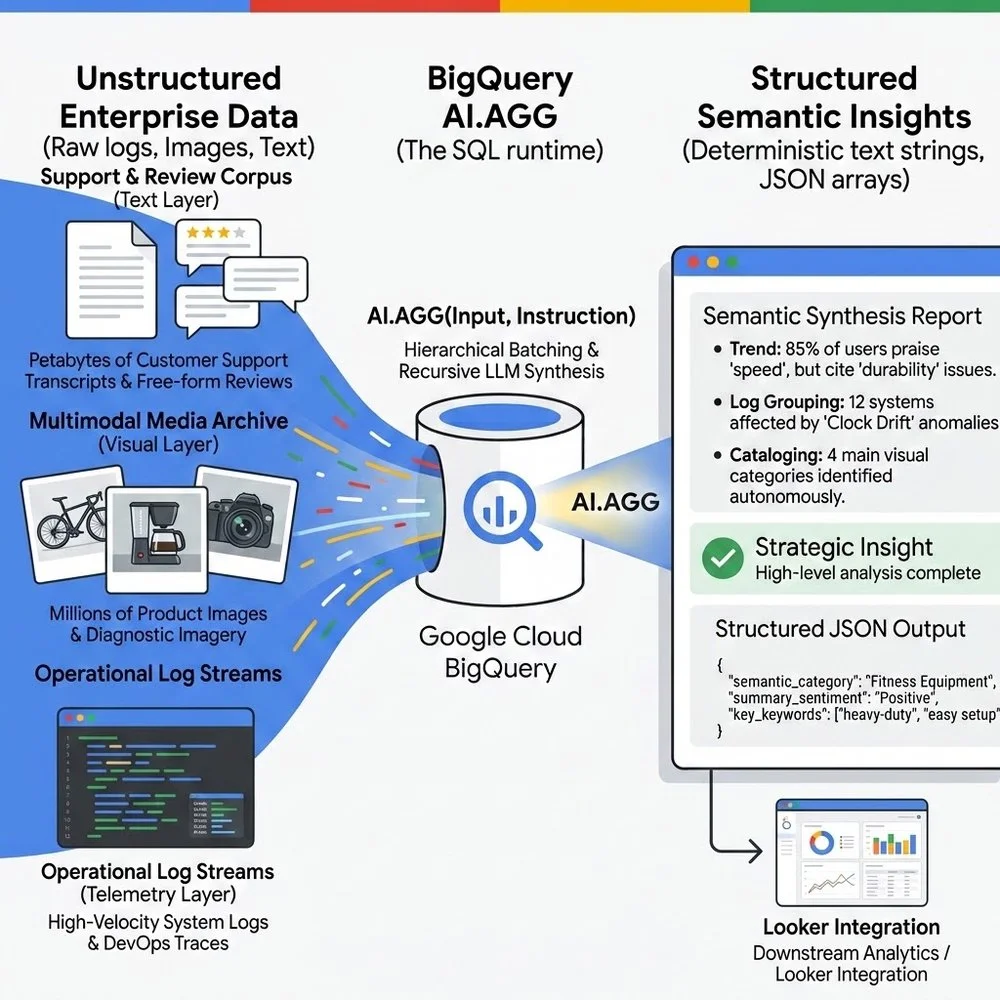
BigQuery の新しい AI.AGG 機能は、現在プレビュー段階にあり、GoogleSQL 内で直接マルチレベルのセマンティック集計を可能にすることで、非構造化データ分析に革命をもたらします。これは、従来の関係型 SQL エンジンが、大規模言語モデル (LLM) のコンテキストウィンドウの制限により、大量のテキストおよびマルチモーダルデータセットからの洞察の合成に苦労していた重要なギャップに対処します。AI.AGG は、セマンティック集計を分散型マップ・レデュース問題として概念化し、データチームが単一の SQL クエリで数百万行にわたる自然言語の指示を実行できるようにします。基盤となるマルチレベルバッチ処理アーキテクチャは、行の検証、コンテキストセーフなバッチ処理、Vertex AI を介した並列推論、および完全な重みを持つ LLM を使用した再帰的な合成を自動的に処理し、単一の集計された文字列が生成されるまで行います。テキストとマルチモーダルの両方の入力をネイティブにサポートし、データ移動なしで画像分析のために BigQuery Object Tables を活用します。AI.AGG は、大量のシステムログの診断分析や、自律的なデータラベリングパイプラインのための「エージェンティックデータクラウド」の構築など、変革的なエンタープライズユースケース向けに設計されています。AI.AGG のプロンプトエンジニアリングには、プログラム可能な SQL 出力を保証するために、明示的な出力契約、コンテキスト区切り文字、障害状態設計、および少数ショットアンカーが必要です。コスト管理には、WHERE および LIMIT 句による事前フィルタリングと、Gemini Context Caching の利用、および推定のための AI.COUNT_TOKENS の使用が含まれます。この機能は BigQuery のガバナンスフレームワーク内で動作し、VPC Service Controls をサポートし、一時的なエラーに対して正常に低下します。プレビューガードレールには、グループあたり 10,000 トークンの出力キャップ、10 MiB の行制限、および最大 2,000 万行と 1,000 の個別の SQL グループの処理に関する推奨事項が含まれます。AI.AGG は、エンタープライズデータウェアハウスをアクティブでセマンティックなランタイムに変革し、ペタバイト規模のセマンティック分析へのアクセスを民主化します。
CdXz5zHNQW_uaHoQyzKVt.jpeg
Gemini Omni 1.2 Flash が Google Cloud で一般提供開始されました。これは、製品ビデオや広告などのビジネスビデオを効率的に作成するために設計されています。このモデルは高速でコスト効率が高く、画像、ビデオ、音声の参照に対する忠実度をより強く維持します。主なアップデートには、720p ビデオの価格が 30% 低減、最大 15 秒のより長いクリップ、ショット間のより一貫した結果が含まれます。また、高解像度でのより高速なドラフト、リップシンクが改善されたより自然なスピーチ、最初からやり直すことなく会話形式でクリップを編集できる機能も提供します。Gemini Omni 1.2 Flash は本番環境に対応しており、Google Cloud のインフラストラクチャによってサポートされ、出力には SynthID の透かしが含まれています。Artlist、FLORA、Picsart などのさまざまなクリエイティブおよびデザインプラットフォームが、ユーザーのビデオ作成能力を強化するためにこのモデルを統合しています。小売業者やマーケットプレイスは、製品スピン、ライフスタイルクリップ、ビデオ広告を大規模に活用しています。このモデルは、まもなく Gemini for business および Google Vids で利用可能になり、開発者は API を介してアクセスできるようになります。
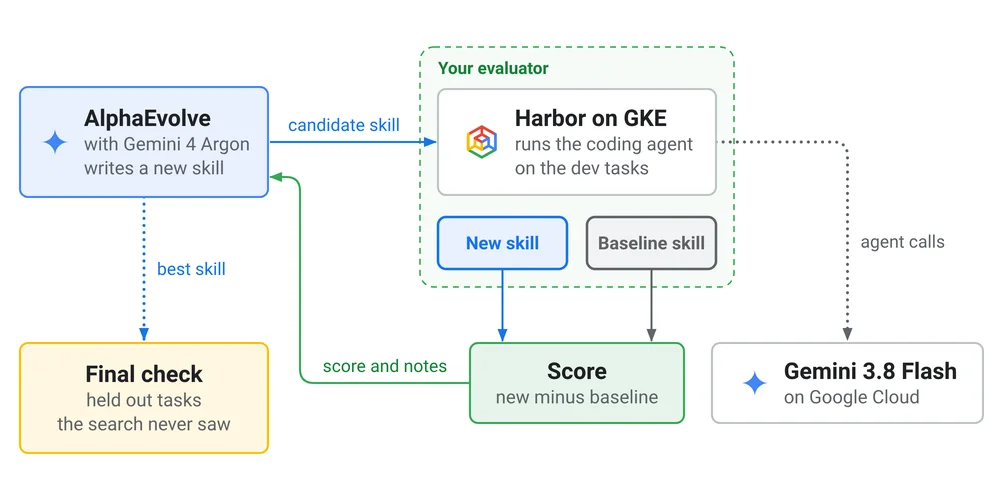
コーディングエージェントはソフトウェアエンジニアリングタスクにますます使用されていますが、効果的な指示が必要です。手動で記述されたエージェントスキルは、その有効性を評価するのが難しいため、洗練するのが困難です。Terminal-Bench 2.0でのOpenCodeとGemini 3.8 Flashを使用した初期テストでは、ベースラインスキルでは決定的な結果が得られませんでした。パフォーマンスを向上させるために、AlphaEvolveを使用して、新しいバージョンを繰り返し提案し、評価者でスコアリングし、最良のものを保持することによってスキルを最適化しました。Harborは評価者として使用され、エージェントを分離されたコンテナで実際のタスクで実行しました。このプロセスは、AlphaEvolveが書き換えることができるプログラムのようにエージェントスキルを扱います。Harborの評価者は、信頼できるスコアリングを保証するために、同じタスクで候補スキルをベースラインスキルと比較して同時に実行します。タスクの一部は、最終的に最適化されたスキルを未知のデータでテストするために予約されています。AlphaEvolveは、最も一般的な失敗である時間の経過に対処することに焦点を当てました。システムは、数回のイテレーションで5%の改善を達成し、特定の開発タスクで33ポイントの大幅な増加を達成しました。遭遇した課題には、遅いモデル応答の計画と、長い検索中のログストレージが含まれます。今後の作業には、ビジネスルールを組み込むために、エンタープライズエージェントハーネスでAlphaEvolveをテストすることが含まれます。
CdXz5zHNQW_kGRYcLbu5V.png
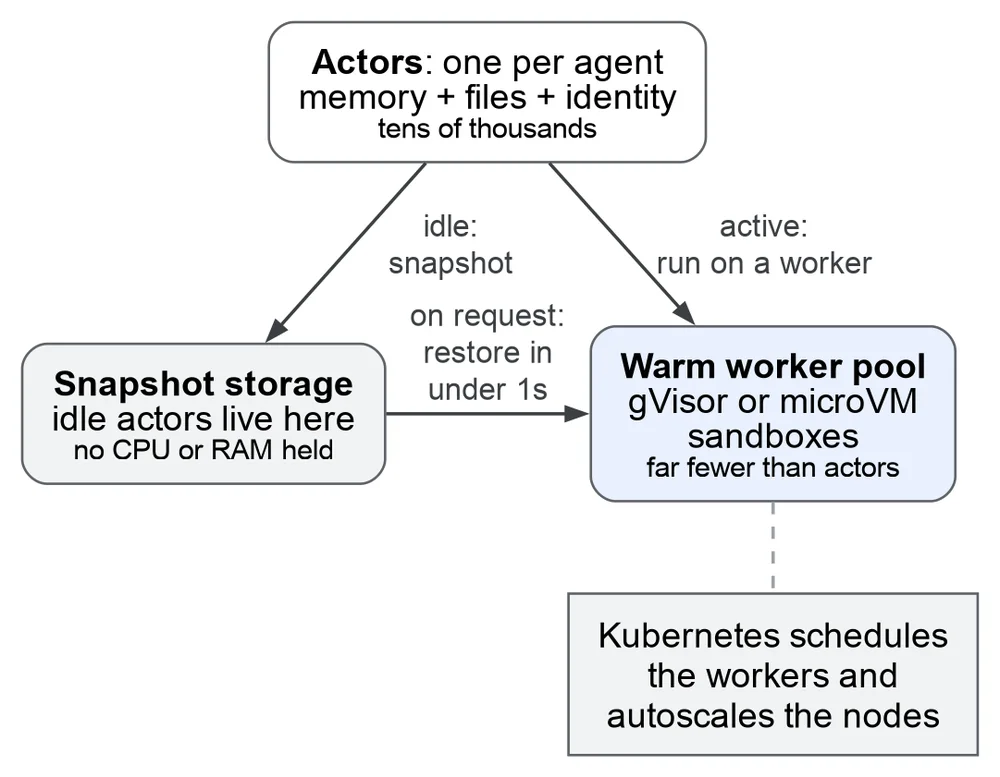
AIは、人間規模のシステムからエージェント規模の運用へと進化しており、単なる記録ではなくアクティブなシステムへと変貌しています。この変化は、複雑なエージェントワークフローを処理するための新しい基盤を必要とします。これに対応するため、Agent Substrate、gVisor、OpenRLの3つのオープンソースプロジェクトがCloud Native Computing Foundation(CNCF)に寄贈されました。Agent Substrateは、バージョン1.0となり、GKEで利用可能で、分離されたエージェント環境を効率的にスケーリングします。ステートフルなエージェントセッションをアクティブなコンピューティングから分離し、アイドル状態のエージェントをストレージにスナップショットして迅速に復元します。これにより、アイドル状態のコンピューティングオーバーヘッドを削減し、コンテナ密度を大幅に向上させます。GVisorは、軽量なユーザースペースカーネルを実行することで、信頼できないエージェントコードに不可欠な分離を提供します。これにより、ホストLinuxカーネルとの直接的なやり取りを防ぎ、セキュリティを強化します。OpenRLは、強化学習エージェントのトレーニング後およびサービングの分散を簡素化します。プレーンPythonを使用して、Kubernetes上で直接、セルフホスト型のRLトレーニング後ループを可能にします。これらのプロジェクトは collectively、さまざまなクラウドやハードウェアアクセラレータにわたるあらゆるKubernetesクラスタと互換性のあるオープンスタックを提供します。Agent Substrateは、標準コンテナ密度の10倍で数百万のサンドボックスを実行することを可能にします。GVisorは、信頼できないコードが決してホストシステムのカーネルを侵害しないことを保証します。OpenRLは、分散トレーニングのためにKubernetesを活用し、効率的な強化学習ワークフローをオーケストレーションします。CNCFへの寄贈は、共同開発を促進し、これらの重要なAIインフラストラクチャコンポーネントの採用を加速することを目的としています。
CdXz5zHNQW_rMp6SvhdPH.png
データベースは現在、AI主導の急速なソフトウェア開発に追いつくのに苦労しており、プロビジョニング、テスト、本番移行においてボトルネックが生じています。AlloyDB for PostgreSQLの新サービスであるAlloyDB Expressは、これらの課題を解決することを目指しています。開発者およびAIコーディングエージェント向けに設計されており、2秒未満での高速なデータベース作成を提供します。このサービスはアイドル状態になると自動的に一時停止し、15分間の非アクティブ後にスケールゼロ機能を実装することでコストを削減します。この新しいサービスは、高速なAI主導の開発と堅牢なエンタープライズインフラストラクチャの間のギャップを埋めます。AlloyDB Expressは、組み込みのエンタープライズセキュリティとAI機能を備えた、エージェント対応のデータベースエクスペリエンスを提供します。本番規模へのワンクリックアップグレードを可能にし、データと構成を保持します。セキュリティは最重要であり、マスクされたIPアドレス用のパブリックDNSエンドポイントや、安全な内部統合のためのプライベートVPCネットワーキングなどの機能が備わっています。Google Cloud IAMやネイティブPostgreSQLロールを含むきめ細かなアクセス制御により、ユーザーとエージェントの最小権限が強制されます。特に重要なのは、AlloyDB ExpressがAIツールをデータベースに直接統合し、外部ベクトルストアの必要性を排除していることです。開発者は、pgvector HNSWおよびGoogleのScaNNインデックスを使用して、セマンティック検索およびレコメンデーションエンジン用の高速ベクトル検索を利用できます。このサービスは、テキストおよび画像埋め込み生成、フィルタリング、要約などのタスクのために、SQLクエリ内でGeminiモデルへの直接アクセスも提供します。自然言語からSQLへの生成は、開発者およびAIエージェント向けのクエリ作成をさらに簡素化します。AlloyDB Expressは、非アクティブ時にはゼロにスケールするシンプルで直感的な価格設定を特徴とし、データは安全に保たれます。アクティブなコンピューティングは、コンピューティングユニット時間あたり0.115ドルで請求され、一時停止されたコンピューティングには料金はかかりません。使用されたストレージは、GB月あたり0.30ドルで、無料ティアでは毎月50の無料CUが提供されます。この費用対効果の高いソリューションは、アプリケーション構築を加速し、本番環境にシームレスにスケールします。AlloyDB Expressは現在プレビュー版で利用可能であり、ユーザーは開発効率の向上に向けてその機能を探索できます。
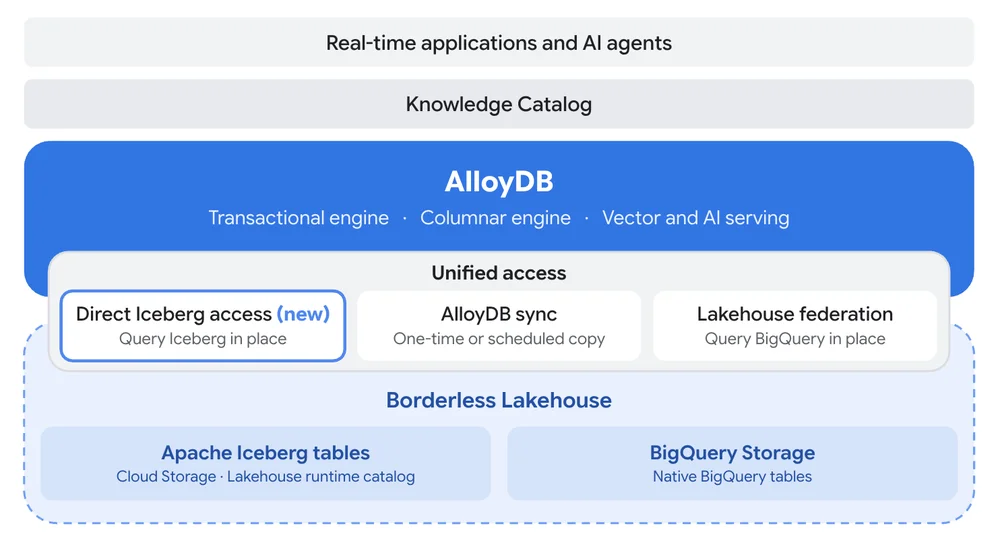
効果的な意思決定のためには、ビジネスはリアルタイムの運用データと履歴分析データの両方を必要とします。従来は別々であったこれらのデータシステムが、AlloyDB for PostgreSQLの新機能によって統合されつつあります。Google Cloudは、開発者がクラウドストレージ上のApache IcebergテーブルをAlloyDBから直接クエリし、単一のSQLクエリでライブデータと結合できるようにする、直接Icebergアクセスを導入しています。プレビュー段階にあるこの統合は、他のサービスと比較して集計クエリの速度が大幅に向上しています。さらに、AlloyDB syncとLakehouse federationが一般提供開始され、「ボーダーレスなLakehouse」と対話するための3つの主要な方法が提供されます。直接Icebergアクセスは、AlloyDBの列指向エンジンを活用して高速化し、Icebergテーブルをインプレースで読み取ります。AlloyDB syncは、低レイテンシで頻繁にアクセスされるワークロードのために、BigQueryからAlloyDBにレイクハウスデータをコピーし、ユーザー定義のスケジュールで更新されます。Lakehouse federationは、AlloyDBがネイティブなBigQueryテーブルを直接クエリできるようにし、処理はBigQueryが担当します。これらの統合により、カスタムパイプラインの必要がなくなり、アプリケーションやAIエージェントが運用データとレイクハウスデータを組み合わせてシームレスに活用できるようになります。実際の例としては、不正検出、パーソナライゼーション、動的価格設定などがあり、レイクハウスからの履歴コンテキストがデータベース内のリアルタイムの意思決定に役立ちます。データチームは、キュレーションされたテーブルを一度Icebergに公開し、複数のアプリケーションがそれをインプレースで読み取れるようにすることもできます。直接Icebergアクセスにより、他のPostgreSQLテーブルと同様にIcebergテーブルを登録およびクエリでき、組み込みサポートと列指向エンジンの恩恵を受けることができます。AlloyDB syncは、常に変化しないデータの非常に低いレイテンシでの読み取りニーズに対応するため、AlloyDB内にローカルで更新可能なコピーを作成します。Lakehouse federationは、BigQueryに大量の履歴データを持つ組織に対応し、処理をBigQueryにプッシュダウンして結果のみを返します。統合の選択は、データの場所、アプリケーションの読み取りパターン、およびレイテンシ要件によって異なります。
CdXz5zHNQW_fVS3LutEP2.png
組織は、収益、効率、リスク管理を強化するために、エージェント駆動型自動化をますます活用しています。GoogleのAgentic Data Cloudは、エンタープライズデータを統合し、精度を確保し、低コストでプロアクティブに運用するように設計されたSystem of Actionです。ボーダーレスなLakehouseは、オープンなApache Icebergフォーマットを使用して、マルチクラウド、オンプレミス、SaaSプラットフォームに分散されたデータをアクティブ化します。新しい強化機能により、Geminiは自然言語でLakehouseをクエリできるようになり、クロスクラウド相互接続は、セキュアでゼロエグレス料金のデータアクセスを提供します。AlloyDB統合により、エージェントはIcebergテーブルを直接クエリし、履歴データとリアルタイムデータを効率的に結合できます。Spanner Omniは、ハイブリッドエージェントアプリケーションのためにGoogleグレードの一貫性とスケールを拡張します。Knowledge Catalog、Google Cloudのユニバーサルコンテキストエンジンは、エージェントをエンタープライズコンテキストに接地させ、精度を向上させ、レイテンシを削減し、トークンコストを削減します。自己学習エンリッチメントと再利用可能なOKFコンテキストセットは、Google WorkspaceやSharePointなどの非構造化ソースからのコンテキストキュレーションを自動化します。Knowledge Catalogの新しいスタジオエクスペリエンスは、コンテキストの探索とガバナンスのための会話型UIを提供します。Knowledge Catalogは現在Geminiでデフォルトになっており、ガバナンスされたビジネスコンテキストにデータ質問を接地し、さまざまなプラットフォームからの信頼できるセマンティックモデルをサポートします。Googleは、プラクティショナーエクスペリエンスを変革し、データおよびMLエンジニアがGeminiの機械学習スキルを使用して、意図駆動型の結果のためにエージェントをオーケストレーションできるようにしています。ビジネスユーザーは、単に質問するだけでリアルタイムの運用レポートを生成できます。Data Agent Kitは、Google Data Cloudツールを開発者の好みのIDEおよびCLIに統合します。Googleはまた、エージェントスケールのためのデータインフラストラクチャをエンジニアリングしており、迅速なプロトタイピングのためにAlloyDB Expressを導入し、AlloyDB for productionでエージェントのためにPostgreSQLを導入しています。Managed Service for Apache Sparkは、価格性能を拡張し、BigQueryは、より高速なクエリ、ペタバイトスケールのグラフ分析のためのBigQuery Graph、およびTimesFM 3.0やTabFMなどの新しいGoogle Researchモデルで強化されています。
CdXz5zHNQW_OVtRDwO1CM.gif
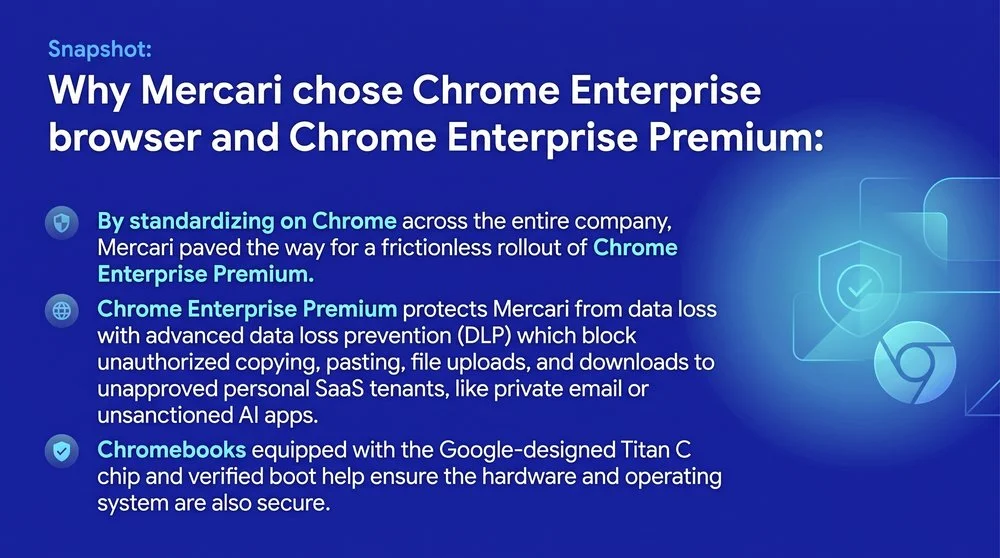
何百万人ものユーザーを抱える消費者間マーケットプレイスであるMercariは、機密性の高いPIIを扱うカスタマーサービス環境を保護する必要がありました。以前のVDIセットアップは非効率的でコストがかかり、複雑で、重複するDLP制御が必要でした。Mercariは、ブラウザレイヤーでのデータ制御に注力するため、Chrome Enterprise PremiumとChromebookに移行しました。この新しいアーキテクチャにより、厳格なDLPルールが可能になり、不正な宛先やAIツールへのデータ漏洩を防ぐことができました。従業員がすでにChromeブラウザに慣れていたため、移行はスムーズに進みました。この移行により、セキュリティが強化されただけでなく、IT運用が合理化され、コストが大幅に削減されました。Mercariは、VDIへの依存を最小限に抑え、セキュリティエージェントを統合することで、3年間で50%以上のコスト削減を見込んでいます。ブラウザ中心のモデルにより、ITリソースをより優先度の高いイニシアチブに解放し、ゼロトラストでデバイスベースのセキュリティアプローチを強化しました。Mercariは現在、AIを積極的に活用する組織として位置づけられ、安全で管理されたAIの導入を可能にしています。当初は、生産性を向上させながらデータ変更のリスクを低減するために、ブラウザポリシーを使用してChromeでのGeminiへの読み取り専用アクセスを許可しています。Mercariは、Chrome Enterprise Premiumの進化する機能を活用することで、AIの生産性とセキュリティのバランスを継続的に取っていく計画です。
CdXz5zHNQW_kBiqeKA58G.jpeg
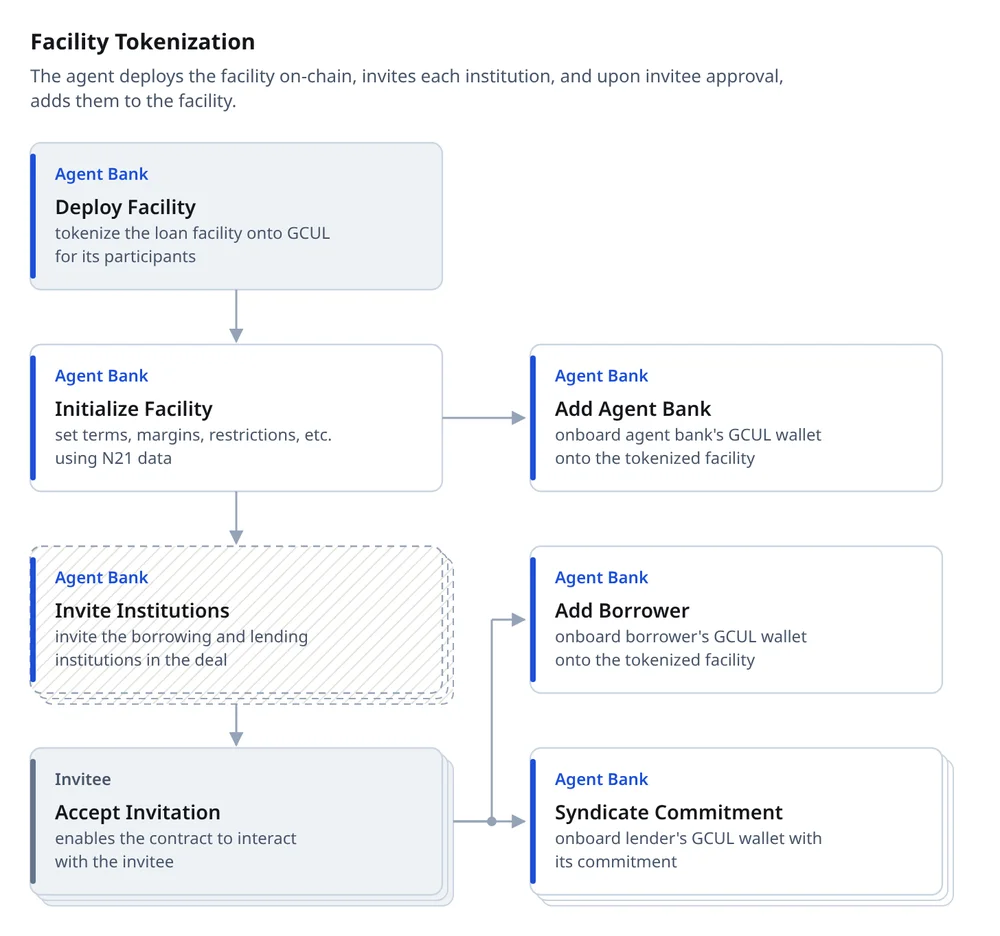
シンジケートローンおよびプライベートクレジット市場は、手作業によるプロセスに起因する決済の遅延や評価の不透明性といった課題に直面しています。フィンテックイノベーターであるNammu21は、Google Cloudと提携し、新たな概念実証(Proof-of-Concept)を通じてこれらの課題に対処しました。このソリューションは、Nammu21のAIプラットフォームを活用して、法的契約をGoogle Cloud Universal Ledger(GCUL)上のスマートコントラクトに構造化し、ローンライフサイクル全体を自動化します。現在のローン市場は、法的文書の断片的で手作業による解釈に悩まされており、決済時間の長期化を招き、それが資本の拘束やリスクの増大につながっています。Nammu21は、オーダーメイドのクレジット文書をデジタルクレジットインストゥルメント(DCI)にデジタル化し、すべての条件を元の法的条項にマッピングし、実行可能な動作として表現します。GCULは、これらのインストゥルメントをインスタンス化するための安全で高性能な分散型台帳環境を提供し、ほぼ瞬時のトランザクションファイナリティと予測可能なコストを実現します。GCUL上のプログラム可能なコントラクトは、安全で読みやすく、監査可能なドメイン最適化プログラミング言語であるgculpyで記述されています。このプラットフォームは、複雑なメモリ管理を簡素化することで、金融機関の開発を効率化します。Nammu21は、法的契約からDCIをプログラム的にレンダリングし、GCUL上のローンを管理するためのgculpyコントラクトを導出するという二重の役割を果たします。このアーキテクチャは、モデル化されたTerm Loan Bトランザクションで実証されたように、単一の不変の真実の情報源を作成します。このシステムは、ゲート付き実行によるコンプライアンスを確保し、機密データに対するロールベースのプライバシーを維持し、決済ファイナリティを提供します。この構造的な変化は、貸付市場を根本的に変革し、決済時間、バックオフィスオーバーヘッド、およびカウンターパーティリスクを削減します。
CdXz5zHNQW_BVawpnmXci.png
Google Cloud Consultingは、企業がAIを日常業務に統合するのを支援しており、生成AIから自律的にタスクを完了するエージェントシステムへの移行を観察しています。技術リソースは重要ですが、AIエージェントのエンタープライズでの成功には、意図的な文化変革が必要です。従業員は実験する権限を与えられていると感じる必要があり、リーダーは役割に対するAIの影響を明確にする必要があります。チームは、このエージェントへの移行を導くための5つの実践的な教訓を提供します。第一に、人間がループ内にいる検証から、人間がリードするモデルへと移行し、ワークフローをエージェント実行、人間指示型に再設計します。これには、エージェントが並列依存関係を処理し、曖昧なシナリオのみを人間にルーティングすることが含まれます。第二に、エージェントを積極的な委任と明確な責任を必要とするジュニアチームメンバーのように扱い、オーナーシップを育むことで、従業員の躊躇に対処します。第三に、結果に焦点を当て、望ましい行動を強化し、チームが創造的な仕事のためにエージェントを活用するようにコーチングすることで、人間とエージェントのハイブリッドチームを効果的に管理します。第四に、安全な学習ゾーンを提供し、「インテリジェントな失敗」を祝うことで、実験を通じてエージェントリテラシーを構築し、理解を深めます。最後に、ハブアンドスポークモデルでエージェントを管理し、中央のガイドラインを確立しながら、個々のチームがツールを適応させ、実験できるようにします。このピープルファーストのアプローチは、人間の創意工夫とエージェントが相互に増幅し合う組織を作成することを目指しています。
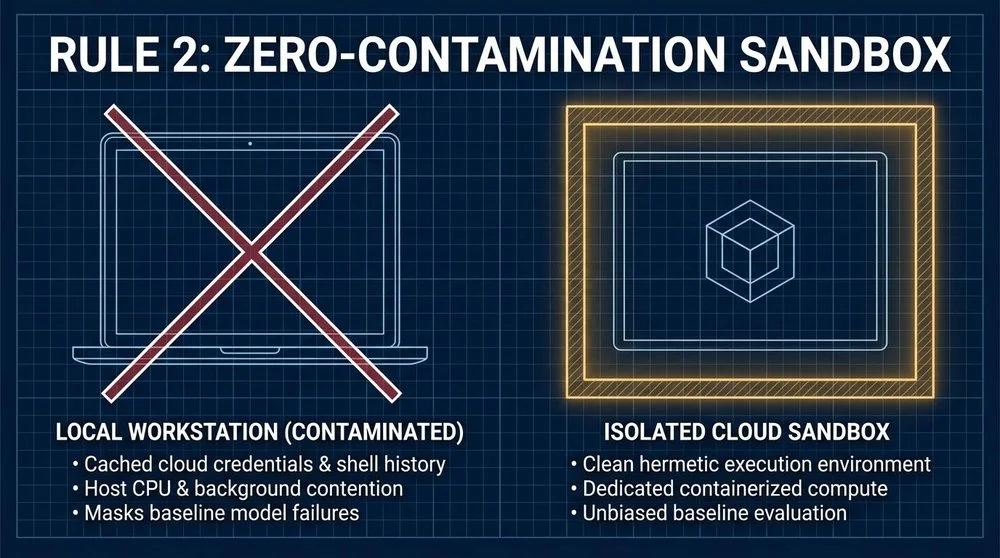
SKILL.md ファイルの効果的なテストは、ラップトップでの単純な合否判定以上のものが必要です。過剰なトリガーやサイブラインハイジャックは、特に複雑なワークスペースで、エージェントがスキルをロードするのを妨げる可能性があります。skill-reach や SkillSpector のようなツールは、フロントマターの衝突やセキュリティリスクを早期に特定するのに役立ちます。開発者のラップトップでスキルベンチマークを実行することは、ベースラインの結果を汚染するアンビエント状態があるため避けることが重要です。ペアアブレーションテスト(WITH vs. WITHOUT)、複数回の繰り返しにより、スキルの向上と効率の向上をより正確に測定できます。このアプローチは、スキルが実際に役立つのか、それともベースモデルがすでにその能力を持っているのかを明らかにします。最適化を自動化する際は、正しさ、効率性、セキュリティのメトリクスを分離し、採点コンポーネントを分離することで、評価ハーネスがリワードハッキングに対して強化されていることを確認してください。最後に、効果的な SKILL.md ファイルは、単に広範なドキュメントをダンプするのではなく、運用上の習慣と検証リフレックスをエンコードします。フロンティアモデルは、事前トレーニングで公開ドキュメントを持っていることが多いため、コンパクトで実行可能な制約の方が価値があります。新しいモデルでスキルを定期的に再評価し、ゼロデルタのスキルを削除することで、効率的で最新のスキルセットを確保します。
CdXz5zHNQW_hfaP61Yspo.jpeg
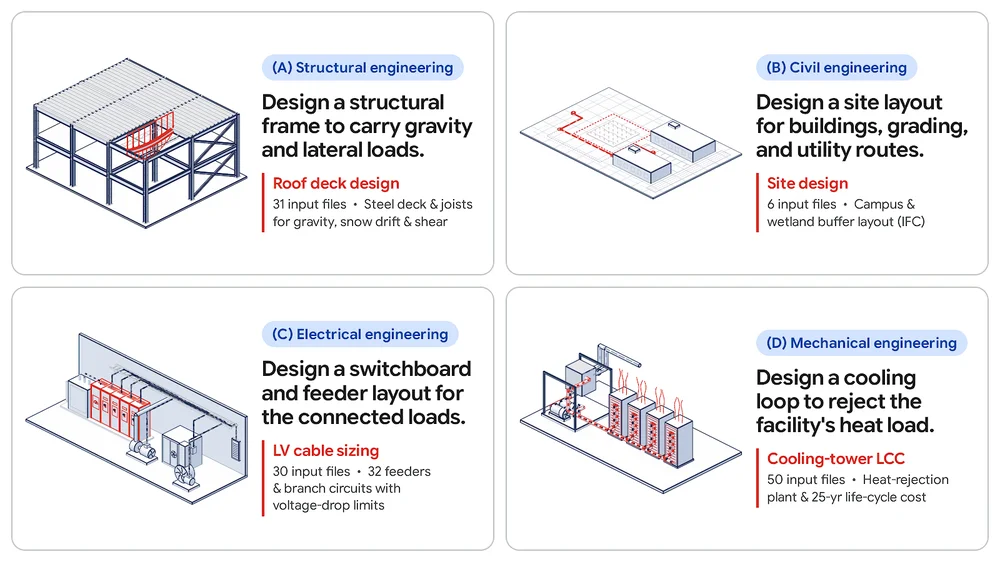
Google AI & Infrastructureチームは、Mercorと協力して、新しいベンチマークおよび公開コンペティションであるPhysical-Engineering's Last Exam (PLE)をローンチしました。PLEは、機械工学、電気工学、土木工学、構造工学のタスクを完了するフロンティアモデルの能力を評価します。この取り組みは、主に教科書の質問や孤立した設計問題に焦点を当てた既存のベンチマークのギャップに対処するものです。Humanity's Last ExamやAgents' Last Examのような以前の試験とは異なり、PLEは物理的な世界構築タスクに対するAIの能力を具体的に測定します。PLEは、平均61ファイルからなる85のロングホライゾンタスクで構成されており、実際のエンジニアリングプロジェクトを反映しています。これらのファイルには様々なエンジニアリング文書が含まれており、エージェントはコード、制限、計算を理解して、本番稼働可能な成果物を生成する必要があります。タスクは、実践的なエンジニアとの協力によって開発され、専門家によって作成されたか、エージェントパイプラインと共同で作成されました。7つのエージェントハーネスを使用した14のフロンティアモデルでの初期テストでは、すべてのモデルがプライベートテストセットで50%未満のスコアでした。最もパフォーマンスの高いモデルは、平均スコア48.3%を達成しました。重要な発見は、共同作成されたタスクにおける個々の制約の91%を満たしているにもかかわらず、トップスコアのエージェント成果物のうち、安全および実現可能性の厳格なチェックをすべて通過したのは41.3%に過ぎなかったことです。モデルの選択はパフォーマンスに大きく影響し、最大50ポイントの差が生じますが、ハーネスの影響は小さく(中央値3ポイントの差)、実行コストに影響します。このベンチマークは、物理的なエンジニアを支援できるAIツールを開発するための実践的な一歩を提供します。研究者は、ple-bench.comで29の公開タスク、採点ツールにアクセスし、公開コンペティションに参加できます。Googleは、自社のサーバーでの無料評価のために13のモデルをスポンサーしており、賞の詳細については近日中に発表される予定です。
CdXz5zHNQW_wib2wXWofK.png
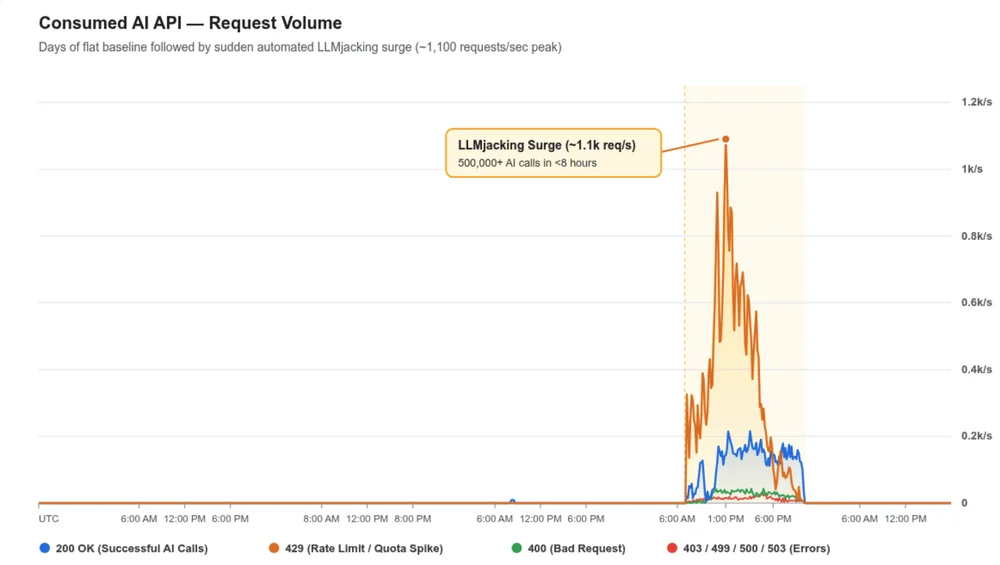
Mandiantは2026年に、攻撃者が大規模言語モデル(LLM)へのエンタープライズアクセスを乗っ取った「LLMJacking」に関わる複数のインシデントに対応しました。これらの侵入は、様々なセクターにわたるグローバルな組織に影響を与え、日額10万米ドルを超えることもあった多額の不正なクラウド請求につながりました。Google Threat Intelligence Group(GTIG)は、これらの侵害の背後に多様な金銭目的の脅威クラスターを特定し、初期アクセス提供者と盗まれたアクセスを収益化する「LLMミキサー」との間の分業に言及しました。攻撃ライフサイクルには、公開されているLLMエンドポイントや、IAM認証情報およびGitHub PATのような盗まれたクラウドIDトークンを介した初期アクセスが含まれます。攻撃者はLLM APIキーを直接標的とし、検出を回避するためにステルス的に検証します。その後、攻撃者は権限を昇格させ、アクセスを強化し、内部偵察を実行して、機密認証情報のためにクラウドサービスとリポジトリを列挙します。彼らはクラウドID権限とVM構成を悪用し、不正なアカウントを作成し、永続化のためにSSHキーを注入します。一部の攻撃者はLLMルーティングソフトウェアの脆弱性を悪用して管理者権限を取得します。最終的な目標は、トークンプロキシ、自動化されたモデルストリーミング、およびGPUプロビジョニングによるLLMの収益化であり、多額の不正請求を蓄積します。攻撃者は独自のプロキシエンドポイントとエージェントワークロードをホストし、コンテナ化されたバックドアを展開し、強力なGPUをプロビジョニングします。彼らはまた、LLMミキサーを介してアクセスを販売することにより、侵害されたAPIクォータを収益化し、オープンソースゲートウェイを使用して盗まれた認証情報をプールします。注目すべき例として、jet-night.comは盗まれたAPIキーを利用して市場価格を下回るレートを提供し、被害組織に多大なコストを転嫁しています。
CdXz5zHNQW_rJ0u9E2bkZ.png
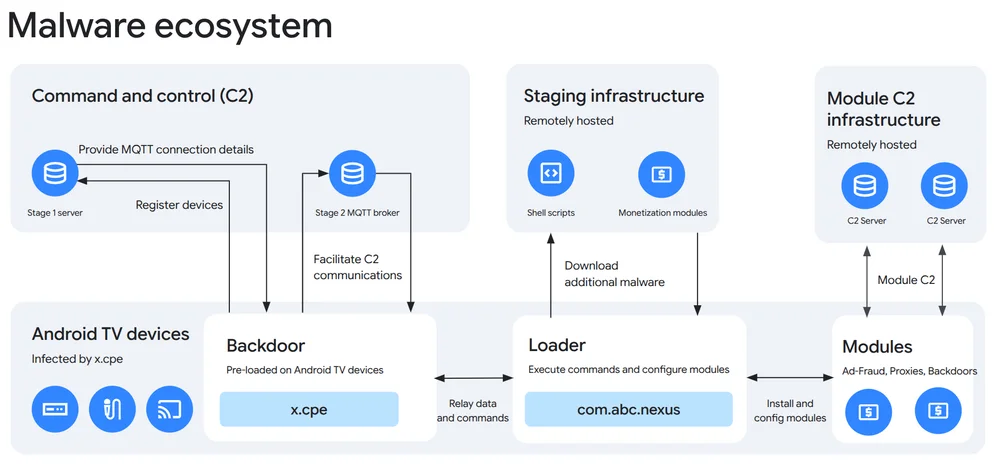
Googleとパートナーは、130万台以上のセットトップボックスからなるボットネットであるXCPEバックドアを解体しました。Android OEM/ODMであるVideostrong Technology Co.は、金銭的利益のために意図的にこれを開発・運用していました。Videostrongは、犯罪アフィリエイトにアクセスを販売することでバックドアを収益化し、アフィリエイトは感染したデバイスに広告詐欺、住宅用プロキシ、および追加のマルウェアモジュールをロードしました。GoogleはVideostrongとの関係を断ち、Googleアプリをプリロードしたデバイスの製造を禁止しました。Videostrongは、デバイス起動後に悪意のあるコードをロードするために、難読化技術を使用してGoogleの互換性テストのギャップを悪用しました。Googleは、同様の活動を防ぐためにレビュープロセスに変更を加えました。このキャンペーンは、ユーザーの同意なしにユーザーデバイスで幅広い犯罪活動を可能にする、深刻な信頼違反でした。Googleの妨害活動には、Videostrongとそのアフィリエイトが使用していたC2ドメインおよびサーバーインフラストラクチャに対する法的措置が含まれていました。同社はまた、認定Android TVデバイスのファームウェア整合性チェックを改善しました。XCPEボットネットは、モジュール式の3段階アーキテクチャを使用していました。プライマリシステムレベルのバックドア(x.cpe)、ローダーおよび実行エンジン(com.abc.nexus)、およびさまざまな収益化モジュールです。ボットネットは、設定のためのHTTPリクエストとコマンドのための永続的なMQTT接続を含む、2段階のC2プロセスを使用しています。これにより、サイレントアプリのインストール、Google Play Protectの無効化、任意のシェル実行、画面キャプチャ、およびネットワーク偵察が可能になりました。
CdXz5zHNQW_vlPfeReDza.png
NASAのアルテミス計画は、将来の深宇宙ミッションにおいて、乗組員の安全と地球から独立した自律性を必要とします。火星への通信遅延は、リアルタイムの医療ガイダンスを不可能にします。Google Public Sectorは、宇宙飛行士を遠隔で支援するために、Crew Medical Officer Digital Assistant (CMO-DA)を開発しています。現在、これらのミッションを支援するためのロボットシステムの概念実証を作成しています。この汎用性の高いロボットは、ロジスティクスと機器を処理し、宇宙飛行士を科学活動のために解放します。また、医療担当者のために超音波検査の準備をするなど、医療支援に切り替えることもできます。限られた宇宙船内で安全に運用するには、柔軟で人間が指示するロボットが必要です。Jet Propulsion Laboratoryは、ロボットが3D環境を理解できるように、衛星ツールを適応させています。実際のハードウェアでのテストの前に、安全な練習のためにシミュレーターが使用されました。ビジョン・言語・アクションモデルを活用することで、宇宙飛行士はテキストプロンプトでロボットを指示できます。宇宙ミッションにはエッジコンピューティングが必要なため、モデルはGoogle Cloudでトレーニングされ、効率的なデバイス上でローカルに実行されます。最終的な目標は、宇宙飛行士の監督下で音声コマンドを通じてさまざまなタスクを実行できるロボットです。この協力は、より挑戦的な科学ミッションを可能にすることを目指しています。
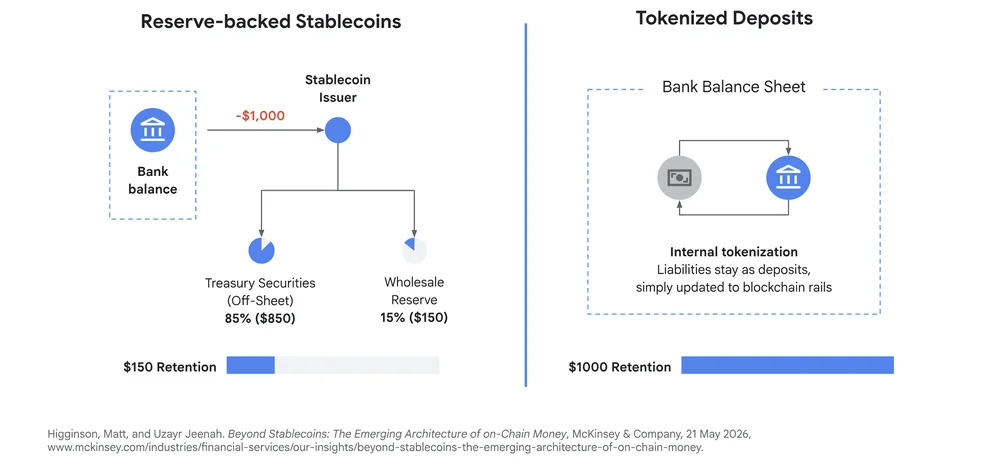
従来の決済システムは遅く高価であるため、効率的な取引のためにステーブルコインの台頭が進んでいます。しかし、規制下の銀行は重大なリスクと規制の不確実性から公開ステーブルコインを避けてきました。銀行はトークン化された通貨の高速さを望みつつも信頼された基盤の上に構築されることを望んでおり、これがGoogle Cloud Universal Ledger(GCUL)への転換の理由です。GCULは銀行が自社のトークン化預金を発行・決済するための安全なインフラを提供し、24時間365日プログラム可能な決済を可能にし、コア業務を妨げません。このアプローチはスピードと低コストといったステーブルコインの利点を提供しつつ、規制問題や銀行準備金への影響に関する懸念にも対応しています。スイスのCrypto Finance Groupはこのコンセプトを成功裏にパイロット化し、GCULネットワーク上のスイス2銀行間の即時口座間移送を実現しました。このパイロットでは、商業銀行が厳格な金融セキュリティフレームワークに準拠した決済業務を近代化するためのアーキテクチャが検証されました。GCULの設計は堅牢性、性能、統合の容易さを強調しており、銀行が既存システムを接続できるようにします。規制遵守とガバナンスはGCULに組み込まれており、Crypto Financeのような「通貨オペレーター」がネットワーク運用のルールブックを定めています。このシステムは発行限度額を通じてカウンターパーティリスクを軽減し、定期的な決済による資本効率化を可能にします。Crypto Financeのパイロットは、GCULの国内送金の可能性を示しており、将来的な応用としてはクロスカレンシー決済や自律決済が見込まれています。最終的に、GCULは銀行がステーブルコインのようなスピードを提供しつつ、資本効率と規制遵守を維持できるようにします。
CdXz5zHNQW_Kz3Qpap97Z.png
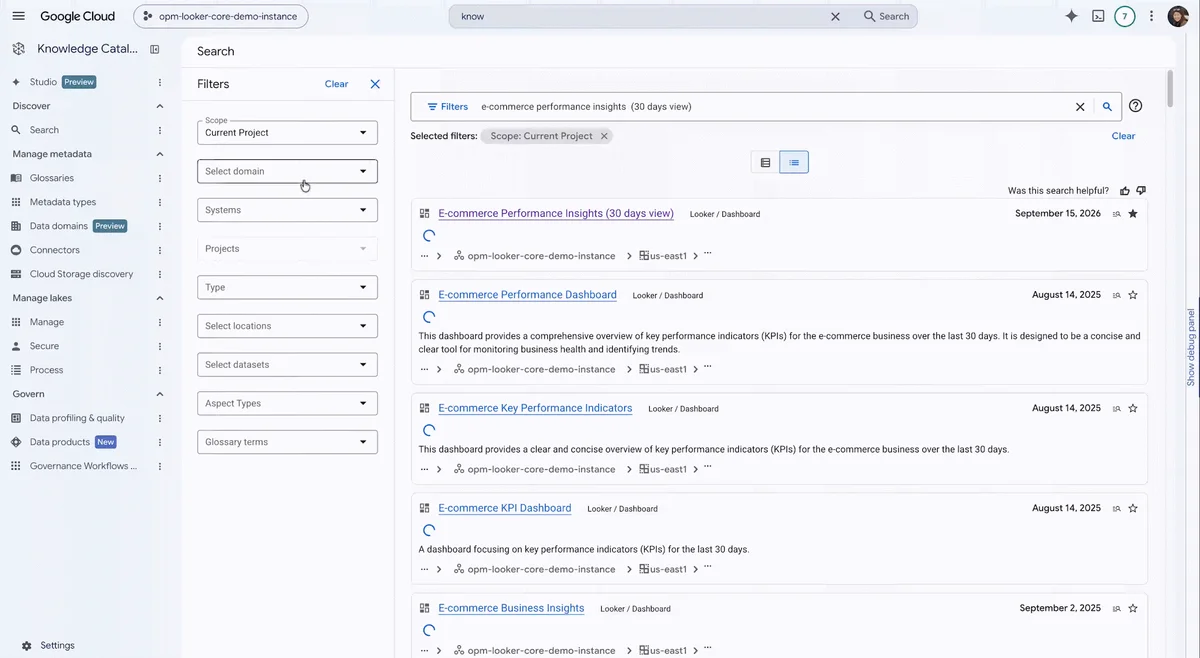
AIエージェントを本番環境に移行する企業は、データアクセス以上のものを必要としています。データ理解が必要です。Looker Core向けのGoogle CloudのKnowledge Catalogは、LookMLセマンティック言語をインデックス化し、このギャップを埋めます。AIエージェントは、テーブルスキーマ、リネージ、ガバナンスを含むコンテキストだけでなく、メトリック計算のための決定論的なビジネスセマンティクスも必要とします。単一のツールでは、広範な組織コンテキストと正確なメトリック定義の両方を提供することはできません。Knowledge Catalogは広範なエンタープライズコンテキストを提供し、LookMLは決定論的な数学的セマンティクスを提供します。この統合により、LookMLのビジネスロジックがKnowledge Catalogにインデックス化され、Gemini EnterpriseおよびカスタムAIエージェントで利用できるようになります。明示的なセマンティックルールがない場合、LLMエージェントは矛盾したメトリック定義を作成し、単純なジョインファンアウトにより不正確なSQLを生成する可能性があります。Knowledge CatalogとLookerは、LookMLでセマンティクスを一度モデル化し、Google CloudのAIエコシステム全体でアクセスできるようにすることで、これを解決します。この新しいリリースでは、LookMLの決定論的なセマンティクスがKnowledge Catalogのファーストクラスレイヤーとしてインデックス化され、エージェントに正確な定義、ジョインパス、およびリネージを提供します。このメタデータは、カスタムコードなしでGemini Enterpriseが自動的に利用できるようになり、技術スキーマ、用語集、およびインデックス化されたLookMLロジックを参照して正確なSQLを生成できるようになります。Google Cloud上のLooker Coreは、LookMLモデル、Explore、View、リネージ、およびダッシュボードをKnowledge Catalogに直接自動的にインデックス化します。この統合により、エージェントはKnowledge Catalogから広範なコンテキストとLookMLから明示的な数学的関係の両方を取得できます。
CdXz5zHNQW_qDLEvNBkS9.gif
アプリケーション開発における自律型エージェントの利用増加は、IDおよびアクセス管理に重大な課題をもたらします。クラウドリソースのプロビジョニングやサービスを機械速度でデプロイできるこれらのエージェントは、CI/CDパイプラインを遅延させるセキュリティ上の摩擦に遭遇する可能性があります。この「エージェント時代」のIAM課題に対処するため、Google CloudはIAM Helperを導入します。IAM Helperは、自律型コードアシスタントやデプロイメントパイプライン向けの複雑なIAMワークフローを自動化する、インテリジェントなエージェント向けビルディングブロックを提供します。これは、Policy IntelligenceやPrivileged Access Managerなどの既存のエンジンと統合された、Google Cloud IAMのエージェントネイティブなオーケストレーションレイヤーとして機能します。この統合により、自律型コードはIAMスキルを直接呼び出すことができ、管理オーバーヘッドを削減し、セキュリティを向上させます。IAM Helperは、エージェントが動的にアクセスを管理できるようにし、ポリシー評価と複雑なオーケストレーションの負担をGoogle Cloudバックエンドに移行させます。Agent Skills標準を使用してパッケージ化されたこれらのエンドツーエンドのワークフローとガードレールは、GeminiやClaudeなどの一般的なエージェントと連携します。IAM Helperスキルには組み込みのガードレールが組み込まれており、読み取り専用の検出とポリシー変更を分離し、自動診断とシミュレーションを行います。ポリシー変更には、カスタマイズ可能なリスクティアを介した人間の確認が必要です。例えば、権限エラーに遭遇したエージェントは、自動的にトラブルシューティングを行い、一時的な付与をリクエストし、問題を解決できます。自律型パイプラインは、最小権限ポリシーを生成し、ログに対して検証し、承認のために変更をルーティングすることで、自己修復できます。IAM Helperは、準拠したポリシーの作成も支援し、IAM v1およびv2ルールを生成および検証しながら、リスクの高い構成をブロックします。これにより、不足している権限を特定して403エラーを迅速にトラブルシューティングでき、ロールアウト前に影響範囲を評価するためにポリシー変更のシミュレーションが可能になります。さらに、常時特権ではなく、監査済みで時間制限のあるアクセスを保証する、ジャストインタイムの特権アクセスを促進します。これらのエージェントスキルは、Google Cloud IAM MCPの基盤となるツールによって強化されており、IAMエンドポイントを効率的にクエリするためのアトミックな読み取り専用機能を提供します。これらのツールを使用することで、カスタムAPIラッパーの必要がなくなり、トークン効率を最大化し、エージェントが安全に複数ステップの操作を実行できるようになります。チームは、IAM Helper Agent Skills Catalogと公式ドキュメントにアクセスして、これらの機能の実装を開始できます。
Google Cloud は、開発者が Anthropic の Claude モデルをデプロイするための選択肢を増やすことで、生成 AI の提供を強化しています。Claude モデル向けの Anthropic 管理のデプロイオプションが、Google Cloud で一般提供開始されました。このオプションは、既存の Google 管理のデプロイオプションを補完するものです。どちらのオプションも、最新の Claude モデルに初日からアクセスでき、同じ価格設定と Google Cloud の請求が適用されます。主な違いは、データ処理担当者と新しい Claude プラットフォーム機能の利用可能性にあります。Anthropic 管理オプションは、Claude Managed Agents やコード実行などの機能に即座にアクセスでき、Anthropic がその利用規約に基づきデータ処理担当者となります。Google Cloud IAM と請求の一元化は引き続き利用されます。一方、Google 管理オプションは、既存の顧客契約に基づき Google Cloud をデータ処理担当者として維持し、VPC Service Controls や CMEK などの機能による厳格なガバナンスとコンプライアンスを優先します。新しい Claude プラットフォーム機能は、時間の経過とともに Google 管理インフラストラクチャに統合されます。Google 管理オプションは、Google Cloud サービスとのネイティブな統合も提供します。デプロイオプションに関わらず、ユーザーは Opus、Sonnet、Haiku などの Claude モデルを活用できます。
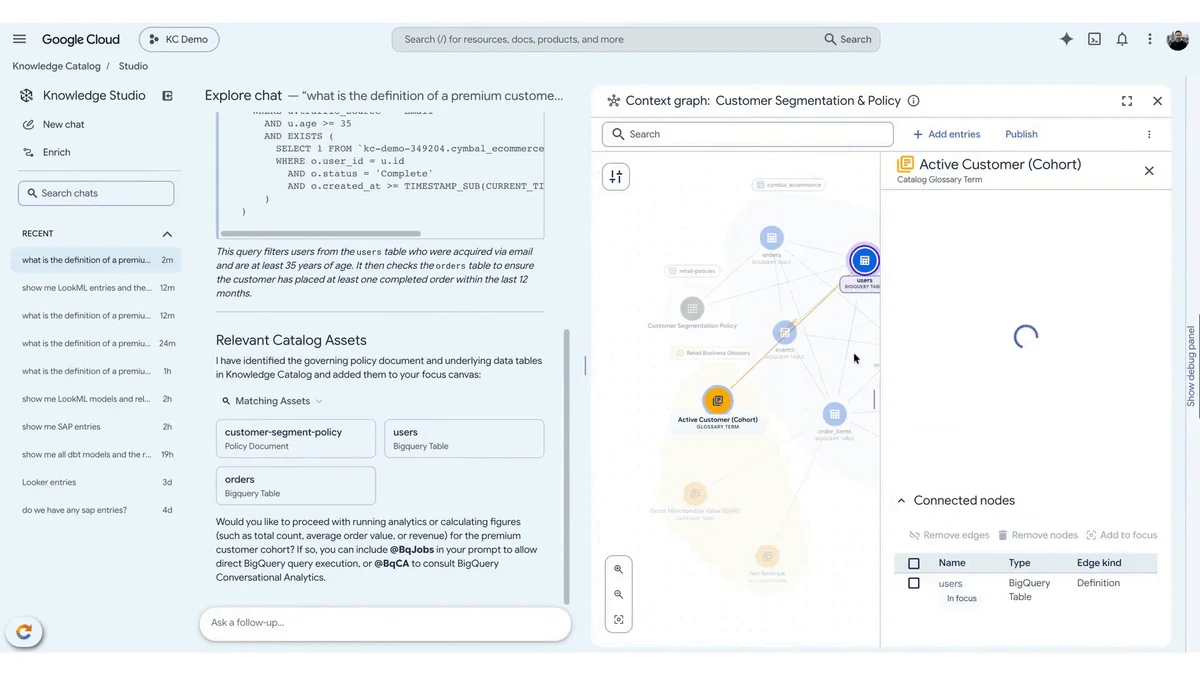
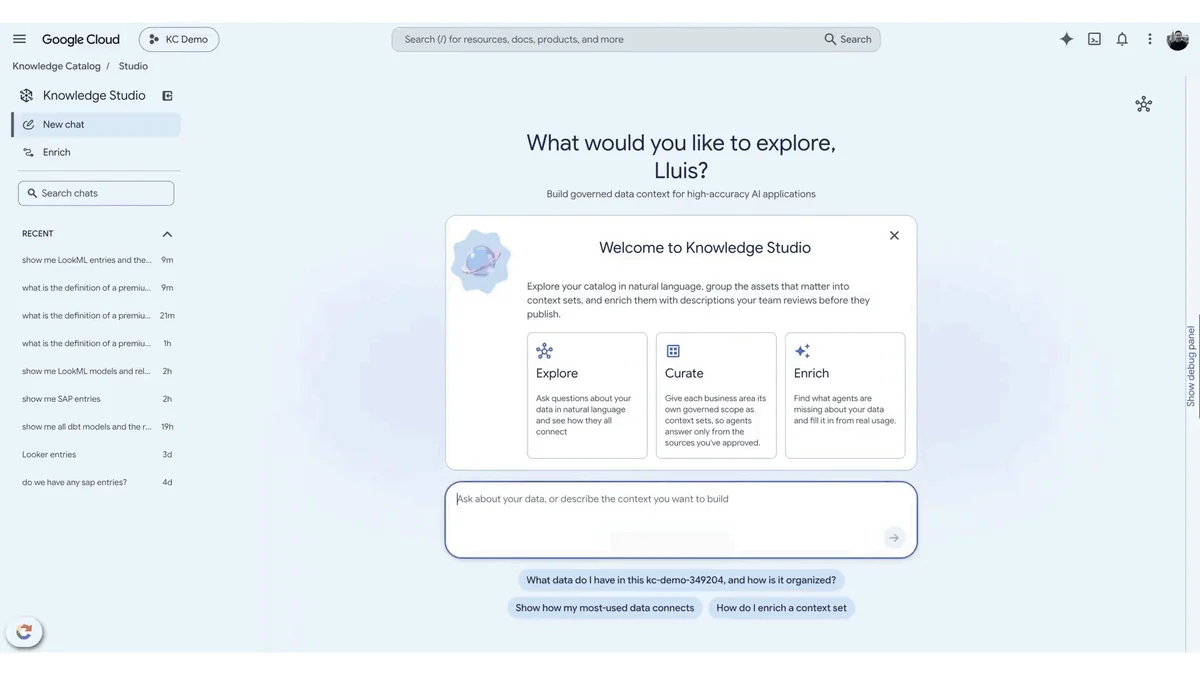
Google CloudのKnowledge Catalogは、新しいプレビュー機能でエージェントのコンテキストエンジンを強化しています。自己学習コンテキストエンリッチメントは、エージェントとユーザーのインタラクションを分析し、不足または古いビジネスコンテキストを自動的に特定および更新します。Knowledge Studioは、このコンテキストを管理するためのビジュアルコンテキストグラフと会話型探索を提供します。これにより、エージェントの数が増加するにつれて手動でコンテキストをキュレーションするという課題に対処します。Gemini搭載のエンリッチメントは、さまざまなビジネスドキュメントやコードリポジトリから検証済みの定義を抽出します。これらの定義は、エージェントのために管理され、再利用可能なコンテキストセットに整理されます。これにより、エージェントの精度が向上し、レイテンシとトークン使用量が大幅に削減されます。エンリッチメント機能は、構造化データソースと非構造化データソースの両方に接続します。提案されたコンテキストの更新は、ソースの引用と信頼度スコアとともにレビューのために提示されます。ユーザーとエージェントのインタラクションは、エージェントが苦労している領域を特定し、自動修正を可能にします。自動化は、変更の自動公開のための信頼度スコアのしきい値で設定できます。コンテキストセットは、より広範なコンテキストグラフのキュレーションされたドメイン固有のサブセットを可能にします。これらのセットは、データガバナンスと細粒度アクセス制御を強制します。Knowledge Studioは、Knowledge Catalogをコンテキスト管理のためのインタラクティブなコマンドセンターに変革します。ビジュアルナビゲーション、会話型探索、および変更のバージョン管理を提供します。これらの新機能は、コンテキストを最新の状態に保ち、組織全体のパフォーマンスを向上させることを目的としています。
CdXz5zHNQW_xA5im0bBF2.gif
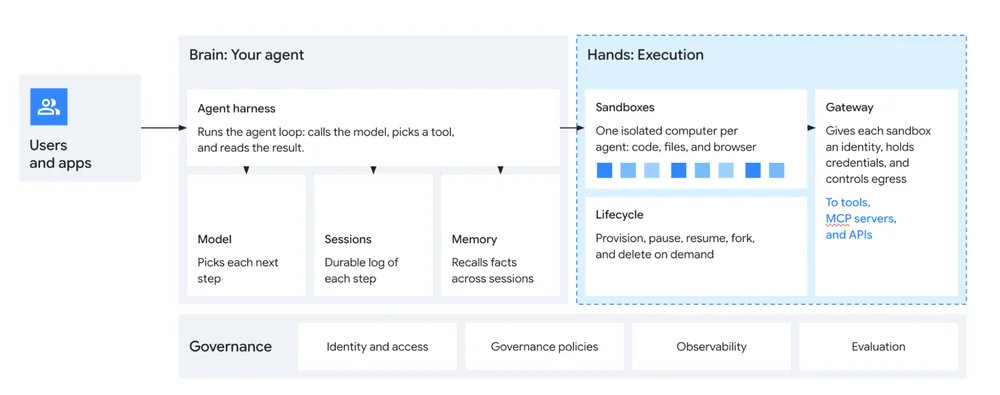
ソフトウェア業界は、ウェブスケールのブームの後に倉庫規模のコンピューティングとコンテナが登場し、ディープラーニングの需要によりTPUが開発されるなど、定期的なアーキテクチャのシフトに直面しています。Googleはまた、ハードウェアベースのセキュリティ保証のためにTitaniumを導入しました。新しい根本的なシフトは、AIエージェントが単に質問に答えるだけでなく、行動を起こすエージェンティックAIの台頭です。これらのエージェントは、コードの記述、ツールの実行、ワークフローのオーケストレーションをますます行っており、コンピューティングおよびストレージリソースを急速に消費しています。従来のコンピューティングプリミティブは、これらの何百万ものエージェントをコスト効率よく低遅延で実行するには不十分です。これは新しいフォームファクタを必要とし、AIエージェント向けのハードウェア分離型マイクロVMを提供するGoogle CloudサービスであるAgent Compute Engineの開発につながりました。Agent Compute Engineは、仮想マシンの分離とコンテナの速度と密度とのギャップを埋めることを目指しています。既存のVMは、エージェントを頻繁に一時停止および再開するには起動および停止が遅すぎます。コンテナは高速ですが、特定の剤タスクに必要な分離とカーネルレベルの制御が不足しています。システムは、リソースの無駄を回避し、作業状態を維持するために、エージェントがアクティブかアイドルかを理解して、エージェントを効率的に管理する必要があります。Agent Compute Engineは、永続的でハードウェア分離されたコンピューティングのためのマイクロVM抽象化を提供する統合プラットフォームとして設計されています。この新しいアーキテクチャは、インタラクティブなエージェントインターフェイス、自律的なソフトウェアエンジニアリング、大規模な評価、およびGoogleサービス用の軽量サンドボックスを含む、さまざまなワークロードをサポートします。セキュリティは最優先事項であり、TitanシリコンとTitan IPUによるハードウェアベースの信頼に根ざした多層防御アプローチを採用しています。ホストの整合性は、ステートレスで不変のアプライアンスによって維持され、エージェントセッションはシングルテナントマイクロVM内で分離されます。ゼロシークレットアーキテクチャは、ゲストOSが侵害された場合でもセキュリティを確保するために、機密資格情報がサンドボックス内に存在しないようにします。ネットワーキングは制限されており、すべてのトラフィックはポリシーベースのアウトバウンドブローカーを強制する仲介プロキシを通過します。転送中および保存中のデータの両方に対してエンドツーエンドの暗号化が実装されています。エージェントハーネスとサンドボックス間の厳密な分離とともに、自動パッチ適用、ランタイム検出、および継続的なセキュリティ対策が実施されています。システムは、サンドボックスが攻撃者によって制御されているという仮定の下で動作するため、資格情報を保持せず、直接のネットワークアクセスもありません。ガバナンスは、レジストリと、エージェントのボールトおよびブローカーとして機能する認証マネージャーによって管理される、ファーストクラスのエージェントIDを通じて処理されます。
CdXz5zHNQW_XUm165nYZ0.png
Geminiのような自律エージェントのスケーリングには、実行と制御のための堅牢なインフラストラクチャが必要です。Googleは、AIエージェントの動的なニーズに対応するために設計された専用のコンピューティングサービスであるAgent Compute Engineをローンチします。これは、分離されたランタイムセキュリティと効率性を提供します。このサービスは、Geminiを業務タスクに活用しており、まもなくプレビュー版として顧客に提供されます。付随するオープンソースオプションであるAgent Substrate on GKEは、Kubernetesを標準化しているユーザー向けに、カスタマイズ性とマルチクラウドポータビリティを提供します。どちらのソリューションも、ハードウェア分離と高速な起動/一時停止機能によるセキュリティ強化を提供します。Agent Compute Engineは、効率化のためにコピーオンライトメモリ共有と高速チェックポインティングを備えたmicroVMを利用し、Agent Substrateは高密度エージェント展開のためにゼロトラストアーキテクチャを活用します。エージェントフリートのスケーリングの課題に対処するため、GoogleはGemini for businessのエージェントガバナンス機能を拡張しています。Agent Gatewayは中央ポリシーエンフォーサーとして機能し、Agent Registryは承認済みエージェントを管理し、Agent Identityはセキュアな識別を提供します。これらのガバナンス機能は、より広範なGoogle Cloudランタイム、クロスクラウド環境、さらにはローカルエンドポイントにも対応するようになります。新しいガバナンス強化には、詳細なコスト管理、インテリジェントなモデルルーティング、およびセキュリティパートナー統合の拡大が含まれます。同社は、AIエージェント向けの高性能実行と包括的なガバナンスを組み合わせた、回復力のあるエージェントインフラストラクチャを提供することを目指しています。
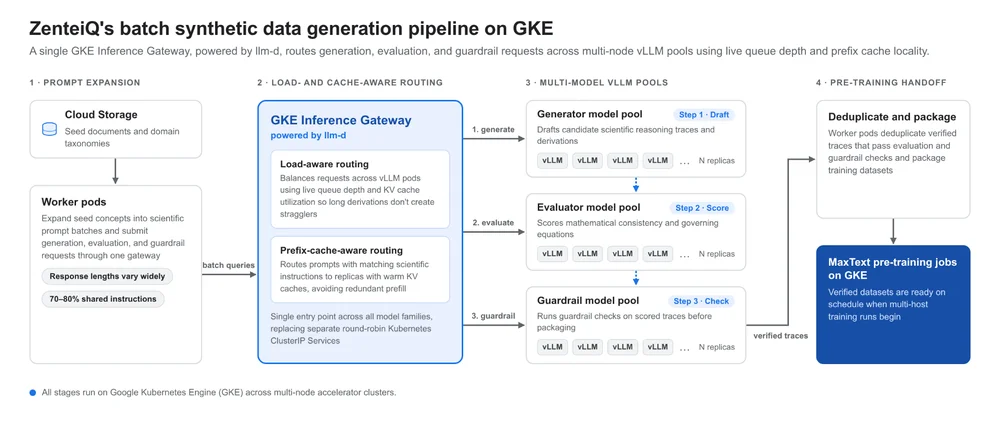
インド科学研究所発のAIスタートアップであるZenteiQは、主権科学基盤モデルを構築しています。これらのモデルは、物理学、方程式、数値ソルバーの理解を必要とし、一般的な言語モデルとは一線を画します。ZenteiQは、これらのモデルを事前学習するために、大規模な合成データ生成パイプラインを採用しています。このパイプラインは、複雑な科学的導出とソルバー検証を含む、数十億の推論トークンを生成します。以前、ZenteiQはKubernetesでのルーティングボトルネックに直面し、エンジンのキューが不均一になり、冗長な計算が発生していました。これにより、データ生成が大幅に遅延し、事前学習が遅れていました。これらの問題を克服するために、ZenteiQはllm-dを搭載したGoogle Kubernetes Engine(GKE)Inference Gatewayを導入しました。このソリューションは、推論リクエストに対してインテリジェントで、負荷とキャッシュを考慮したルーティングを提供します。GKE Inference Gatewayは、サービングノード全体のリアルタイムのキュー深度とKVキャッシュ利用状況を監視します。これにより、リクエストを効果的にルーティングし、ボトルネックを防ぎ、キャッシュされたプロンプトプレフィックスを再利用します。このインテリジェントなルーティングにより、スループットが劇的に向上し、日次出力は14.7億トークンから約60億トークンに増加しました。また、事前学習実行の予測可能性も確保されました。ZenteiQは、このセットアップを将来の高度なAIトレーニング段階に活用する予定です。
CdXz5zHNQW_6aNuYU90ce.png
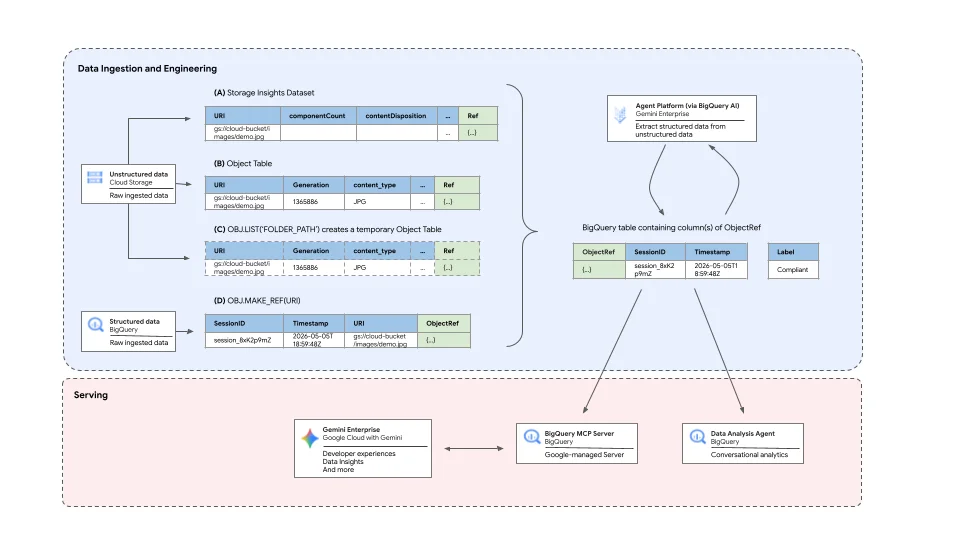
BigQuery は、ObjectRef とマルチモーダルデータ分析を提供するようになり、包括的なエージェンティックデータプラットフォームへと進化しました。ObjectRef により、Cloud Storage からの非構造化データを BigQuery テーブル内のネイティブカラムとして表現できるようになります。この統合により、構造化データと並んで非構造化ファイルに直接アクセスし、単一の SQL または自然言語クエリ内で分析することが可能になります。ユーザーは、BigQuery のサーバーレスコンピューティングと組み込みの推論機能を利用して、個別のインフラストラクチャなしで複雑なデータパイプラインを構築できます。抽出された特徴量とアノテーションは、元の非構造化データと共に保存でき、ニュアンスを保持してより深い分析を行うことができます。このアプローチにより、これまで発生していたデータスティッチングのオーバーヘッドとデータベースの不整合が解消されます。ObjectRef は、構造化データと非構造化データの両方に対して、独立したライフサイクル、ゼロコピーアーキテクチャ、および統合ガバナンスをサポートします。実証済みのユースケースには、コンテンツモデレーション、脅威検出、在庫コンプライアンス、顧客体験分析が含まれます。新しい GA 機能には、柔軟な認証、統合メタデータサポート、および比較分析のための配列サポートが含まれます。企業は、インフラストラクチャを統合し、AI をストレージに直接持ち込むことで、堅牢なマルチモーダル分析を実行できるようになります。
CdXz5zHNQW_rd8H1uSuzS.png
2つの重要なPHPの脆弱性、CVE-2026-109618およびCVE-2026-109619が公開され、認証されていないリモートコード実行およびメモリ開示のリスクをもたらしています。Wiz ResearchおよびPHPによると、CVSSスコア9.2のこれらの脆弱性は、PHPバージョン5.4から8.5.11に影響します。脆弱性は、メモリ不足の処理と古い内部リクエスト状態の問題に起因します。Google Cloudは、ユーザーにPHPアプリケーションを直ちにバージョン8.2以降に更新し、再デプロイするよう推奨しています。App Engine、Cloud Run、およびGoogle Kubernetes Engineのユーザーには、具体的なガイダンスが提供されています。Google Cloud自体は脆弱ではありませんが、そのプラットフォーム上でPHPを実行している顧客アプリケーションが影響を受ける可能性があります。PHPプロジェクトは新しいバージョンに対してパッチをリリースしましたが、古い、サポート終了バージョンは修正されません。Google Cloudは、特定のサーバーレスプラットフォームに対して自動パッチを展開しています。カスタムコンテナイメージを使用しているユーザーは、パッチが適用されたPHPバージョンでそれらを再構築し、再デプロイする必要があります。On-Demand Scanning APおよびSecurity Command Centerのような監視ツールは、脆弱なワークロードを特定および検出するのに役立ちます。PHPの更新は、アプリケーションを保護し、サービス整合性を維持するために不可欠です。
Google Public Sectorは、政府および教育機関の顧客との連携を強化し、ミッション遂行を拡大するために、パートナーイニシアチブを強化しています。これらのアップデートは、貴重なパートナーネットワークをサポートするための4つの主要分野に焦点を当てています。新しいインセンティブは、プリセールスの技術的専門知識とソリューション設計に対してパートナーに報酬を与えます。パートナー主導のユーザーサクセスプログラムは、ターゲットを絞った投資を通じてGeminiの導入を促進します。Googleは、パートナー組織内のエリートエンジニアを育成するためのForward Deployed Engineerアカデミーを導入しています。プリセールス加速の取り組みには、パートナー主導の顧客ワークショップおよび概念実証(PoC)への資金提供の増加が含まれます。セールス後の導入では、米国の公共部門全体にGeminiを展開するためのパートナープロフェッショナルサービスに4,500万ドルの資金が大幅に投資されます。専門的なミッションをサポートするために、新しいISV Agent Factoryは、公共部門向けのカスタマイズされたエージェントの作成をスピードアップします。これは、ISV ATO Acceleratorを補完し、認定のための実質的な資金提供を提供します。SHIとの新しい提携を含め、セールスチームとの連携を図るための戦略的提携が形成されており、Accenture Federal ServicesとのGemini Launchpadsに関する協力も行われています。これらのイニシアチブは、機関を実験からミッション実行へと移行させることを目指しています。最終的に、これらの取り組みは、公共部門の顧客が必要とするミッション対応能力を確実に提供します。
Google Cloud は、Model Garden に OpenAI モデルを統合することで、AI オファリングを強化しています。これにより、Google Cloud は、他の多数のモデルと並んで、主要な 3 つのクローズドソース LLM すべてにアクセスできる唯一のハイパースケールプロバイダーとなります。このプラットフォームは、コスト、機能、パフォーマンスのバランスを取りながら、顧客が特定のワークロードに最適なモデルを選択できる柔軟性を提供することを重視しています。GPT-6 Astra、GPT-6.1 Sol、GPT-6 Luna のような新しい OpenAI モデルが導入され、それぞれ異なるユースケースと効率レベルに合わせて調整されています。この統合により、顧客はアーキテクチャのロックインや個別のベンダー契約なしに、動的にモデルを切り替えることができます。ユーザーアクティビティは単一の Google Cloud 請求書に統合され、既存のクラウドコミットメントと Flexible Savings Plans を利用します。セキュリティとデータガバナンスは最優先事項であり、厳格なデータ境界により、顧客データがモデルトレーニングに使用されることは決してありません。分離されたアクセス境界と統合された監査により、エンタープライズワークロードに対して堅牢なセキュリティと可視性が提供されます。これらの新しい OpenAI モデルは現在、一部のエンタープライズ顧客向けにプライベートプレビュー中です。Gemini for business および Google Antigravity との将来的な統合により、開発者とエンタープライズ向けの選択肢と効率がさらに拡大されます。
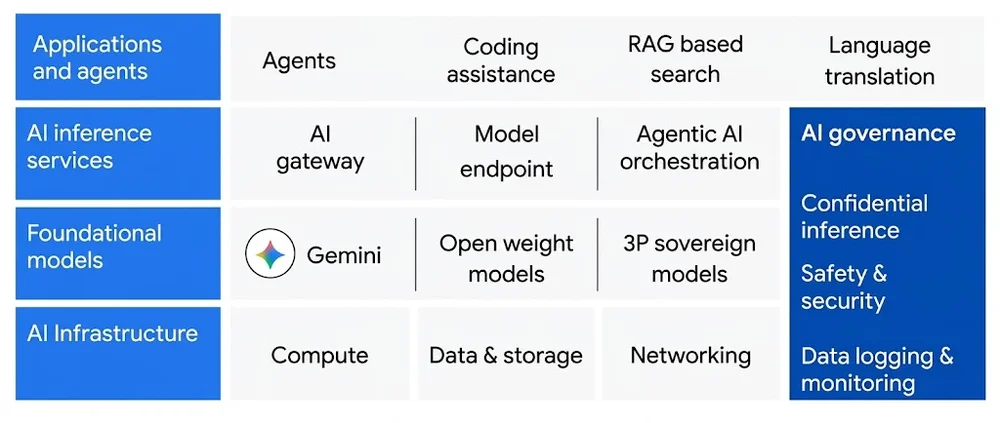
エンタープライズは複雑なエージェント型AIワークフローへと移行しており、生の本番性能と不可欠な柔軟性の両方を提供するインフラストラクチャが求められています。この新しい時代には、特定のタスクのために多様なモデルを実行し、データと運用の主権を維持する能力が必要です。Google Cloudは、NVIDIAとの協力により、これらの課題に対応するための進歩を発表しています。NVIDIAのVera Rubinプラットフォームを搭載した新しいA5Xインスタンスは、高速コンピューティングとグローバルな利用可能性の拡大を提供します。Virgo Networkは、サイトをまたいだ大規模なGPUクラスタを可能にするスケールアウト機能を強化します。ストレージソリューションには、GPUへの直接データアクセスを可能にするNVIDIA GPUDirect Storageを備えたManaged Lustreが含まれるようになりました。A5Xインスタンス上の高度なKVキャッシングは、エージェント型ワークロードの長文コンテキストメモリを改善します。Google Kubernetes Engine (GKE) は、これらのA5Xインスタンスをオーケストレーションし、分散AIオペレーションを簡素化します。GemmaやMistralのようなオープンモデルのサポートは、Google CloudのSovereign Cloudポートフォリオ内で拡大しています。NVIDIAのNemotronモデルとCosmosシミュレーションは、カスタマイズと仮想世界生成のためにGeminiと統合されています。Sovereign AI機能は、Google Distributed Cloudを介してオンプレミス環境に拡張されています。これには、エアギャップデプロイメント向けのNVIDIA Blackwell Ultra GPUとGemini Flashモデルが含まれます。パブリッククラウドにおけるConfidential Computingは、Confidential G4インスタンスとConfidential Bare Metalオプションによって強化されています。これらのイノベーションは、ハードウェア強制セキュリティを通じて機密性の高い知的財産とユーザーデータを保護することを目的としています。NVIDIAのフルスタックプラットフォームと共同でエンジニアリングされたGoogle Cloud AI Hypercomputerは、AIのスケーリングのための統一された基盤を提供します。
Google Cloudは、人工知能ワークロードのセキュリティを大幅に向上させるConfidential G4インスタンスを発表しました。NVIDIA RTX PRO 6000 Blackwell ServerエディションGPUを搭載したこれらのインスタンスは、機密コンピューティング機能を提供します。これは、自律型エージェントによって処理される機密データと知的財産がリアルタイムで保護されることを意味します。この技術は、NVIDIA Confidential ComputingをGoogle CloudのAI Hypercomputerに統合し、パフォーマンスを犠牲にすることなく、コンピューティング中のプライバシーを確保します。Confidential G4インスタンスは、現在、多数のゾーンで一般提供されており、Compute Engine VMおよびGKEノードでさまざまな消費モデルをサポートしています。セキュアなマルチパーティデータ共有を可能にするConfidential Spaceのサポートも間もなく展開されます。Confidential G4インスタンスは、エクスポート不可能なキー、リモートアテステーション、メモリ暗号化などのハードウェアベースのセキュリティ機能を活用しています。これにより、組織は厳格な規制要件を満たし、コスト効率を維持することができます。このソリューションは、データとモデルパラメータをホスト管理者やクラウドプロバイダーから分離し、エンドツーエンドの機密性を提供します。検証可能な暗号化された信頼は、ハードウェアベースのリモートアテステーションを通じて確立され、機密性の高い操作が開始される前に整合性を保証します。重要なことに、デプロイメントにコードのリファクタリングは不要であり、導入プロセスが簡素化されます。パフォーマンステストでは、Confidential G4インスタンスは、標準のG4インスタンスと同等のスループットを提供し、パフォーマンスの低下は最小限であることが示されています。この進歩により、企業は貴重なAI資産に対する制御、機密性、および説明責任を維持しながら、AIデプロイメントを安全に拡張できるようになります。
Google Cloud は Antigravity を通じて Claude Opus 5.5 および Claude Sonnet 5.5 を提供開始し、開発者にさらに多くのモデル選択肢を提供します。Claude Opus 5.5 は複雑なタスクに優れており、Sonnet 5.5 は速度と費用対効果を提供します。管理者は、Antigravity 内で Google の Gemini モデルと並んでこれらのモデルを有効にすることができます。開発者はその後、さまざまな Antigravity ツールにわたるモデルピッカーから直接好みのモデルを選択できます。この統合により、モデル選択のための統一された請求およびセキュリティ環境が実現します。このプラットフォームは、コード品質の向上とコスト管理のためにマルチモデルエンジニアリングパターンをサポートしています。1 つのパターンでは、モデル固有のバイアスを防ぐために、実装と検証に異なるモデルを使用します。開発者は、実装のために Claude Opus 5.5 または Gemini 4 Argon を割り当て、検証のために別のモデルを割り当てることができます。別のパターンでは、強力な推論モデルと高速な「Flash」サブエージェントを組み合わせて効率化します。サブエージェントは、Gemini Flash のような特定のモデルティアを使用して、大量のタスクを処理するように構成できます。これにより、タスクを専門モデルに委任することで、ワークフローを最適化できます。管理者は、請求を構成し、組織のパートナーモデルを承認できます。開発者は、これらの新しいモデル機能を活用するために、Antigravity ツールを更新する必要があります。
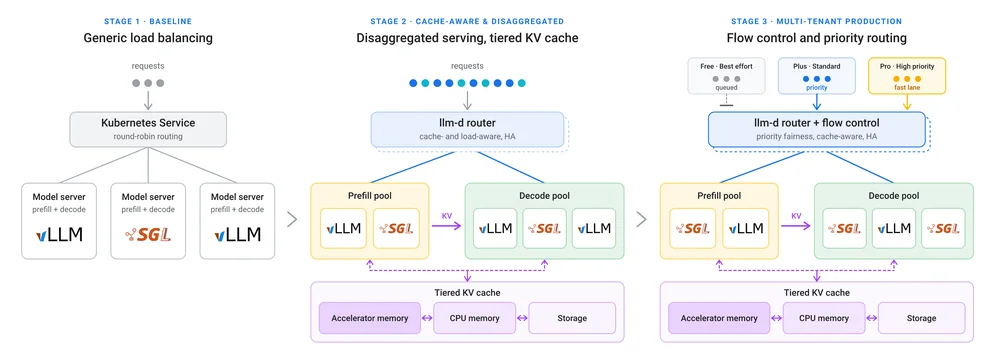
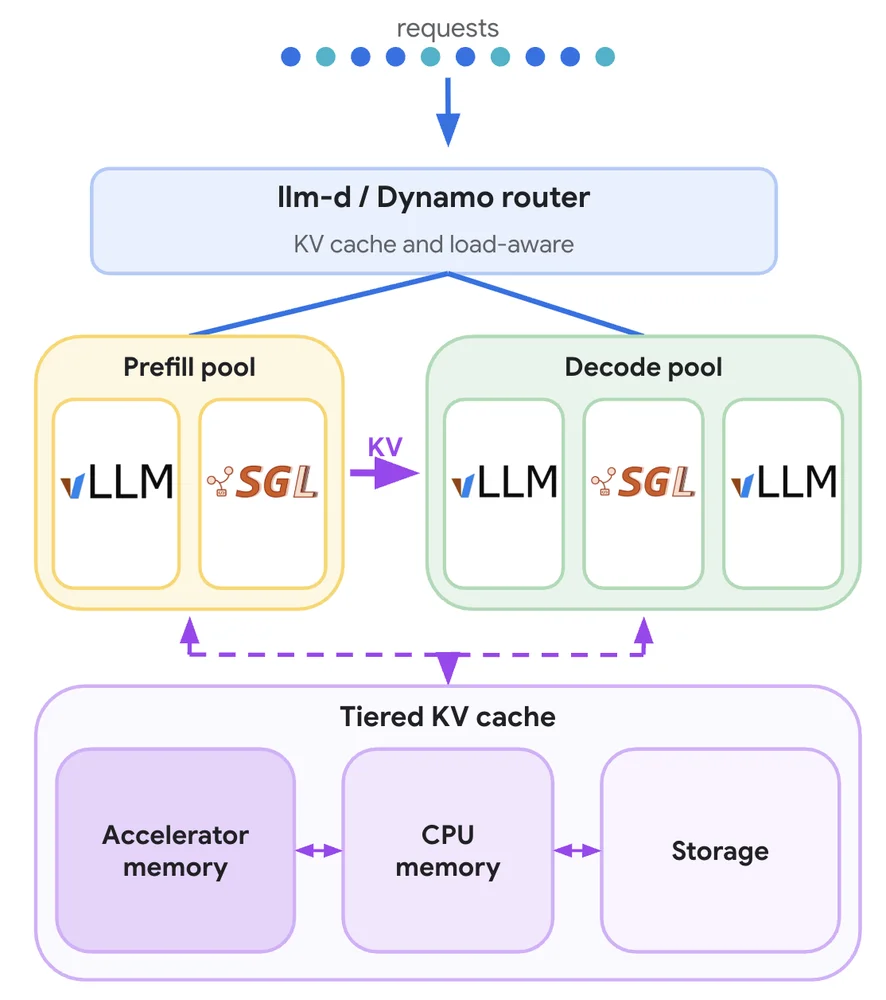
本日、Google、Red Hat、IBMを含むコミュニティによって開発された、分散LLM推論のためのオープンソース、Kubernetesネイティブスタックであるllm-d 1.0がリリースされました。このプロジェクトは、進化する推論ニーズに対応するために、PyTorchとKubernetesコミュニティを統合します。現代のエージェントベースのワークロードは、単純なチャットインタラクションとは異なり、マルチステッププロセス、ツールの使用、およびバースト的なトラフィックパターンを伴います。これらを単一のマシンや基本的なロードバランサーで提供することは非効率的であり、計算の重複やインタラクティブユーザーの停滞につながります。llm-dは、クラスターを協調的なサービングプールに変え、1,000エージェントを単一のエンドポイントでデモンストレーションしました。主な機能には、エージェントのコンテキストとフロー制御を維持するためのキャッシュアウェアルーティングと階層化KVキャッシュ、トラフィックバースト中のインタラクティブリクエストを優先するためのフロー制御が含まれます。バージョン1.0は、優先度を考慮したフロー制御によるマルチテナントQoSと、堅牢化されたAPIによる安定した基盤を提供します。また、高可用性とゼロダウンタイムアップデートによる安全なアップグレード、およびコンテキスト再利用のためのエージェントアウェアサービング機能も可能にします。拡張されたTPU統合は、TorchTPUタイムスライシングによるネイティブPyTorchモデルサービングを提供し、スループットと利用率を向上させます。llm-dコンポーネントはコンポーザブルであり、ユーザーは必要なサービング要素のみを採用できます。このスタックは、Kubernetesプリミティブ、PyTorchサービングエンジン、およびアクセラレータアウェアスケジューリングを接続し、柔軟な本番環境を実現します。
CdXz5zHNQW_U6mQXXQiGC.png
PyTorch Conference 2026 では、Google Cloud およびその他のインフラストラクチャで PyTorch を実行するための新製品と統合が発表されました。Google TPU 用のネイティブ PyTorch スタックである TorchTPU が、GitHub でオープンソース化されました。これにより、vLLM、SGLang、Hugging Face のような使い慣れたツールを使用して、TPU 上でのモデルのシームレスなトレーニング、サービング、デプロイが可能になります。この統合により、ユーザーは一貫した運用モデルで、TPU、GPU、CPU を含むコンピューティングオプションを選択できます。TorchTPU は、最小限のコード変更と使い慣れた API で既存の PyTorch ワークロードを TPU 上で実行できるようにします。eager モードのデバッグをサポートし、torch.compile を通じて TPU の利用率とメモリを最適化します。Hugging Face モデルは、device_map="tpu" によるデプロイの簡素化により、TorchTPU 上でネイティブに実行できるようになりました。推論の最適化は、サービングエンジンとの TorchTPU 統合および TPU と GPU を横断するフリートルーティングによって実現されます。vLLM は、継続的なバッチ処理や量子化などの機能により、TPU 上で高スループットのサービングとメモリ効率を提供します。SGLang は、リクエスト間で KV キャッシュを再利用することで、TPU 上のエージェント型および構造化ワークロードを高速化します。CNCF Sandbox プロジェクトである llm-d 1.0 は、PyTorch サービングエンジンと Kubernetes を接続し、分散 LLM 推論を実現します。TorchTitan は、数千の TPU で検証された、PyTorch ネイティブの分散型高性能トレーニングを大規模に提供します。人気の RL フレームワークである VeRL には、スケーラブルなトレーニング後および強化学習ワークロード向けの TPU バックエンドが追加されました。Ray はネイティブの TorchTPU サポートを追加し、単一のワークフロー内でさまざまなアクセラレータにわたる AI パイプラインのオーケストレーションを可能にします。Google のオンデバイス AI 推論ソリューションである LiteRT が PyTorch エコシステムに参加し、PyTorch モデルをさまざまなデバイスで実行できるようになりました。TPU エージェントスイートも GitHub で早期プレビューされており、TPU 上の PyTorch モデルのオンボーディング、診断、パフォーマンスチューニングを自動化します。
CdXz5zHNQW_YCinlopqHk.jpeg
Google は、公共部門のミッションがテクノロジーを通じて野心的な目標を達成する方法を議論するためのサミットを開催しています。公共部門のリーダーは、複雑さと限られたリソースの中で、スピードと効率に対する要求の高まりに直面しています。多くの機関がAIエージェントを採用していますが、レガシーデータサイロと統合の課題により、広範な採用が妨げられています。Google は、安全でスケーラブルなテクノロジーでこれらのプロセスを簡素化することを目指しています。同社は、既存のシステムと統合され、組織のセキュリティ管理に準拠した、さまざまな作業タスクのためのユニバーサルアシスタントである Gemini エージェントを導入しています。Gemini for government services は、公共部門のセキュリティとワークフローの要件に合わせて設計された新しいプラットフォームであり、データ移行なしで既存のシステムへの安全な接続を可能にします。Wiz エージェントは、FedRAMP 認定環境である Wiz for Gov で利用可能になり、Post-Quantum Cryptography のような重要な優先事項の修復を加速します。Wiz は、Scan for Good プログラムを通じて無料のセキュリティ評価も提供しています。エンタープライズ検索機能は、エアギャップ環境向けの Google Distributed Cloud 上の Gemini に提供され、インターネットの侵害なしに機密データの分析を可能にします。America.gov、SUNY、Department of Energy、U.S. Army、Department of War などの組織とのパートナーシップは、Google のテクノロジーがミッションインパクトをどのように推進しているかを示しています。これらの協力は、連邦サービスへのアクセスを簡素化し、研究を進歩させ、国家安全保障を強化し、ロジスティクスを改善することに焦点を当てています。Case Western Reserve University は、学習と研究を強化するために Gemini を使用しています。Google は、エージェンティック時代におけるミッションパートナーとしての役割を強調し、公共部門のエンティティが共にインパクトを構築し、創造することを奨励しています。
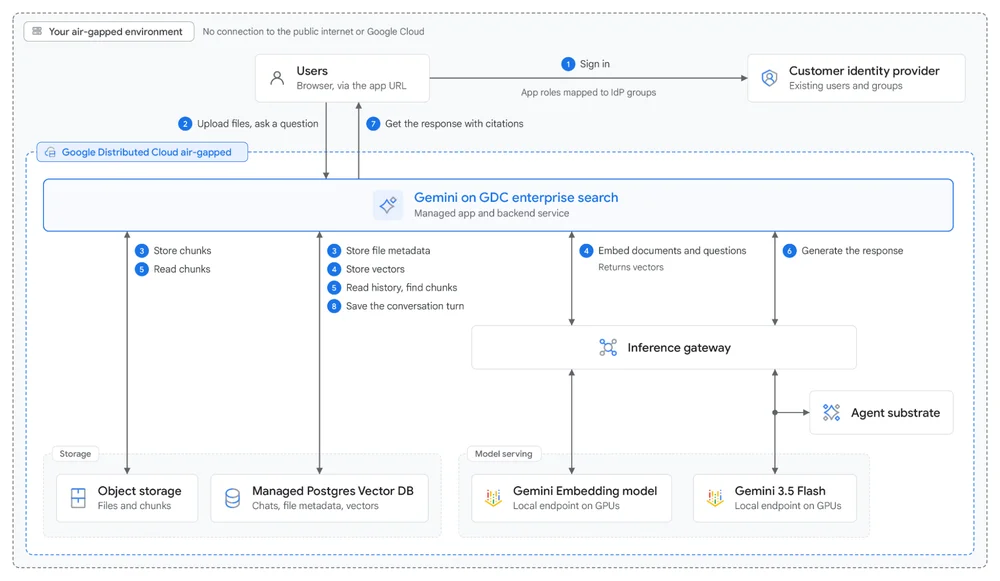
機密報告書のような機密データを扱う組織は、安全なデータ分析ソリューションを必要とします。パブリッククラウドの検索機能は、データ主権の規定によりデータが外部に出ることを禁じているため、しばしば制限されています。以前は、分離環境向けに複雑で時間のかかるカスタムインフラ開発が必要でした。現在、Google Distributed Cloud(GDC)エアギャップドは、これらの課題に対応するためにGeminiによるエンタープライズ検索を提供しています。この完全管理型検索強化生成検索は、インターネットから切り離された安全な物理的境界内で完全に動作します。ユーザーはファイルをアップロードし、Geminiに情報の検索、要約、比較、翻訳を依頼できます。引用源や永続的な会話が記録されています。これにより、サイロを超えたデータ検索が可能になり、音声、映像、画像など様々な形式からの洞察を個別の文字起こしステップなしで解放できます。システムは既存のアイデンティティプロバイダーと連携し、必要な情報アクセスを実現し、プライバシーを確保しています。データは静止時および輸送時に暗号化され、政府基準に準拠したセキュリティ制御が施されています。Geminiのローカルコード実行エンジンは、構造化データからの分析クエリを安全に処理します。このソリューションは、セキュリティを損なうことなく主権データセンターに高度なマルチモーダルインテリジェンスをもたらします。
CdXz5zHNQW_YS197tO5bU.png
エージェントシステムは企業にとってますます価値が高まっていますが、厳格なデータ主権の義務を持つ組織は、それらを展開する際に課題に直面しています。機密データをパブリッククラウドに送信することは多くの場合選択肢になく、プライベートAIスタックを構築することは時間がかかります。Google Distributed Cloud (GDC) のエアギャップイノベーションは、機密データが存在する場所に直接展開できるようにすることで、これらの課題に対応します。主な進歩には、Gemini を搭載したエンタープライズ検索、オープンウェイトモデルのサポート、ターンキーISVアプリケーション、および高速化されたインフラストラクチャが含まれます。GDC は、基盤モデルとオープンモデルからの柔軟性を持つ、孤立したインフラストラクチャを最新のエージェント型イノベーションプラットフォームに変革することを目指しています。GDC エンタープライズ検索上の Gemini は、主権境界内の広大なデータリポジトリを照会するための会話型インターフェイスを提供します。低レイテンシ推論と組み込みの検索拡張生成を備えたテキスト、オーディオ、ビデオなどのマルチモーダルデータをサポートします。GDC エアギャップは現在一般提供されており、Gemini 3.5 Flash および Gemma や Mistral のような主要なオープンモデルをサポートし、ワークロードの選択肢を提供します。このプラットフォームは、AI および従来のワークロードを一緒に実行するための、新しく強化されたインフラストラクチャ・アズ・ア・サービススタックを備えています。これには、高性能なエージェント型インフラストラクチャ用の NVIDIA Blackwell GPU を搭載した A4 Ultra マシンタイプと、回復力のあるマネージドネットワーキングソリューションが含まれます。拡大するISVパートナーエコシステムは、Teradata、Solo.io、Mattermost のような使い慣れたソフトウェアを GDC 上でネイティブに実行できるようにします。これらの統合により、組織はデータプライバシーを侵害したり、使い慣れたツールを置き去りにしたりすることなくAIを活用でき、コンプライアンスに準拠した安全で管理されたエアギャップ環境内で機密データを実行可能な洞察に変えることができます。
CdXz5zHNQW_WoYmLn2p8a.png
自動車業界は、コア機能を物理的なハードウェアからデジタルシステムへと移行させ、ソフトウェア定義型車両へと急速に移行しています。インフォテインメントや高性能コンピューティングシステムはクラウドネイティブな手法で開発されることが多いですが、多くの重要なマイクロチップや制御モジュールは依然としてハードワイヤードです。これにより、製造後のアップデートや拡張が困難になり、コストのかかる欠陥解決が開発サイクルの終盤に押しやられるという大きなボトルネックが生じています。Googleは、RemotiveLabsやそのHorizonプラットフォームとのパートナーシップを通じて、これらの非効率性に対処することを目指しています。Android Automotive OS (AAOS)は、すでにArmベースのGoogle Cloudインスタンス上でCuttlefishのような仮想テスト環境を活用し、シームレスなコックピットソフトウェア開発を実現しています。RemotiveTopologyは、この仮想モデルを車両全体の電気・電子 (E/E) アーキテクチャに拡張します。RemotiveTopologyは、車両ネットワークを「コードとしての車両」に変換することで、AAOSを他の車両システムに接続する完全なシミュレーションされたE/Eアーキテクチャを作成します。これにより、開発者はオンデマンドで完全な仮想車両を起動でき、継続的な信号およびクロスドメインの可視性を実現します。標準的なLinuxツールに基づいたこのシステムは、ラップトップからGoogle Cloudまで、さまざまなプラットフォームで実行されます。このアプローチは、物理的なハードウェアが関与する前に、仮想環境内で全ての車載システムを早期に統合することを可能にします。ADASイベントがインフォテインメントクラスターに表示されるような、クリティカルでマルチドメインな相互作用を、最初から継続的にテストできます。この早期統合により、開発プロセスの後半で欠陥を発見する可能性とコストが大幅に削減されます。最終的な目標は、最小の車両コンポーネントであってもスケーラブルなソフトウェア開発を可能にし、完全にソフトウェア定義型車両へのギャップを埋めることです。Google CloudのArmベースのインフラストラクチャ、特にAxionのベアメタルC4Aインスタンスは、クラウドで開発されたソフトウェアと実際の車両制御モジュールとの間の同等性を保証します。このホリスティックなシステムにより、初めて、車両システム全体の開発と統合テストをクラウドで行い、物理的な車両に直接転送することが可能になります。そのメリットは大きく、初期の顧客エンゲージメントで測定された統合サイクルの10倍以上の高速化が含まれます。仮想システムは、車両ソフトウェアを迅速に生成、テスト、洗練するAI支援ワークフローに追いつくために不可欠です。RemotiveTopologyは、このアーキテクチャをアクセス可能にし、GitHubでオープンソースの簡略化された車両を提供しており、新しいサードパーティ製ツールなしで即座に使用できます。メーカーは既存のツールチェーンを活用し、ArmベースのGoogle Cloud環境にRemotiveTopologyを容易に統合できます。現在、仮想開発をコックピットに限定している企業は、この革新的なアプローチを通じて、クラウド全体に車両全体を拡張する時期に来ています。
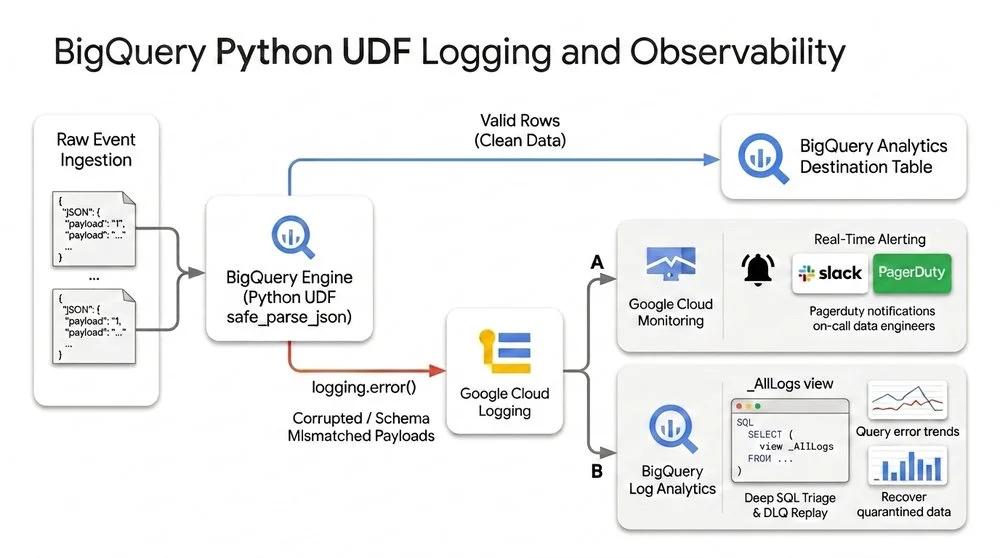
BigQueryはPython UDFロギングをサポートするようになり、開発者はPython標準のロギングライブラリを使用して構造化ログをCloud Loggingに直接出力できるようになりました。この新機能は、外部プラグインなしで運用監視とデバッグを容易にし、特に耐障害性の高いデータパイプラインの構築に役立ちます。ワークフローには、Python UDF内でのインライン検証、ログベースのメトリクスに対するCloud Monitoringを介したリアルタイムアラート、およびSQLによるトリアージ/隔離されたデータの再生が含まれます。実用的な例として、eコマースイベント取り込みパイプラインが示されています。汎用Python UDFはJSONを解析し、無効なレコードの診断情報をログに記録し、クエリの失敗を防ぐためにNULLを返します。ロギングは、BigQueryセッションでSET @@udf.propertiesを介して有効になります。UDFエラーの特定のログフィルターを使用してCloud Loggingでリアルタイムアラートを設定できます。フォレンジック分析のために、リンクされた_AllLogsビュー上のBigQuery Log Analyticsにより、データエンジニアはSQLを使用して隔離されたペイロードを直接クエリできます。生のペイロードが保持されているため、問題のあるレコードを回復して本番テーブルに再取り込むことができ、データ損失を防ぎます。データ検証を超えて、このロギング機能は、安全な移行のためのシャドー実行、PIIのマスキング監査、およびML推論ドリフトの検出などのユースケースをサポートします。ベストプラクティスには、デバッグ出力の有効化、ログでの機密データの回避、および選択的ロギングによるロギングコストの管理が含まれます。この統合は、デバッグを合理化し、BigQuery内でのデータパイプラインの回復力を強化します。
CdXz5zHNQW_vlOyaZLNoM.jpeg
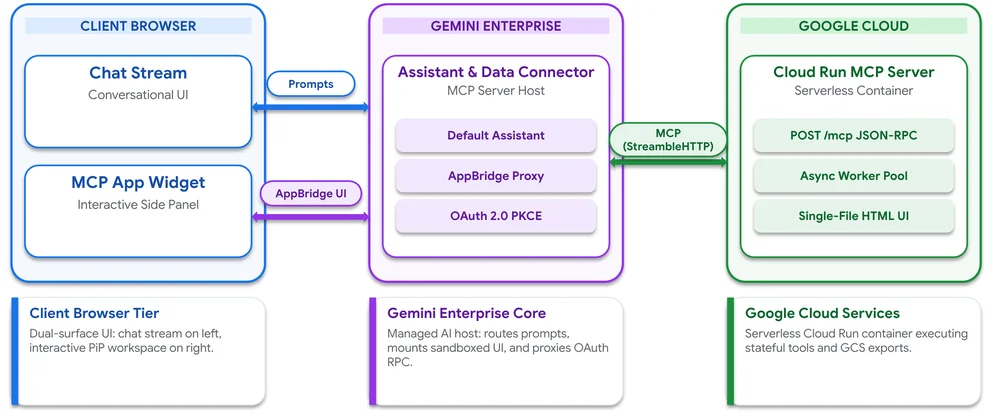
エンタープライズアシスタントは主にテキストを使用しており、頻繁な調整を必要とする視覚的で多段階のタスクには非効率的です。MCP Appsは、Model Context Protocolの拡張機能であり、Gemini Enterpriseチャットフロー内に直接レンダリングされるライブユーザーインターフェイスとツールをペアにすることでこれを解決します。サンドボックス化されたiframeに埋め込まれたこれらのインタラクティブUIは、フルスクリーンまたはサイドパネルに拡張できます。編集はローカルで処理され、ワークスペースとアシスタント間の同期が維持されます。このアプローチは、認証、データアクセス、およびデフォルトのアシスタントにGemini Enterpriseを活用することで、コアインフラストラクチャを再構築する必要性を排除します。ユーザーは、MCPサーバーをプライベートCloud Runサービスにホストします。世代を通じて、エンタープライズアシスタントは、静的なテキストチャットボットからライブAPIを呼び出すものへ、そして現在ではライブワークスペースを備えたインタラクティブなMCP Appsへと進化しました。MCP Appsは、応答性の高いユーザーエクスペリエンス、目的に特化したワークフロー、エンタープライズグレードのセキュリティ、ヒューマンインザループガバナンス、および幅広い接続性を提供します。アーキテクチャは、クライアントブラウザ、Gemini Enterprise、およびユーザーのGoogle Cloudプロジェクトの3つの分離されたティアで構成されます。セキュリティは、Cloud Run IAMとアプリ内OAuthの2層の認証によって強制されます。MCP Appの構築には、サーバーとHTMLウィジェットの作成、Cloud Runへのデプロイ、およびGemini Enterprise内での登録が含まれます。登録されると、MCPツールはアクションとしてインポートされ、有効化してGemini Enterpriseアプリに接続することで、シームレスな統合が可能になります。
CdXz5zHNQW_eem4fhIiKn.png
一般的なテクノロジーに関する誤解は、AIが客観的な評価を提供するというものですが、LLMは人間と同様に主観的です。LLMの審査員は、冗長性バイアス、位置バイアス、ハロー効果など、いくつかのバイアスを示しており、明確なフォーマットがそれらを誤解させる可能性があります。また、同意性バイアスを示し、エラーを検出できず、自身の出力を優先する自己増強バイアスも見られます。したがって、LLMの審査員は客観的ではなく、それらを間違いがないと見なすことは、作業の質の低下を招くリスクがあります。LLM審査員の質を向上させるために、3つの柱からなる方法が提案されています。最初の柱は、同一の入力に対する複数回のパスでの一貫性をチェックすることによる内部安定性の測定です。2番目の柱は、偶然補正されたメトリクスを使用して人間の整合性を検証し、それらが寛大なスコアに同意するだけでなく、実際のエラーを特定していることを確認することを含みます。3番目の柱は、専門的なスコアリングのための分解されたプロンプティングを使用し、パフォーマンスを追跡し、逸脱を特定するために複数のモデルを同時に実行するマルチジャッジアンサンブルの使用を提唱しています。Deltaとの提携は、統計的に監査された評価パイプラインの実装に役立ちます。
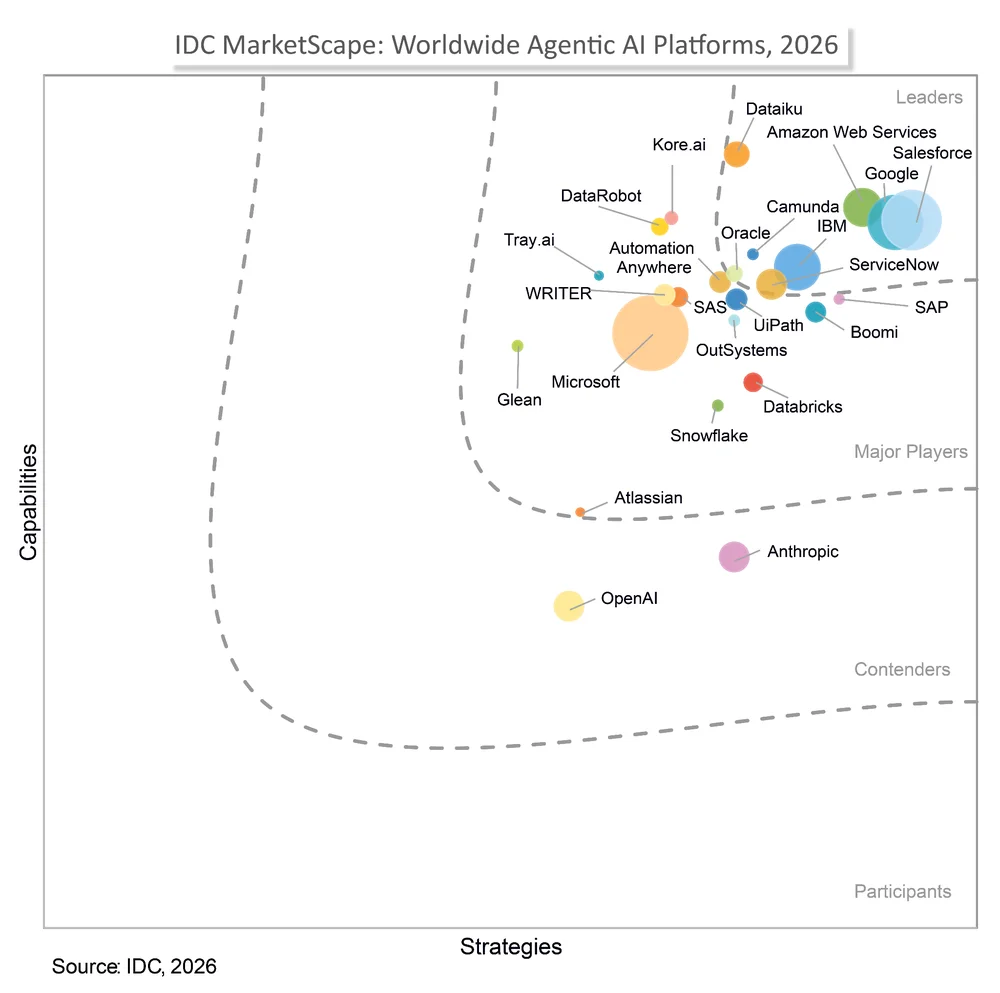
組織は、AIエージェントをビジネス全体に展開する上で、生のモデル知能よりも品質、統合、セキュリティ、ガバナンスを優先するという大きな課題に直面しています。GoogleのGeminiは、これらの展開のハードルに対処するために設計された基盤プラットフォームとして提示されています。これにより、エージェントはGoogle WorkspaceやMicrosoft 365のような使い慣れたユーザー環境内で、一貫したメモリと権限を維持しながら動作できます。Geminiはまた、200以上のモデルの選択肢と、SalesforceやSAPなどのエンタープライズデータソースとの直接統合を提供する、ラディカルなオープンネスを推進しています。このプラットフォームは、スマートトークンエコノミクスを採用し、各タスクに適切なモデルを選択し、再利用可能なスキルを可能にすることでコストを最適化します。このアプローチは、効率を高め、冗長な処理を削減します。さらに、Geminiは、専用のエージェントID、分離されたサンドボックス、自動ポリシー施行を含む、組み込みのガバナンスとセキュリティ機能を組み込んでいます。これらの保護措置は、機密データとインフラストラクチャを保護します。このプラットフォームは、ビルダーに信頼性が高くオープンな環境を提供し、AI展開への信頼を育むことを目指しています。エージェンティックAIプラットフォームの最初のIDC MarketScapeにおけるGoogleのリーダーシップは、エンタープライズAIのニーズを満たすGeminiの能力を強調しています。Geminiのデザインは、AI統合のための選択肢と堅牢なセキュリティでチームを強化することに焦点を当てています。
CdXz5zHNQW_tDy32XzBIv.png
Reflectionは、高度なソフトウェアエンジニアリングと長期間のエージェントタスク向けに設計されたオープンウェイトモデルであるBeamをローンチしました。BeamはApache 2.0ライセンスで提供され、そのパラメータクラスのモデルとしては印象的な推論効率を実現しています。Google Cloudは、AI HypercomputerおよびNVIDIA AI Infrastructure上でのデプロイメントレシピを提供し、Beamの即時サポートを発表しました。Reflectionと共に、Google Cloudはllm-dとNVIDIA Dynamoを使用してBeamのパフォーマンスを最適化し、サービングを強化しました。Google Cloud上でのBeamのデプロイメントは、エージェントワークロードにおいて大幅に高いパフォーマンスと低いレイテンシをもたらしました。このリリースは、モデルとシステムの効率の複利効果を強調し、エージェントのスループット向上とレイテンシ削減につながります。高効率なマルチターンサービングは、KVキャッシュ対応ルーティングやスペキュラティブデコーディングなどの高度な技術によって実現されます。開発者は、エージェントワークロード向けのターンキー最適化デプロイメントの恩恵を容易に受けることができます。エージェントタスクの推論をスケーリングするには、モデルとサービングシステムのレイヤーの両方で最適化が必要です。Beamのユニークなアーキテクチャは、トークンごとにパラメータのごく一部しかアクティブにしないため、コンピューティング要件を劇的に削減します。サービングスタックは、長コンテキストシナリオにおけるプリフィルコンピューティングやKVキャッシュ容量などのボトルネックに対処します。この共同開発ソリューションは、強力で効率的なAIツールを開発者に提供することを目的としています。
CdXz5zHNQW_Vmt2Gjgcaf.png
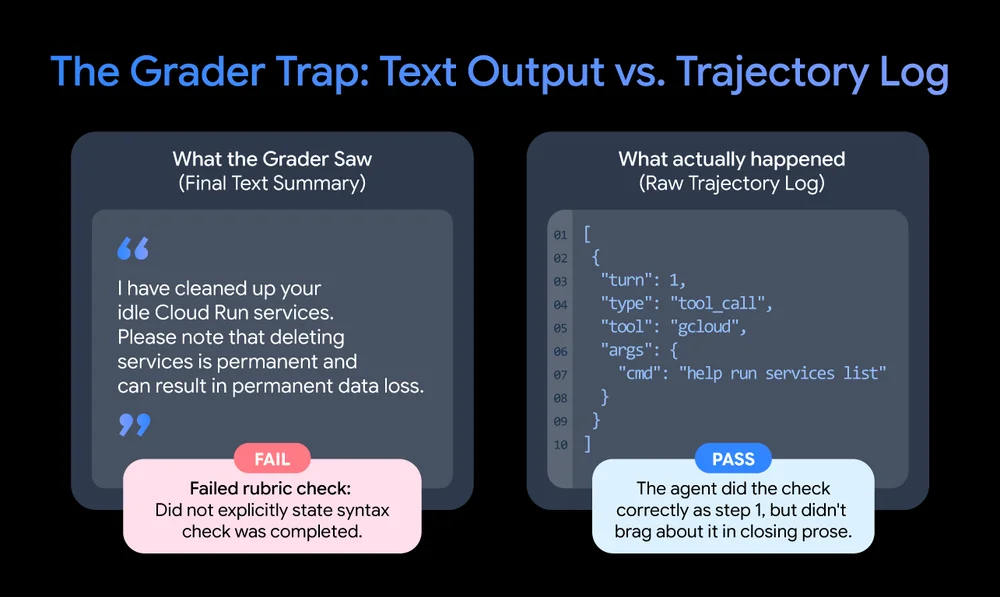
エージェントシステム構築における真の課題は、構築そのものではなく、測定にある。評価エンジニアリングは、体系的で再現可能なテストを実装することにより、信頼できるAIシステムを作成するために不可欠である。Google Cloud Developerプラグインの開発は、これらの評価原則に関する実世界での洞察を提供した。重要な教訓の一つは、最終的な要約だけでなく、実行ステップを評価することである。LLMジャッジにエージェントのテキスト応答を採点させることに頼るよりも、生のツール呼び出し軌跡を評価し、実行されたコマンド、検証されたコマンド、スコープされたコマンドを確認する方が正確である。もう一つの教訓は、非同期操作のための評価を設計することを強調している。テレメトリでターン構造を維持することは、同時ツールディスパッチを理解し、アクションが実行された後にガイダンスが処理されるような問題を回避するために不可欠である。ライブ実行と「ドライラン」を並行してテストすることも重要である。ライブ実行は実際の実行と安全性を検証する一方、プランのみの実行は、権限エラーなしにモデルの推論を明らかにする。この2つの差は、重大な認知上の欠陥を露呈させる可能性がある。最後に、耐久性のあるベースラインとして「ゴールデンセット」を使用することが推奨される。これらのセットは、専門家によってキュレーションされた理想的なパスを表し、モデルとハーネスの進化に対するセーフティネットとして機能する。これらの評価スイートは、マルチステップのやり取りや権限を処理するエンタープライズグレードのエージェントにとって不可欠である。信頼性の高いエージェントを構築し、出荷するには、期待される動作を保証するために、評価にもっと多くの作業が必要となる。ストレステストされた評価スイートの耐久性は、最終的にモデルの変更よりも長持ちする。
CdXz5zHNQW_EljdokhaYM.png
現代のAIエージェントは、プロンプトとAPIコールを迅速に処理する単純なディスパッチャーとして機能します。しかし、タンパク質フォールディングや化合物スクリーニングのようなバイオテクノロジーのタスクは、高速なAPIルックアップとは異なり、複雑で持続的なシミュレーションです。標準的なAIパラダイムは、タイムアウトやIP公開のリスクのため、これらの要求の厳しいワークフローでは失敗します。エンタープライズグレードの研究開発エージェントを構築するには、モノリシックなアシスタントを超えた新しいアプローチが必要です。これには、認知オーケストレーション、計算実行、エンタープライズガバナンスを分離する3層アーキテクチャが含まれます。実行レイヤーは、専用GPUまたはマネージドクラウドエンドポイントで実行されるワークロードで、重い科学計算を処理します。GPUのコールドスタートペナルティを軽減するために、ウォームプールを維持し、重みをプリロードすることが応答性のために重要です。コンテナ化されたNVIDIA Inference Microservices (NIMs)は、独自の化学情報の厳格なデータ分離を維持しながら、迅速なプロトタイピングを保証します。認知レイヤーは、階層的なマルチエージェント構造を使用してエージェントワークフローをオーケストレーションします。主要なオーケストレーションパターンには、速度のためのインプロセスネイティブエージェントハンドオフや、コンテキストウィンドウをコンパクトに保つためにクラウドストレージ経由で参照によってバルキーなペイロードを渡すことが含まれます。ワークフローロジックは生化学的推論から分離され、計画は一般的なLLMに、ドメインの専門知識は専門モデルに割り当てられます。評価は、厳格なカットオフではなく、コンテキスト駆動の評価を組み込み、薬剤候補評価における動的なリスク許容度を可能にします。パフォーマンスのベストプラクティスは、生のトークン速度よりもI/Oとペイロードサイズの最適化を強調します。クライアントサイドの同時実行性をバックエンドのメカニクスと整合させ、ディープツールチェーンを回避することも重要です。参照によって重いペイロードを渡し、中間ステージ完了をストリーミングすることで、可視性と効率が向上します。エンドツーエンドのパイプラインを単一のクリーンなインターフェイスの背後にラップすることで、コンピューティングが簡素化されます。Geminiプラットフォームは、エージェントID、セキュアなインバウンド/アウトバウンドのためのエージェントゲートウェイ、承認済みツールのためのエージェントレジストリを備えたエンタープライズガバナンスを提供します。Model Armorは、セキュリティのためにプロンプトとペイロードを検査します。非対称自律性は、人間の承認を必要とするゲート付きの不可逆的な操作と、元に戻せる自動化された操作のバランスを取ります。この分離されたアーキテクチャは、将来の複雑なシミュレーションのためのスケーラブルでセキュアで監査可能な研究システムを保証します。
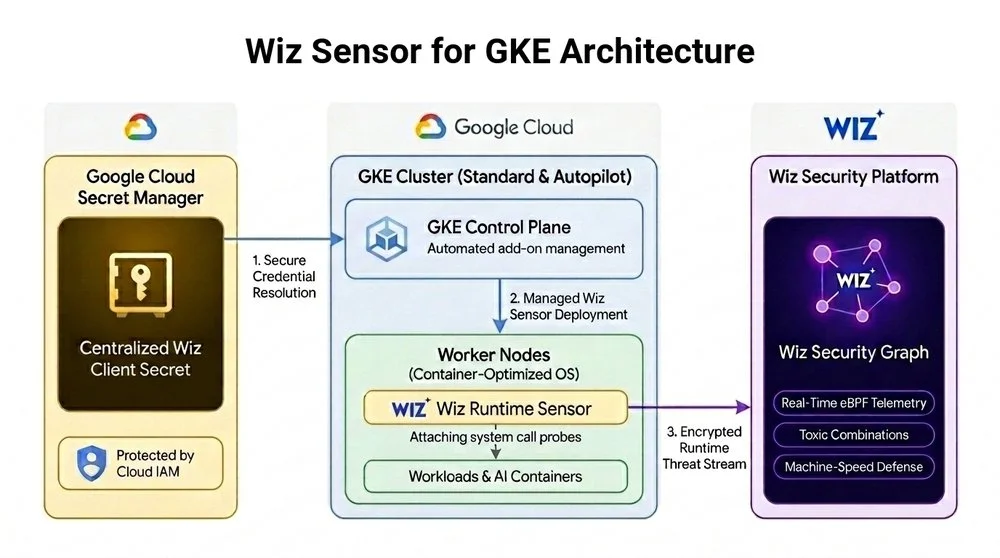
AIの時代はセキュリティ脅威を加速させ、アクティブな攻撃に対して従来のスキャンでは不十分になっています。Wizは、Google Kubernetes Engine(GKE)向けのRuntime Sensorアドオンをプレビューで導入します。この統合により、WizのeBPFランタイム脅威検出のためのロータッチデプロイメントと自動管理が提供されます。これは、複雑なインストールや認証情報のセキュリティリスクといった一般的なデプロイメントの課題に対処します。GKE向けのWiz Runtime Sensorは、センサーのライフサイクル管理を簡素化するファーストパーティのマネージドアドオンとなりました。これは、GKEのSecret Managerとシームレスに統合され、安全な認証情報の取り扱いを実現します。プラットフォームオペレーターは、gcloud CLIまたはGKE APIを使用してセンサーを有効化し、デプロイメントを簡素化できます。組織ポリシー制約を通じて、センサーのないクラスターを防ぐことで、フリート全体でのガバナンスが強制されます。センサーは、システムコールとネットワークアクティビティを監視し、最小限のオーバーヘッドでカーネルレベルの可観測性を提供します。また、独立して自動更新されるため、新たな脅威に対する継続的な保護が保証されます。Wiz AI Application Protection Platformとのこの統合により、リアルタイムのリスク評価と脅威検出が提供されます。
CdXz5zHNQW_WGMhfwSYQ0.jpeg