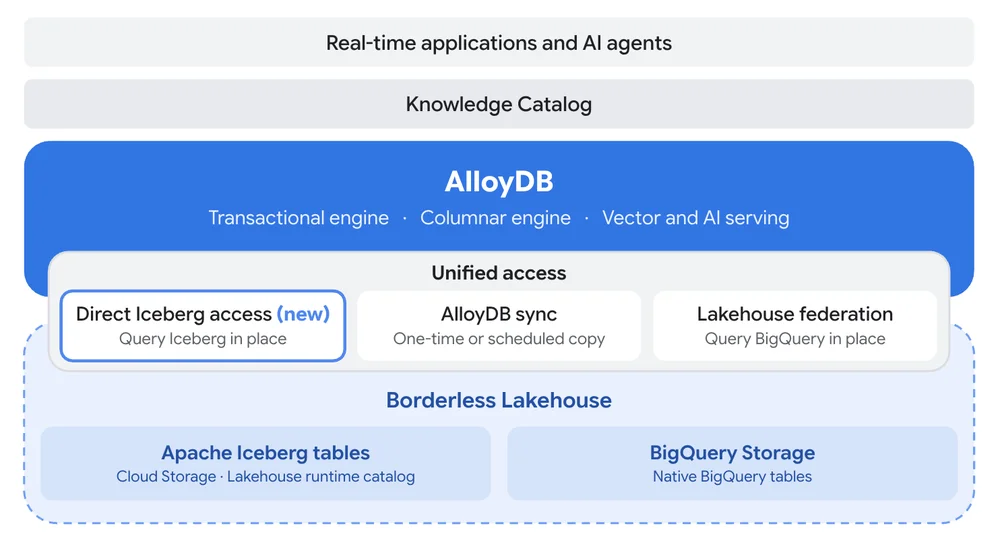
AlloyDB for PostgreSQL での Iceberg への直接アクセスによる、オペレーショナルデータと Lakehouse データの統合
効果的な意思決定のためには、ビジネスはリアルタイムの運用データと履歴分析データの両方を必要とします。従来は別々であったこれらのデータシステムが、AlloyDB for PostgreSQLの新機能によって統合されつつあります。Google Cloudは、開発者がクラウドストレージ上のApache IcebergテーブルをAlloyDBから直接クエリし、単一のSQLクエリでライブデータと結合できるようにする、直接Icebergアクセスを導入しています。プレビュー段階にあるこの統合は、他のサービスと比較して集計クエリの速度が大幅に向上しています。さらに、AlloyDB syncとLakehouse federationが一般提供開始され、「ボーダーレスなLakehouse」と対話するための3つの主要な方法が提供されます。直接Icebergアクセスは、AlloyDBの列指向エンジンを活用して高速化し、Icebergテーブルをインプレースで読み取ります。AlloyDB syncは、低レイテンシで頻繁にアクセスされるワークロードのために、BigQueryからAlloyDBにレイクハウスデータをコピーし、ユーザー定義のスケジュールで更新されます。Lakehouse federationは、AlloyDBがネイティブなBigQueryテーブルを直接クエリできるようにし、処理はBigQueryが担当します。これらの統合により、カスタムパイプラインの必要がなくなり、アプリケーションやAIエージェントが運用データとレイクハウスデータを組み合わせてシームレスに活用できるようになります。実際の例としては、不正検出、パーソナライゼーション、動的価格設定などがあり、レイクハウスからの履歴コンテキストがデータベース内のリアルタイムの意思決定に役立ちます。データチームは、キュレーションされたテーブルを一度Icebergに公開し、複数のアプリケーションがそれをインプレースで読み取れるようにすることもできます。直接Icebergアクセスにより、他のPostgreSQLテーブルと同様にIcebergテーブルを登録およびクエリでき、組み込みサポートと列指向エンジンの恩恵を受けることができます。AlloyDB syncは、常に変化しないデータの非常に低いレイテンシでの読み取りニーズに対応するため、AlloyDB内にローカルで更新可能なコピーを作成します。Lakehouse federationは、BigQueryに大量の履歴データを持つ組織に対応し、処理をBigQueryにプッシュダウンして結果のみを返します。統合の選択は、データの場所、アプリケーションの読み取りパターン、およびレイテンシ要件によって異なります。