BigQueryにおけるTabFMの紹介:予測分析の再考
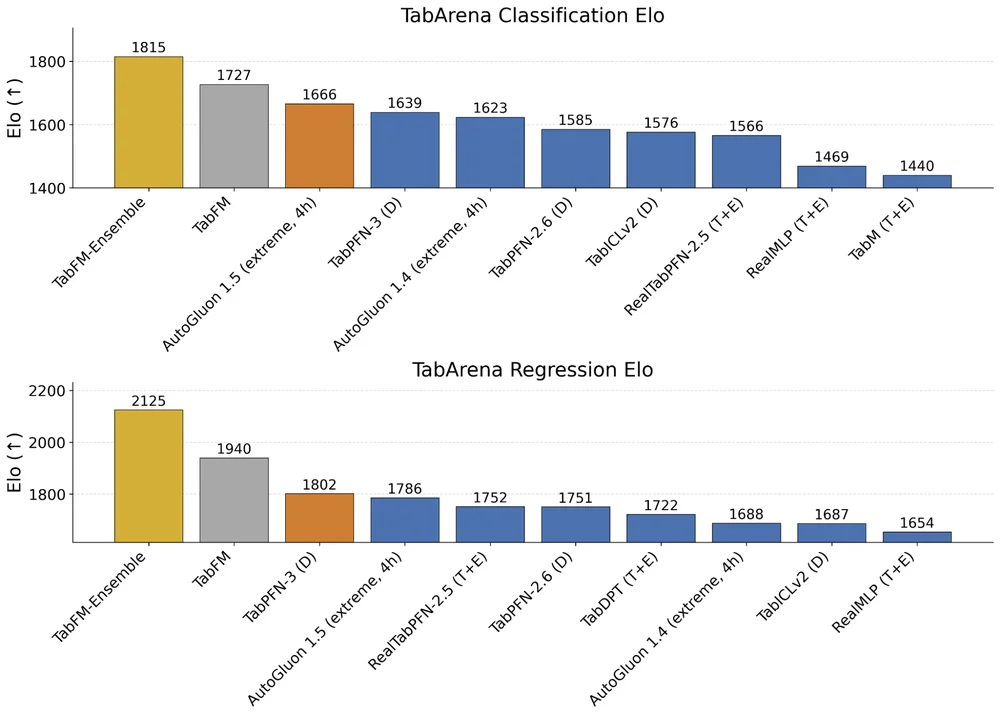
予測分析には、以前は複雑なカスタムモデルの構築とトレーニングサイクルが必要でした。この従来の取り組みには、手動での特徴量エンジニアリング、長時間のチューニング、専門的なスキルが必要であり、予測モデルの活用不足につながることがよくありました。Google Researchは、テーブルデータ向けの事前トレーニング済み基盤モデルであるTabFMを導入しました。これは現在BigQueryで利用可能です。TabFMは、インコンテキスト学習を利用して、単一のSQLステートメントを通じて即座に高精度の予測を提供し、個別のトレーニングとデプロイメントのステップを不要にします。このシステムはゼロショット予測を提供し、広範な機械学習の専門知識を持たないユーザーのプロセスを簡素化します。また、インフラストラクチャを管理することなく予測能力を提供することで、エージェント型アプリケーションを強化します。TabFMは、ベンチマークにおいて従来のモデルを上回る最先端の精度を示します。開発者エクスペリエンスは、ネイティブなBigQuery統合と簡単なSQL構文によって簡素化されます。TabFMは特徴量エンジニアリングタスクを自動的に処理し、そのスケーラビリティにより、数百万行を迅速に処理できます。ユーザーはAI.PREDICTを利用して即座に予測を行い、AI.EVALUATEを利用してモデルのパフォーマンスを評価できます。TabFMは迅速な洞察と頻繁な再トレーニングに優れていますが、非常に大規模なデータセットの場合や、特徴量の重要性の説明可能性が重要な場合は、従来のモデルが引き続き適しています。この統合により、標準的なSQLクエリを実行するのと同じくらい簡単に予測機械学習が可能になります。