大規模なApache Icebergの管理:SpannerがLakehouseランタイムカタログをどのように支えるか
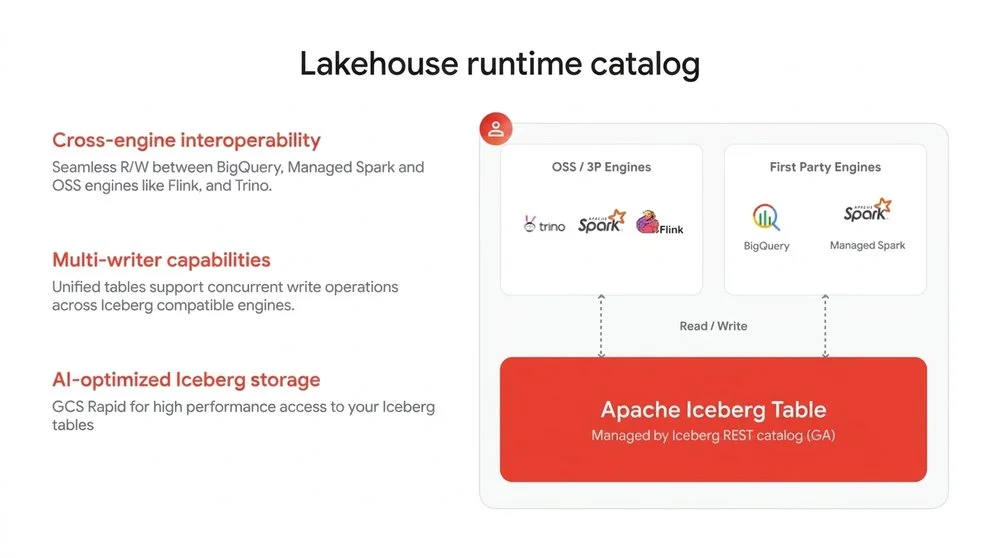
顧客は、AIネイティブソリューションのための共有データエステートを作成するために、Apache Icebergのようなオープンフォーマットに標準化し、レイクハウスアーキテクチャを採用しています。重要なコンポーネントは、テーブルポインタ、アトミックコミットを管理し、単一の真実の情報源として機能するApache Iceberg REST Catalogです。企業は、AIエージェントからの大量の小規模で繰り返し実行されるクエリをサポートするために、非常にスケーラブルで可用性が高く、管理されたカタログを必要としています。このようなカタログは、アトミックコミット、高可用性、データベースのスケーリング、テーブルメンテナンス、堅牢なガバナンスといった課題に対処する必要があります。Spannerを搭載したGoogle Cloudのサーバーレスレイクハウスランタイムカタログは、これらの課題に対するソリューションを提供します。このカタログは完全にサーバーレスで高可用性があり、メタデータを統合し、Apache Iceberg REST Catalog仕様をネイティブに実装しています。主な利点には、オープンAPI、マルチエンジン相互運用性(BigQuery、Managed Spark)、およびIcebergテーブルの読み書き機能が含まれます。オブジェクトストレージ内の既存のデータに直接ポインタを指すことで、エンタープライズグレードの機能とゼロデータコピーを備えた完全に管理されたIcebergストレージを提供します。このカタログは、クラウド間(Databricks Unity、Snowflake Horizon、AWS Glue)の双方向フェデレーションと、クレデンシャルベンディングを使用したセキュアなアクセスもサポートしています。AIによるコンテキストとガバナンスのためにKnowledge CatalogおよびCloud IAMと統合され、テーブルレベルのセキュリティ、検索、およびリネージを提供します。特に、Googleの惑星規模のインフラストラクチャとSpannerに支えられた、アトミックコミット、同時実行制御、高可用性、およびスケーラビリティを保証します。Spannerは、読み書きのための水平スケーラビリティの高い弾力性を持つ完全なリレーショナルSQLセマンティクスを提供し、リージョン構成を通じて高可用性を実現します。データ量とクエリ負荷を動的に監視しながら、コンピューティングとストレージを自動的にスケーリングします。この基盤により、シリアライズ可能なトランザクションが可能になり、エージェント規模の操作に対して業界をリードする一貫性保証を提供します。レイクハウスランタイムカタログは、Knowledge Catalogと統合され、Spannerのフルテキストおよびネイティブベクトル検索を活用して、Icebergテーブルの効率的な検出とより良いリコールを実現します。この統合アプローチは、運用オーバーヘッドを削減し、AIエージェントユースケースの市場投入までの時間を短縮します。Google Cloudのボーダーレスレイクハウスは、データ、ガバナンス、AIコンテキストを統合し、運用上の総所有コストを削減します。