大規模なトレーニングおよび推論ジョブ向けの信頼性の高いGPUコンピューティング
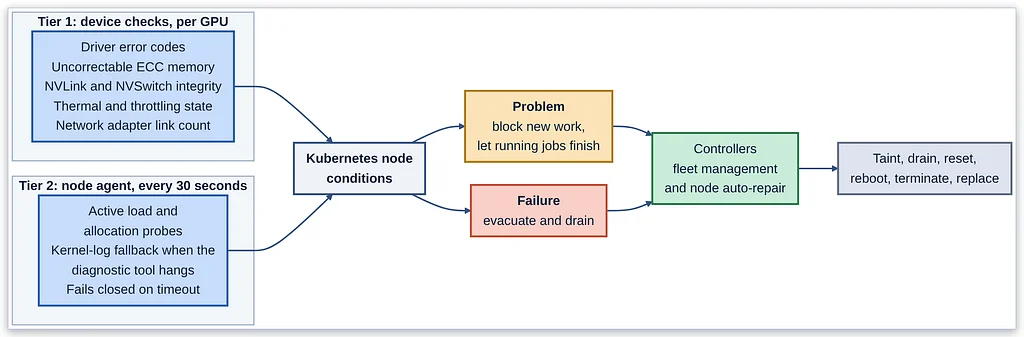
Netflixは、パーソナライズされたコンテンツ推奨やその他の機械学習アプリケーションのために、GPUに大きく依存しています。これらのGPUは、コンテンツのトレーニングと提供に不可欠であり、その信頼性は、可用性とコスト効率の両方にとってビジネス上の必須事項です。基本的なクラウドプロバイダーのヘルスチェックでは、長時間のトレーニングジョブを壊滅させる可能性のある微妙なGPUまたはネットワークファブリックの障害を検出できないため、不十分です。このような障害は、パフォーマンスの低下やジョブの完全な停止として現れ、ユーザーエクスペリエンスに影響を与え、リソースを無駄にする可能性があります。Netflixは、GPUインフラストラクチャの健全性を確保するために、レイヤードアプローチを採用しています。最初のレイヤーは、GPUやネットワークアダプターなどの障害のあるハードウェアの検出と修復に焦点を当てています。2番目のレイヤーは、タスクをリトライし、使用前にマシンを検証するスケジューラとプラットフォームを含みます。3番目のレイヤーは、チェックポインティングとエラスティックワーカーを通じて、マシン損失から長時間のジョブを回復できるようにします。4番目のレイヤーはオブザーバビリティであり、他の3つのレイヤーの効果を監視します。ヘルスチェックは2つのティアで実行されます。個々のGPUのデバイスレベルチェックと、エージェントによって実行されるノードレベルチェックです。これらのチェックは、Kubernetesノード条件として結果を報告します。問題が検出されると、マシンの条件が更新され、コントローラーがアクションを実行します。初期の問題は許容されますが、持続的な障害はマシンの退避、ドレイン、および交換にエスカレートします。修復は段階的であり、アクションは障害の深刻度に合わせて調整され、単一のGPUの再起動からマシン全体の終了と交換まで行われます。持続的に障害が発生するハードウェアについては、不変の識別子が記録され、それらがプールに再参加するのを防ぎます。マシンは、すべての診断に合格することを保証するために、作業にリリースされる前に検証されます。最後に、長時間のジョブはチェックポインティングによって回復力があり、マシンが失われた場合に最後の安定した状態から再開できます。