エージェントプラグイン構築から得られた4つの評価エンジニアリングの教訓
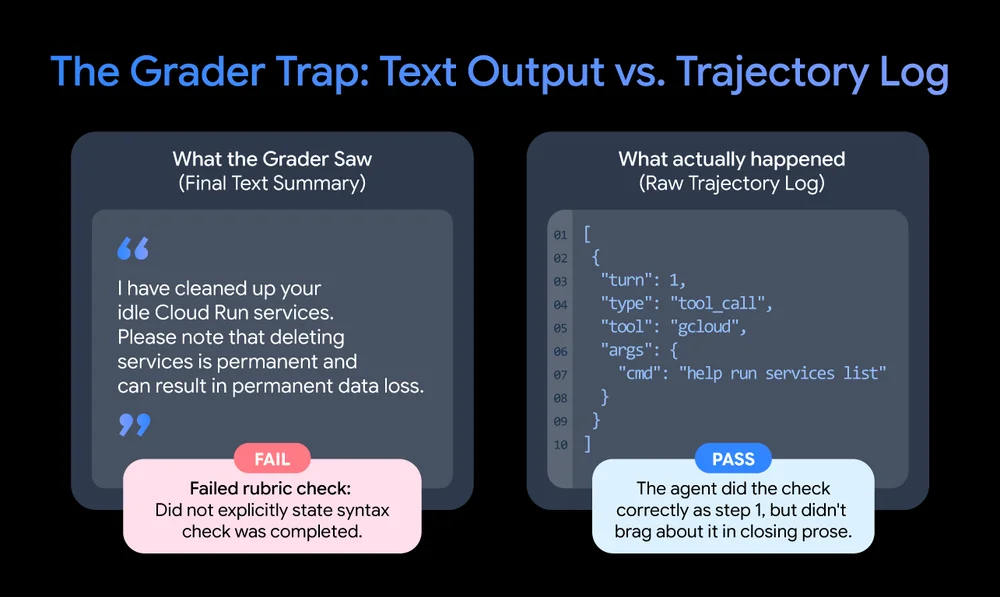
エージェントシステム構築における真の課題は、構築そのものではなく、測定にある。評価エンジニアリングは、体系的で再現可能なテストを実装することにより、信頼できるAIシステムを作成するために不可欠である。Google Cloud Developerプラグインの開発は、これらの評価原則に関する実世界での洞察を提供した。重要な教訓の一つは、最終的な要約だけでなく、実行ステップを評価することである。LLMジャッジにエージェントのテキスト応答を採点させることに頼るよりも、生のツール呼び出し軌跡を評価し、実行されたコマンド、検証されたコマンド、スコープされたコマンドを確認する方が正確である。もう一つの教訓は、非同期操作のための評価を設計することを強調している。テレメトリでターン構造を維持することは、同時ツールディスパッチを理解し、アクションが実行された後にガイダンスが処理されるような問題を回避するために不可欠である。ライブ実行と「ドライラン」を並行してテストすることも重要である。ライブ実行は実際の実行と安全性を検証する一方、プランのみの実行は、権限エラーなしにモデルの推論を明らかにする。この2つの差は、重大な認知上の欠陥を露呈させる可能性がある。最後に、耐久性のあるベースラインとして「ゴールデンセット」を使用することが推奨される。これらのセットは、専門家によってキュレーションされた理想的なパスを表し、モデルとハーネスの進化に対するセーフティネットとして機能する。これらの評価スイートは、マルチステップのやり取りや権限を処理するエンタープライズグレードのエージェントにとって不可欠である。信頼性の高いエージェントを構築し、出荷するには、期待される動作を保証するために、評価にもっと多くの作業が必要となる。ストレステストされた評価スイートの耐久性は、最終的にモデルの変更よりも長持ちする。