GKE PodスナップショットでAIワークロードをより速く、より効率的にスケールする
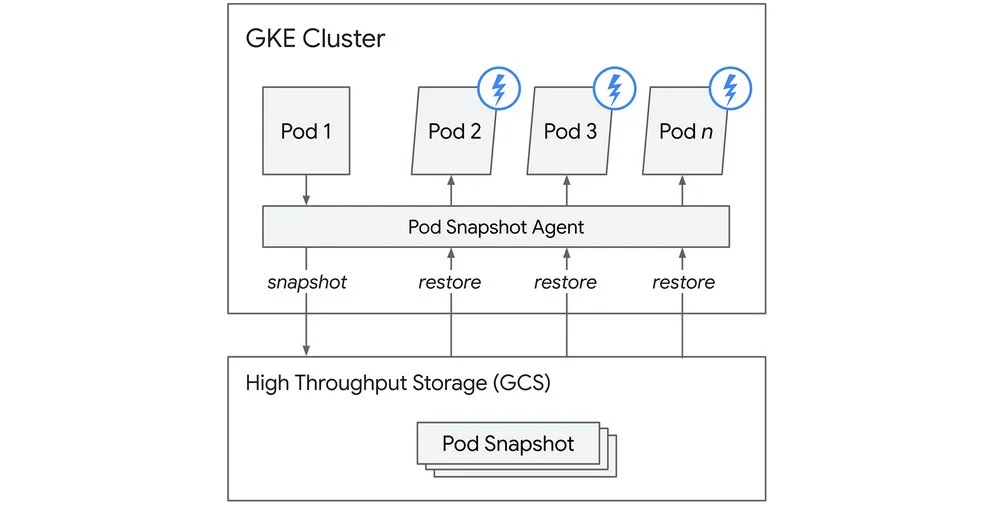
現代のAIワークロードは、初期化時間の長さにより、パフォーマンスとコストのジレンマに直面しています。大規模言語モデルやインスタントコード実行には高速なプロビジョニングが必要であり、しばしばインフラストラクチャの過剰支出につながります。Google Kubernetes Engine(GKE)Podスナップショットは、実行中のワークロードの状態を保存および復元することで解決策を提供します。この機能は、AI推論の起動時間を劇的に短縮し、大規模モデルを数秒でロードします。多くのアプリケーションにとって問題となるコールドスタートは、GPUメモリのロードが大きいため、AIでは特に深刻です。従来の方法では、過剰プロビジョニングや、状態復元のための複雑なカスタムソリューションが用いられていました。GKE Podスナップショットは、新しいレプリカに対する冗長なモデルロードを排除することで、AI推論の効率的なスケーリングを可能にします。一度の初期化で永続的なスナップショットが作成され、新しいインスタンスは即座に復元できます。これにより、スケーリングが加速され、高価な過剰プロビジョニングの必要性が減少します。エージェントワークフローの場合、Podスナップショットは起動レイテンシを改善し、アイドル状態のサンドボックスを効果的に管理します。スナップショットは新しいエージェント環境を迅速に初期化し、アイドル状態のサンドボックスを即座に一時停止および再開できるようにします。この機能は、初期化フェーズが長い様々なワークロードに適応可能です。GKE Podスナップショットは、スナップショット管理のための宣言的ポリシーを通じて、Kubernetesワークフローとシームレスに統合されます。