Google Cloud上のReflectionのBeamのDay 0サポート:llm-dとNVIDIA Dynamoによる5倍高速なパフォーマンス
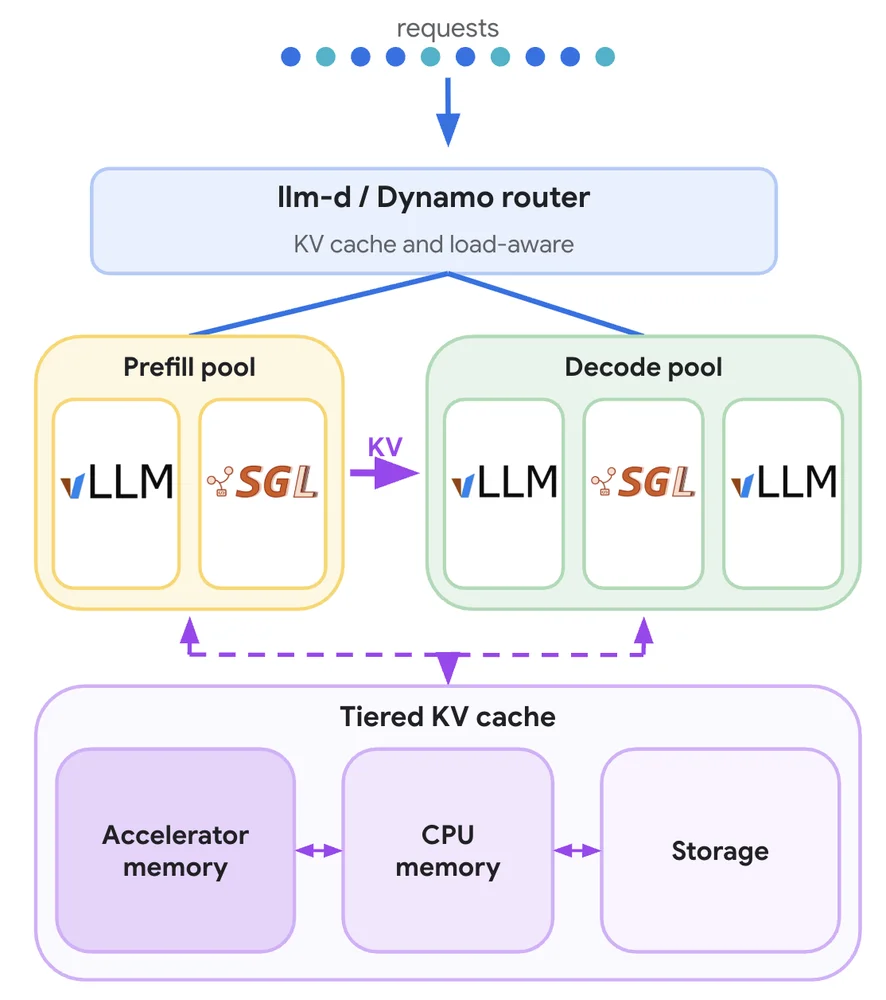
Reflectionは、高度なソフトウェアエンジニアリングと長期間のエージェントタスク向けに設計されたオープンウェイトモデルであるBeamをローンチしました。BeamはApache 2.0ライセンスで提供され、そのパラメータクラスのモデルとしては印象的な推論効率を実現しています。Google Cloudは、AI HypercomputerおよびNVIDIA AI Infrastructure上でのデプロイメントレシピを提供し、Beamの即時サポートを発表しました。Reflectionと共に、Google Cloudはllm-dとNVIDIA Dynamoを使用してBeamのパフォーマンスを最適化し、サービングを強化しました。Google Cloud上でのBeamのデプロイメントは、エージェントワークロードにおいて大幅に高いパフォーマンスと低いレイテンシをもたらしました。このリリースは、モデルとシステムの効率の複利効果を強調し、エージェントのスループット向上とレイテンシ削減につながります。高効率なマルチターンサービングは、KVキャッシュ対応ルーティングやスペキュラティブデコーディングなどの高度な技術によって実現されます。開発者は、エージェントワークロード向けのターンキー最適化デプロイメントの恩恵を容易に受けることができます。エージェントタスクの推論をスケーリングするには、モデルとサービングシステムのレイヤーの両方で最適化が必要です。Beamのユニークなアーキテクチャは、トークンごとにパラメータのごく一部しかアクティブにしないため、コンピューティング要件を劇的に削減します。サービングスタックは、長コンテキストシナリオにおけるプリフィルコンピューティングやKVキャッシュ容量などのボトルネックに対処します。この共同開発ソリューションは、強力で効率的なAIツールを開発者に提供することを目的としています。