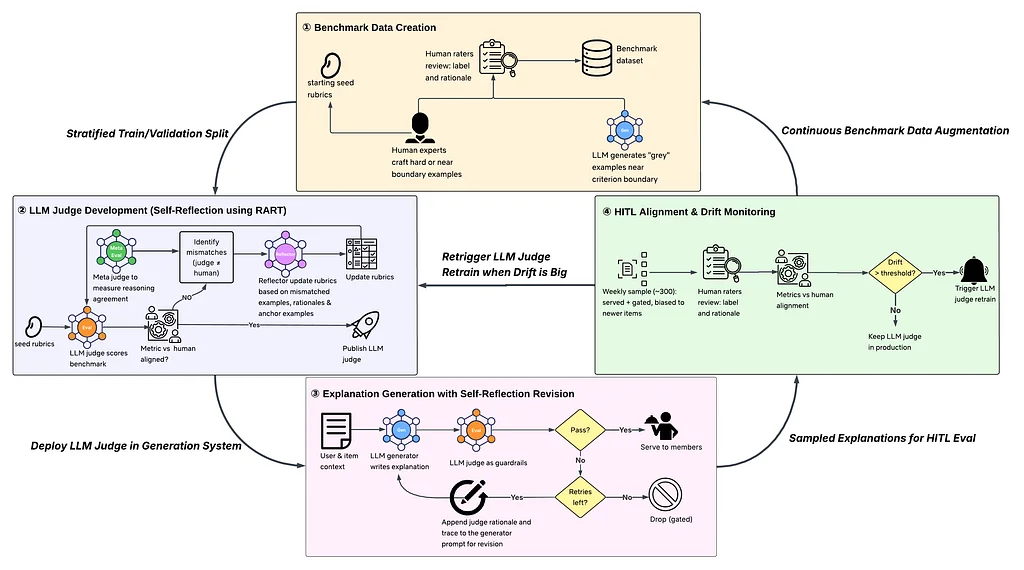
LLM-as-a-Judge のライフサイクル:構築、アラインメント、および大規模なモニタリング
LLMによる大規模テキスト生成では、手動レビューの限界から自動評価が必要不可欠です。LLM-as-a-Judgeアプローチは、プライマリLLMの出力をセカンドLLMで採点しますが、評価者の信頼性に関する懸念が生じます。この問題は、LLMジャッジを構築、アラインメント、継続的に監視することで対処され、あらゆる段階で人間の判断に準拠していることが保証されます。人間が品質基準を定義し、ラベル付きデータセットを作成し、ジャッジの行動を監視し、アップデートを承認します。信頼できるLLMジャッジは静的なものではなく、その作成、アラインメント、運用、保守において人間の関与を含むライフサイクルを持っています。このプロセスは、アイテムレコメンデーションを説明する短いメッセージであるレコメンデーション説明の生成タスクを通じて説明されます。誤解を招く説明はユーザーの信頼を損なうため、品質は重要です。LLMジャッジのライフサイクルは、誕生、トレーニング、デプロイメント、HITLアラインメント&ドリフト監視の4つのフェーズで構成されます。誕生フェーズでは、人間の専門家が敵対的および境界例を含むベンチマークデータを考案し、それを人間の評価者がラベル付けします。トレーニングフェーズでは、自己反省とルーブリックの更新を使用して、LLMジャッジを人間のラベルと根拠にアラインメントするように洗練させます。デプロイメントフェーズでは、ジャッジを説明生成システム内のゲートおよびクリティックとして統合します。HITLアラインメント&ドリフト監視フェーズでは、ジャッジを人間の評価者と比較して定期的にベンチマークし、システム変更には人間の承認を要求することで、継続的な信頼性を確保します。このフェーズでは、Meta-Judgeを使用してLLMジャッジの根拠と人間の根拠を比較し、ジャッジが間違った理由で正しい答えにたどり着いたケースを検出します。新しい人間ラベル付きデータとシグナルを取り込むこの継続的なフィードバックループは、ベンチマークおよび開発フェーズにフィードバックされます。システムコンポーネントには、ジェネレーター、ジャッジ、リフレクター、Meta-Judge、人間の専門家および評価者が含まれ、これらすべてがライフサイクルフェーズ全体で連携してジャッジの整合性を維持します。