llm-d 1.0を発表:Google Cloud TPUおよびGPU上でのエージェント向けオープン分散推論
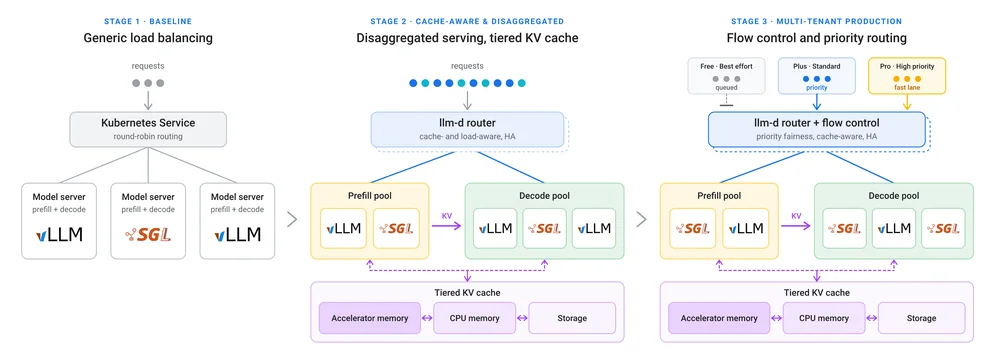
本日、Google、Red Hat、IBMを含むコミュニティによって開発された、分散LLM推論のためのオープンソース、Kubernetesネイティブスタックであるllm-d 1.0がリリースされました。このプロジェクトは、進化する推論ニーズに対応するために、PyTorchとKubernetesコミュニティを統合します。現代のエージェントベースのワークロードは、単純なチャットインタラクションとは異なり、マルチステッププロセス、ツールの使用、およびバースト的なトラフィックパターンを伴います。これらを単一のマシンや基本的なロードバランサーで提供することは非効率的であり、計算の重複やインタラクティブユーザーの停滞につながります。llm-dは、クラスターを協調的なサービングプールに変え、1,000エージェントを単一のエンドポイントでデモンストレーションしました。主な機能には、エージェントのコンテキストとフロー制御を維持するためのキャッシュアウェアルーティングと階層化KVキャッシュ、トラフィックバースト中のインタラクティブリクエストを優先するためのフロー制御が含まれます。バージョン1.0は、優先度を考慮したフロー制御によるマルチテナントQoSと、堅牢化されたAPIによる安定した基盤を提供します。また、高可用性とゼロダウンタイムアップデートによる安全なアップグレード、およびコンテキスト再利用のためのエージェントアウェアサービング機能も可能にします。拡張されたTPU統合は、TorchTPUタイムスライシングによるネイティブPyTorchモデルサービングを提供し、スループットと利用率を向上させます。llm-dコンポーネントはコンポーザブルであり、ユーザーは必要なサービング要素のみを採用できます。このスタックは、Kubernetesプリミティブ、PyTorchサービングエンジン、およびアクセラレータアウェアスケジューリングを接続し、柔軟な本番環境を実現します。