DEV Community 日本語
フォロー
LLM推論の最適化:より速く、より安価なAIのためのテクニック
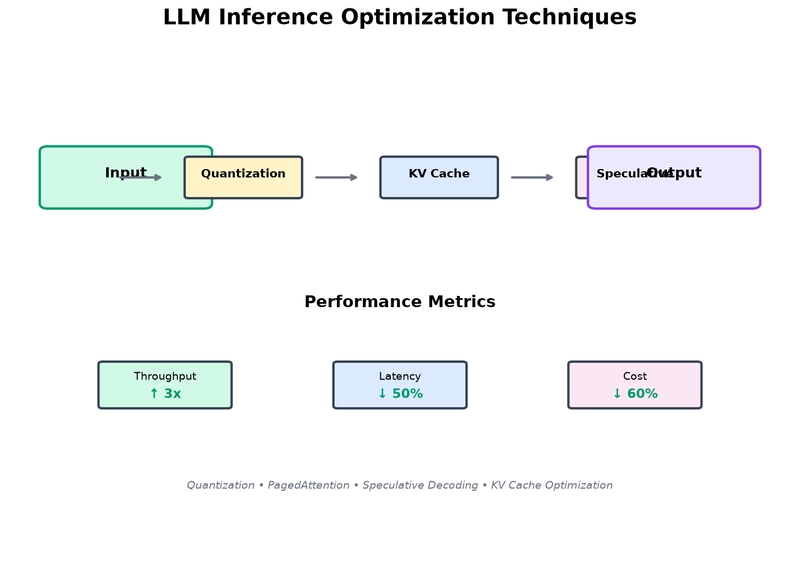
AIアプリケーションがスケールするにつれて、大規模言語モデル(LLM)は推論の遅さと高コストという課題に直面しています。LLM推論の最適化は、応答時間の短縮、計算コストの削減、およびより広範な展開を可能にするために不可欠です。量子化は、モデルの重みの精度をINT8やINT4などを使用して低減する主要な技術であり、わずかな精度のトレードオフで大幅な高速化を提供します。PagedAttentionなどの手法を使用したKVキャッシュ最適化は、特に長いコンテキストでの生成を高速化するためにメモリ効率を向上させます。スペキュラティブデコーディングは、より小さなモデルを使用してトークンをドラフトし、それをより大きなモデルで検証することで、品質の低下なしに2〜3倍の高速化を実現します。プロンプト最適化は、トークン使用量と関連コストを最小限に抑えるために、より簡潔で構造化されたプロンプトを作成することに焦点を当てています。バッチ処理は、複数のリクエストをグループ化することで、さらに効率を高めます。量子化は大幅な速度とコストのメリットを提供し、KVキャッシュとスペキュラティブデコーディングは品質損失なしで高速化を提供します。プロンプト最適化は、品質に影響を与えることなく、中程度の速度とコストの改善を提供します。KVキャッシュ最適化の実装は、多くの場合、最も簡単な開始点であり、エッジデバイスの場合は量子化、スループットの場合はスペキュラティブデコーディングが続きます。将来は、ハードウェア固有のソリューションや動的ルーティングを含む、より高度な最適化手法が登場するでしょう。最終的に、最適な最適化戦略は、速度、コスト、またはモデル品質の維持という特定の優先順位に依存します。