マルチクラスターGKEインファレンスゲートウェイで1%未満のオーバーヘッドを持つグローバルAIルーティング
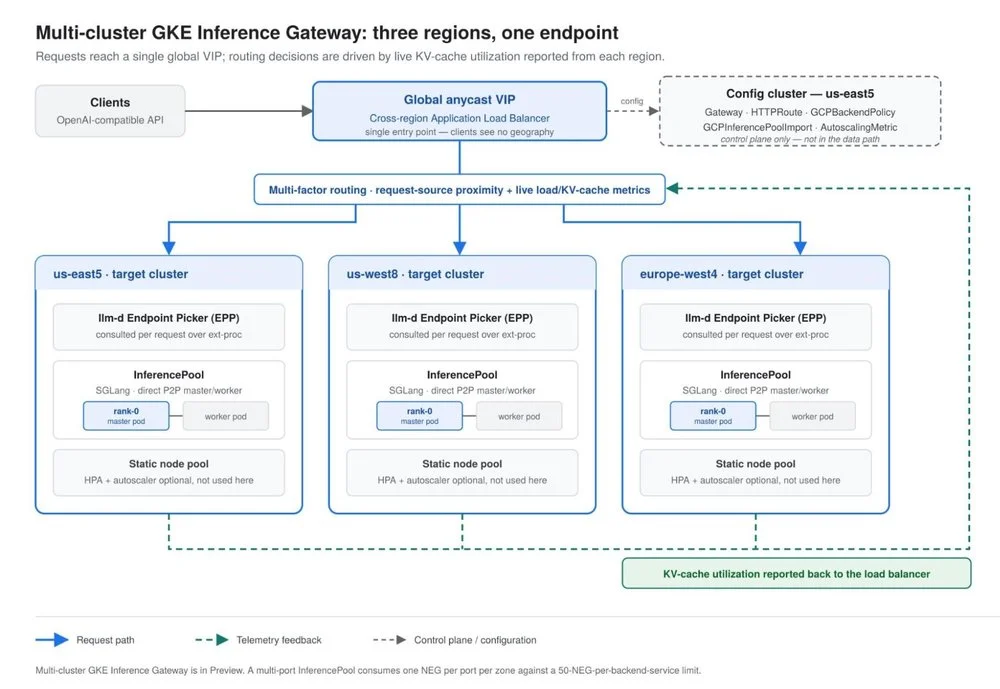
AIインフラストラクチャ、特にアクセラレータの需要は非常に高く、データセンター全体で不足とコンピューティング容量の断片化を引き起こしています。大規模なコンテキストウィンドウを持つ最新のAIワークロードは、アクセラレータメモリを急速に消費し、利用率の問題を悪化させます。これに対処するため、グローバルに分散した容量を単一のプールとして扱うためのレイヤードルーティングアーキテクチャが開発されました。このシステムは、グローバルトラフィック分散のためのマルチクラスターGKEインファレンスゲートウェイと、メモリを意識したスケジューリングのためのLLM-dルーターを備えています。このアーキテクチャは、ランタイム、モデル、アクセラレータのタイプに依存しないように設計されています。大規模なマルチリージョンGKEデプロイメントでのベンチマークは、ほぼ線形のスループットスケーリングと99.9%の成功率を示しました。GKEインファレンスゲートウェイは1%未満のオーバーヘッドを追加し、直接クラスター呼び出しのスループットの99.5%を提供しました。トラフィックは、ライブアプリケーションシグナル、特にKV-キャッシュトークン利用率に基づいてルーティングされ、システムがリージョン間でインテリジェントにトラフィックをスプールすることを可能にします。このメモリを意識したルーティングは、アクセラレータがメモリ飽和によって孤立するのを防ぐことで、効率的な利用を保証します。その結果、追加されたアクセラレータからのほぼ比例したパフォーマンス向上を達成し、資本の無駄遣いを回避することで、「ドルあたりのインテリジェンス」を最大化します。主な教訓として、スマートなロードバランシングの重要性、エージェンティックワークロードのメモリボトルネックの考慮、AIトラフィックレイテンシへの適応、ネイティブサービングパターンとのルーティングの統合、そしてオープンでポータブルなスタックの選択が強調されています。