NVIDIA Dynamo上でPinterestのVLMサービングスタックを構築する
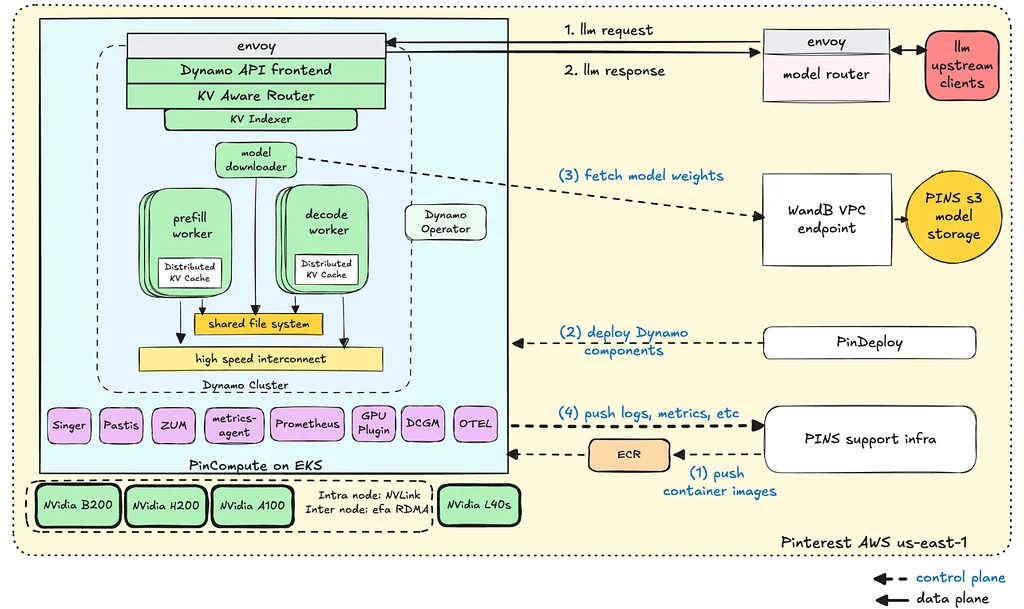
Pinterestは、ビジュアル検索およびディスカバリープラットフォームを強化するために、ビジョン・言語モデル(VLM)を活用しています。これらのモデルは、Pinterest Assistantやハイブリッド検索などの新機能の実現に不可欠です。Pinterestは、オープンソースのVLMをカスタマイズし、特定の製品およびスケーリング要件を満たしています。VLMのサービングは、複数の画像やより大きなKVキャッシュの処理など、従来のテキストのみのLLMを超える独自の課題を提示します。これらの課題に対処するため、PinterestはNVIDIA Blackwell GPUとNVIDIA Dynamo上にVLMサービングスタックを構築しました。Blackwell GPUは、要求の厳しいAIワークロードに対して優れたコンピューティングスループットとメモリ容量を提供します。Dynamoは、サービングパス全体にわたるマルチモーダル推論を最適化するための分散オーケストレーションレイヤーを提供します。VLMのリクエストペイロードはより複雑であり、画像のダウンロード、前処理、およびプロンプトの構築が必要です。VLMサービングにおけるプリフィルステージはしばしば支配的であり、計算コストが高いため、高度なキャッシュ管理が必要となります。マルチターンのVLMインタラクションは、進化するビジュアルコンテキストとより重いプリフィル要求により、サービングをさらに複雑にします。KVキャッシュメモリのプレッシャーを管理することは重要であり、KV対応ルーティングやオフロードなどの戦略が必要です。Pinterestのソリューションは、分散プリフィリングとデコーディング、LMCacheによるKVキャッシュオフロード、およびDynamoとvLLM内のマルチモーダルサポートを利用しています。また、カスタムプロジェクション埋め込みを実装して、大きなビジュアルコンテキストの処理コストを削減しました。この最適化されたVLMサービングスタックはパフォーマンスを大幅に向上させ、Time-to-First-Tokenで実質的な改善を示しています。