オープンスタンダードによるクロスクラウド会話分析の簡素化
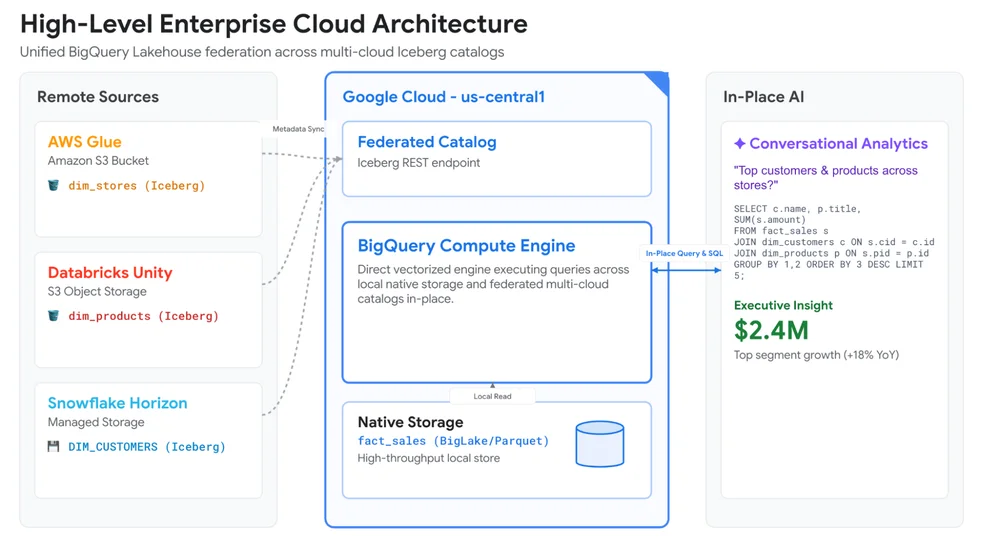
組織は、複数の専門プラットフォームやクラウドに分散した断片的なデータにしばしば苦慮しています。以前は、これには複雑なデータパイプラインを構築するか、不完全なレポートを受け入れるかのいずれかが必要でした。従来の方法では、データを中央ウェアハウスにコピーしていましたが、これは同期の問題、ストレージコスト、スキーマ変更時のパイプラインの破損につながっていました。Google CloudのApache Iceberg上に構築されたボーダレスLakehouseは、コンピューティングとAIが異なるプラットフォーム間でデータをその場でアクセスできるようにすることで、解決策を提供します。このアーキテクチャは、メタデータを同期しながらデータファイルへの直接アクセスを可能にします。Databricks、Snowflake、AWS Glueからのデータをデータ移行なしでBigQueryにフェデレートすることをサポートしています。BigQueryのフェデレートクエリは、これらの外部カタログ間でデータにアクセスするために4部構成のパスを使用します。この統合により、異なるデータセットの統合されたクエリと分析が可能になります。さらに、フェデレートテーブルは、BigQueryの会話型分析と組み合わせて、自然言語を使用した探索に利用できます。運用上の考慮事項には、バックグラウンド更新のタイミングの管理、クエリキャッシュの理解、データレジデンシーコンプライアンスの確保が含まれます。ボーダレスLakehouseは、高コストな移行と複雑なパイプラインを排除することで、データアクティベーションを簡素化することを目指しています。