DEV Community 日本語
フォロー
Prismの理解:共同ビデオ・オーディオ生成のためのダイナミックスパースアテンション
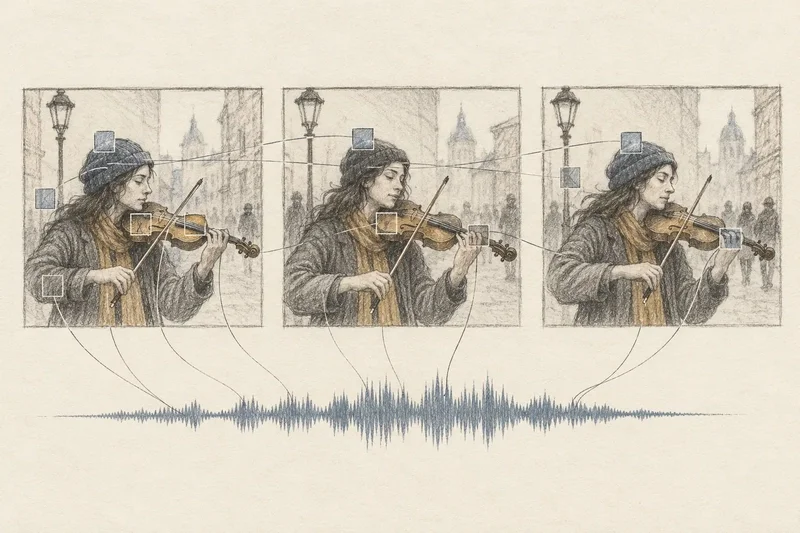
Prismは、高解像度のビデオおよびオーディオ生成モデルのトレーニングをより効率的にするために設計された、新しいスパースアテンションフレームワークです。高解像度のビデオは膨大な数のビジュアルトークンを含んでおり、従来の密なアテンションは、その二次的なスケーリングにより計算コストが高くなります。オーディオはさらに複雑さを増し、モデルは音とその視覚的な起源を関連付ける必要があります。Prismは、ビデオのローカルコンテンツに基づいてアテンションパターンをインテリジェントに適合させることで、この問題に対処します。このフレームワークは、ビデオクリップを時空間マクロゾーンに分割し、各ゾーン内の視覚的な変化とオーディオ・ビデオ間のクロスアテンション信号を分析します。これらの信号に基づいて、Prismはアテンションブロックを動的に形成し、計算リソースを、視覚的な変化が大きい領域やオーディオ・ビデオの相関が強い領域に集中させます。このスパースアテンションアプローチは、情報量の少ないビデオ部分での不要な計算を回避します。PrismのプレビューはHugging Faceで利用可能であり、画像からビデオへの生成、テキストからビデオ・オーディオへの生成のための推論スクリプト、およびネイティブな共同ビデオ・オーディオトレーニングのサポートを提供しています。現在のリポジトリは、かなりのGPUリソースを必要とし、720pの推論には80GBのGPUが必要で、より高い解像度には複数のそのようなGPUが必要です。1080pおよび2K解像度のネイティブトレーニングには、それぞれ少なくとも32個または64個の80GB GPUが必要です。著者は、Prismがフルアテンションと比較して最大2.5倍高速なトレーニングを達成し、生成品質も向上したと報告していますが、これらの結果は彼らの実験設定に特有のものです。この研究プレビューは、チェックポイントのダウンロードやGPU環境の設定に慣れているユーザーを対象としています。Prismのコアイノベーションは、コンテンツを認識する動的なスパースアテンションにあり、これは高解像度の共同ビデオ・オーディオモデルのトレーニングに特に有益です。