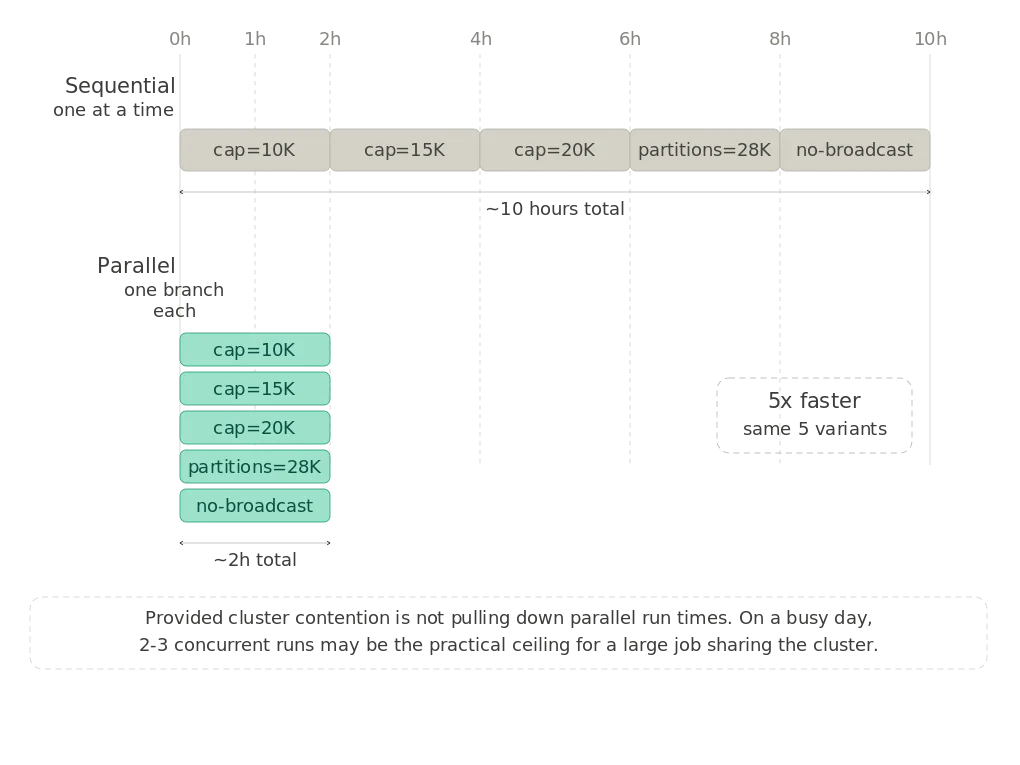
Netflix TechBlog | Medium 日本語 フォロー 寝ている間(そして飛行機の中で)Apache Sparkの実験を実行する Netflixのメンバーセッションライザーは、重要なデータパイプラインであり、何十億ものイベントを処理してユーザーの視聴セッションを作成します。標準的なデバッグアプローチは、データスキューにより、サンプリングされていない大規模なデータセットでのみ発生するメモリ不足エラーのような問題がNetflixのプロダクションスケールでは失敗しました。著者のブレークスルーは、単一の実行を高速化することから、複数の同時実験を可能にすることに焦点を移したことでした。これは、Dataflowのブランチ駆動開発を活用して各テストバリアントを分離することで達成されました。スケジューラをパラメータ化し、各実験に独自のブランチと出力テーブルを割り当てることで、複数のテストを同時に実行できるようになりました。これにより、総実行時間はテストあたり数時間から、最も長い単一ジョブの実行時間に劇的に短縮されました。AIエージェントが、多数の並列実験を実行する運用上の複雑さを管理するために採用され、構成の更新、ジョブのトリガー、およびメトリックのポーリングを自動化しました。これにより、著者は退屈な手動チェックから解放され、結果を即座に比較できるようになりました。Netflixのクラウド開発環境での永続的なtmuxセッションは、数時間に及ぶSparkジョブがネットワークの切断やラップトップのシャットダウンによって中断されるのを防ぐ上で重要であることが証明されました。パフォーマンスの根本的なボトルネックは、collect_list演算子がイベントバッグ全体をメモリにバッファリングすることと、非効率的なデータ構造であることが特定されました。具体的には、セッションIDをUUID文字列に変更し、フィールドにScalaのOptionを使用することで、メモリ使用量が大幅に増加しました。さらに、肥大化した文字列属性が各イベントに不要な負荷を追加しました。修正には、Optionからプリミティブフィールドをアンボックスすることと、未使用の属性を削除してイベントバッグをスリム化することが含まれました。セッションに依存しないメタデータはセッションヘッダーにホイストされました。2つの直感に反する発見は、Sparkのメモリ管理の複雑さを浮き彫りにしました。行を狭めることは、ブロードキャストジョインを強制することで、より速いOOMを引き起こす可能性があり、Adaptive Query Executionはブロードキャストハッシュジョインを通じて、サイレントに大量のデータをメモリに蓄積しました。AQEのブロードキャストしきい値を調整することで、これが解決されました。規律あるロギングシステムは、各実験、その構成、および主要なメトリックを追跡し、単一の真実の源を作成し、孤立した変数変更を強制しました。セッションキャッピングの修正をSpark Windowステージの前にテストするという間違いが犯され、これは切り捨て前にメモリをバッファリングしました。最終的に修正された修正は、メモリの肥大化を防ぐために、切り捨てをアップストリームに移動しました。これらのチューニング作業は当面の問題を解決しましたが、セッション全体を単一の行に集約するという根本的なデータ形状は、将来のスケーリングの課題を提示します。 Running Apache Spark experiments in my sleep (and on a plane) netflixtechblog.com Netflix TechBlog | Medium 日本語 RSS thenote.app

collect_list演算子がイベントバッグ全体をメモリにバッファリングすることと、非効率的なデータ構造であることが特定されました。具体的には、セッションIDをUUID文字列に変更し、フィールドにScalaのOptionを使用することで、メモリ使用量が大幅に増加しました。さらに、肥大化した文字列属性が各イベントに不要な負荷を追加しました。修正には、Optionからプリミティブフィールドをアンボックスすることと、未使用の属性を削除してイベントバッグをスリム化することが含まれました。セッションに依存しないメタデータはセッションヘッダーにホイストされました。2つの直感に反する発見は、Sparkのメモリ管理の複雑さを浮き彫りにしました。行を狭めることは、ブロードキャストジョインを強制することで、より速いOOMを引き起こす可能性があり、Adaptive Query Executionはブロードキャストハッシュジョインを通じて、サイレントに大量のデータをメモリに蓄積しました。AQEのブロードキャストしきい値を調整することで、これが解決されました。規律あるロギングシステムは、各実験、その構成、および主要なメトリックを追跡し、単一の真実の源を作成し、孤立した変数変更を強制しました。セッションキャッピングの修正をSpark Windowステージの前にテストするという間違いが犯され、これは切り捨て前にメモリをバッファリングしました。最終的に修正された修正は、メモリの肥大化を防ぐために、切り捨てをアップストリームに移動しました。これらのチューニング作業は当面の問題を解決しましたが、セッション全体を単一の行に集約するという根本的なデータ形状は、将来のスケーリングの課題を提示します。