全てのLLMワークロードは等しくない:分類と生成におけるTPUパフォーマンスのベンチマーク
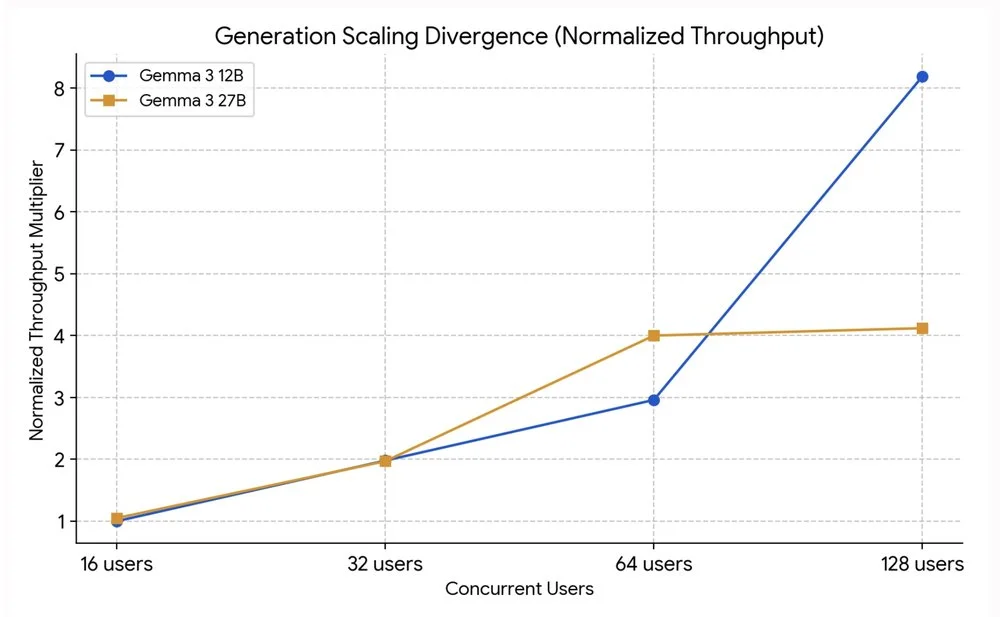
LLMのエンタープライズ本番デプロイは、パフォーマンスとコストにおけるインフラストラクチャの重要な役割を明らかにします。すべてのLLMリクエストがハードウェアに均等に負荷をかけるわけではないため、標準的なベンチマークでは不十分です。本研究では、Google Cloud TPU v6e上でGemma 3 12Bと27Bを比較し、異なるワークロードでの大規模なインフラストラクチャパフォーマンスを理解します。デコード負荷の高い生成では、Gemma 3 12Bモデルは高同時実行性でより良くスケールしますが、飽和する27Bモデルとは異なります。プレフィル負荷の高い分類タスクでは、12Bと27Bの両方のモデルが同様のスケールを示し、スループットペナルティなしでより大きなモデルを可能にします。ハードウェアの飽和は、レイテンシの急増とサイレントリクエストのドロップを引き起こし、CPU/メモリだけでなく、エンドツーエンドのレイテンシに基づいたスケーリングを必要とします。アーキテクチャは、GKE、TPU v6e、vLLMサービングフレームワーク、およびGemma 3モデルで構成されます。分類タスクは入力が高く出力が低い一方、生成タスクは入力が低/中程度で出力が高いです。ベンチマークは、高同時実行性での生成スケーリングにおける12Bモデルの優位性を示していますが、分類では両モデルとも同様のパフォーマンスを示します。最適化するには、モデル選択とサービング構成を特定のワークロードの入出力プロファイルに合わせます。