Kubernetes Blog 日本語 ノート

Kubernetes Blog 日本語

Kubernetesの公式ホームページは、コンテナーオーケストレーションシステムで、コンテナー化されたアプリケーションのデプロイメント、スケーリング、管理を自動化するためのプラットフォームです。このプラットフォームは、Cloud Native Computing Foundationが維持するKubernetesプロジェクトに関する包括的なドキュメントを提供します。Kubernetesを使用してステートレスアプリケーションとステートフルアプリケーション、バッチジョブ、CI/CDワークフローを実行する詳細なガイド、チュートリアル、リファレンス資料、APIドキュメント、コミュニティーエンゲージメントイニシアチブが含まれています。これらのリソースを使用して、Kubernetesを始め、クラウドベースのアプリケーションを効率的に管理するためのKubernetesの機能を効果的に活用することができます。

ノートのスレッド

Kubernetes Job が保留中である場合、Kueue がまだリソースの可用性を判断していることが原因である可能性があります。Headlamp Kueue プラグインは、Kueue リソースビューを UI に統合することで、この調査を支援します。これにより、ユーザーは、広範なコマンドラインの使用なしに、Workload の Admission パスを LocalQueues、ClusterQueues、ResourceFlavors、および Cohorts を通じて追跡できます。調査は、Workload のステータスと条件を調べて、Kueue がそれを Admission したかどうかを確認することから始まります。Workload が Admission されていない場合、問題は Kueue の Admission プロセスにあります。Admission されているが Pod が保留中の場合、問題は Kubernetes のスケジューラに移行します。Headlamp の Workload ビューは要求されたリソースを表示し、LocalQueue リンクをたどると Job の要求のエントリポイントが明らかになります。リンクされた ClusterQueue を検査することは重要です。そのクォータとポリシーがリソース割り当てを決定するためです。特定の例では、CPU と Pod スロットが限られている ClusterQueue が、より多くを要求した Job が Kueue によって一時停止されたままになる原因となりました。ResourceFlavors と Cohorts は、より複雑なクォータまたはハードウェアクラスの問題を調査するために検査されます。Workload が Admission されている場合、トラブルシューティングは Headlamp の標準的な Job および Pod ビューに移動して、スケジューラ関連のイベントを確認します。この Headlamp ファーストのアプローチは、Kueue 関連の遅延に対して、より迅速で統合されたトラブルシューティングエクスペリエンスを提供することを目指しています。
Kubernetesクラスターは、CPUの制約よりも前にメモリの制限に直面することが多く、これは新しいエージェント型AIワークロードによって悪化する問題です。これらのAIワークロードは、信頼されていないコードを初期化および実行するためにかなりのメモリを必要とし、その後アイドル状態になります。このアイドルメモリはコストがかかり、ノードがホストできるポッドの数を制限します。スワップメモリは、特に高速なNVMe SSDによってバックアップされている場合、休止状態のメモリをページアウトすることでこれを解決できます。現在一般提供されているKubernetesのスワップサポートにより、ノードはより多くのポッドをホストできます。CI/CDビルド、サンドボックス化されたブラウザ、およびPythonランタイム全体でのベンチマークは、レイテンシへの影響を最小限に抑えながら、最大3倍の密度向上を実証しました。歴史的に、メモリアカウンティングの問題と遅いディスクレイテンシのためにスワップは避けられていました。しかし、cgroup v2と高速なNVMe SSDはこれらの懸念を解決し、スワップを実用的なソリューションにしています。カーネルビルドのような従来のワークロードは、スワップが有効な場合にメモリ制限の低下を許容できます。ヘッドレスブラウザのような高密度エージェントワークロードは、スワップによってポッド密度の大幅な増加が見られます。サンドボックス化されたPythonランタイムもスワップの恩恵を受け、3倍の同時セッションを可能にします。ノードスワップを有効にするには、kubeletを構成し、クラウドプロバイダーのローカルディスクを使用します。Burstable QoSを持つワークロードは、動的なメモリバランスのためにスワップを活用できます。最終的に、高速スワップはアイドルメモリ状態をオフロードし、エージェント型ワークロードのポッド密度とノード利用率を向上させます。
Kubernetesの採用は、複雑なアプリケーションライフサイクルの管理、多様なワークロードのサポート、信頼性の確保につながっています。DeploymentsやStatefulSetsなどのコントローラーで構成されるSIG Appsは、Kubernetesにおけるアプリケーション管理の基盤を形成しています。このグループは、ワークロードの回復力の強化、ライフサイクル管理の洗練、運用上の課題の解決に焦点を当てています。SIG AppsのチェアであるJanet KuoとMaciej Szulikは、ワークロード管理の進化と将来の方向性について議論しています。SIG Appsは、アプリケーションの作成、更新、スケーリング、リカバリを管理する、Kubernetes上でアプリケーションが実行される方法にとって不可欠です。KubernetesがAIやバッチ処理のようなより多様なワークロードをサポートするにつれて、SIG Appsは信頼性とシンプルさのためにAPIを進化させています。現在の取り組みは、ワークロードの提供、ロールアウトとスケーリングパフォーマンスの向上、ユーザーから報告された問題への対応を優先しています。主要な焦点は、ワークロードの回復力の向上、特にノード障害とそのDaemonSetsやJobsのようなワークロードへの影響に関するものです。JobSetやLeaderWorkerSetのような新しいサブプロジェクトは、大規模なAIトレーニングと推論における障害を処理することを目的としています。これらの改善が成功裏に提供されることで、Kubernetesを運用するプラットフォームチームの手作業による介入が削減されます。SIG Appsにとっての重要な課題は、積極的なコントローラーの動作、必要なシグナル、および既存のユーザー自動化のための重要な後方互換性のバランスを取ることです。レガシーシステムを壊さないようにするために、SIG Appsはオプトイン機能とCRDを介した新しいパラダイムの導入を好みます。このグループはまた、自動化の改善のためにJob APIをより具体的な障害理由で強化するためのKEP-4443のような提案を再検討しています。新しい貢献者は、#sig-apps Slackチャンネルに参加するか、Agent Sandboxのような進化するサブプロジェクトに貢献することが奨励されています。
Kubernetes v1.37 は、PersistentVolumeClaimUnusedSinceTime feature gate を Beta に昇格させ、デフォルトで有効化しました。この機能強化により、各 PersistentVolumeClaim (PVC) のステータス内に "Unused" 条件が追加されます。この条件は、現在実行中のポッドが PVC を参照しているかどうかを直接示します。以前は、未使用の PVC を特定するには、複数の Kubernetes オブジェクトを相互参照し、広範なカスタムスクリプトを作成する必要があり、複雑でした。新しい機能は、PVC の使用状況をネイティブに報告することで、これを簡素化します。PVC は、非終了状態のポッドが参照していない場合は Unused とマークされ、少なくとも 1 つの実行中または保留中のポッドがアタッチされている場合は Used とマークされます。完了したバッチジョブからのポッドを含む、終了したポッドは、PVC をアクティブに使用しているとは見なされません。"Unused" 条件には lastTransitionTime フィールドも含まれており、PVC がアイドル状態になった日時を記録します。これにより、管理者は特定の期間未使用であった PVC を簡単に特定でき、コスト最適化とストレージ管理に役立ちます。以前は v1.36 で Alpha であったこの機能は、広範なテストを経て、現在 Beta ではデフォルトで有効になっています。ユーザーは kubectl を介して PVC のステータスを直接確認することで、これらの変更を観察できます。Kubernetes プロジェクトは、ユーザーフィードバックに基づいて、将来のリリースでこの機能を General Availability に移行する予定です。
Kubernetes v1.37 は、ワークロード保護を強化するための重要なストレージセキュリティ強化機能を導入します。これらの機能により、Kubernetes 内で直接 emptyDir ボリュームのパーミッションモードとバインドマウントオプションを設定できるようになります。これにより、開発者やセキュリティ専門家は、複雑な回避策なしに厳格なセキュリティポリシーを実装できます。これらの改善は、バインドマウントフラグやディレクトリパーミッションなどの基本的な Linux セキュリティメカニズムに基づいています。noexec、nosuid、nodev などのバインドマウントフラグは、マウントされたファイルシステムで許可されるアクションを制御します。スティッキービットを含むディレクトリパーミッションは、アクセスを規制し、共有ディレクトリでの不正なファイル削除を防ぎます。これらの機能の主な動機は、セキュリティ関連のバインドマウントオプションを許可することで、Kubernetes ワークロードのセキュリティを強化することです。以前は、ボリュームはこれらの保護フラグなしでマウントされており、セキュリティ上の脆弱性が生じていました。対処された重要なギャップは、emptyDir ボリュームにマウントオプションを設定できないことと、ディレクトリのデフォルトの 0777 パーミッションモードです。これにより、所有権に関係なく、任意のプロセスが emptyDir ボリューム内のファイルにアクセス、変更、または削除することが可能でした。新しい機能はネイティブソリューションを提供し、例えば、セキュアな共有ワークスペースのために emptyDir にスティッキービットを設定できるようにし、/tmp の動作を模倣します。これらの強化により、アプリケーション開発者は書き込み可能なマウントでの権限昇格を防ぎ、アプリケーションデータに対して最小権限の原則を強制できます。ユースケースには、書き込み可能なボリュームからの任意のバイナリ実行を防ぐことや、マルチコンテナポッドでの共有スクラッチスペースを保護することが含まれます。開発者は、0750 のような特定のモードを設定することで、一時ストレージへのアクセスを自信を持ってロックダウンできるようになりました。両方の機能は現在 v1.37 でアルファ版であり、機能ゲート VolumeBindMountOptions と EmptyDirVolumeMode を有効にする必要があります。これらの新しい機能は Linux 固有であり、Windows ノードには影響しません。
Kubernetes v1.37 は、Pod-Level Resource Managers をベータ版に引き上げ、Kubelet のマネージャーがポッドレベルのリソース宣言を利用できるようにします。以前は、クリティカルなアプリケーションの排他的な NUMA アライメントには、すべてのコンテナにコアを割り当てる必要がありましたが、サイドカーにとっては非効率的でした。この新機能により、プライマリコンテナには NUMA アライメントされたリソースを予約し、共有プールでサイドカーを収容するハイブリッド割り当てが可能になります。サイドカーは、専用コアを消費することなく、NUMA アライメントと保護を得られます。ベータ版リリースには、デフォルトで無効になっている PodLevelResourceManagers 機能ゲートと、PodResources API の強化が含まれています。API は現在、ポッドのトップレベルの cpu_ids とメモリを報告し、監視での二重カウントを防ぎます。ユーザーは、リソースをより効果的に管理するために、この機能を選択できます。目標は、クリティカルなワークロードのパフォーマンスを向上させ、リソース利用率を向上させることです。詳細なドキュメントとチュートリアルが利用可能であり、ユーザーはすぐに始めることができます。機能が一般提供に向けて進むにつれて、フィードバックは非常に重要です。
Kubernetes v1.37 は、Memory QoS のベータ版への昇格をマークし、cgroup v2 を使用する Linux ノードでデフォルトで有効になりました。この機能は、カーネルのメモリコントローラーを活用して、より良いガイダンスを提供することで、コンテナのメモリ管理を強化します。v1.22 でアルファ版として導入され、v1.36 で階層型メモリ予約機能が拡張されました。ベータ版への昇格は、MemoryQoS 機能ゲートが v1.37 のすべての kubelet で明示的な設定変更なしにアクティブになることを意味します。重要な点として、デフォルトの kubelet 設定では、ユーザーが明示的にオプトインしない限り、メモリのスロットリングや予約は有効になりません。ユーザーは、kubelet の設定フィールドを通じて特定の Memory QoS の動作を有効にすることができます。例えば、memoryThrottlingFactor を設定すると、Burstable および BestEffort コンテナに対して memory.high スロットリングがアクティブになります。あるいは、memoryReservationPolicy を TieredReservation に設定すると、memory.min および memory.low を介して階層型メモリ保護が有効になります。v1.37 における重要な変更点は、memoryThrottlingFactor のデフォルトが 0.9 から null に変更されたことで、既存のクラスターがアップグレード時に自動的にメモリのスロットリングが行われるのを防ぎます。これにより、明示的に設定されない限り、実行時の動作は一貫性が保たれます。Memory QoS を設定するために、クラスターオペレーターはスロットリングのために memoryThrottlingFactor を、階層型予約のために memoryReservationPolicy を設定できます。両方を同時に、または個別に有効にすることができます。Memory QoS を完全に無効にすることは、機能ゲートを false に設定し、それに応じて kubelet の設定を調整することで可能です。既知の制限事項として、メモリ予約はノード全体に適用され、個々のポッドの制御に影響を与える、望ましい動作に関係なくすべてのポッドに一貫して適用されます。Memory QoS の次の開発段階は、一般提供への昇格であり、継続的なフィードバックが将来の調整を形成します。
KubernetesストレージCSIドライバー向けの変更ブロック追跡(CBT)は、2025年9月にアルファ版として最初にリリースされました。この機能は、ブロックボリューム内の変更を追跡することでストレージ操作を強化します。アルファ版の発表では、その動機、コアコンポーネント、および使用方法が詳細に説明されています。CBTは現在ブロックボリュームのみをサポートしており、ファイルベースのストレージは除外されています。external-snapshot-metadataプロジェクトの最近のv1.0.0リリースにより、この機能はベータ版に昇格しました。ベータ版における主な更新は、SnapshotMetadataServiceカスタムリソース定義(CRD)がv1alpha1からv1beta1にアップグレードされたことです。スキーマは同じですが、古いv1alpha1バージョンは削除されたため、ユーザーは適応する必要があります。アルファ版からベータ版に移行するには、ユーザーはCRD定義を再適用し、マニフェストを新しいAPIバージョンを使用するように更新し、クライアントまたはコントローラーコードを調整する必要があります。この移行は、手動で一度だけ行うプロセスです。ベータ版では、最小Kubernetesバージョン1.33およびCSI仕様バージョン1.10以降が必要です。互換性のあるコンテナイメージはcsi-snapshot-metadata:v1.0.0です。この機能をテストするには、CSIドライバーがスナップショットをサポートしており、external-snapshot-metadataサイドカーが含まれていることを確認してください。v1beta1 CRDをインストールし、ドライバー用のSnapshotMetadataServiceリソースを作成します。次に、listerツールまたはカスタム実装を使用して、GetMetadataAllocatedおよびGetMetadataDelta関数と対話します。開発チームは現在、より広範なCSIドライバーの採用と、ベータ期間中の運用フィードバックの収集に注力しています。CSIドライバーのメンテナーにはサポートの追加を評価することを、バックアップアプリケーション開発者にはストリーミングクライアントとイテレーターパッケージに関する入力を提供することを奨励しています。詳細については、CSI開発者ドキュメント、KEP-3314、external-snapshot-metadataリポジトリ、gRPCスキーマ、およびsnapshot-metadata-listerの例を参照してください。この機能への貢献は大きく、関心のある個人はSIG StorageおよびData Protectionワーキンググループとの連携を奨励されています。
Kubernetes v1.37でネイティブヒストグラムがベータ版に移行し、高解像度かつ低カーディナリティのオブザーバビリティを提供します。この進化により、バケット推測、高カーディナリティ、補間エラーに悩まされていた古い静的なPrometheusヒストグラムが置き換えられます。Prometheusネイティブヒストグラムは、単一の時系列内に格納される動的な指数バケットを利用し、時系列を最大90%削減します。これにより、高解像度が自動的に提供され、正確な分位数計算が可能になります。Kubernetesでは、ネイティブヒストグラムは共有メトリクスに統合され、デュアルエクスポージャーにより既存のオブザーバビリティスタックとの互換性が確保されます。従来のバケットは、ゼロブレークチェンジの移行のために新しいネイティブスパンと並行して引き続き発行されます。標準的な指数オプションが自動的に適用され、分位数計算のバウンドエラーが保証されます。この機能は、APIサーバー、スケジューラー、Kubeletなどの主要なKubernetesコンポーネントを自動的にサポートします。Kubernetes v1.37へのアップグレードによりこの機能が有効になり、Prometheusスクレイプ設定は新しい形式を取り込むように適応します。ダッシュボードとアラートの移行には、従来のバケット参照から直接メトリック名を使用するようにPromQLクエリを更新する必要があります。推奨される移行ワークフローには、最初に両方の形式を有効にし、次にクエリを更新し、検証してから、ストレージ節約のために従来の形式のスクレイピングを無効にすることが含まれます。オプトアウトまたはロールバックは、Prometheusスクレイプ設定またはコンポーネントフィーチャーゲートを調整することで柔軟に行えます。この機能は一般提供に向けて進んでおり、コミュニティの参加が奨励されています。
Kubernetes v1.35 では、再起動なしで CPU とメモリを動的に調整できるインプレース Pod リサイジングが導入されました。しかし、完全に利用されているノードで Pod をスケールアップすると、容量が不足している場合に「Deferred」ステータスになる可能性がありました。これは、Pod がリソースが利用可能になるまで無期限に待機することを意味しました。これを解決するために、Kubernetes v1.37 では、現在アルファ版であるインプレース Pod リサイジングのためのスケジューラプリエンプションが導入されました。この機能により、Kubernetes スケジューラはノード容量を積極的に解放できます。実行中の Pod のインプレースリサイズリクエストが利用可能なリソースを超えた場合、スケジューラは優先度の低い Pod をプリエンプトできます。これにより、ビジーなノードでも重要なアプリケーションをスケールアップできます。プリエンプションは、Pod の現在のノードに限定され、対象となる優先度の低いワークロードをターゲットにします。これにより、クラスタオペレータは、優先度の低いタスクをビンパッキングすることで、リソース利用率を最大化できます。これがないと、オペレータは、利用率の低下か、重要なアプリケーションのスケーリングの失敗のリスクかのジレンマに直面していました。この機能は、スケジューラの既存の追跡メカニズムと統合されています。リサイズプリエンプションと標準の Pod 配置プリエンプションを区別します。リソース予約は、リサイズ中の競合状態を防ぐために安全に処理されます。この機能は、Kubernetes v1.37 以降と、InPlacePodVerticalScalingSchedulerPreemption フィーチャーゲートが有効になっている必要があります。管理者は、podPreemptionPolicy フィールドを使用して、特定のノードのリサイズプリエンプションを無効にすることができます。
Kubernetesは従来、基本的なステータス情報以上の、Nodeのライフサイクル状態を記述するための統一された方法を欠いていました。これはしばしば、断片的な理解や異なるクラスタコンポーネント間の潜在的な競合につながっていました。Kubernetes v1.37では、このギャップを埋めるために、DrainInProgress、Drained、MaintenancePlanned、MaintenanceInProgress、GracefulNodeShutdownInProgressという5つのよく知られたNode条件が導入されました。これらの新しい条件は、True、False、またはUnknownのステータスを使用して現在の状態を示します。これらの条件の設定と解除は、管理者または権限のあるコントローラーの責任です。現在、コアワークロードコントローラーはこれらの条件に基づいて動作しませんが、Nodeのライフサイクルイベントをシグナルすることで運用上の明確さを提供します。例えば、自動化は作業開始前にMaintenancePlannedを設定し、開始後にMaintenanceInProgressを設定できます。同様に、ドレイン自動化はそれに応じてDrainInProgressとDrainedを設定できます。推奨されるパターンは、実際の運用(例えば、cordoningやdraining)には既存のKubernetesメカニズムを引き続き利用しながら、ステータスレポートのためにこれらの条件を使用することです。この共有シグナルは、スケジューラから外部メンテナンスシステムまで、さまざまなクラスタコンポーネントがNodeステータスを理解する必要があるため、非常に重要です。これがなければ、コンポーネントは、Graceful shutdown中に意図的に終了されたPodをDaemonSetコントローラーが置き換えるといった、競合する決定を下す可能性があります。これらの新しい条件は、Nodeライフサイクル管理における将来の機能強化のための安定した基盤を提供します。Kubernetesコミュニティは、Graceful node shutdownやメンテナンスなどのシナリオを改善するために、これらの新しい条件に関するフィードバックを積極的に求めています。
Kubernetes v1.37 は、ワークロード認識スケジューリングにとって重要なマイルストーンであり、複雑なバッチおよび AI/ML ワークロードのサポートを強化します。ギャングスケジューリングに不可欠なコアの Workload および PodGroup API は、ベータ版に昇格しました。このリリースでは、異種 Pod グループの階層的スケジューリング要件を管理するための CompositePodGroup API が導入されます。新しいコントローラー統合 API と workloadbuilder Go ライブラリにより、アウトオブツリーコントローラーとワークロード認識スケジューリング機能との統合が簡素化されます。ネイティブの Job コントローラーは、これらの拡張された API を高度なスケジューリングポリシーとトポロジー認識のために完全に活用するようになりました。ギャングスケジューリングおよび Workload/PodGroup API は、ベータ版への昇格と更新されたバージョン管理により、より堅牢になりました。PodGroup のキューイングが改善され、PodGroup がスケジューリングキューでファーストクラスの市民になりました。PodGroup の minCount フィールドは変更可能になり、弾力的なワークロードの動的な調整が可能になりました。ワークロード認識プリエンプションは、GenericWorkload 機能に統合され、PodGroup のディスラプションモードを尊重するようになりました。CompositePodGroup API は、マルチレベルのトポロジー認識スケジューリングを可能にし、異なるインフラストラクチャレベル間での複雑な共同配置制約を可能にします。
Kubernetes v1.37 は KubeletInUserNamespace をベータ版に昇格させ、kubelet やランタイムなどのノードコンポーネントを非rootユーザーとして実行できるようになります。このrootlessモードは、2018年の実験から進化したもので、潜在的なコンテナブレークアウトの脆弱性を封じ込めることでセキュリティを強化します。Podのユーザー名前空間とは異なり、これはホストのノードコンポーネントに焦点を当てています。この機能は、歴史的に攻撃者にroot権限を付与する可能性があったCVE-2022-0811やCVE-2023-27561のような脆弱性によるリスクを軽減します。ユーザー名前空間で実行することにより、攻撃者の影響は非rootユーザーのアカウントに限定され、カーネルやファームウェアの変更を防ぎます。ユーザー名前空間はカーネルの脆弱性自体から保護するものではなく、seccompのような他の強化策と組み合わせる必要があります。この機能は、本番クラスター、共有マシン、ラップトップ、AIサンドボックスなど、さまざまなユースケースがあります。これは、ホストの非rootユーザーを名前空間内の偽のrootにマッピングすることで機能し、ほとんどのノードコンポーネントタスクで十分です。ユーザー名前空間は、例えばRootless Dockerを使用して、外部で作成する必要があります。デフォルトで有効になったKubeletInUserNamespace機能ゲートにより、kubeletは特定の権限エラーを無視できます。最近の改善には、idmapped tmpfs、ユーザー名前空間化されたPod、書き込み可能なcgroupのサポート強化が含まれており、ネストされたKubernetesデプロイメントが可能になります。kind、minikube、Usernetes、k3sのようなツールは、rootless Kubernetesクラスターを簡単に作成する方法を提供します。プロジェクトは将来的にこの機能を一般提供(General Availability)に移行する予定であり、コミュニティの参加を歓迎しています。
Kubernetes 1.37 は、Dynamic Resource Allocation (DRA) において重要な進歩をもたらし、Extended Resource サポートが General Availability に到達しました。これにより、DRA ドライバーは、個別のデバイスプラグインなしで従来の拡張リソースを管理できるようになります。ResourceClaim にはステータスフィールドとして devices が追加され、ネットワークインターフェイス名や IP アドレスなどのデバイス状態の可視性が向上しました。DRA デバイスの taint と toleration は安定化し、ノードの taint をミラーリングしてデバイスの可用性とメンテナンスを管理できるようになりました。標準化された numaNode デバイス属性は、異なるドライバー間での名前の一貫性を保証します。ResourceClaim のワークロードサポートは Beta に進み、単一のクレームを複数の Pod で共有できるようになり、以前の制限を克服しました。DRA Device Attributes Downward API は現在 Beta であり、デバイス属性をワークロードに直接注入することを容易にし、カスタムコントローラーのニーズを簡素化します。Alpha 機能には、属性のリストタイプが含まれており、より複雑なデバイスマッチングを可能にし、ノードの過剰割り当てを防ぐためのノード割り当て可能リソースリクエストが含まれます。リソース可用性の可視性は、2 番目の Alpha 版となり、時点のスナップショットを提供します。DRA の Optional Node Operations により、ドライバーは不要なノードセットアップ呼び出しをスキップできます。Derived Attributes は新しい Alpha 機能であり、CEL 式を使用してカスタムルールに基づいた柔軟なデバイスマッチングを実現します。DRA Device Compatibility Groups は、互換性のないデバイスの組み合わせのスケジューリングを防ぎます。PreQueueingHint 拡張ポイントも Alpha 版であり、スケールアップ時のスキャン範囲を縮小することで、Pod スケジューリングを最適化します。DRA Consumable Capacity は、現在、小数値をサポートしており、リソース割り当ての精度を向上させています。これらの継続的な開発は、Kubernetes のリソース管理機能の改善への取り組みを強調しています。
Kubernetes v1.37 は、デフォルトでワークロードをレプリカゼロにスケールダウンするためのベータ版 API サポートを提供します。これにより、HorizontalPodAutoscaler はアイドル状態のリソースをゼロに削減し、必要に応じてスケールアップできるようになります。以前は、この機能には外部アドオンまたはアルファ機能ゲートが必要でした。ゼロへのスケーリングは、キューコンシューマーのようなワークロードにとって特に有益であり、特に高価な専用ハードウェアを使用する場合、リソースの節約が大きくなる可能性があります。主なトレードオフは、システムがメトリクスを観測し、ポッドをスケジュールし、アプリケーションを起動する必要があるため、コールドスタート時間が長くなることです。このアプローチは、作業を耐久性のあるキューに一時的に保持できる場合に最も効果的です。ポッドがなくなったときに存在しなくなる CPU またはメモリメトリクスとは異なり、オブジェクトメトリクスと外部メトリクスは独立して永続します。これにより、ワーカーポッドが実行されていない場合でも、HorizontalPodAutoscaler はキューの長さなどのメトリクスを引き続き監視できます。ゼロからスケールするには、Prometheus Adapter のような外部メトリクスアダプターが必要であり、キューコンシューマーのラグなどのメトリクスを Kubernetes に公開します。次に、HorizontalPodAutoscaler は最小レプリカ数をゼロに設定し、スケーリングを決定する外部メトリクスをターゲットにします。特別な ScaledToZero ステータス条件は、手動の一時停止から自動スケーリングダウンを区別し、HorizontalPodAutoscaler が制御を再開できるようにします。以前はアルファ版だったこの機能は、v1.37 でベータ版に昇格し、リソース効率の向上を目的としてデフォルトで有効になっています。
etcd RangeStream は Kubernetes v1.37 でベータ版に昇格し、etcd v3.7 と連携します。この機能は、リソースの大きなコレクションを読み取る際の API サーバーと etcd のメモリ使用量を大幅に削減します。以前は、API サーバーのウォッチキャッシュを初期化するには、etcd から高コストなフルリードが必要でした。ページネーションは存在しましたが、オブジェクトサイズではなくキー数に基づいていたため、予測不能なメモリのスパイクやメモリ不足エラーが発生する可能性がありました。etcd の単項 Range RPC は、送信前にページ全体を組み立てていたため、etcd と API サーバーの両方でメモリプレッシャーが悪化していました。etcd v3.7 の新しい RangeStream RPC は、結果をチャンクでストリーミングすることでこれを解決します。チャンクサイズは値のサイズに合わせて適応的に調整され、キー数ではなくバイト数で読み取りを制限します。これにより、ストリームが進むにつれてメモリを段階的に解放できます。EtcdRangeStream 機能ゲートが有効になっている場合、API サーバーはウォッチキャッシュの初期化とフォールバックリストリクエストの両方に RangeStream を使用します。チャンクが到着するとデコードおよび解放されるため、コレクション全体が同時にメモリに保持されるのを防ぎます。この機能には Kubernetes v1.37 以降と etcd v3.7 以降が必要です。API サーバーは etcd のサポートを自動的に検出し、RangeStream が実装されていない場合はフォールバックします。RangeStream がアクティブであることを確認するには、etcd_request_duration_seconds_count{operation="listStream"} メトリックがゼロ以外の値であることを監視してください。
Storage Version Migration (SVM) は Kubernetes v1.37 で General Availability に達し、デフォルトで有効になりました。この機能は、Kubernetes API リソースのストレージバージョンを更新するという課題に対処します。リソースは特定のスキーマ表現を使用して格納され、この表現への変更は既存のオブジェクトの書き換えを必要とします。一般的なユースケースは、カスタムリソース定義 (CRD) を新しい API バージョンに昇格させ、古いバージョンを非推奨にすることです。SVM がない場合、リソースがストレージに古いバージョンを使用している場合、古いバージョンを削除することは安全ではありませんでした。同様に、保存時の暗号化やキーローテーションでは、新しい暗号化を適用するために格納されたデータを書き換える必要がありました。以前は、これには手動のスクリプト作成や外部ツールが必要でしたが、これらはエラーが発生しやすく、管理が困難でした。SVM は、宣言的な StorageVersionMigration API オブジェクトを導入することでこれを簡素化します。組み込みコントローラーはこれらのオブジェクトを監視し、リソースを指定されたデフォルトのストレージバージョンに自動的に移行します。移行を開始するには StorageVersionMigration オブジェクトを作成し、コントローラーがそれを処理します。移行のステータスを監視でき、正常な完了はすべてのリソースが更新されたことを示します。CRD の作成者は、CRD のアップグレードに移行マニフェストを直接含めることができるようになり、プロセスが合理化されます。
Kubernetes は、新しい本番環境のIDメカニズムとして Pod Certificates と Cluster Trust Bundles を導入しました。この機能は現在一般提供されており、TLS および mTLS 用の X.509 証明書の発行をコア Kubernetes に直接統合します。これは、以前の主要なメカニズムであるサービスアカウント JWT を大きく超える進歩です。JWT は使いやすさと幅広い互換性を提供しますが、重要な弱点があります。それは、それらがベアラートークンであるため、侵害された場合に不正アクセスを受けやすいことです。一方、Pod Certificates は、主に X.509 証明書である非対称暗号化に基づいたプルーフ・オブ・ポセッション認証情報(proof-of-possession credentials)を活用します。これにより、認証情報自体を共有するだけでなく、所有権の証明を要求することでセキュリティが強化されます。目標は、Kubernetes ワークロードから X.509 証明書を使用することを JWT と同じくらい簡単にする一方で、高いセキュリティ基準を維持することです。Pod Certificates は柔軟性を考慮して設計されており、プラグ可能なインターフェイスを通じて単一のクラスター内でさまざまな種類の証明書を許可します。これは、サービスアカウント JWT の単一の標準化された形式とは対照的です。将来の Kubernetes バージョンでは、サービス DNS 名および SPIFFE クライアント証明書の組み込み証明書プロバイダーが提供される予定です。アーキテクチャには、証明書を要求するアプリケーション、リクエストを発行しトラストバンドルを管理する Kubelet、およびこれらのリクエストを満たしトラストバンドルを発行する署名コントローラーが含まれます。発行プロセスは時系列で行われ、Pod のスケジューリングから始まり、アプリケーションがキーと証明書にアクセスすることで完了します。自動ローテーションが組み込まれており、アプリケーションはこれらの更新を処理する必要があります。セキュリティチェックは kube-apiserver に統合されており、分離を強制し、侵害されたノードが不当なアクセスを得るのを防ぎます。これらの機能を試すには、ユーザーは Tinycert のようなサードパーティの署名者をインストールする必要があります。Tinycert は、サンプル署名者と、アプリケーションが SPIFFE 証明書をロードするのに役立つライブラリを提供します。
Kubernetes v1.37 では、metrics.k8s.io API が stable v1 に昇格しました。この API は、ノードと Pod の CPU およびメモリ使用量に関する重要なデータを提供します。これは、kubectl top やリソースメトリクスベースのオートスケーリングといった重要な機能の基盤となります。クラスターオペレーターおよび開発者にとって、この昇格は API の安定性が保証されたことを意味します。v1 API は、その v1beta1 前身と同じリソースタイプとフィールドを保持しています。v1.6 でアルファとして導入された Resource Metrics API は、v1.8 でベータとなり、長年にわたり本番環境で信頼性高く使用されてきました。この API は、ノードのリソース使用量のための NodeMetrics と、コンテナごとの内訳を含む Pod のリソース使用量のための PodMetrics を公開します。これは、完全なモニタリングソリューションではなく、オートスケーリングと基本的な検査に必要なメトリクスのみを提供するように意図されています。v1 API のサーフェスは v1beta1 と同一であり、API バージョン自体のみを除外しています。kubectl top は両方のバージョンをサポートしており、v1 を優先しますが、Horizontal Pod Autoscaler コントローラーは現在 v1beta1 のみをサポートしています。API は metrics-server のような実装によって API アグリゲーション経由で提供されるため、機能ゲートを有効にする必要はありません。v1 を利用可能にするには、実装がそれをサーブし、関連付けられた APIService が登録されている必要があります。この移行期間中、実装は後方互換性のために v1 と v1beta1 の両方をサーブし続けるべきです。
Kubernetes v1.37、テーマはGarhwal、67の機能強化を伴ってリリースされました。16の機能がStableに、23がBetaに、そして27がAlphaに入りました。リリーステーマは、コミュニティ貢献の相互接続性を象徴しています。主要なStableアップデートは、APIサーバーの起動と復旧を強化し、etcdの過負荷を防ぐ、レジリエントなウォッチキャッシュ初期化です。Horizontal Pod Autoscalerのゼロへのスケール機能は、現在Betaであり、CPUとメモリメトリクスを除き、アイドル時にワークロードをスケールダウンしてコスト削減を可能にします。マニフェストベースのAdmission Control設定もBetaに昇格し、ポリシーとWebhookをディスクからロードできるようになります。Alphaの導入には、コンテナランタイム用の新しいRPCでCRIを拡張する、Podレベルのチェックポイントとリストアが含まれます。注目すべきStableへの昇格には、より安全なYAMLサブセットのためのKYAMLと、リソース使用のためのmetrics.k8s.io APIが含まれます。SELinuxMountとSELinuxChangePolicyフラグは、現在Stableであり、ボリュームに対してデフォルトで有効になっています。いくつかのDevice Resource Allocation (DRA) 機能がStableに到達しました。これには、デバイス設定のためのResourceClaimステータス、拡張リソースリクエストの処理、デバイスのtaintsとtolerations、および標準化されたNUMAノードデバイス属性が含まれます。Node declared features、つまり機能ゲートされたNode機能を宣言するためのフレームワークもStableに昇格しました。
KYAMLは、標準YAMLに見られる問題を解決し、Kubernetesマニフェストを記述するための、より厳格で一貫性のある方法を提供します。YAMLのサブセットとして設計されたKYAMLは、既存のパーサーとの互換性を維持しつつ、スタイルの選択肢を狭めます。これにより、空白文字の感度やサイレントな型変換など、予期せぬ動作につながる可能性のある一般的な落とし穴を防ぐことを目指しています。標準YAMLとは異なり、KYAMLはマップには波括弧、リストには角括弧を使用して、構造と型を明示的に定義します。サイレントな型変換(「NO」がブール値のfalseとして解析される「Norway Bug」など)を回避するために、文字列値の引用を義務付けています。KYAMLは、JSONと比較して設定記述エクスペリエンスを向上させるコメントと末尾カンマもサポートしています。Kubernetes 1.34以降では、kubectl -o kyamlを使用してKYAML出力を生成できます。sigs.k8s.io/yamlfmtやgoogle/yamlfmtのようなツールは、既存のYAMLファイルをKYAML形式に変換できます。KYAMLを採用することは、既存のKubernetesツールやパイプラインに変更を加えることなく、より大きな一貫性とエラーの削減を実現するための選択です。これは、必須の移行ではなく、より堅牢な設定を記述するための新しい習慣です。
Kubernetes Gateway API はバージョン 1.6.0 をリリースし、サービスネットワーキングの機能を強化しました。この新しいリリースは、レイヤー 4 プロトコルルーティングを標準化することで、大きな進歩を遂げました。以前は、Gateway API の安定した基盤は主に HTTP および TLS トラフィック向けでした。バージョン 1.6.0 は、TCPRoute および UDPRoute リソースを安定したバージョン 1 API に追加しました。これらのリソースは、生の TCP および UDP トラフィックのルーティングを可能にし、データベースや IoT テレメトリなどのワークロードのギャップを解消します。実験的なイノベーションも、より明確な API 境界によって合理化されています。新しい実験的リソースは、gateway.networking.x-k8s.io という別の API グループに配置され、'X' プレフィックスを使用します。この区別により、実験的リソースと標準リソースを容易に識別できるようになります。たとえば、XBackend リソースは、拡張バックエンド構成を可能にする新しい実験的追加機能です。これにより、以前は安定した Service リソースで問題があった ExternalHostname のような宛先が可能になります。この実験的機能は、クラウド API へのエグレストラフィックのようなユースケース向けに設計されています。TCP および UDP ルーティングの標準への昇格は、Gateway API をユニバーサルネットワーキングソリューションとして確立します。ユーザーは、さまざまな互換性のある Gateway コントローラー実装でバージョン 1.6.0 を採用できるようになりました。Gateway API コミュニティは、ユーザーおよび開発者からのフィードバックと貢献を奨励しています。
Kubernetesコントローラーは、一般的にGo言語でkubebuilderとcontroller-runtimeを使用して記述され、分散ワークロードの効率的な開発を提供します。しかし、負荷が増加するにつれて、本番環境の問題を回避するためにcontroller-runtimeの内部動作を理解することが重要になります。中心的な概念は、リコンサイラー内のr.Get()とr.List()がAPIサーバーに直接クエリするのではなく、ローカルのインメモリキャッシュにアクセスすることです。このキャッシュは、リスト操作によって最初に設定され、その後ウォッチによって維持されます。この設計により、ローカル読み取りは非常に高速になり、コントロールプレーンへの負荷を回避できます。しかし、トレードオフとして、ローカルキャッシュはかなりのメモリを消費する可能性があり、古いデータを返す可能性があります。対照的に、書き込みは常にキャッシュをバイパスしてAPIサーバーに向けられます。このローカルキャッシュのサイズとインデックス作成戦略は、メモリ使用量に直接影響します。非効率的なList()操作は、多数のオブジェクトの線形スキャンを遅くする可能性があります。リコンサイルループは、望ましい状態と実際の状態を継続的に比較して、それらを一致させます。イベントはキューに入れられ、現在の状態を読み取り、必要なアクションを決定し、新しいイベントを生成する可能性のあるリコンサイル関数につながります。キャッシュの主な目的は、これらのリコンサイルループのためにオブジェクトの状態の迅速で最新のビューを提供することです。このウォッチベースのモデルは、client-goに由来し、更新のための単一の長寿命接続を維持することにより、継続的なAPIポーリングを防ぎます。controller-runtimeは、Reflector、DeltaFIFO、Indexerなどの低レベルのclient-goコンポーネントの複雑さを抽象化します。Managerは、共有キャッシュ、コントローラー、その他のサービスをオーケストレーションします。Informerは特定のGVKを監視し、ローカルストア(Indexer)を維持し、イベントをサブスクライバーにディスパッチします。ResourceEventHandlersはこれらのイベントを処理し、ストアを更新し、それがコントローラーのビューに反映されます。workqueueは、ワーカーによる処理のためにオブジェクトキーを管理し、Predicatesはエンキュー前にイベントをフィルタリングします。ReflectorはAPIサーバーと直接やり取りする唯一のコンポーネントであり、初期リストを実行してからウォッチを確立します。resourceVersionを利用してウォッチを再開し、イベントの見落としがないことを保証します。ウォッチ接続が失われた場合、またはAPIサーバーが古いresourceVersionを示した場合、再リストが実行されます。DeltaFIFOは変更の順序付けられたバッファとして機能し、オブジェクトキーごとにデルタをグループ化します。最後のPop()呼び出し以降のオブジェクトのすべての累積変更を提供し、順序付けられたバッチ処理を保証します。ただし、連続する「追加」または「更新」イベントを折りたたまないため、急速に変化するオブジェクトに対して複数の処理ラウンドが発生する可能性があります。
KubernetesはCPUとメモリに基づいてスケーリングしますが、実際の需要ではキューの深さやアクティブな接続数のようなカスタムメトリクスが必要になることがよくあります。Prometheusメトリクスエクスポーターは、アプリケーションの状態をプレーンテキストでHTTPの/metricsエンドポイントに公開することで、Prometheusがスクレイピングできるようにし、このギャップを埋めます。エクスポーターは、データソースとアプリケーションコードに対する制御に応じて、スタンドアロンサービスとして、またはアプリケーションに直接組み込むことができます。Prometheusは特定のフォーマットでメトリクスを期待します。常に増加する値にはカウンター、変動する値にはゲージ、分布にはヒストグラムを使用します。メトリクス名は明確な__スネークケースの規約に従う必要があります。Goでエクスポーターを構築するには、モジュールの初期化、Prometheusクライアントライブラリの設定、カウンター、ゲージ、ヒストグラムなどのメトリクスの登録を行います。これらのメトリクスは、アプリケーションのデータソースから読み取るポーリングループによって更新されます。HTTPサーバーは、ライブネスプローブ用の/healthzエンドポイントとともに/metricsエンドポイントを公開します。エクスポーターは、マルチステージDockerビルドを使用して最小限のコンテナイメージにパッケージ化され、フットプリントを小さく保ちます。Kubernetesクラスターへのデプロイには、Pod管理のためのDeploymentと、Prometheusに安定したアドレスを提供するServiceが含まれます。Prometheusは、Prometheus Operatorを使用している場合はServiceMonitorを介して、またはPodテンプレートのアノテーションベースのディスカバリを介して、これらのメトリクスをディスカバリします。検証には、Prometheusのターゲットページを確認してエクスポーターが「UP」であることを確認し、式ブラウザでメトリクスをクエリすることが含まれます。この基盤により、HorizontalPodAutoscalerを使用したオートスケーリングが可能になります。これは、Prometheus Adapterのようなメトリクスアダプターを使用して、カスタムメトリクスをKubernetes Custom Metrics APIと統合します。これにより、ワークロードは基本的なリソース使用率だけでなく、ビジネスに関連するシグナルに基づいてスケーリングできるようになります。
Kubernetesは、AIおよび機械学習ワークロードのデフォルトプラットフォームとしてますます普及しています。Kubeflowは、これらのMLタスクを管理するためにKubernetesのカスタムリソース定義(CRD)を活用する人気のツールです。Kubeflowの専門ダッシュボードはデータサイエンティストを支援しますが、基盤となるKubernetesレイヤーをしばしば隠蔽し、オペレーターはトラブルシューティングのためにkubectlを使用せざるを得なくなります。Headlamp Kubeflowプラグインは、一般的なKubernetes UI内でKubeflowのカスタムリソースを直接表示することで、このギャップを埋めます。これにより、オペレーターは他のクラスターコンポーネントと同じプリミティブを使用してMLリソースを監視および管理できます。Headlamp自体は、Kubernetes SIG UIの下で維持されている拡張可能なKubernetes Web UIです。このプラグインは、Kubernetes APIサーバーを直接クエリすることでクラスターレベルの洞察を提供し、名前空間全体にわたるPodの状態、失敗理由、リソース状態の詳細を提供します。Notebooks、Pipelines、ハイパーパラメータチューニング用のKatib、Training、SparkなどのさまざまなKubeflowコンポーネントをサポートしています。このプラグインにより、Kubeflowのバックエンドデータベースに依存することなく、ノートブックPodの詳細、Katibトライアルのステータス、パイプラインの状態を検査できます。また、MLリソースをHeadlamp内のグラフノードとしてマッピングし、それらの間の関係を視覚化します。このアプローチは、CRDが多用されるプラットフォームが、オペレーターに使い慣れたツール内で不可欠なクラスターレベルの可視性を提供するためのパターンを示しています。
Kubernetes DashboardとHeadlampはクラスターの可視性を提供しますが、機能は異なります。Headlampはデスクトップまたはインクラスターのクライアントであり、kubeconfigを使用して複数のクラスターに接続し、ユーザーIDを尊重します。Kubernetes Dashboardは、通常トークン認証を介してアクセスされるインクラスターのWebアプリケーションです。移行するには、現在のDashboardの使用状況を文書化し、kubeconfigが機能することを確認し、並行ロールアウトのようなロールアウト計画を選択します。Headlampをデスクトップで実行するか、クラスター内で実行するかを決定します。デスクトップは個々の使用には高速ですが、クラスター内は共有アクセスに適しています。デスクトップのインストールはパッケージマネージャーを介して簡単に行えますが、インクラスターのインストールはHelmまたはYAMLマニフェストを使用します。デスクトップHeadlampの認証はkubeconfigに依存しますが、インクラスターの設定では、サインインのためにOpenID Connect(OIDC)または外部認証レイヤーがよく使用されます。RBAC権限はHeadlampによって尊重されるため、ユーザーは承認されているアクションのみを表示および実行できます。Headlampはマルチクラスター管理に優れており、ユーザーはUI内で直接kubeconfigを使用してクラスターを切り替えることができます。これにより、Kubernetes Dashboardの単一クラスターの焦点と比較して、より統合されたエクスペリエンスが得られます。
SIG etcd は、分散型キーバリューストアの重要なアップデートである etcd v3.7.0 のリリースを発表しました。このリリースでは、待望の RangeStream 機能が導入され、大規模な結果セットの効率的なストリーミングが可能になります。また、より高速なリース操作や最適化されたキーのみのレンジリクエストを含む、さまざまなパフォーマンスの向上が実現されています。レガシーな v2 ストアへの依存は完全に排除され、etcd は v3store からのみ起動するようになり、運用が簡素化されました。包括的な protobuf のオーバーホールにより、古いライブラリがサポートされているバージョンに置き換えられ、セキュリティと保守性が向上しました。このリリースでは、コア依存関係も更新され、bbolt は v1.5.1、raft は v3.7.0 になりました。さらなる改善点として、ローカル開発およびテスト用の Unix ソケットのサポートが含まれます。etcdutl コマンドには、無期限のブロックを防ぐためのタイムアウト引数が追加されました。Client v3 は、直接 JWT を設定できる機能と、認証なしで AuthStatus を取得できる機能により、認証の柔軟性が向上しました。監視強化のために、新しいウォッチおよびリクエストの期間メトリクスが追加されました。etcdctl コマンドは明確化のために再編成され、非推奨の実験的フラグは削除されました。レガシーな v2 API パッケージおよびコードの大規模なクリーンアップも実施されました。
AIはソフトウェア開発を変革し、コード生成を通じてより多くの貢献者を可能にしています。しかし、この進歩はコード保守の改善を上回っており、課題を提示しています。Kubernetesコミュニティは、包括的なAIポリシーを確立することで、AI支援コーディングに積極的に適応しています。このポリシーは、イノベーションと説明責任のバランスを取り、コード品質と人間の監督を確保することを目的としています。中核的な原則は透明性であり、貢献者はプルリクエストでAIの使用を開示する必要があります。極めて重要なのは、人間の説明責任が最優先されることです。AIは共同著者または共同署名者としてリストすることはできません。貢献者は、AI生成コードについても個人的に説明する必要があり、知識のギャップを防ぎます。プロジェクトは、AI支援のものを含むすべての共同著者に対して貢献者ライセンス契約を施行し、不完全なPRにフラグを立てます。コード品質を向上させ、初期フィードバックを提供するために、自動AIレビューが検討されています。GitHub CopilotやCodeRabbitのようなツールは、特定のKubernetesプロジェクト内で評価およびテストされています。これらのツールは、人間のレビューの前に迅速なスポットチェックを提供する品質ゲートとして機能できます。コミュニティは、レビューツールの調整、新興AI技術の評価、およびメンテナーの燃え尽き症候群の軽減とテストトリアージの支援におけるAIの可能性の探求に積極的に協力を求めています。
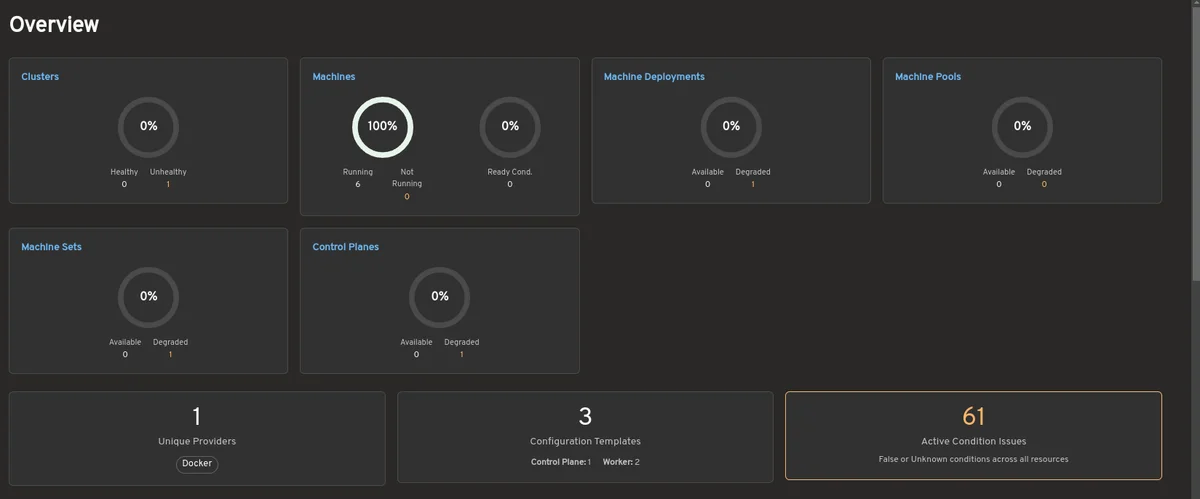
Headlampは、ブラウザからクラスターリソースを管理するためのオープンソースのKubernetes UIプロジェクトです。Cluster API (CAPI) は、クラスターライフサイクル管理のための宣言的なKubernetesスタイルのAPIを提供します。Headlamp Cluster APIプラグインは、CAPIリソースの管理を簡素化し、生のkubectlコマンドの必要性をなくします。このプラグインは、Headlampに専用のCAPIセクションを追加し、一貫したリストビューと詳細ビューを通じて、コアCAPIリソースへの完全な可視性を提供します。主な機能には、クラスター概要、Machineの可視性、およびヘルスモニタリングのための集中化されたCluster APIダッシュボードが含まれます。ユーザーは、KubeadmControlPlaneレプリカを追跡し、MachineDeploymentsとMachineSetsをスケーリングし、所有リソース階層を視覚化できます。このプラグインは、生のYAMLなしでKubeadmConfigを検査でき、トポロジー認識も提供します。マップビューは、Cluster、Control Plane、およびWorkerの関係を視覚化し、v1beta1とv1beta2の両方のCluster APIバージョンをサポートします。Prometheusメトリクスは、詳細ページにインラインでライブパフォーマンスデータを提供するために統合されています。CNCF LFX Mentorshipプログラム中に開発されたこのプラグインは、Cluster API管理エクスペリエンスを向上させることを目的としています。これはアルファリリースであり、今後の開発のためにコミュニティからのフィードバックを奨励しています。
CdXz5zHNQW_bupmQg41I4.png
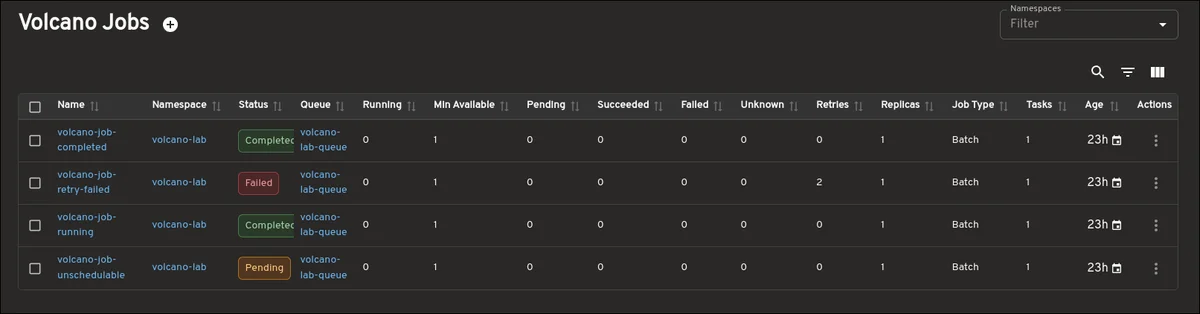
Volcanoは、ハイパフォーマンスコンピューティング、AI/ML、その他のバッチワークロード向けに設計された、Kubernetes向けのクラウドネイティブなバッチスケジューラです。Kubernetesは元々長時間実行されるサービスのために構築されましたが、バッチワークロードはしばしば動的なジョブの到着、リソースの競合、複数のワーカーの同時起動を必要とします。Volcanoは、キュー、優先度、クォータ、ギャングスケジューリングといった概念でKubernetesを拡張し、ワークロードを独立したPodではなく、全体として扱います。拡張可能なKubernetes Web UIであるHeadlamp向けのVolcanoプラグインは、これらのスケジューリングの詳細を単一のインターフェースにもたらします。このプラグインは、Volcano Jobs、Queues、PodGroups専用のビューを提供し、バッチワークロードの運用とトラブルシューティングを容易にします。Jobビューは、ワークロードのステータス、タスクの詳細、Podのステータスを表示し、一時停止/再開やログへのアクセスといった直接的な操作を可能にします。Queueビューは、リソース割り当て、容量、予約の詳細に関する洞察を提供します。PodGroupビューは、ギャングスケジューリングの状態と潜在的なブロッカーを明確にします。重要な機能の1つはマップビューであり、Jobs、Queues、PodGroups、Podsがどのように相互接続されているかを視覚的に表現し、保留中または進行しないワークロードの問題を迅速に特定するのに役立ちます。このプラグインは、自動化のためのCLIツールを置き換えることなく、関連リソース、構造化された詳細、および実行時出力を一元化することで、インタラクティブなトラブルシューティングエクスペリエンスを強化します。将来の機能強化には、Prometheusとの統合や、より豊富なスケジューリングの洞察が含まれる可能性があります。ユーザーは、HeadlampのPlugin Catalogを通じてプラグインをインストールし、その開発を形成するためのフィードバックを提供できます。
CdXz5zHNQW_lVauTs2nj6.png
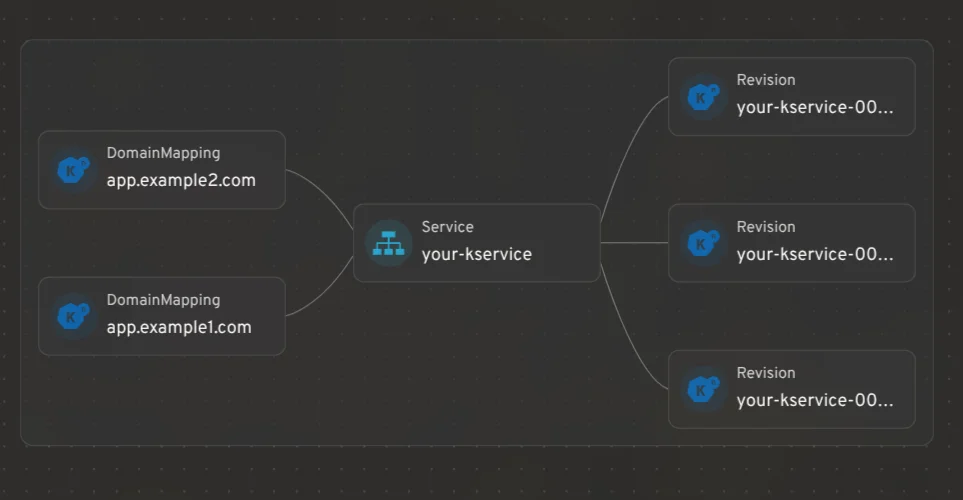
Headlampは、Kubernetesリソースを管理およびデバッグするために設計されたオープンソースプロジェクトです。KnativeはKubernetes上でサーバーレスワークロードを可能にしますが、複数のツールを横断して運用するのは複雑になる可能性があります。この課題に対処するため、Knative用のHeadlampプラグインが開発されました。このプラグインにより、ユーザーはHeadlamp内からKnativeを包括的に管理できます。KnativeリソースをHeadlampのリソースマッピングビューに統合し、KService、Revision、DomainMapping間の関係を表示します。プラグインはKServiceの詳細ビューを提供し、トラフィック分割とオートスケーリング構成のライブ編集を可能にします。ユーザーは、KServiceヘッダーから直接ポッドを再起動したり、ログにアクセスしたりすることもできます。プラグインは、段階的なロールアウトとA/Bテストのために、リビジョン間の詳細なトラフィック分割を容易にします。各リビジョンのトラフィック分布、準備状況、タグを視覚的に表示します。オートスケーリング構成は明確に提示され、設定が明示的であるか、クラスターのデフォルトから継承されているかを示します。Prometheusプラグインと組み合わせると、KServiceおよびRevisionのリクエストレートやレイテンシなどのメトリクスを提供します。プラグインは、Revision、DomainMapping、およびネットワーキングの概要を含む、他のKnative CRDのリストビューと詳細ビューも提供します。インストールは、HeadlampのプラグインカタログからKnativeプラグインを検索してインストールすることを含みます。フィードバックやバグレポートは、GitHubのissueまたはKubernetes Slackチャンネルを通じて提出できます。
CdXz5zHNQW_uA3Yt1MH58.png
デバイス管理ワーキンググループは、Kubernetesにおける特殊ハードウェア管理の増大するニーズに対応します。GPU、TPU、および特定のネットワークインターフェースを必要とするAI、エッジ、および通信ワークロードには、従来のコンピューティングリソース割り当て方法では不十分です。ワーキンググループの主要プロジェクトである動的リソース割り当て(DRA)は、一般提供可能(General Availability)に達し、大きな進歩を示しました。DRAは、モデリング、要求、スケジューリング、およびアクチュエーションの4段階の構造化されたフレームワークでデバイス管理を提供します。この新しいアプローチにより、ベンダーは詳細なハードウェア機能を宣伝でき、ユーザーは正確なハードウェア要件を指定できます。その後、Kubernetesスケジューラは、これらの要件をインテリジェントに利用可能なハードウェアに一致させます。DRAは、デバイスを単純な整数として扱っていた従来のデバイスプラグインAPIを、柔軟で宣言型のAPIに置き換えます。ワーキンググループは、Kubernetesコンポーネント全体での包括的な統合を確保するために、複数のSIGが関与するクロスSIGの取り組みです。現在の取り組みは、DRAの表現力の向上、運用可視性のサポート、およびマルチノードおよび複雑なハードウェアトポロジ管理の改善に焦点を当てています。今後の作業には、デバイスのヘルスモニタリングと、グループ化されたデバイス使用のサポート強化が含まれます。ワーキンググループは、Kubernetesのよりプログラマブルでハードウェアを意識した未来を創造することを目指しています。
この記事は、永続データとボリューム管理を担当するKubernetesの特別関心グループであるSIG Storageに焦点を当てています。SIG Storageの共同議長であるXing Yangは、グループが基本的な永続ボリュームの処理から複雑なストレージ機能の推進へと進化してきた経緯について説明しています。当初はステートレスワークロード向けに設計されたKubernetesは、現在ではステートフルアプリケーションもサポートしており、専用のストレージソリューションが必要となっています。SIG Storageはこれらの課題に対処するために結成され、PersistentVolumesやPersistentVolumeClaimsといったプリミティブを導入しました。重要な進歩は、サードパーティのストレージプロバイダーがコアKubernetesの変更なしにシステムを統合できるようにするContainer Storage Interface(CSI)でした。現在の作業には、クラッシュ整合性のあるマルチボリュームスナップショットのためのVolume Group Snapshotと、効率的なバックアップのためのChanged Block Trackingが含まれており、これらは最近安定版に昇格しました。Container Object Storage Interface(CSI)も、オブジェクトストレージ統合の標準化に向けて進んでいます。ユーザーにとって最近の成果としては、IOPSのようなストレージプロパティの動的な調整を可能にするVolumeAttributesClassが一般提供(General Availability)に昇格したことが挙げられます。将来のロードマップには、運用上の可視性を向上させるためのVolume Healthと、潜在的な自動修復機能が含まれています。SIG Storageは、バグ修正、テスト、レビュー、およびMutable PV Affinityやボリュームレプリケーションのような機能に関するフィードバックについて、コミュニティの協力を求めています。ステートフルワークロードの課題には、データグラビティ、Day-2運用の複雑さ、データモビリティが含まれます。AIワークロードが増加するにつれて、Kubernetesにおけるストレージはよりインテリジェントになると予想されており、オブジェクトストレージが重要性を増しています。高性能、低遅延ストレージ、およびデータ認識スケジューリングも、予想されるトレンドです。SIG Storageは、これらの進化するストレージ需要に対処するために、コミュニティの関与を歓迎しています。
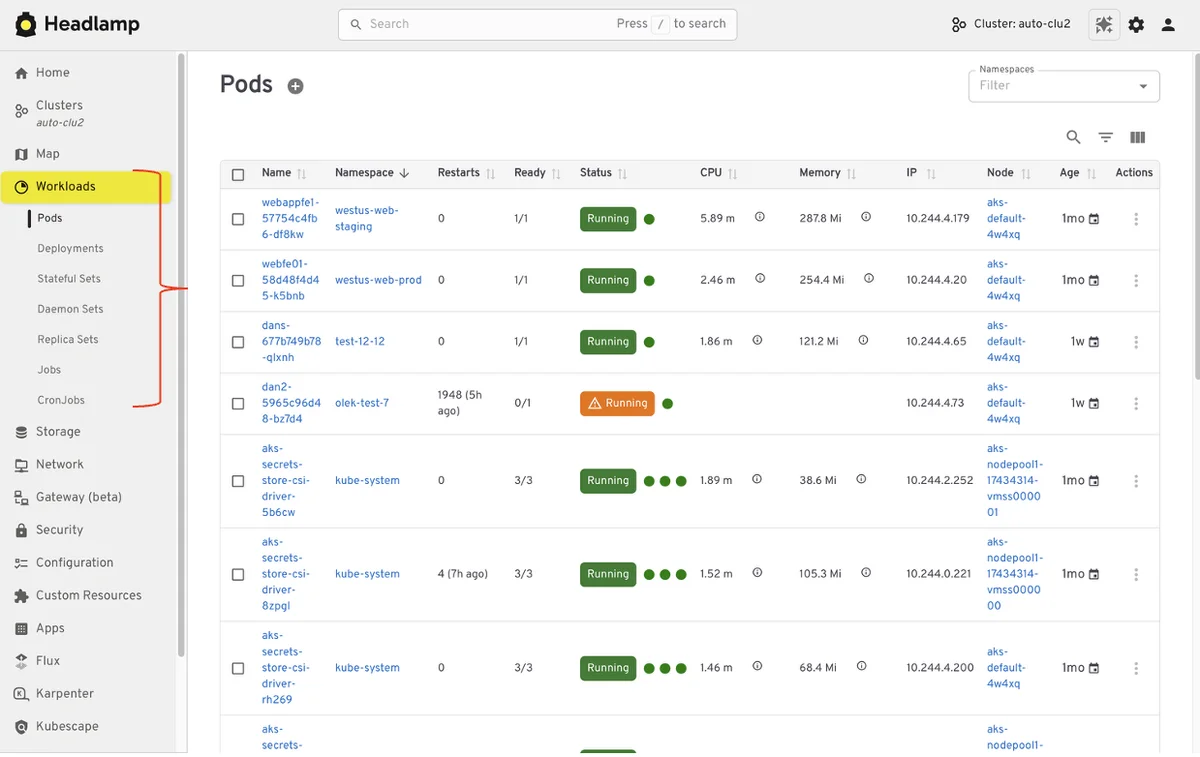
Kubernetes Dashboardは、かつてKubernetesの主要なビジュアルインターフェースでしたが、アーカイブされました。多くのユーザーにとって重要なオンランプとして機能し、クラスターの可視性とリソースの検査を簡素化しました。Headlampは、Dashboardの基盤の上に構築され、このレガシーを引き継いでいます。モダンなKubernetesの使用パターンを取り入れながら、明確なビジュアルインターフェースを提供します。Headlampは、マルチクラスターの可視性、Projectsを通じたアプリケーション中心のビュー、そしてプラグインによる拡張性を提供します。この移行は、Dashboardのユーザー中心のレガシーを尊重し、成長し続けるUIソリューションを提供することを目的としています。Kubernetes Dashboardの多くの使い慣れたワークフローはHeadlampにも引き継がれており、継続性と使いやすさを保証します。Headlampは、単一のインターフェースからマルチクラスター管理を可能にすることで機能を拡張し、分散環境での摩擦を軽減します。Headlamp内のProjectsは、関連リソースをグループ化して理解とトラブルシューティングを容易にする、アプリケーション中心のビューを提供します。このプラットフォームは、GitOpsワークフロー用のFluxプラグインやガイダンス用のAIアシスタントなどのプラグインを通じて拡張可能です。Headlampは、クラスター内ツールまたはデスクトップアプリケーションとして使用できる柔軟なデプロイメントオプションを提供します。現在のDashboardの使用状況(クラスター、名前空間、認証を含む)を理解することは、Headlampへのスムーズな移行を支援します。
CdXz5zHNQW_NGyZ88sXD3.png
Kubernetesは、より正確なCVEレコードを洗練させることで透明性を向上させています。古いCVEレコードには不一致が発見されており、一部では修正済みバージョンが誤って記載されていました。Kubernetesセキュリティ対応委員会は、2026年6月1日にこれらのレコードを修正します。これにより、脆弱性スキャナーが以前は検出されなかった問題を発見する可能性があります。この記事では、修正されていない3つの脆弱性、CVE-2020-8561、CVE-2020-8562、およびCVE-2021-25740に関する技術的な詳細を提供します。これらの更新により、正確な脆弱性スキャンが保証され、継続的な管理者による緩和策の必要性が明確になります。修正されていないCVE-2020-8554も、標準化されたバージョン番号形式で提供されます。特定された脆弱性が修正されていないのは、それらを修正するとKubernetesのコア機能が中断されるためです。各脆弱性には、管理者がクラスターを保護するために実装すべき特定の緩和策があります。これらの脆弱性のアーキテクチャ上の性質を考慮すると、これらの措置は非常に重要です。プロジェクトは、これらのリスクを管理するための「設定によるセキュア」アプローチを強調しています。これらのレコードの更新は、透明性と正確なリスク評価を促進する、成熟したセキュリティエコシステムを示しています。
SIG-Etcd は、分散データベースの重要なアップデートである etcd v3.7.0 の最初のベータ版をリリースしました。このバージョンでは、大規模な結果セットの処理を改善し、レイテンシとメモリ管理を強化するように設計された機能である RangeStream が導入されています。このリリースには、レガシーコンポーネントとインターフェースのリファクタリングとクリーンアップも含まれており、全体的なパフォーマンスが向上しています。開発者は、ユーザーにベータ版をテストし、etcd リポジトリで見つかった問題を報告することを奨励しています。主なハイライトは、etcd v2store の最後の痕跡が削除され、v3store への移行が完了したことです。この移行は、特に v3.6.11 にいないユーザーにとって、破壊的な変更をもたらす可能性があるため、遭遇した問題に関するフィードバックが求められています。このベータリリースには、bbolt および raft ライブラリのアップデートも組み込まれています。さらに、リリース時期は etcd v3.4 のサポート終了 (EOL) に連動しており、5 月以降はアップデートが停止されます。コミュニティは、最終的な廃止前に、必要に応じて v3.4 の追加セキュリティパッチをリリースする準備ができています。ユーザーは v3.4 からのアップグレードを強く推奨されています。今後のベータ版は計画されており、プロトバッファのリファクタリングがさらに進み、6 月または 7 月初旬にリリース候補版と最終版が登場する可能性があります。フィードバックは、GitHub のイシュー、Kubernetes Slack チャンネル、および etcd-dev メーリングリストを通じて積極的に募集されています。
このブログ記事は、当初日付が誤って記載されていましたが、現在は2026年5月15日の公開日となっています。Kubernetes v1.36では、Cloud Controller Managerのルートコントローラーに新しいアルファ版メトリックroute_controller_route_sync_totalが導入されました。このメトリックは、クラウドプロバイダーとのルート同期操作を追跡し、CloudControllerManagerWatchBasedRoutesReconciliationフィーチャーゲートの監視に役立ちます。このフィーチャーはv1.35で導入され、ルートコントローラーをウォッチベースのアプローチに切り替えます。この変更により、ノードが変更された場合にのみルートを調整するため、APIコールが削減されます。新しいフィーチャーをテストするには、フィーチャーゲートが無効な場合と有効な場合でメトリックの動作を比較してください。フィーチャーゲートが無効な場合、カウンターは一定の間隔で増加します。逆に、フィーチャーが有効な場合、カウンターはノードの変更時にのみ増加します。この違いは、ノードの変更がまれな安定したクラスターで最も顕著です。フィードバックは、Kubernetes Slack、GitHubイシュー、SIG Cloud Providerコミュニティページで提供できます。詳細については、KEP-5237を参照してください。
Mixed Version Proxy (MVP) は、不明なリソースのリクエストを新しいAPIサーバーに安全にルーティングすることで、Kubernetesクラスターのアップグレードを強化し、404エラーを防ぎます。Kubernetes 1.28でAlpha機能として最初に導入されたMVPは、バージョン1.36でBetaに移行し、デフォルトで有効になります。MVPは、アップグレード中のAPIサーバーのバージョンが異なる場合に発生する問題を解決します。新しいリソースに対するリクエストが古いサーバーで失敗する可能性があります。誤った404の代わりに、リクエストはそれを処理できるサーバーにプロキシされます。MVPのBetaバージョンは、ピアの機能を判断するためにStorageVersion APIの代わりに集約されたディスカバリを使用し、機能を向上させます。このアップデートには、ピア集約ディスカバリも含まれており、クライアントに利用可能なすべてのAPIの統一されたビューを提供します。MVPを有効にするには、APIサーバーは--peer-ca-fileフラグを必要とし、必要に応じて--peer-advertise-ipおよび--peer-advertise-portも必要です。kubeadmを使用すると、これらのフラグをClusterConfigurationファイルに含めることで、プロセスを合理化できます。ユーザーは、ステージング環境でMVPをテストし、1.36アップグレードの一部としてSIG API Machineryにフィードバックを提供することが推奨されます。
Kubernetes Service の .spec.externalIPs フィールドは、当初クラウド外のロードバランサー機能のために設計されましたが、CVE-2020-8554 で特定されたセキュリティ脆弱性により、現在非推奨となっています。このフィールドは、Service が応答する追加の IP アドレスを指定できますが、すべてのユーザー間の信頼を前提としているため、固有のセキュリティリスクがあります。Kubernetes 1.21 ではすでに .spec.externalIPs の無効化が推奨され、これを強制するためのアドミッションコントローラーが導入されました。代替手段として、手動で管理される LoadBalancer サービスや、MetalLB のようなクラウド外ロードバランサーコントローラーは、より優れたセキュリティと制御を提供します。MetalLB は、管理者が IP アドレスの割り当てを制御できるようにし、セキュリティ上の懸念を軽減します。Gateway API も安全なソリューションを提供し、管理者が Gateway リソースを通じて IP を制御できるようにします。Kubernetes 1.36 では .spec.externalIPs が正式に非推奨となり、その使用に関する警告が発行され始めました。Kube-proxy によるこの機能のサポートは将来のリリースで無効化され、完全な削除は後続のバージョンで計画されています。ユーザーは、この安全でない機能から移行することが推奨されます。
Kubernetes v1.35 は、Workload API や同一 Pod に対する基本的な gang scheduling を含む、ワークロード認識型スケジューリングの改善を導入しました。Kubernetes v1.36 は、Workload API(静的テンプレート)を新しい PodGroup API(実行時状態)から分離することで、このアーキテクチャを洗練させます。この分離により、kube-scheduler が直接 PodGroup 情報を読み取れるようになり、パフォーマンスが向上します。新しい PodGroup スケジューリングサイクルは、ワークロードの原子的な処理を可能にし、デッドロックを防ぐためにグループ全体を統一された操作として評価します。有効な配置が見つかり、グループ制約が満たされた場合、Pod は一緒にバインドされます。それ以外の場合、グループ全体はスケジューリング不可能と見なされ、後で再試行されます。これは、厳格なワークロード要件に対するオール・オア・ナッシングの配置を保証する gang scheduling の基盤を形成します。v1.36 のトポロジー認識型スケジューリングは、PodGroup に対するトポロジー制約の定義を可能にし、ネットワーク遅延を削減するために特定の物理的または論理的なドメイン内に Pod を共同配置します。これには、スケジューリング制約に基づいて候補配置の生成、評価、スコアリングが含まれます。ワークロード認識型プリエンプションは、PodGroup スケジューリングサイクルをサポートするために導入され、PodGroup 全体に対応するスペースを確保するために複数のノードから同時に Pod をプリエンプトします。PodGroup を単一のプリエンプターユニットとして扱い、PodGroup の優先度と disruptionMode フィールドがプリエンプションの動作を制御します。最後に、v1.36 は Dynamic Resource Allocation (DRA) を Workload API と統合し、PodGroup が ResourceClaims を介して特殊なハードウェアリソースを要求および共有できるようにします。これらの進歩は、将来の Kubernetes リリースにおける高度なワークロードスケジューリング機能の構築のための堅牢な基盤を築きます。
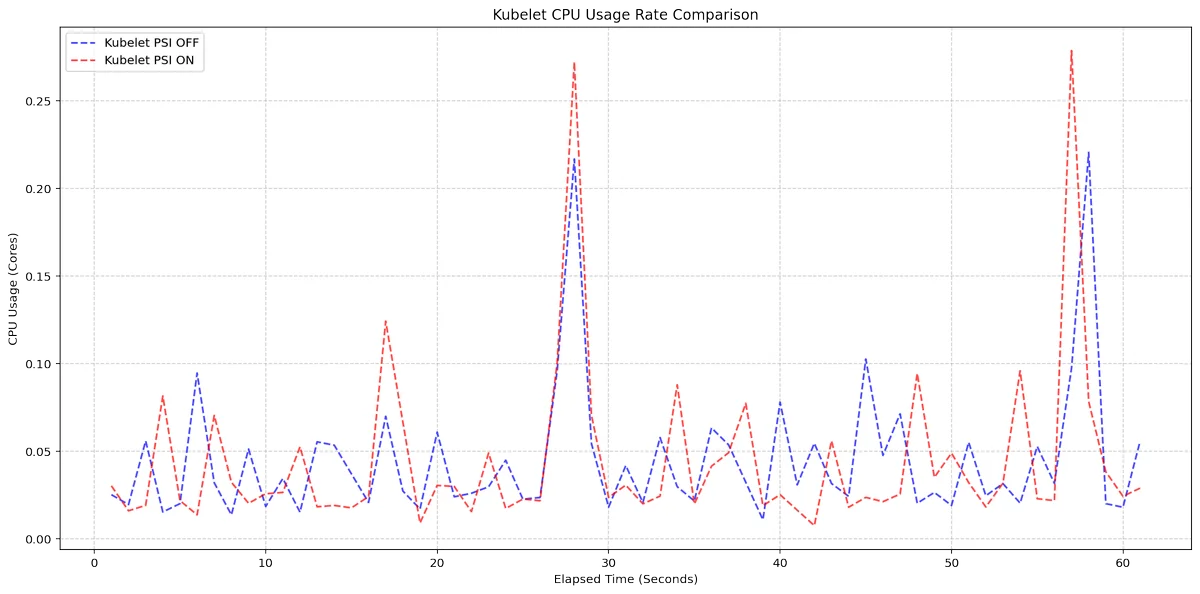
Pressure Stall Information (PSI) は 2018 年から Linux カーネルに統合されており、リソース飽和が障害につながる前に特定するための高忠実度シグナルを提供します。従来の利用率メトリクスとは異なり、PSI は CPU、メモリ、I/O 全体で停止したタスクと失われた時間を定量化します。Kubernetes v1.36 では、ノード、ポッド、コンテナレベルでのリソース競合を監視するための安定したインターフェースが利用可能になりました。PSI は、一時的なスパイクと持続的なリソースの緊張を区別するために、停止時間の累積合計と移動平均(10 秒、60 秒、300 秒)を提供します。SIG Node による高密度ワークロード(80 個以上のポッド)での広範なパフォーマンス テストにより、PSI の本番環境への対応が証明されました。KubeletPSI フィーチャーゲートを切り替えることで測定された Kubelet のオーバーヘッドは、リソース使用量への影響は無視できる程度でした。Kubelet の収集ロジックは軽量であることが証明され、標準のハウスキーピング サイクルにシームレスに統合され、0.1 コア未満またはノード容量の 2.5% 未満を消費しました。カーネル オーバーヘッドに関して、Linux カーネルで PSI を有効にすると(psi=1 対 psi=0)、高負荷下で 0.037 から 0.125 コア(ノード容量の 0.925% ~ 3.125%)の一貫した差が生じました。プライマリ コレクターである kubelet プロセスも、驚くほど低い CPU 使用率を維持し、スパイクは 1 秒を超えて 0.25 コア(6.25%)を超えることはありませんでした。v1.36 の改善点には、よりスマートなメトリクス発行が含まれます。Kubelet は、誤解を招くゼロ値のメトリクスを報告する前に、cgroup 構成を通じて OS レベルの PSI サポートを検出するようになりました。PSI を使用するには、ノードは Linux カーネル 4.20 以上を実行し、cgroup v2 を使用し、OS レベルで PSI が有効になっている必要があります(CONFIG_PSI=y、psi=0 ブート パラメータなし)。PSI メトリクスは v1.36 で一般的に利用可能であり、フィーチャーゲートのオプトインは不要です。ユーザーは /metrics/cadvisor エンドポイントをスクレイピングするか、Summary API をクエリできます。PSI は Linux カーネル機能であり、Windows ノードでは利用できません。コントロール プレーンの API サーバーを介して Kubelet の HTTP API にプロキシすることで、Summary API からリアルタイムの圧力データを取得できますが、これは特権操作です。
CdXz5zHNQW_xWB13lRlZh.png
Kubernetes v1.36 は、以前は Alpha および Beta の機能拡張であったボリュームグループスナップショットの一般提供 (GA) を導入します。この機能は、拡張 API を活用して、複数のボリュームのクラッシュ整合性スナップショットを同時に有効にします。システムはラベルセレクターを使用して PersistentVolumeClaim オブジェクトをグループ化し、ワークロードを整合性のあるリカバリポイントにリストアできるようにします。この機能は CSI ボリュームドライバーでのみサポートされており、書き込み順序の整合性を必要とする複数のボリュームを利用するアプリケーションに大きな利点をもたらします。以前は、個々のボリュームスナップショットは、特にマルチボリュームアプリケーションの場合、異なる時間に取得されると不整合を引き起こす可能性がありました。グループスナップショットは、手動でのアプリケーションの静止の必要性をなくし、煩雑な逐次的な個々のスナップショットなしに、グループ内のすべてのボリュームでクラッシュ整合性を提供します。Kubernetes は、3 つのカスタム API の種類である VolumeGroupSnapshot、VolumeGroupSnapshotContent、および VolumeGroupSnapshotClass を通じてグループスナップショットを管理します。これらの CRD は、GA リリースで v1 に昇格され、ユーザーはそれぞれグループスナップショットを要求し、プロビジョニングされたリソースを追跡し、作成ポリシーを定義できます。GA リリースでは、以前のベータ版からのフィードバックに基づいた安定性の向上、バグ修正、およびリストアサイズのレポートの改善がもたらされます。この機能を使用するには、ユーザーはグループ化する PersistentVolumeClaims にラベルを付け、これらのラベルに一致するセレクターと VolumeGroupSnapshotClass を持つ VolumeGroupSnapshot オブジェクトを定義する必要があります。リストアの場合、新しい PersistentVolumeClaims は、より大きな VolumeGroupSnapshot の一部である個々の VolumeSnapshot オブジェクトから作成されます。ストレージベンダーは、CSI ドライバー内に新しいグループコントローラーサービスと RPC を実装することでサポートを追加できます。
Kubernetes v1.36 の Dynamic Resource Allocation (DRA) は、CPU やメモリなどのネイティブリソースにまで機能を拡張し、専門的なハードウェアを超えた大幅な進歩をもたらします。ネットワークを含むさまざまなハードウェアタイプに対するドライバーサポートが拡大しており、DRA はよりハードウェアに依存しないソリューションとなっています。スケジューリングの柔軟性とクラスターの利用率を高めるいくつかの主要な機能が卒業しました。Prioritized list 機能は、デバイスリクエストのフォールバックプリファレンスを可能にし、リソース割り当ての効率を向上させます。Extended resource support は、従来の拡張リソースを介したリソースリクエストを可能にすることで、DRA への段階的な移行を可能にします。Partitionable devices は、物理ハードウェアをより小さく論理的なインスタンスに動的に分割するためのネイティブ DRA サポートを提供します。Device taints は、障害のあるデバイスの割り当てを防いだり、特定のハードウェアを予約したりすることで、管理者がハードウェアをより効果的に管理できるようにします。Device binding conditions は、外部リソースが完全に準備されるまで Pod のコミットメントを遅延させることで、スケジューリングの信頼性を向上させます。Resource health status は、Pod ステータスにデバイスの正常性情報を直接公開し、ハードウェア障害の迅速な特定と対応を支援します。新しいアルファ機能には、PodGroups 間で共有リソースを管理することにより、大規模な AI/ML を最適化する、ワークロード向けの ResourceClaim サポートが含まれます。Node allocatable resources は、CPU とメモリの割り当てを DRA の傘下に統合し、きめ細かなパフォーマンスチューニングを可能にします。DRA リソースの可用性の可視性は、管理者にリアルタイムのデバイス容量情報を提供し、より良い計画を可能にします。Deterministic device selection は、ドライバーが辞書順によるスケジューリングに影響を与えることを可能にします。コンテナ内の Discoverable device metadata は、ドライバーがデバイス属性をコンテナに公開するための標準プロトコルを提供します。将来のロードマップは、既存の機能の成熟、パフォーマンスとスケーラビリティの向上、ワークロード認識型およびトポロジー認識型スケジューリングとの統合に焦点を当てており、Device Plugin からのユーザーの DRA への移行に重点を置いています。
Kubernetesコントローラーは、特に高カーディナリティのリソースを監視する際に、クラスターサイズが増加するにつれてスケーリングの課題に直面します。クライアントサイドシャーディングは機能的ですが、APIサーバーからのデータ量を削減しないため、非効率性を引き起こします。Kubernetes v1.36でアルファ機能(KEP-5866)として導入されたサーバーサイドシャーディングリストとウォッチは、この非効率性を解消します。APIサーバーは、コントローラーが指定したハッシュ範囲に基づいてイベントをフィルタリングし、各レプリカに関連するデータのみを送信します。コントローラーはインフォーマーを使用してリソースをリストおよびウォッチし、WithTweakListOptionsを介してshardSelectorを組み込みます。shard selectorは、オブジェクトのmetadata.uidまたはmetadata.namespaceに基づいてリソースをフィルタリングするために使用されます。APIサーバーは、shard selectorが正しく適用されたことを確認するために、リスト応答メタデータにshardInfoフィールドを返します。これが存在しない場合、クライアントは完全なフィルタリングされていないコレクションを処理する必要があり、クライアントサイドフィルタリングに頼る可能性があります。この機能には、ShardedListAndWatchフィーチャーゲートを有効にする必要があります。Kubernetesコミュニティは、特に大規模クラスターを管理しているコントローラー作成者やオペレーターからのフィードバックを求めています。このアプローチは、要求の厳しいKubernetes環境におけるコントローラーのパフォーマンスとスケーラビリティを向上させるように設計されています。
Kubernetes v1.36 は、ネイティブ型向けの宣言的バリデーションを導入し、一般提供を開始しました。これにより、バリデーションルールの定義が手書きの Go コードから IDL タグへと移行し、API の信頼性と予測可能性が向上します。以前は手書きコードに依存していたため、技術的負債、不整合、不透明な API が生じていました。このソリューションは、タグを解析して Go のバリデーション関数を自動生成するコードジェネレーターである validation-gen を利用します。このフレームワークには、存在、制約、コレクション、ユニオン、不変性に関するさまざまなマーカータグが含まれています。主な利点は「アンビエントラチェッティング」であり、既存のオブジェクトを壊すことなく、バリデーションを即座に厳格化または緩和できます。宣言的バリデーションにより、kube-api-linter のようなツールを使用した API レビューが容易になり、一貫性が向上します。プロジェクトは、残りのレガシーコードの移行と、新しい API に対する宣言的バリデーションの義務化を計画しています。これにより、kubectl のようなツールによるクライアントサイドバリデーションや、Kubebuilder のようなツールとの統合など、将来的なエコシステムのメリットも解き放たれます。移行は進行中であり、Kubernetes コードベースへの貢献の機会があります。このドキュメントは、貢献者への謝辞で締めくくられ、Kubernetes バリデーションの宣言的な未来を歓迎しています。
Kubernetes の v1.36 で導入されたマニフェストベースの Admission Control は、クラスターブートストラップ中のセキュリティポリシー施行のギャップに対処します。既存の API ベースの Admission Control には脆弱性があります。ポリシーは API オブジェクトであり、削除される可能性があるため、セキュリティ上のウィンドウが生じます。この新機能により、Admission Webhook と CEL ベースのポリシーを、API サーバーが起動時にロードするファイルとして定義できます。これにより、リクエストが処理される前にポリシーがアクティブになり、不正な変更から保護されます。これは、AdmissionConfiguration ファイルの staticManifestsDir フィールドを使用して、ポリシー YAML ファイルを含むディレクトリを指定します。これらのファイルは、API ベースの設定と区別するために、.static.k8s.io で終わる名前を持つ必要があります。この機能は、Admission 設定自体を削除や変更から保護できます。マニフェストファイルへの変更は、実行時に自動的に更新されます。API サーバーは、起動中に厳密な検証を施行し、実行時の更新をアトミックに処理します。これを実装するには、ManifestBasedAdmissionControlConfig フィーチャーゲートを有効にする必要があります。
Kubernetes v1.36 は、アルファ機能として Pod レベルのリソースマネージャーを導入し、パフォーマンスに敏感なワークロードのリソース管理を強化します。これは、kubelet の Topology Manager、CPU Manager、Memory Manager を、コンテナごとの仕様を超えた、ポッド中心のリソース割り当てモデルに拡張します。これにより、プライマリアプリケーションコンテナに対して、軽量なサイドカーを効率的にサポートしながら、専用の NUMA アラインされたリソースを提供するという課題に対処します。以前は、予測可能なパフォーマンスを実現するためには、すべてのコンテナに専用リソースを割り当てる必要がありましたが、サイドカーにとっては無駄でした。あるいは、そうしないと、ポッドの Guaranteed QoS が犠牲になっていました。Pod レベルのリソースマネージャーは、ハイブリッド割り当てを可能にし、高性能ワークロードがリソースを無駄にすることなく NUMA アラインメントを実現できるようにします。例えば、レイテンシに敏感なデータベースポッドでは、メインコンテナが専用の CPU とメモリを受け取り、サイドカーは他のノードリソースから分離された、別のポッド共有プールを共有できます。別のユースケースとしては、トレーニングコンテナが専用の NUMA アラインされたリソースを受け取り、サービスメッシュサイドカーが一般的なノード全体共有プールで実行される ML ワークロードが挙げられます。CPU の分離は、専用コンテナに対する CFS クォータの強制を無効にし、共有プールコンテナに対してはポッドレベルで強制することで管理されます。有効化するには、特定の kubelet feature gate、Topology Manager ポリシー、および静的な CPU および Memory Manager の設定が必要です。新しい kubelet メトリクスは、リソース割り当てとコンテナ割り当てのオブザーバビリティを提供します。この機能は現在アルファ段階であり、既知の制限事項や注意点があり、Kubernetes コミュニティチャネルを通じてユーザーからのフィードバックを奨励しています。