タイムシリーズ階層ストレージジャーニー:Kafka/FlinkストリームからネイティブCassandraコールドリードへ
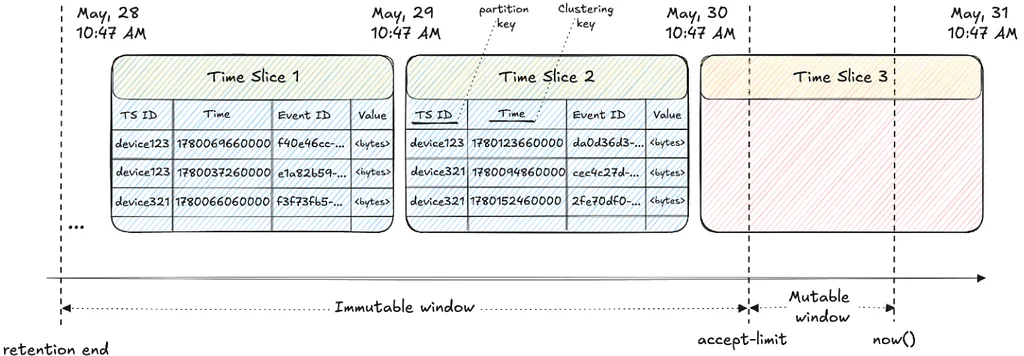
Netflixのペタバイト規模の時系列データを扱うための重要なプラットフォームであるTimeSeries Abstraction platformは、ストレージコストの課題に直面しています。これを解決するため、アクセス頻度の低い古いデータをより安価なオブジェクトストレージに移動させつつ、低レイテンシのアクセスを維持する2つのソリューションが実装されました。最初のソリューションは、Apache KafkaとFlinkを使用してデータをS3にストリーミングし、その後、日次でParquetファイルをマージおよび最適化するコンパクションジョブを実行します。このコンパクションプロセスには、小さな行グループの作成、イベントの時間によるソート、効率的な読み取りのためのブルームフィルターの使用が含まれます。その後、コンパクションされたファイルはコントロールプレーンに登録され、ホットストレージの切り捨てが可能になります。読み取りはホットおよびコールドティアに分散され、コールドティアはコンパクションメタデータを活用してS3の読み取りを最小限に抑えます。成功にもかかわらず、ストリーミングインフラストラクチャは複雑さとコストをもたらしました。これにより、より統合された2番目のソリューションが開発され、Cassandraのバックアップを活用しました。このアプローチは、個別のデータ転送なしにS3バックアップから直接データを読み取ることを目的としています。これは、不変のタイムスライス用の新しいCassandraコンパクション戦略であるReadOnlyCompactionStrategy(ROCS)を導入しました。ROCSはSSTableをトークン範囲に合わせることで、読み取りのファンアウトを削減し、すべてのティアでレイテンシを改善します。CassandraはS3にデータをバックアップし、SSTableパスのリストを含むマニフェストを作成します。2番目のソリューションは、不変のタイムスライスに対してこれらのS3バックアップから直接読み取るようにCassandraをカスタマイズします。これは、プラグ可能なMemtable、特に「backupmemtable」を使用して読み取りをリダイレクトします。このバックアップMemtableは、必要なインデックスファイルとメタデータファイルをS3からノードにダウンロードします。堅牢なレジリエンスメカニズムにより、コンポーネントの信頼性の高いダウンロードと初期化が保証されます。ローカルコンポーネントの準備が整うと、Cassandraはこれらのバックアップから読み取りを提供し、S3の読み取りを並列化し、キャッシュを利用してさらに最適化します。この戦略は、個別のストリーミングインフラストラクチャを排除することにより、運用オーバーヘッドとインフラストラクチャコストを大幅に削減します。