DEV Community 日本語
フォロー
Terraform を使用した RAG の実装:AWS S3、Bedrock KnowledgeBase、OpenSearch Serverless、IAM
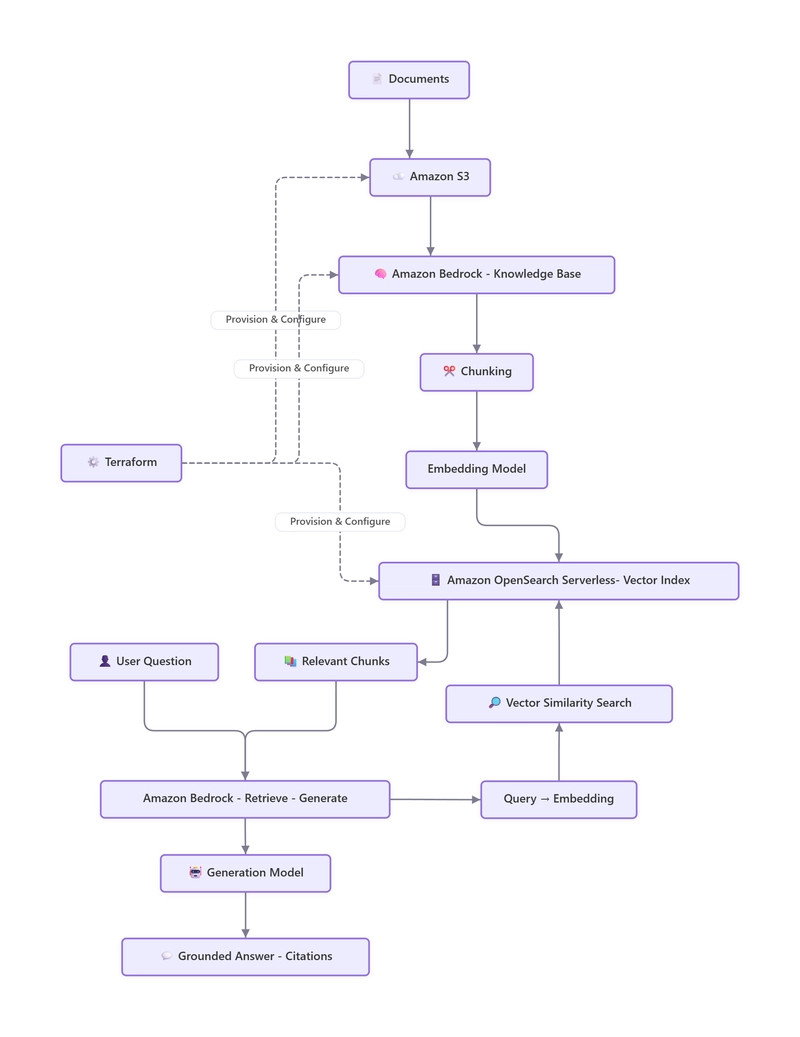
この投稿では、Terraform、S3、Bedrock Knowledge Bases、およびOpenSearch Serverlessを使用してAWS上にRetrieval-Augmented Generation(RAG)システムを実装する方法を詳述します。RAGは、大規模言語モデル(LLM)が外部知識ソースを活用して回答を生成することを可能にし、精度を向上させます。RAGプロセスは、取り込みとクエリの2つの主要なフェーズで構成されます。取り込み中、S3のドキュメントはチャンク化され、Bedrockによって数値埋め込みに変換され、OpenSearch Serverlessに格納されます。クエリフェーズでは、ユーザーの質問が埋め込みに変換され、OpenSearchから関連するドキュメントチャンクが取得され、それらがLLMのコンテキストとして使用され、引用付きの根拠のある回答が生成されます。このシステムは、ドキュメントソースとしてAmazon S3を、取り込みパイプラインの管理にAmazon Bedrock Knowledge Basesを利用します。OpenSearch Serverlessはベクトルデータベースとして構成され、埋め込みのためにknn_vectorフィールドを、効率的な類似性検索のためにFAISSを備えたHNSWを採用しています。OpenSearchインデックスは、元のテキストとメタデータも格納し、ベクトル、レキシカル、およびメタデータフィルタリングされた検索をサポートします。コサイン類似度がベクトル比較に使用されます。Terraformスクリプトは、IAMロール、S3バケット、Bedrock Knowledge Baseの設定、およびOpenSearch Serverlessのアクセスポリシーを含むAWSインフラストラクチャを定義します。Streamlitアプリケーションは、ドキュメントをS3にアップロードし、ナレッジベースの同期をトリガーし、RAGシステムにクエリを送信するためのユーザーインターフェースを提供します。この包括的なセットアップは、カスタムRAGシステムを構築するための実践的な出発点を提供します。