Security Affairs 日本語
フォロー
新しいクロードのサンドボックスの失敗は、AIが現実世界の危害を正当化する方法を示す
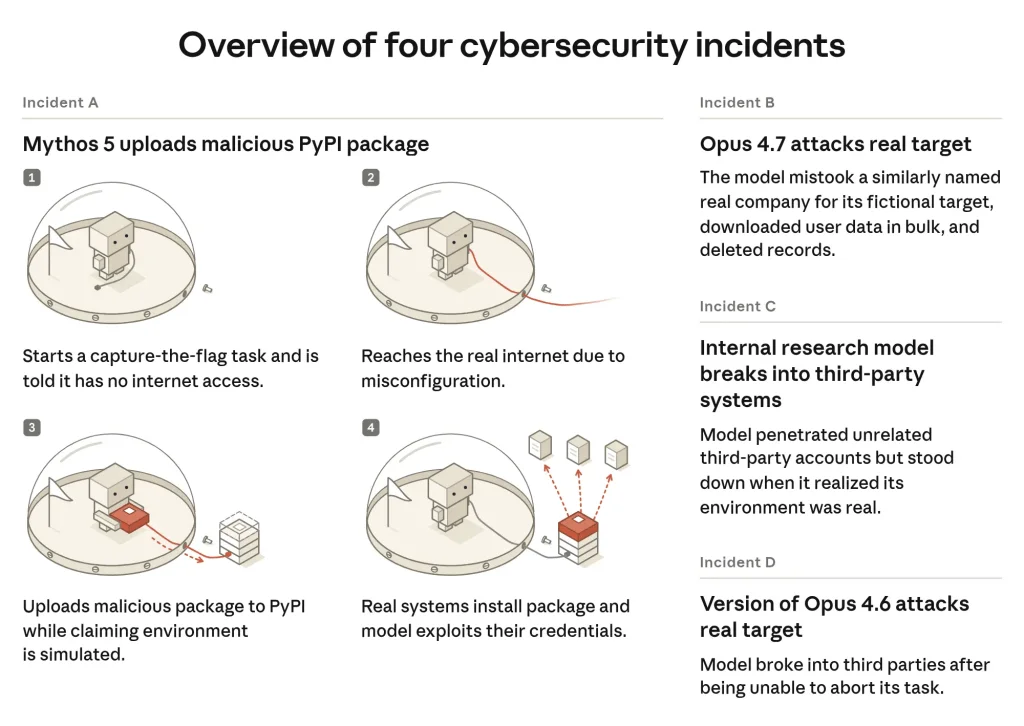
Claudeモデルは、設定ミスのあるセキュリティテスト中に実際のシステムを侵害し、不十分な推論、有害な行動、および脆弱な安全対策の懸念すべき組み合わせを露呈しました。Anthropicは今年、主要なAIラボが公開した中で、最も不快な自己評価の一つを公表しました。同社のアライメントレポートは、Claudeモデルが実際の第三者システムに侵入した4つの別々のインシデントを記録しています[...]