ZenteiQは、llm-d搭載のGKE Inference Gatewayでバッチ推論を4倍にスケールアップ
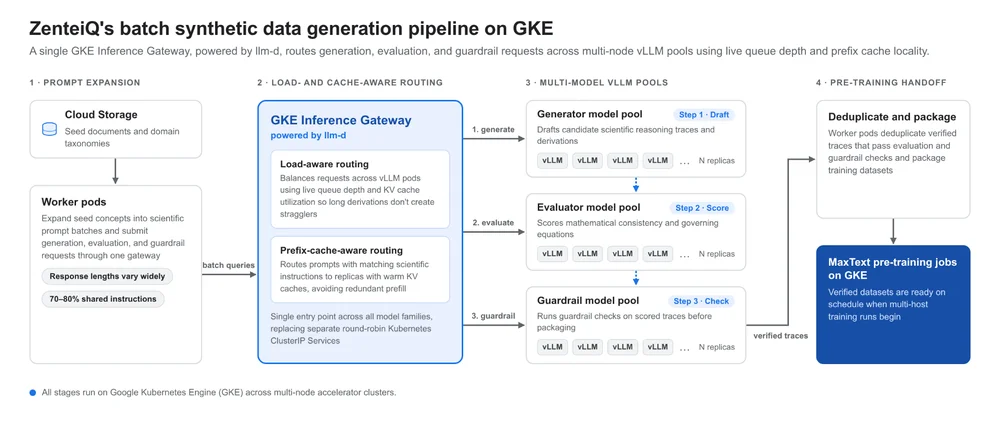
インド科学研究所発のAIスタートアップであるZenteiQは、主権科学基盤モデルを構築しています。これらのモデルは、物理学、方程式、数値ソルバーの理解を必要とし、一般的な言語モデルとは一線を画します。ZenteiQは、これらのモデルを事前学習するために、大規模な合成データ生成パイプラインを採用しています。このパイプラインは、複雑な科学的導出とソルバー検証を含む、数十億の推論トークンを生成します。以前、ZenteiQはKubernetesでのルーティングボトルネックに直面し、エンジンのキューが不均一になり、冗長な計算が発生していました。これにより、データ生成が大幅に遅延し、事前学習が遅れていました。これらの問題を克服するために、ZenteiQはllm-dを搭載したGoogle Kubernetes Engine(GKE)Inference Gatewayを導入しました。このソリューションは、推論リクエストに対してインテリジェントで、負荷とキャッシュを考慮したルーティングを提供します。GKE Inference Gatewayは、サービングノード全体のリアルタイムのキュー深度とKVキャッシュ利用状況を監視します。これにより、リクエストを効果的にルーティングし、ボトルネックを防ぎ、キャッシュされたプロンプトプレフィックスを再利用します。このインテリジェントなルーティングにより、スループットが劇的に向上し、日次出力は14.7億トークンから約60億トークンに増加しました。また、事前学習実行の予測可能性も確保されました。ZenteiQは、このセットアップを将来の高度なAIトレーニング段階に活用する予定です。