AI 추론 모델 서빙을 위한 네트워킹 - GKE 전용 및 기타 모든 백엔드
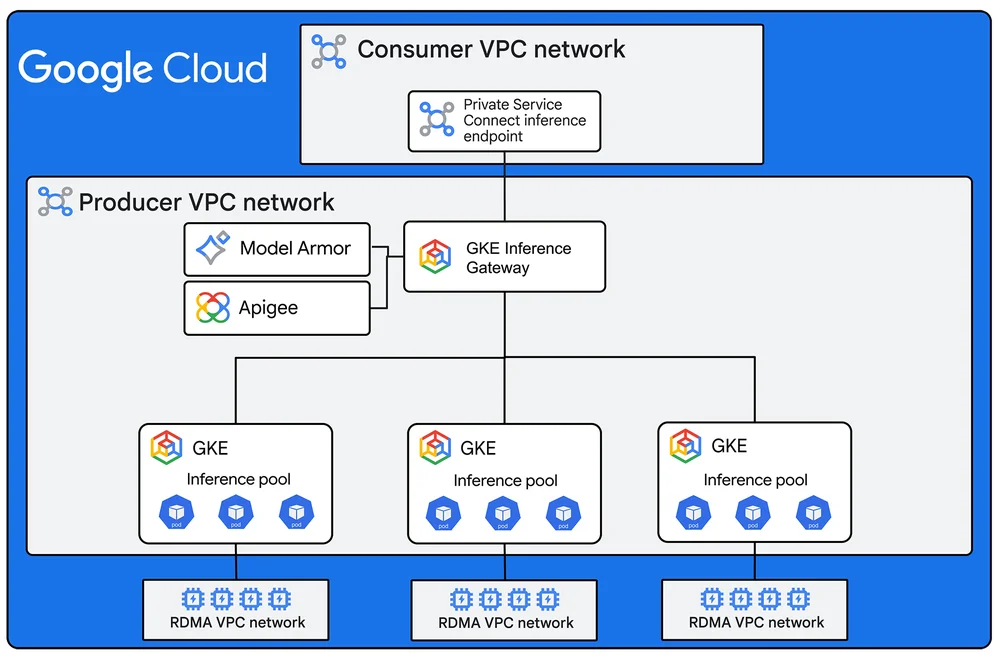
기업은 종종 여러 AI 추론 모델을 실행하며, 이는 호출 간소화 및 중앙 집중식 거버넌스를 위한 아키텍처를 필요로 합니다. AI 추론 모델 서빙 네트워킹을 위한 두 가지 참조 아키텍처가 제시됩니다. 하나는 Google Kubernetes Engine(GKE)용이고 다른 하나는 기타 모든 백엔드 유형용입니다. 두 아키텍처 모두 보안 및 효율성을 향상시키기 위해 설계된 공통 서비스를 공유합니다. Cloud Load Balancer 또는 Inference Gateway인 진입점은 추론 호출을 위한 안정적이고 안전한 프런트엔드를 제공합니다. 이 진입점은 TLS 종료를 처리하고 API 관리에 통합되며 서비스 확장을 통해 기능을 확장할 수 있습니다.두 설계 모두에 공통적인 서비스에는 소비자 VPC 네트워크 내에 진입점을 고정하기 위한 Private Service Connect 추론 엔드포인트가 포함됩니다. Apigee API Management는 클라이언트 ID 확인, 속도 제한 및 할당량 적용을 위한 선택적 서비스입니다. Model Armor는 프롬프트와 출력을 검사하는 인라인 AI 안전 체크포인트 역할을 합니다. GKE별 설계는 특수 인그레스 엔진 역할을 하는 GKE Inference Gateway를 활용합니다. 이 게이트웨이는 HTTPRoute 규칙에 따라 적절한 모델 서빙 대상으로 쿼리를 라우팅합니다.모델 복제본의 논리적 그룹인 추론 풀이 사용되며, 게이트웨이는 모델 식별자를 기반으로 올바른 풀을 선택합니다. 모델 복제본 세트는 다양한 노드 풀에 배포된 개별 모델 복제본의 균일한 그룹을 나타냅니다. 여러 백엔드 유형을 서빙하는 아키텍처의 경우, 지역 내부 Application Load Balancer가 중앙 라우팅 프록시 역할을 합니다. Inference Payload Processor는 Service Extension으로 구현되며, 대상 모델 식별자를 추출하기 위해 들어오는 요청 페이로드를 검사합니다. Network Endpoint Groups(NEGs)는 이 식별자를 기반으로 이기종 백엔드로의 유연한 라우팅을 제공합니다.