Google Cloud Blog 한국어 노트

Google Cloud Blog 한국어

cloud.google.com/blog은 Google Cloud의 공식 블로그입니다. Google Cloud의 제품 및 서비스에 대한 뉴스, 업데이트 및 통찰, 클라우드 컴퓨팅 산업의 트렌드 및 혁신을 제공합니다. 이 블로그는 Google Cloud 전문가, 엔지니어 및 사상가들이 작성한 기사로 구성되어 있습니다. 인공 지능, 머신 러닝, 데이터 분석, 보안 등 다양한 주제를 다루고 있습니다. 기사들은 기술 튜토리얼, 케이스 스터디 및 베스트 프랙티스도 포함하여 Google Cloud를 사용하거나 관심이 있는 개발자, IT 전문가 및 비즈니스 리더에게 귀중한 자원이 됩니다. 블로그는 주제, 제품 및 산업별로 분류되어 있습니다. 방문객은 최신 기사를 브라우징하거나 특정 주제를 검색하거나 블로그의 RSS 피드를 구독하여 최신 뉴스 및 업데이트를 최신 상태로 유지할 수 있습니다. 블로그의 주요 기능 중 일부는 다음과 같습니다. - Google Cloud 제품 및 서비스에 대한 심층 기사, 예를 들어 Google Cloud Platform, Google Cloud Storage 및 Google Cloud AI Platform - Google Cloud 서비스 사용에 대한 기술 튜토리얼 및 가이드 - Google Cloud 고객의 케이스 스터디 및 성공 사례 - 산업 트렌드 및 혁신에 대한 통찰 및 분석 - Google Cloud의 파트너쉽 및 협력에 대한 뉴스 및 업데이트 - Google Cloud 전문가 및 사상가와의 인터뷰 전반적으로 Google Cloud 블로그는 클라우드 컴퓨팅, 인공 지능 및 관련 기술에 관심이 있는 모든 사람에게 귀중한 자원이 됩니다.

노트 스레드

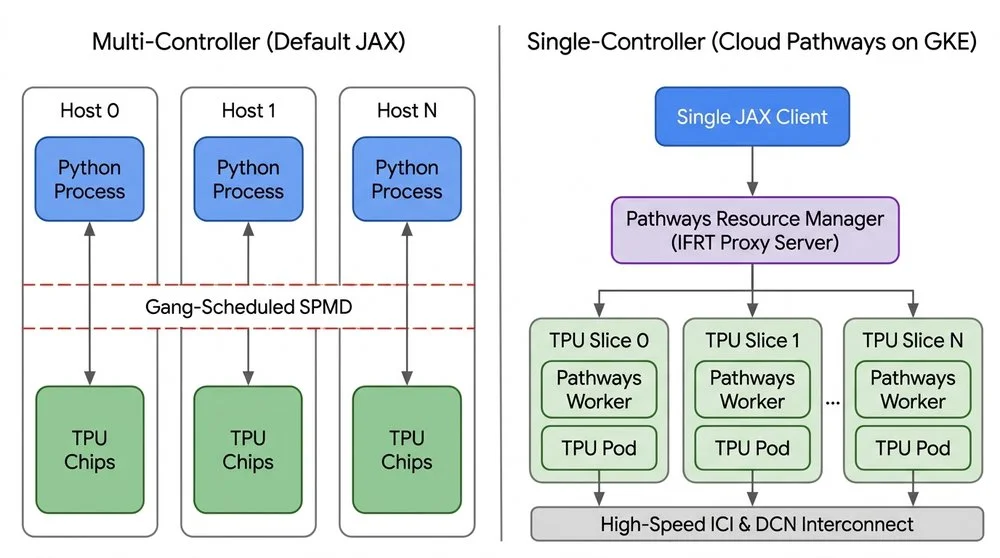
Cloud Pathways가 Google Cloud AI Hypercomputer의 핵심 구성 요소로서 GKE에서 이제 일반적으로 사용할 수 있습니다. 이 기술은 Gemini와 같은 최첨단 모델을 훈련하기 위해 Google DeepMind에서 처음 개발되었습니다. Pathways는 대규모의 다양한 가속기 플릿을 위해 설계된 분산 머신러닝 런타임입니다. 지난 90일 동안 GKE에서 Pathways를 사용하여 1억 3천만 시간 이상의 Cloud TPU 칩 시간을 처리했습니다. 이제 모든 Google Cloud 고객은 단일 컨트롤러 런타임, 함께 배치된 Python 사이드카, 탄력적인 내결함성을 활용할 수 있습니다. Cluster Director와의 미리 보기 통합은 Cloud Pathways를 Slurm 클러스터로 확장하여 통합 JAX 실행 및 대화형 노트북을 제공합니다. Cloud Pathways는 수천 개의 가속기에 걸쳐 AI 워크로드를 확장하기 위한 기존의 다중 컨트롤러 설정의 복잡성을 해결합니다. 오픈 소스 Interim Framework Runtime을 기반으로 구축된 통합 단일 컨트롤러 아키텍처로 다중 컨트롤러 관리를 대체합니다. 이를 통해 단일 JAX 클라이언트 프로세스가 마치 로컬로 연결된 것처럼 여러 대규모 TPU 슬라이스를 오케스트레이션할 수 있습니다. 주요 기능에는 단일 컨트롤러 오케스트레이션, 컴퓨팅 집약적인 로직을 위한 함께 배치된 Python 사이드카, 복원력 있고 탄력적인 훈련이 포함됩니다. 또한 유연한 다중 사용자 액세스를 위한 대화형 모드와 공유 Pathways 서비스를 제공합니다. 주요 AI 연구소 및 기업, 예를 들어 주요 소비자 기술 회사 및 ZenteiQ는 이미 미션 크리티컬 프로덕션 워크로드에 Cloud Pathways를 사용하고 있습니다. Cloud Pathways는 현재 GKE에서 Cloud TPU v5e, v5p, Trillium 및 Ironwood를 지원하는 모든 Google Cloud 리전에서 사용할 수 있습니다.
CdXz5zHNQW_Me7SwPag7x.jpeg
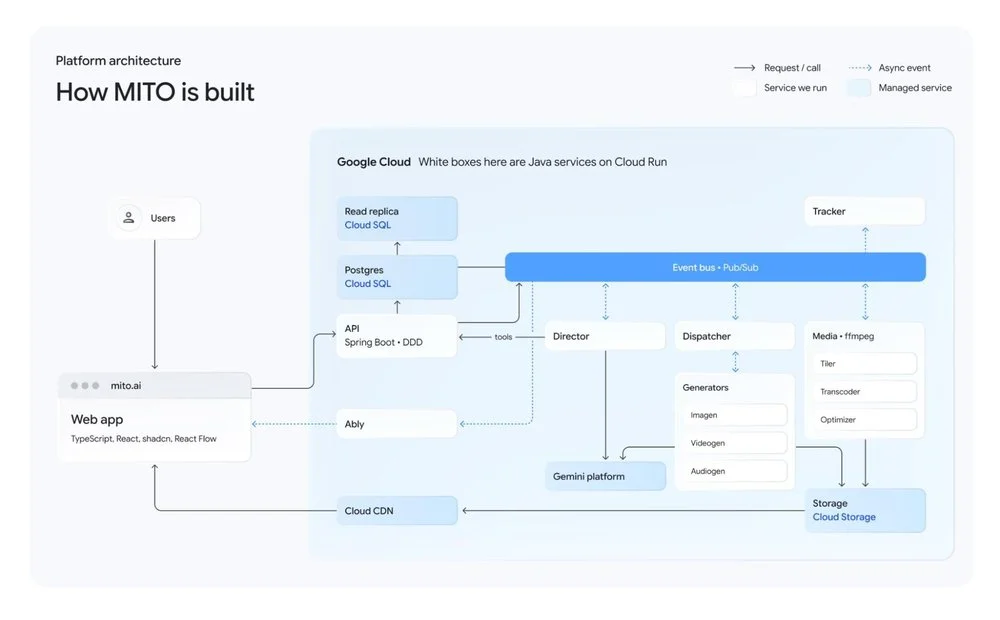
미토는 AI 기반 비디오 제작을 민주화하여 첨단 기술을 모두가 접근할 수 있도록 하는 것을 목표로 합니다. 그들의 여정은 생성형 AI를 활용한 장기 내러티브 콘텐츠 제작에 있어 상당한 인프라와 워크플로우 문제를 드러냈습니다. 이러한 도전에는 대규모 로컬 미디어 라이브러리 관리, 실시간 협업 부재, 긴 렌더링 지연 등이 포함되었습니다. 생성형 모델 간 불일치와 공개 API에 대한 용량 제약이 그들의 노력을 더욱 복잡하게 만들었습니다. 이러한 문제를 극복하기 위해 미토는 구글 클라우드에서 서버리스 비동기 아키텍처를 설계했습니다. API와 백그라운드 작업자에는 클라우드 런을 활용해 확장 가능한 처리 능력을 유지했습니다. 구글 클라우드 퍼블리브/서브는 작업 실행 분리를 위한 중앙 이벤트 버스 역할을 했습니다. 미디어 자산은 구글 클라우드 저장소에 저장되어 클라우드 CDN을 통해 지연을 최소화합니다. 클라우드 SQL과 PostgreSQL을 활용한 독립된 데이터베이스 아키텍처는 생산 문제에 영향을 주지 않는 분석을 지원합니다. Vertex AI를 통한 기본 모델과 맞춤형 시스템 프롬프트를 활용합니다. 프론트엔드는 프롬프트 변수를 최적화하고 비용 효율성을 위해 정지 프레임 생성을 우선시하는 '6의 법칙'을 적용합니다. 이 솔루션은 95%가 AI 생성으로 묘사되는 Movistar Plus+의 획기적인 전국 방송 캠페인을 성공적으로 가능하게 했습니다. 이 캠페인은 스페인 주요 TV 채널 전역에서 방영되었으며, AI 디렉터의 대화 기능과 실시간 협업을 선보였습니다. Mito의 아키텍처는 미래 지향적이며, 점점 더 빠른 렌더링 시간과 고급 AI 역량에 맞춰 준비되어 있습니다. 그들은 Gemini 기반 자동 평가 하네스를 구축해 창의적 출력을 검증합니다. AI 디렉터는 작업을 여러 전문 모델에 동적으로 라우팅하여 지능형 조정을 지원합니다. Mito는 또한 진정성 있는 스토리텔링을 강화하기 위해 초현실적인 시각 요소를 통합하기 위해 '불완전한 미학'을 수용했습니다.
CdXz5zHNQW_tOhDlbvIcv.jpeg
BigQuery DataFrames(BigFrames)는 새로운 .bigquery accessor를 도입하여 사용자가 친숙한 판다 데이터프레임 내에서 고급 머신러닝을 직접 실행할 수 있게 합니다. 이 통합은 클라우드 인프라에서 BigQuery의 엔터프라이즈급 AI 기능을 원활하게 실행할 수 있게 합니다. 선형 회귀와 같은 작업에서는 사용자가 로컬 학습을 우회하여 BigQuery 데이터에 ai.predict()를 직접 활용할 수 있습니다. .bigquery accessor는 pandas 연산을 Google Standard SQL로 변환하여 모델을 BigQuery에서 네이티브로 실행합니다. 환경 설정은 구글 클라우드 특정 역할과 pandas 및 bigframe 설치가 필요합니다. AI 기능은 pandas 시리즈와 DataFrame 모두에서 제공됩니다. Series의 경우, ai.embed()는 텍스트 임베딩을 계산하고, ai.similarity()는 코사인 유사도 점수를 계산합니다. DataFrame 함수는 시계열 예측을 위한 ai.forecast()와 자연어 행 필터링을 위한 ai.if_()와 같은 다중 열 연산을 처리합니다. 이 기능들은 클라우드 인프라와 모델 실행의 복잡성을 추상화합니다. 목표는 데이터 과학자들이 Python 생태계를 벗어나지 않고도 정교한 AI 작업을 수행할 수 있도록 돕는 것입니다. 지원되는 기능으로는 임베딩 생성, 분류, 예측, 예측 모델링 등이 포함됩니다. pandas 내의 BigQuery AI 기능은 머신러닝 워크플로우 확장을 단순화합니다.
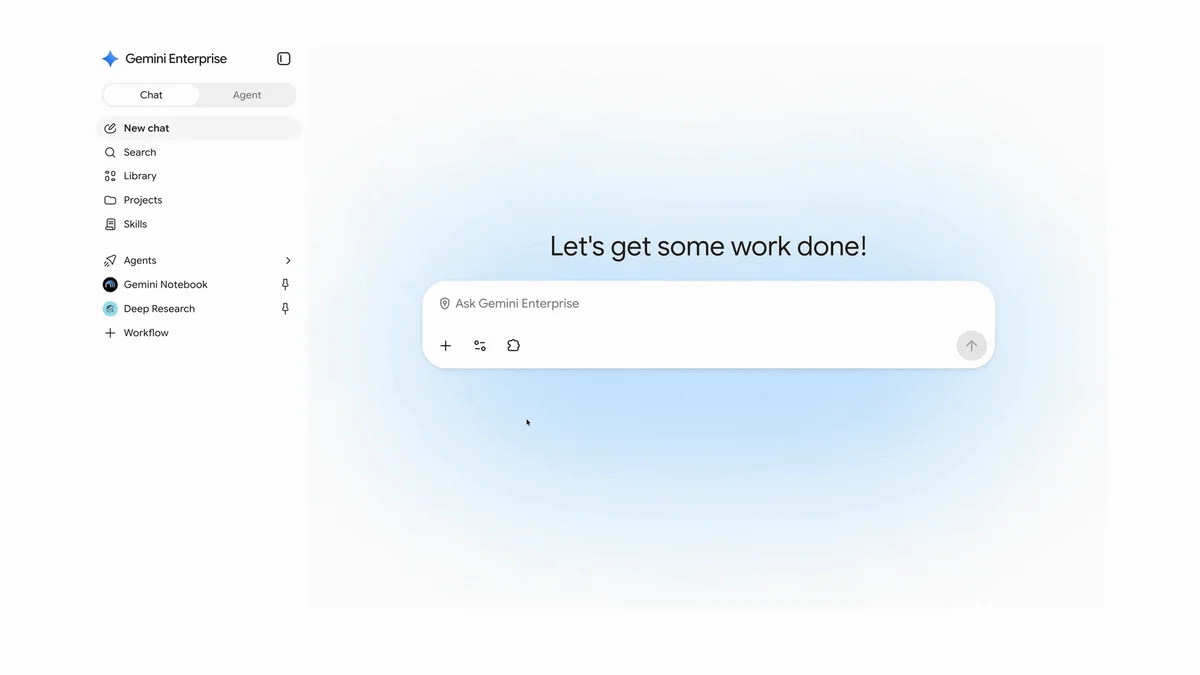
Gemini for Business는 이제 데이터 클라우드 커넥터를 미리보기 버전으로 제공하여 사용자가 자연어를 사용해 실시간 기업 데이터를 조회할 수 있도록 지원합니다. 이 커넥터들은 거버넌스된 데이터에 직접 접근함으로써 데이터 요청 적체 문제를 해결합니다. Knowledge Catalog와 통합하여 관련 데이터를 찾고, 자연어 쿼리를 해석하며, 사용자 신원으로 권한 범위가 적용된 쿼리를 실행합니다. 사용자는 BigQuery, Spanner, AlloyDB, Cloud SQL과 같은 운영 데이터베이스, 그리고 Looker에서 데이터를 조회할 수 있습니다. 검색 결과는 Google Docs, Gmail, Google Slides와 같은 도구로 직접 이전할 수 있습니다. Gemini는 의미론적 발견과 맥락 매핑을 활용하여 기술 메타데이터와 비즈니스 용어집을 활용해 일상적인 용어를 데이터베이스 구조로 변환합니다. 권한 인식 실행은 행 및 열 수준의 접근 제어를 존중합니다. Data Cloud 커넥터는 BigQuery와 AWS S3 간의 데이터를 질의하여 환경을 하나의 대화형 인터페이스로 통합할 수 있습니다. 이 커넥터들은 데이터를 복사하지 않고 현장에서 접근할 수 있는 연합 쿼리 모드를 제공합니다. 맞춤형 솔루션과 비교할 때, 데이터 클라우드 커넥터는 더 높은 응답 품질과 관리된 인증을 통한 가이드 설정 기능을 내장합니다. 이 기능은 데이터 접근을 민주화하고 비즈니스 사용자와 분석가의 인사이트를 가속화하는 것을 목표로 합니다.
CdXz5zHNQW_RxiqwDQ3xG.gif
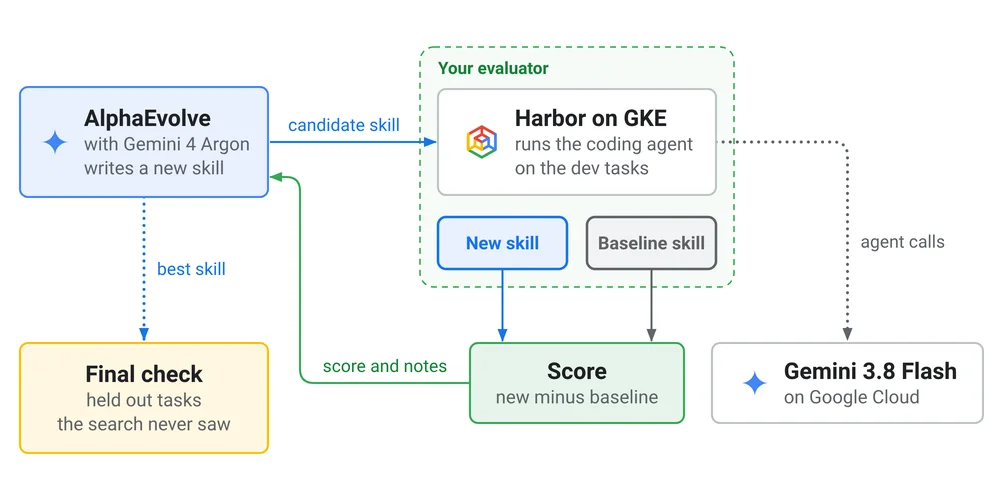
코딩 에이전트는 소프트웨어 엔지니어링 작업에 점점 더 많이 사용되지만 효과적인 지침이 필요합니다. 에이전트 스킬을 수동으로 작성하면 효과를 평가하기 어렵기 때문에 개선하기 어렵습니다. Terminal-Bench 2.0에서 OpenCode 및 Gemini 3.8 Flash를 사용한 초기 테스트는 기본 스킬로 불확실한 결과를 보였습니다. 성능을 개선하기 위해 AlphaEvolve를 사용하여 반복적으로 새 버전을 제안하고, 평가자로 점수를 매기고, 최상의 스킬을 유지함으로써 스킬을 최적화했습니다. Harbor는 격리된 컨테이너에서 실제 작업에 에이전트를 실행하는 평가자로 사용되었습니다. 이 프로세스는 AlphaEvolve가 다시 작성할 수 있는 프로그램처럼 에이전트 스킬을 처리합니다. Harbor의 평가자는 신뢰할 수 있는 점수를 보장하기 위해 동일한 작업에서 기본 스킬과 후보 스킬을 동시에 비교합니다. 최종 최적화된 스킬을 보지 못한 데이터에 대해 테스트하기 위해 작업의 일부가 예약됩니다. AlphaEvolve는 가장 흔한 실패인 시간 초과를 해결하는 데 중점을 두었습니다. 시스템은 몇 번의 반복으로 5%의 개선을 달성했으며 특정 개발 작업에서 33점의 상당한 증가를 보였습니다. 발생한 과제에는 느린 모델 응답에 대한 계획 및 긴 검색 중 로그 저장 등이 포함되었습니다. 향후 작업에는 비즈니스 규칙을 통합하기 위해 엔터프라이즈 에이전트 하네스에 AlphaEvolve를 테스트하는 것이 포함됩니다.
CdXz5zHNQW_kGRYcLbu5V.png
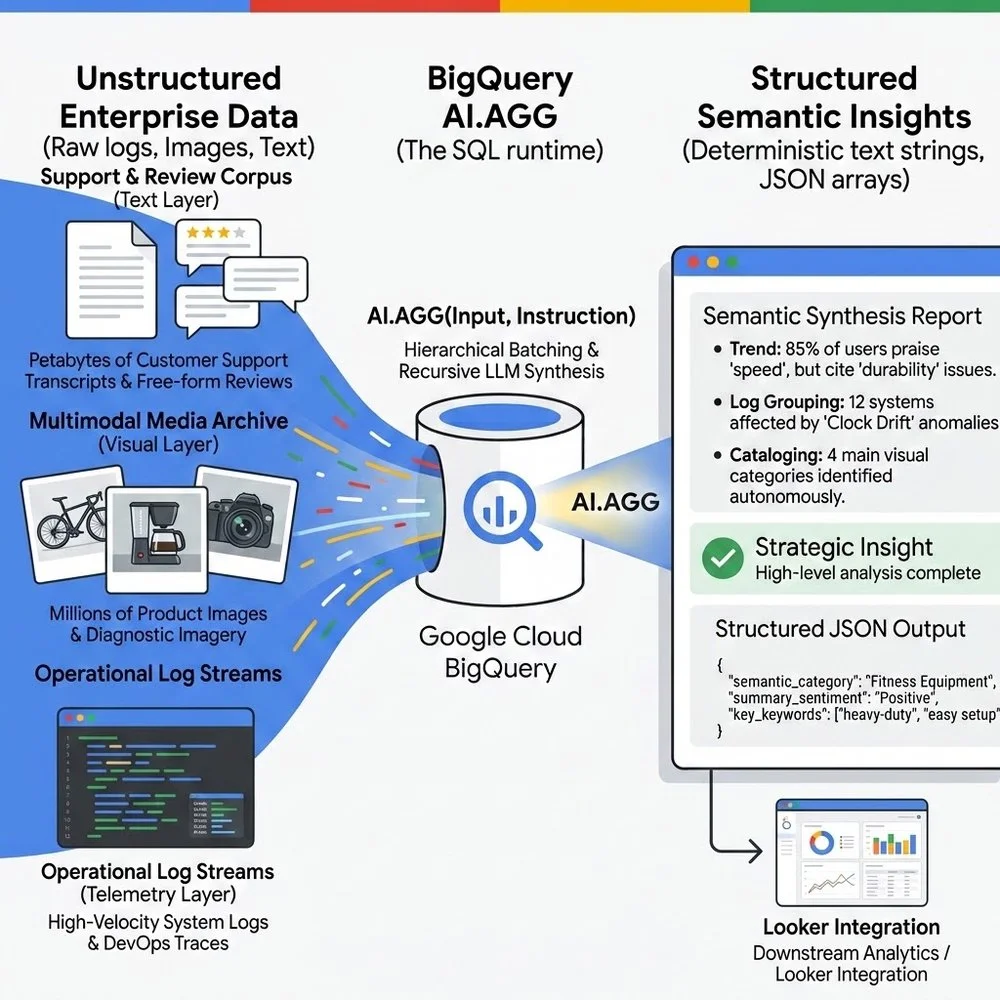
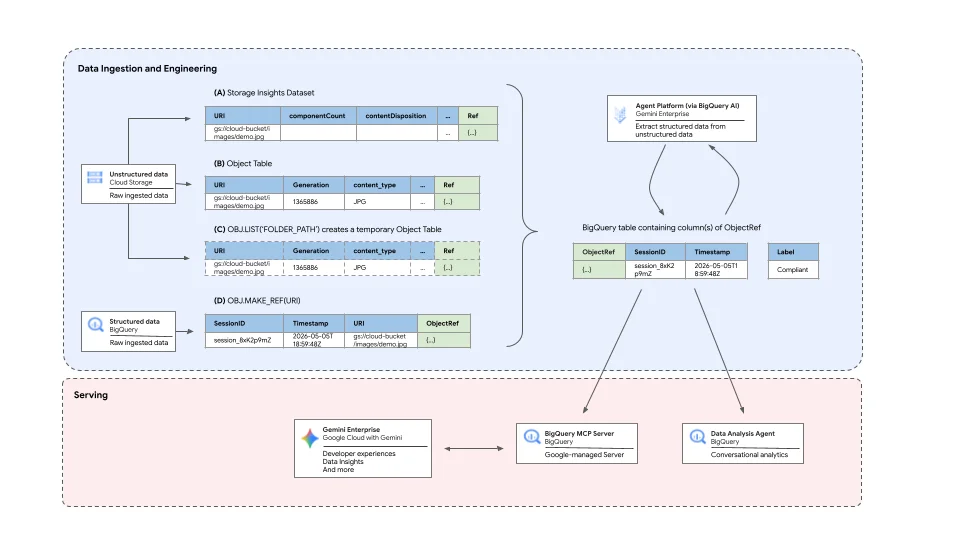
현재 프리뷰 상태인 BigQuery의 새로운 AI.AGG 기능은 GoogleSQL 내에서 직접 다단계 의미론적 집계를 가능하게 하여 비정형 데이터 분석에 혁신을 가져옵니다. 이는 대규모 언어 모델(LLM)의 컨텍스트 창 제한으로 인해 기존 관계형 SQL 엔진이 방대한 텍스트 및 멀티모달 데이터셋에서 인사이트를 종합하는 데 어려움을 겪었던 중요한 격차를 해소합니다. AI.AGG는 의미론적 집계를 분산형 맵리듀스 문제로 개념화하여, 데이터 팀이 단일 SQL 쿼리로 수백만 행에 걸쳐 자연어 지침을 실행할 수 있도록 합니다. 기반이 되는 다단계 배치 아키텍처는 행 유효성 검사, 컨텍스트 안전 배치, Vertex AI를 통한 병렬 추론, 그리고 단일 집계 문자열이 생성될 때까지 전체 가중치 LLM을 사용한 재귀적 종합을 자동으로 처리합니다. 데이터 이동 없이 이미지 분석을 위해 BigQuery Object Tables를 활용하여 텍스트 및 멀티모달 입력을 모두 네이티브로 지원합니다. AI.AGG는 대량 시스템 로그의 진단 분석 및 자율 데이터 레이블링 파이프라인을 위한 "에이전트 데이터 클라우드" 구축과 같은 혁신적인 엔터프라이즈 사용 사례를 위해 설계되었습니다. AI.AGG를 위한 프롬프트 엔지니어링은 프로그래밍 가능한 SQL 출력을 보장하기 위해 명시적인 출력 계약, 컨텍스트 구분 기호, 실패 상태 설계 및 소량 예시 앵커링을 요구합니다. 비용 관리는 WHERE 및 LIMIT 절을 사용한 사전 필터링과 Gemini Context Caching 활용, 그리고 추정을 위한 AI.COUNT_TOKENS 사용을 포함합니다. 이 기능은 BigQuery의 거버넌스 프레임워크 내에서 작동하며, VPC Service Controls를 지원하고 일시적인 오류 발생 시 우아하게 성능을 저하시킵니다. 프리뷰 가드레일에는 그룹당 10,000 토큰 출력 제한, 10MiB 행 제한, 그리고 최대 2천만 행 및 1,000개의 고유 SQL 그룹 처리를 위한 권장 사항이 포함됩니다. AI.AGG는 엔터프라이즈 데이터 웨어하우스를 능동적이고 의미론적인 런타임으로 변환하여 페타바이트 규모의 의미론적 분석에 대한 접근을 민주화합니다.
CdXz5zHNQW_uaHoQyzKVt.jpeg
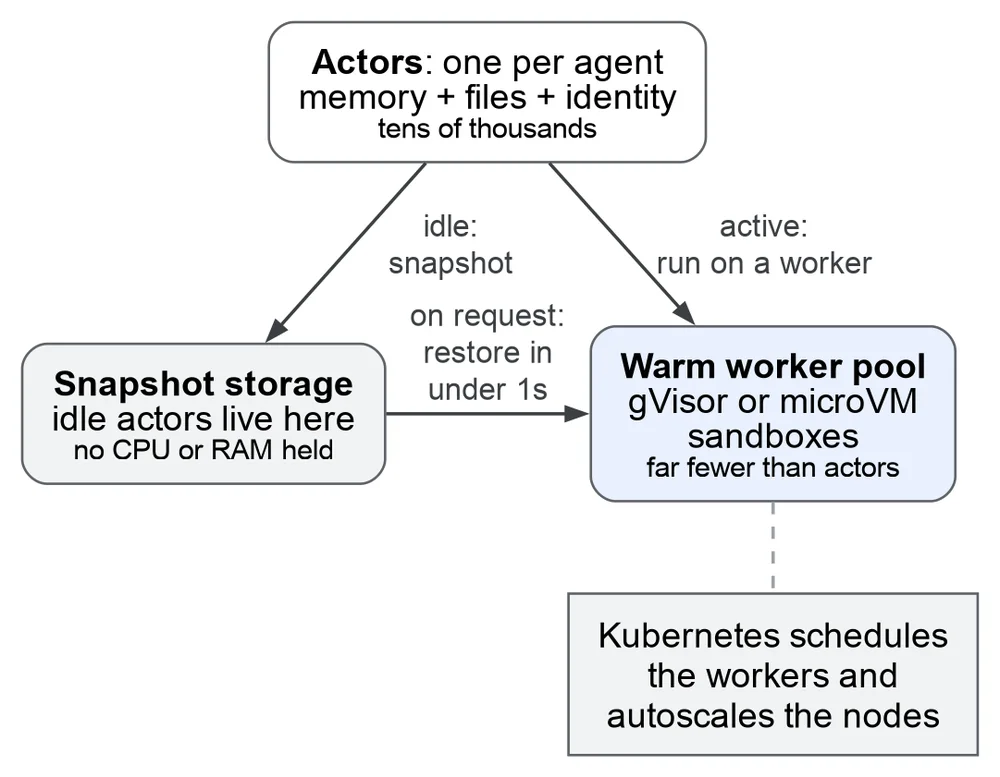
AI는 인간 규모 시스템에서 에이전트 규모 운영으로 진화하며, 단순한 기록이 아닌 능동적인 시스템으로 변모하고 있습니다. 이러한 변화는 복잡한 에이전트 워크플로우를 처리하기 위한 새로운 기반을 요구합니다. 이를 해결하기 위해 세 가지 오픈 소스 프로젝트인 Agent Substrate, gVisor, OpenRL이 Cloud Native Computing Foundation(CNCF)에 기증되었습니다. 현재 버전 1.0이며 GKE에서 사용할 수 있는 Agent Substrate는 격리된 에이전트 환경을 효율적으로 확장합니다. 상태 저장 에이전트 세션을 활성 컴퓨팅과 분리하고, 유휴 에이전트를 스토리지에 스냅샷하여 신속하게 복원합니다. 이는 유휴 컴퓨팅 오버헤드를 줄여 컨테이너 밀도를 크게 향상시킵니다. gVisor는 경량 사용자 공간 커널을 실행하여 신뢰할 수 없는 에이전트 코드에 필수적인 격리를 제공합니다. 이는 호스트 Linux 커널과의 직접적인 상호 작용을 방지하여 보안을 강화합니다. OpenRL은 강화 학습 에이전트의 사후 훈련 및 서빙 배포를 단순화합니다. 일반 Python을 사용하여 Kubernetes에서 직접 자체 호스팅 RL 사후 훈련 루프를 가능하게 합니다. 이러한 프로젝트들은 집합적으로 다양한 클라우드 및 하드웨어 가속기 전반에 걸쳐 모든 Kubernetes 클러스터와 호환되는 오픈 스택을 제공합니다. Agent Substrate는 표준 컨테이너 밀도의 10배로 수백만 개의 샌드박스를 실행할 수 있도록 합니다. gVisor는 신뢰할 수 없는 코드가 호스트 시스템 커널을 손상시키지 않도록 보장합니다. OpenRL은 분산 훈련을 위해 Kubernetes를 활용하여 효율적인 강화 학습 워크플로우를 조정합니다. CNCF에 기증하는 것은 협업 개발을 촉진하고 이러한 중요한 AI 인프라 구성 요소의 채택을 가속화하는 것을 목표로 합니다.
CdXz5zHNQW_rMp6SvhdPH.png
데이터베이스는 현재 AI 기반의 빠른 소프트웨어 개발 속도를 따라가지 못해 프로비저닝, 테스트, 프로덕션 전환에 병목 현상을 일으키고 있습니다. AlloyDB for PostgreSQL의 새로운 서비스인 AlloyDB Express는 이러한 문제를 해결하는 것을 목표로 합니다. 개발자와 AI 코딩 에이전트를 위해 설계되었으며, 2초 이내에 데이터베이스를 빠르게 생성할 수 있습니다. 이 서비스는 유휴 상태일 때 자동으로 일시 중지되어 15분간의 비활성 후 scale-to-zero 기능을 구현하여 비용을 절감합니다. 이 새로운 서비스는 빠른 AI 기반 개발과 강력한 엔터프라이즈 인프라 간의 격차를 해소합니다.AlloyDB Express는 내장된 엔터프라이즈 보안 및 AI 기능을 갖춘 에이전트 준비 데이터베이스 환경을 제공합니다. 데이터와 구성을 유지하면서 프로덕션 규모로 원클릭 업그레이드를 할 수 있습니다. 마스킹된 IP 주소를 위한 공개 DNS 엔드포인트 및 안전한 내부 통합을 위한 프라이빗 VPC 네트워킹과 같은 기능을 통해 보안이 최우선입니다. Google Cloud IAM 및 네이티브 PostgreSQL 역할을 포함한 세분화된 액세스 제어는 사용자 및 에이전트에 대한 최소 권한을 시행합니다.중요하게도 AlloyDB Express는 AI 도구를 데이터베이스에 직접 통합하여 외부 벡터 스토어의 필요성을 없앱니다. 개발자는 pgvector HNSW 및 Google의 ScaNN 인덱스를 통해 빠른 벡터 검색을 사용하여 의미론적 검색 및 추천 엔진을 활용할 수 있습니다. 이 서비스는 또한 텍스트 및 이미지 임베딩 생성, 필터링 및 요약과 같은 작업을 위해 SQL 쿼리 내에서 Gemini 모델에 직접 액세스할 수 있습니다. 자연어-SQL 생성은 개발자 및 AI 에이전트를 위한 쿼리 생성을 더욱 단순화합니다.AlloyDB Express는 비활성 시 제로로 확장되는 간단하고 직관적인 가격 책정 기능을 제공하며, 데이터는 안전하게 유지됩니다. 활성 컴퓨팅은 Compute Unit 시간당 $0.115로 청구되며, 일시 중지된 컴퓨팅에 대해서는 요금이 부과되지 않습니다. 사용된 스토리지는 GB당 월 $0.30이며, 무료 티어는 매월 50개의 무료 CU를 제공합니다. 이 비용 효율적인 솔루션은 애플리케이션 구축을 가속화하고 프로덕션으로 원활하게 확장됩니다. AlloyDB Express는 현재 미리 보기로 제공되며, 사용자는 향상된 개발 효율성을 위해 해당 기능을 탐색할 수 있습니다.
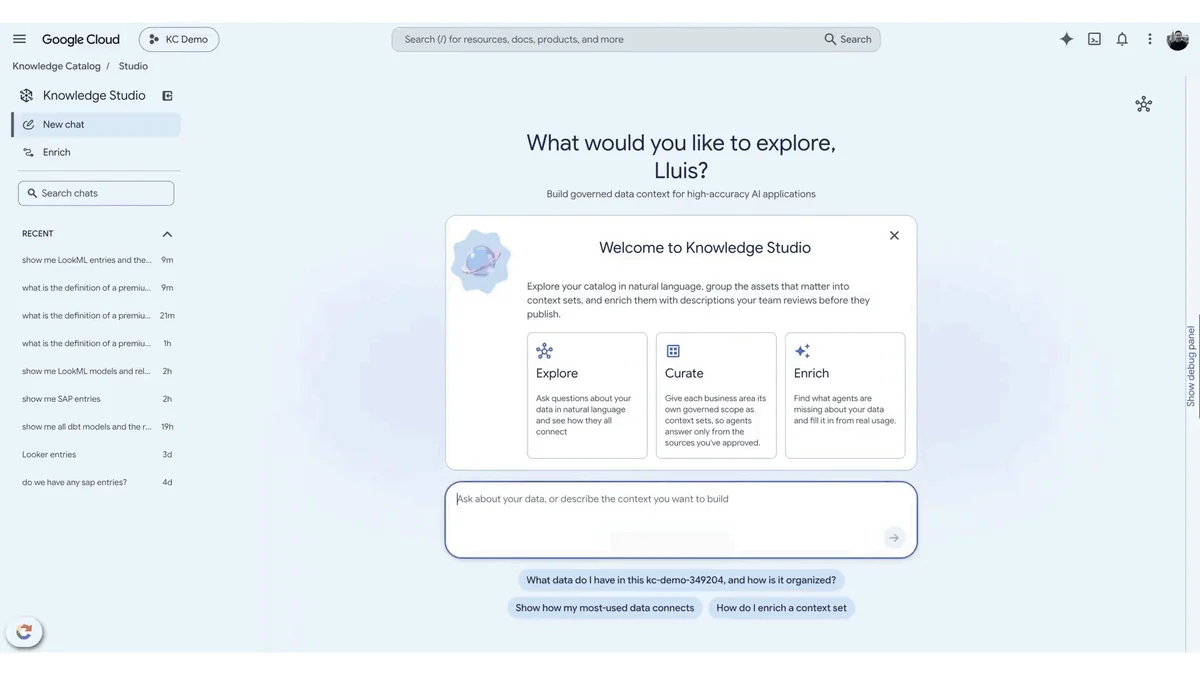
조직들은 수익, 효율성 및 위험 관리를 향상시키기 위해 에이전트 기반 자동화를 점점 더 활용하고 있습니다. Google의 Agentic Data Cloud는 엔터프라이즈 데이터를 통합하고, 정확성을 보장하며, 저렴한 비용으로 선제적으로 운영하도록 설계된 System of Action입니다. 국경 없는 Lakehouse는 개방형 Apache Iceberg 형식을 사용하여 멀티 클라우드, 온프레미스 및 SaaS 플랫폼 전반의 분산 데이터를 활성화합니다. 새로운 향상 기능은 Gemini가 자연어를 사용하여 Lakehouse를 쿼리할 수 있도록 하고, 크로스 클라우드 상호 연결은 안전하고 제로 이그레스 수수료 데이터 액세스를 제공합니다. AlloyDB 통합은 에이전트가 Iceberg 테이블을 직접 쿼리하여 과거 및 실시간 데이터를 효율적으로 조인할 수 있도록 합니다. Spanner Omni는 하이브리드 에이전트 애플리케이션에 Google 수준의 일관성과 확장을 제공합니다. Google Cloud의 범용 컨텍스트 엔진인 Knowledge Catalog는 에이전트를 엔터프라이즈 컨텍스트에 기반하여 정확성을 향상시키고, 지연 시간을 줄이며, 토큰 비용을 낮춥니다. 자체 학습 강화 및 재사용 가능한 OKF 컨텍스트 세트는 Google Workspace 및 SharePoint와 같은 비정형 소스에서 컨텍스트 큐레이션을 자동화합니다. Knowledge Catalog의 새로운 스튜디오 환경은 컨텍스트를 탐색하고 관리하기 위한 대화형 UI를 제공합니다. Knowledge Catalog는 이제 Gemini에서 기본으로 제공되어, 관리되는 비즈니스 컨텍스트에 데이터 질문을 기반으로 하고 다양한 플랫폼의 신뢰할 수 있는 의미론적 모델을 지원합니다. Google은 실무자 경험을 혁신하여 데이터 및 ML 엔지니어가 Gemini의 머신러닝 기술을 사용하여 의도 기반 결과에 대한 에이전트를 오케스트레이션할 수 있도록 합니다. 비즈니스 사용자는 단순히 질문하여 실시간 운영 보고서를 생성할 수 있습니다. Data Agent Kit는 Google Data Cloud 도구를 개발자의 선호하는 IDE 및 CLI에 통합합니다. Google은 또한 에이전트 규모에 대한 데이터 인프라를 엔지니어링하고 있으며, 신속한 프로토타이핑을 위해 AlloyDB Express를, AlloyDB for production의 에이전트를 위해 PostgreSQL을 도입하고 있습니다. Managed Service for Apache Spark는 가격 대비 성능을 확장하며, BigQuery는 더 빠른 쿼리, 페타바이트 규모의 그래프 분석을 위한 BigQuery Graph, 그리고 TimesFM 3.0 및 TabFM과 같은 새로운 Google Research 모델로 향상되었습니다.
CdXz5zHNQW_OVtRDwO1CM.gif
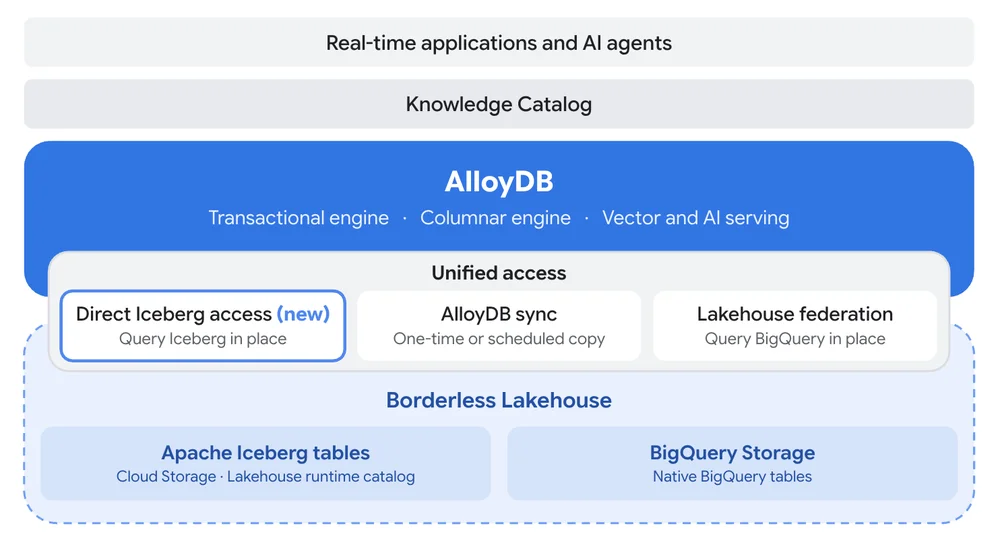
효과적인 의사결정을 위해 기업은 실시간 운영 데이터와 과거 분석 데이터를 모두 필요로 합니다. 전통적으로 분리되어 있던 이러한 데이터 시스템이 이제 통합되고 있으며, 이는 PostgreSQL용 AlloyDB의 새로운 기능으로 대표됩니다. Google Cloud는 직접 Iceberg 액세스를 도입하여 개발자가 클라우드 스토리지의 Apache Iceberg 테이블을 AlloyDB에서 직접 쿼리하고 단일 SQL 쿼리에서 실시간 데이터와 조인할 수 있도록 합니다. 현재 미리 보기 상태인 이 통합은 다른 서비스에 비해 집계 쿼리에 훨씬 빠릅니다.또한, AlloyDB sync 및 Lakehouse federation이 이제 일반적으로 사용할 수 있게 되어 "경계 없는 Lakehouse"와 상호 작용하는 세 가지 주요 방법을 제공합니다. 직접 Iceberg 액세스는 AlloyDB의 컬럼 엔진을 활용하여 가속화하면서 Iceberg 테이블을 제자리에서 읽습니다. AlloyDB sync는 BigQuery에서 Lakehouse 데이터를 AlloyDB로 복사하여 낮은 지연 시간으로 자주 액세스되는 워크로드를 처리하며, 사용자 정의 일정에 따라 새로 고쳐집니다. Lakehouse federation은 AlloyDB가 네이티브 BigQuery 테이블을 직접 쿼리할 수 있도록 하여 BigQuery가 처리를 담당합니다. 이러한 통합은 사용자 정의 파이프라인의 필요성을 없애고 애플리케이션 및 AI 에이전트가 통합된 운영 및 Lakehouse 데이터에 원활하게 액세스할 수 있도록 합니다.실제 사례로는 사기 탐지, 개인화 및 동적 가격 책정이 있으며, 여기서 Lakehouse의 과거 컨텍스트는 데이터베이스의 실시간 결정에 정보를 제공합니다. 데이터 팀은 또한 큐레이션된 테이블을 Iceberg에 한 번 게시하여 여러 애플리케이션이 제자리에서 읽을 수 있도록 할 수 있습니다. 직접 Iceberg 액세스를 통해 다른 PostgreSQL 테이블과 마찬가지로 Iceberg 테이블을 등록하고 쿼리할 수 있으며, 내장 지원 및 컬럼 엔진의 이점을 누릴 수 있습니다. AlloyDB sync는 지속적으로 변경되지 않는 데이터에 대한 매우 낮은 지연 시간 읽기 요구를 충족하기 위해 AlloyDB에 로컬에서 새로 고칠 수 있는 복사본을 만듭니다. Lakehouse federation은 BigQuery에 방대한 과거 데이터가 있는 조직을 대상으로 하며, 처리를 BigQuery로 푸시 다운하고 결과만 반환합니다. 통합 선택은 데이터 위치, 애플리케이션 읽기 패턴 및 지연 시간 요구 사항에 따라 달라집니다.
CdXz5zHNQW_fVS3LutEP2.png
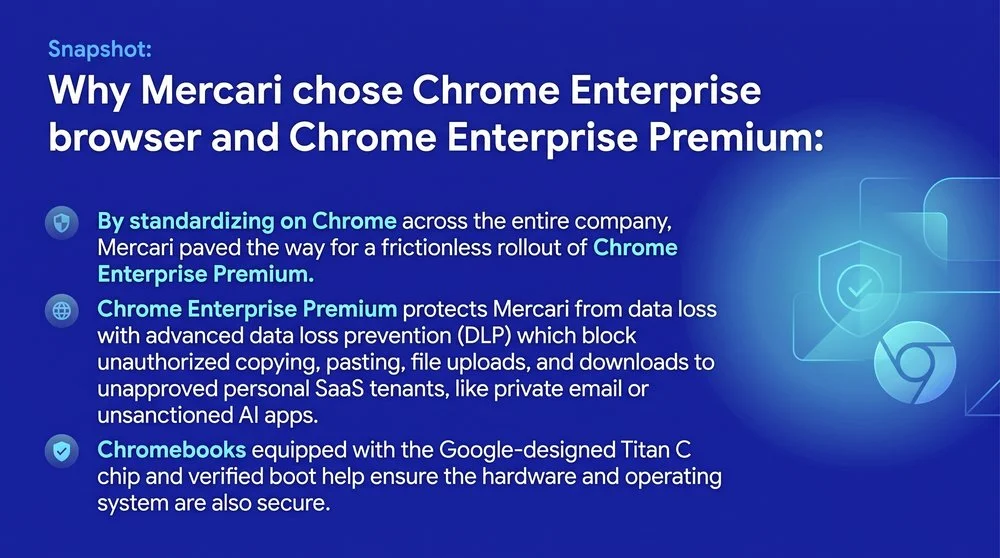
수백만 명의 사용자를 보유한 소비자 간(C2C) 마켓플레이스인 메르카리는 민감한 PII를 처리하는 고객 서비스 환경을 보호해야 했습니다. 이전의 VDI 설정은 비효율적이고 비용이 많이 들며 복잡했으며, 중복되는 DLP 제어가 필요했습니다. 메르카리는 브라우저 계층 데이터 제어에 집중하기 위해 Chrome Enterprise Premium과 Chromebook으로 전환했습니다. 이 새로운 아키텍처는 엄격한 DLP 규칙을 허용하여 승인되지 않은 목적지 및 AI 도구로의 데이터 유출을 방지했습니다. 직원들이 기존 Chrome 브라우저에 익숙했기 때문에 전환은 원활했습니다. 이러한 전환은 보안을 강화했을 뿐만 아니라 IT 운영을 간소화하고 비용을 크게 절감했습니다. 메르카리는 VDI 의존도를 최소화하고 보안 에이전트를 통합함으로써 3년 내에 50% 이상의 비용 절감을 예상하고 있습니다. 브라우저 중심 모델은 IT 리소스를 우선순위가 높은 이니셔티브에 재할당하여 제로 트러스트, 장치 기반 보안 접근 방식을 강화했습니다. 메르카리는 이제 AI를 선도하는 조직으로서 안전하고 통제된 AI 채택을 가능하게 합니다. 초기에는 Chrome에서 Gemini에 대한 읽기 전용 액세스를 허용하는 브라우저 정책을 사용하여 생산성을 향상시키면서 데이터 수정 위험을 줄이고 있습니다. 메르카리는 Chrome Enterprise Premium의 진화하는 기능을 활용하여 AI 생산성과 보안의 균형을 지속적으로 맞출 계획입니다.
CdXz5zHNQW_kBiqeKA58G.jpeg
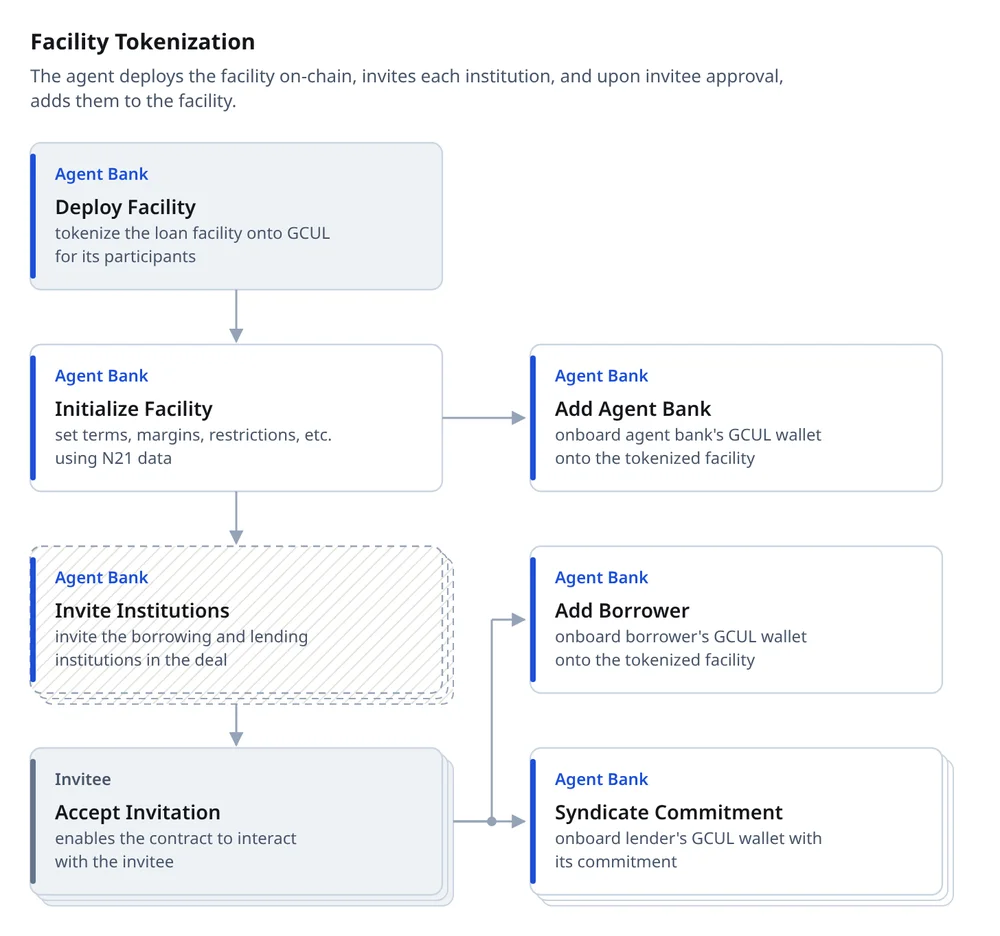
신디케이티드 대출 및 사모 신용 시장은 수작업 프로세스로 인한 느린 결제 및 가치 평가 불투명성과 같은 문제에 직면해 있습니다. 핀테크 혁신 기업 Nammu21은 새로운 개념 증명(proof-of-concept)을 통해 이러한 문제를 해결하기 위해 Google Cloud와 협력했습니다. 이 솔루션은 Nammu21의 AI 플랫폼을 사용하여 법률 계약을 Google Cloud Universal Ledger(GCUL)의 스마트 계약으로 구조화하여 전체 대출 라이프사이클을 자동화합니다. 현재 대출 시장은 법률 텍스트의 파편화되고 수동적인 해석으로 인해 어려움을 겪고 있으며, 이는 긴 결제 시간으로 이어지고 결과적으로 자본을 묶어두고 위험을 증가시킵니다. Nammu21은 맞춤형 신용 문서를 디지털 신용 상품(DCI)으로 디지털화하여 모든 약관을 원본 법률 조항에 매핑하고 실행 가능한 동작으로 표현합니다. GCUL은 이러한 상품을 인스턴스화하기 위한 안전하고 고성능의 분산 원장 환경을 제공하며, 거의 즉각적인 거래 확정성과 예측 가능한 비용을 제공합니다. GCUL의 프로그래밍 가능한 계약은 안전하고 읽기 쉬우며 감사 가능한 도메인 최적화 프로그래밍 언어인 gculpy로 작성됩니다. 이 플랫폼은 복잡한 메모리 관리를 단순화하여 금융 기관의 개발을 간소화합니다. Nammu21은 법률 계약에서 DCI를 프로그래밍 방식으로 렌더링하고 GCUL에서 대출을 관리하는 gculpy 계약을 파생시키는 이중 역할을 수행합니다. 이 아키텍처는 모델링된 Term Loan B 거래에서 입증된 바와 같이 단일의 변경 불가능한 진실 공급원을 생성합니다. 이 시스템은 게이트 실행을 통해 규정 준수를 보장하고 민감한 데이터에 대한 역할 기반 개인 정보를 유지하며 결제 확정성을 제공합니다. 이러한 구조적 변화는 대출 시장을 근본적으로 변화시켜 결제 시간, 백오피스 오버헤드 및 거래상대방 위험을 줄입니다.
CdXz5zHNQW_BVawpnmXci.png
Google Cloud Consulting은 기업이 AI를 일상 운영에 통합하도록 지원하며, 생성형 AI에서 작업을 자율적으로 완료하는 에이전트 시스템으로의 전환을 관찰하고 있습니다. 기술 리소스가 중요하지만, AI 에이전트의 성공적인 기업 채택에는 의도적인 문화 변화가 필요합니다. 직원들은 실험할 수 있다는 느낌을 받아야 하며, 리더는 AI가 역할에 미치는 영향을 명확히 해야 합니다. 이 팀은 이러한 에이전트 전환을 안내하기 위한 다섯 가지 실용적인 교훈을 제공합니다. 첫째, 에이전트 실행 및 인간 지휘 워크플로우를 재설계하여 인간 루프 검증에서 인간 주도 모델로 전환합니다. 이는 에이전트가 병렬 종속성을 처리하고 모호한 시나리오만 인간에게 라우팅하는 것을 포함합니다. 둘째, 에이전트를 적극적인 위임과 명확한 책임을 요구하는 주니어 팀원으로 취급하여 소유권을 육성함으로써 직원들의 망설임을 해결합니다. 셋째, 결과에 집중하고 바람직한 행동을 강화하며 팀이 창의적인 작업을 위해 에이전트를 활용하도록 코칭함으로써 사람과 에이전트의 하이브리드 팀을 효과적으로 관리합니다. 넷째, 안전한 학습 영역을 제공하고 "지능적인 실패"를 축하하여 이해를 심화함으로써 실험을 통해 에이전트 리터러시를 구축합니다. 마지막으로, 허브 앤 스포크 모델로 에이전트를 관리하여 중앙 지침을 수립하는 동시에 개별 팀이 도구를 조정하고 실험할 수 있도록 합니다. 이 사람 중심 접근 방식은 인간의 독창성과 에이전트가 서로를 상호 증폭시키는 조직을 만드는 것을 목표로 합니다.
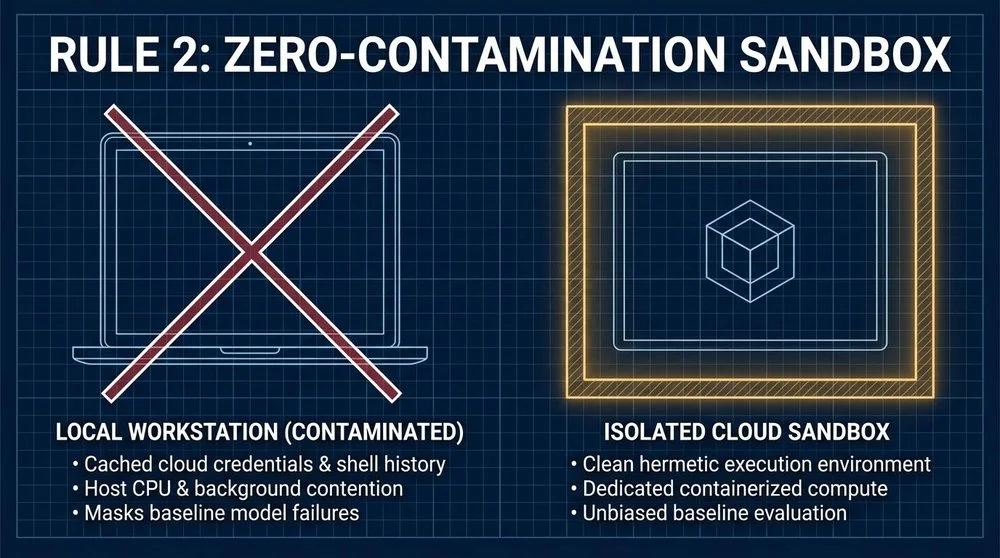
SKILL.md 파일을 효과적으로 테스트하는 것은 노트북에서의 단순한 합격/불합격 이상의 것을 요구합니다. 과도한 트리거링 또는 형제 하이재킹은 복잡한 워크스페이스에서 에이전트가 스킬을 로드하는 것을 방해할 수 있습니다. skill-reach 및 SkillSpector와 같은 도구는 프론트매터 충돌 및 보안 위험을 조기에 식별하는 데 도움이 됩니다. 주변 상태가 기준 결과를 오염시키기 때문에 개발자 노트북에서 스킬 벤치마크를 실행하는 것을 피하는 것이 중요합니다. 여러 번의 반복에 걸친 페어드 제거 테스트(WITH vs. WITHOUT)는 스킬 개선 및 효율성 향상을 보다 정확하게 측정할 수 있습니다. 이 접근 방식은 스킬이 실제로 도움이 되는지 또는 기본 모델이 이미 해당 기능을 가지고 있는지 밝혀냅니다. 최적화를 자동화할 때 평가 하네스가 올바름, 효율성 및 보안 메트릭을 분리하고 채점 구성 요소를 격리하여 보상 해킹에 대해 강화되었는지 확인하십시오. 마지막으로, 효과적인 SKILL.md 파일은 광범위한 문서를 단순히 덤프하는 대신 운영 습관과 검증 반사를 인코딩합니다. 프론티어 모델은 사전 훈련에 공개 문서가 있는 경우가 많으므로 간결하고 실행 가능한 제약 조건이 더 가치 있습니다. 새로운 모델로 스킬을 정기적으로 재평가하고 델타가 없는 스킬을 삭제하면 효율적이고 최신 상태의 스킬 세트를 보장할 수 있습니다.
CdXz5zHNQW_hfaP61Yspo.jpeg
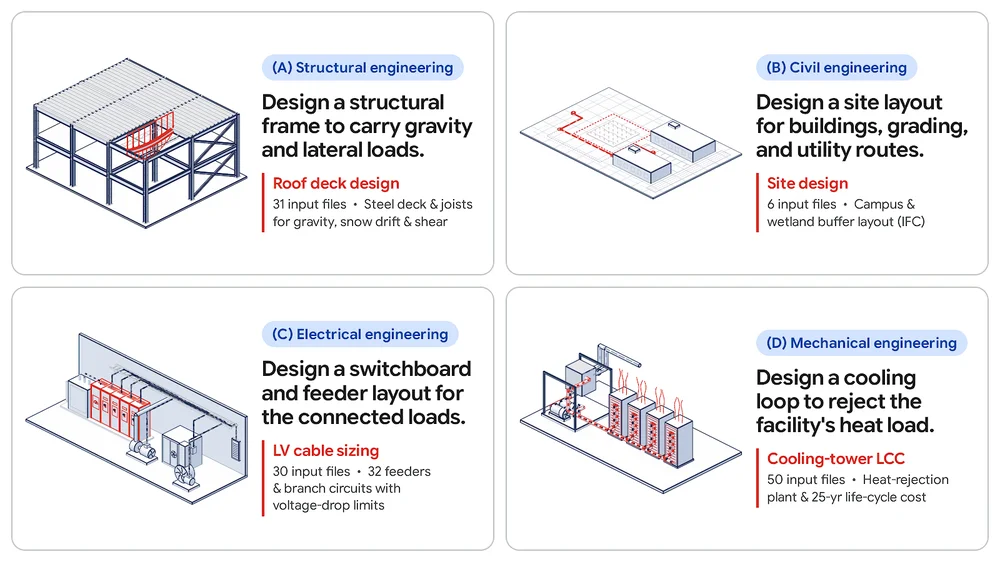
Google AI & Infrastructure 팀은 Mercor와 협력하여 새로운 벤치마크이자 공개 대회인 Physical-Engineering's Last Exam (PLE)을 출시했습니다. PLE는 최첨단 모델의 기계, 전기, 토목 및 구조 공학 과제 수행 능력을 평가합니다. 이 이니셔티브는 주로 교과서 문제나 개별 설계 문제에 초점을 맞춘 기존 벤치마크의 격차를 해소합니다. Humanity's Last Exam 또는 Agents' Last Exam과 같은 이전 시험과 달리 PLE는 물리적 세계 구축 작업에 대한 AI의 능력을 구체적으로 측정합니다.PLE는 실제 엔지니어링 프로젝트를 반영하는 85개의 장기 과제로 구성되며, 과제당 평균 61개의 파일이 포함됩니다. 이 파일에는 다양한 엔지니어링 문서가 포함되어 있으며, 에이전트는 코드, 제한 사항 및 계산을 통해 추론하여 실제 생산 가능한 결과물을 생성해야 합니다. 이 과제들은 현직 엔지니어와의 협력을 통해 개발되었으며, 전문가가 작성하거나 에이전트 파이프라인과 공동으로 작성되었습니다.7개의 에이전트 하네스를 사용하여 14개의 최첨단 모델에 대한 초기 테스트 결과, 모든 모델이 비공개 테스트 세트에서 50% 미만의 점수를 기록했습니다. 가장 높은 성능을 보인 모델은 평균 48.3%의 점수를 달성했습니다. 중요한 발견은 공동 작성 과제에서 개별 제약 조건의 91%를 충족했음에도 불구하고, 최고 점수를 받은 에이전트 결과물의 41.3%만이 모든 엄격한 안전 및 타당성 검사를 통과했다는 것입니다.모델 선택은 성능에 상당한 영향을 미치며 최대 50점의 차이를 보이지만, 하네스는 영향이 적고(중앙값 3점 차이) 실행 비용에 영향을 미칩니다. 이 벤치마크는 물리적 엔지니어를 지원할 수 있는 AI 도구 개발을 향한 실질적인 단계를 제공합니다. 연구원들은 ple-bench.com에서 29개의 공개 과제, 채점 도구에 액세스하고 공개 대회에 참여할 수 있습니다. Google은 자사 서버에서 13개 모델의 무료 평가를 후원하고 있으며, 상금 세부 정보는 곧 발표될 예정입니다.
CdXz5zHNQW_wib2wXWofK.png
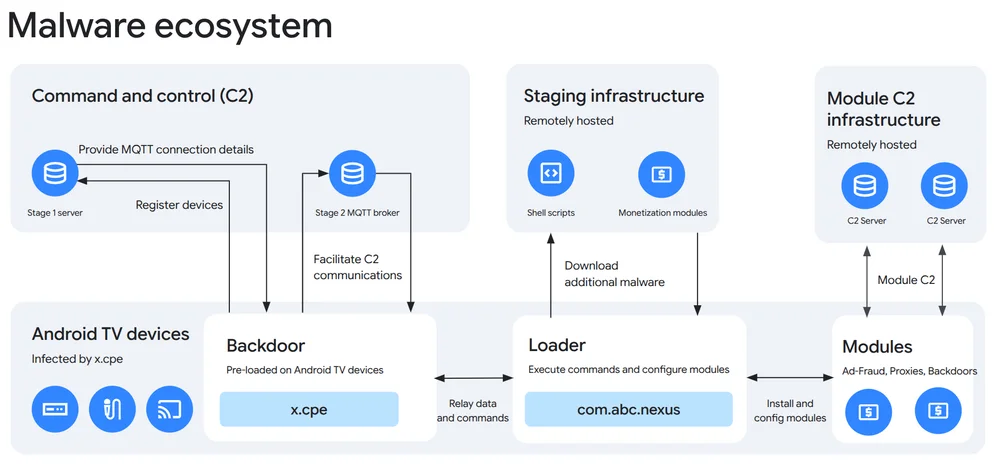
Google과 파트너들은 130만 개 이상의 셋톱박스로 구성된 봇넷인 XCPE 백도어를 해체했습니다. 안드로이드 OEM/ODM 업체인 Videostrong Technology Co.는 금전적 이득을 위해 이를 의도적으로 개발하고 운영했습니다. Videostrong은 범죄 제휴 업체들에게 접근 권한을 판매하여 백도어를 수익화했으며, 이들은 감염된 장치에 광고 사기, 주거용 프록시 및 추가 악성코드 모듈을 로드했습니다. Google은 Videostrong과의 관계를 끊고, Google 앱 사전 설치 기기 제작을 금지했습니다. Videostrong은 기기 부팅 후 악성 코드를 로드하기 위해 난독화 기법을 사용하여 Google 호환성 테스트의 허점을 악용했습니다. Google은 유사한 활동을 방지하기 위해 검토 프로세스를 변경했습니다. 이 캠페인은 사용자 동의 없이 광범위한 범죄 활동을 장치에서 가능하게 한 심각한 신뢰 위반이었습니다. Google의 방해 노력에는 Videostrong 및 그 제휴 업체가 사용한 C2 도메인 및 서버 인프라에 대한 법적 조치가 포함되었습니다. 또한 Google은 인증된 Android TV 기기에 대한 펌웨어 무결성 검사를 개선했습니다. XCPE 봇넷은 모듈식 3단계 아키텍처를 사용했습니다. 즉, 기본 시스템 수준 백도어(x.cpe), 로더 및 실행 엔진(com.abc.nexus), 다양한 수익화 모듈입니다. 봇넷은 구성에 HTTP 요청을 사용하고 명령에 지속적인 MQTT 연결을 사용하는 2단계 C2 프로세스를 사용합니다. 이를 통해 앱 자동 설치, Google Play Protect 비활성화, 임의 셸 실행, 화면 캡처 및 네트워크 정찰이 가능했습니다.
CdXz5zHNQW_vlPfeReDza.png
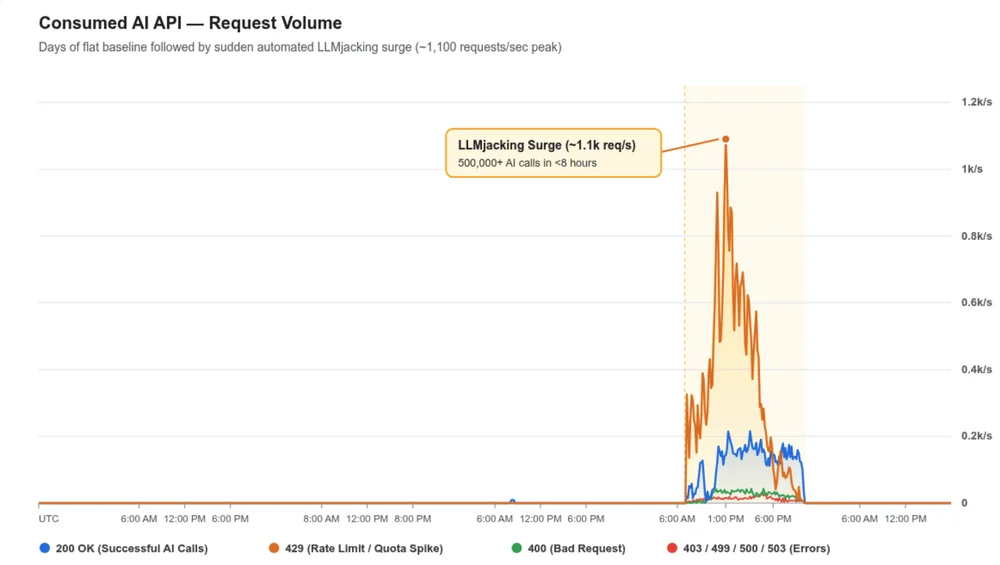
"Mandiant는 2026년에 대규모 언어 모델(LLM)에 대한 기업 접근 권한을 탈취하는 "LLMJacking"과 관련된 여러 사건에 대응했습니다. 전 세계 다양한 부문의 조직에 영향을 미친 이러한 침입으로 인해 일일 100,000달러를 초과하는 상당한 규모의 사기성 클라우드 요금이 발생했습니다. Google 위협 인텔리전스 그룹(GTIG)은 이러한 침해 배후에 다양한 재정적 동기를 가진 위협 클러스터를 식별했으며, 초기 접근 제공업체와 도난당한 접근 권한을 수익화하는 "LLM 믹서" 간의 분업을 언급했습니다. 공격 수명 주기는 공개적으로 노출된 LLM 엔드포인트 또는 IAM 자격 증명 및 GitHub PAT와 같은 도난당한 클라우드 ID 토큰을 통한 초기 접근을 포함합니다. 위협 행위자는 LLM API 키를 직접 대상으로 삼아 탐지를 피하기 위해 은밀하게 검증하기도 합니다. 이후 위협 행위자는 권한을 상승시키고 접근 권한을 강화하며 내부 정찰을 수행하여 민감한 자격 증명을 위해 클라우드 서비스 및 리포지토리를 열거합니다. 이들은 클라우드 ID 권한 및 VM 구성을 악용하여 무단 계정을 생성하고 지속성을 위해 SSH 키를 삽입합니다. 일부 행위자는 LLM 라우팅 소프트웨어의 취약점을 악용하여 관리자 제어 권한을 얻습니다. 궁극적인 목표는 토큰 프록시, 자동화된 모델 스트리밍 및 GPU 프로비저닝을 통한 LLM 수익 창출이며, 상당한 규모의 사기성 요금을 축적합니다. 위협 행위자는 자체 프록시 엔드포인트 및 에이전트 워크로드를 호스팅하고, 컨테이너화된 백도어를 배포하며 강력한 GPU를 프로비저닝합니다. 또한 LLM 믹서를 통해 접근 권한을 판매하여 손상된 API 할당량을 수익화하고, 오픈 소스 게이트웨이를 사용하여 도난당한 자격 증명을 풀링합니다. jet-night.com과 같은 주목할 만한 예시는 도난당한 API 키를 활용하여 시장 가격보다 낮은 요금을 제공하며, 상당한 비용을 피해 조직에 전가합니다."
CdXz5zHNQW_rJ0u9E2bkZ.png
NASA의 아르테미스 프로그램은 미래 심우주 임무를 위해 승무원 안전과 지구 독립적인 자율성을 필수적으로 요구합니다. 화성까지의 통신 지연은 실시간 의료 지도를 불가능하게 만들 것입니다. Google Public Sector는 우주비행사를 원격으로 지원하기 위해 Crew Medical Officer Digital Assistant (CMO-DA)를 개발하고 있습니다. 현재 이들은 이러한 임무를 지원하기 위한 로봇 시스템 개념 증명(proof-of-concept)을 만들고 있습니다. 이 다목적 로봇은 물류 및 장비를 처리하여 우주비행사들이 과학에 집중할 수 있도록 할 것입니다. 또한 의료진을 위해 초음파 준비와 같은 의료 지원으로 전환할 수도 있습니다. 제한된 우주선 내에서 안전하게 작동하려면 유연하고 인간이 지시하는 로봇이 필요합니다. Jet Propulsion Laboratory는 로봇이 3D 환경을 이해하도록 위성 도구를 조정하고 있습니다. 실제 하드웨어 테스트 전에 안전한 연습을 위해 시뮬레이터가 사용되었습니다. 비전-언어-액션 모델을 활용하여 우주비행사들은 텍스트 프롬프트를 통해 로봇을 지시할 수 있습니다. 우주 임무는 엣지 컴퓨팅을 필요로 하므로, 모델은 Google Cloud에서 훈련되고 효율적인 장치에서 로컬로 실행됩니다. 궁극적인 목표는 우주비행사의 감독 하에 음성 명령을 통해 다양한 작업을 실행할 수 있는 로봇을 만드는 것입니다. 이 협력은 더 도전적인 과학 임무를 가능하게 하는 것을 목표로 합니다.
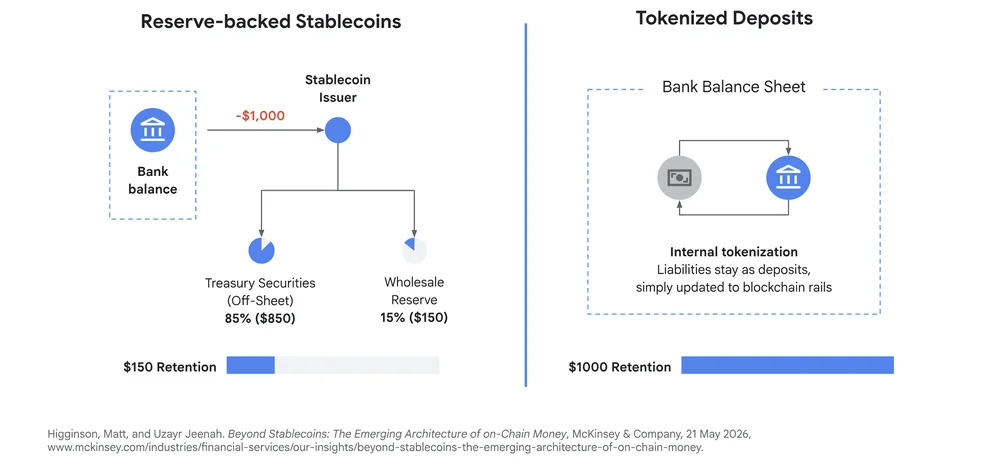
기존 결제 시스템은 느리고 비용이 많이 들어 효율적인 거래를 위한 스테이블코인의 부상을 이끌었습니다. 그러나 규제된 은행들은 상당한 위험과 규제 불확실성으로 인해 공개 스테이블코인을 기피해 왔습니다. 은행들은 토큰화된 통화의 속도를 원하지만, 신뢰할 수 있는 기반 위에 구축되기를 바라며, 이는 Google Cloud Universal Ledger(GCUL)로 전환하는 이유를 설명합니다. GCUL은 은행이 자체 토큰화된 예금을 발행하고 결제할 수 있는 안전한 인프라를 제공하여, 핵심 운영을 방해하지 않으면서 연중무휴 프로그래밍 가능한 결제를 가능하게 합니다. 이 접근 방식은 스테이블코인의 속도와 낮은 비용과 같은 이점을 제공하는 동시에 규제 문제와 은행 준비금에 미치는 영향에 대한 우려를 해결합니다. 스위스의 Crypto Finance Group은 이 개념을 성공적으로 시범 운영하여 GCUL 네트워크에서 두 스위스 은행 간의 즉각적인 계좌 간 이체를 시연했습니다. 이 시범 운영은 상업 은행이 엄격한 금융 보안 프레임워크를 준수하면서 결제 운영을 현대화하기 위한 아키텍처를 검증했습니다. GCUL의 설계는 견고성, 성능 및 통합 용이성을 강조하여 은행이 기존 시스템을 연결할 수 있도록 합니다. 규정 준수 및 거버넌스는 GCUL에 내장되어 있으며, Crypto Finance와 같은 "통화 운영자"가 네트워크 운영에 대한 규칙을 설정합니다. 이 시스템은 발행 한도를 통해 거래 상대방 위험을 완화하고 주기적인 결제를 통해 자본 효율성을 가능하게 합니다. Crypto Finance 시범 운영은 국내 이체에 대한 GCUL의 잠재력을 보여주며, 향후 적용 분야에는 통화 간 결제 및 자동화된 결제가 포함됩니다. 궁극적으로 GCUL은 은행이 자본 효율성과 규정 준수를 유지하면서 스테이블코인과 유사한 속도를 제공할 수 있도록 합니다.
CdXz5zHNQW_Kz3Qpap97Z.png
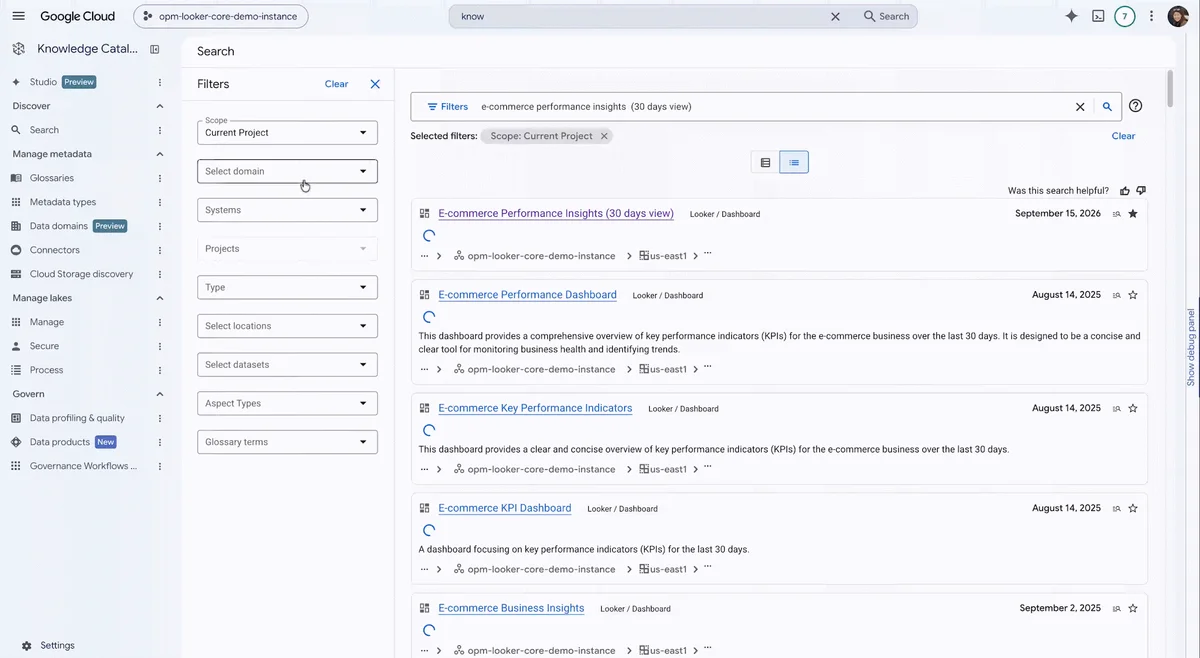
AI 에이전트를 프로덕션 환경으로 전환하는 기업은 데이터 액세스 이상의 것을 요구합니다. 데이터 이해가 필요합니다. Looker Core용 Google Cloud의 Knowledge Catalog는 이제 LookML 시맨틱 언어를 인덱싱하여 이 격차를 해소합니다. AI 에이전트는 테이블 스키마, 계보, 거버넌스를 포함한 컨텍스트뿐만 아니라 메트릭 계산을 위한 결정론적 비즈니스 시맨틱도 필요합니다. 단일 도구로는 광범위한 조직 컨텍스트와 정확한 메트릭 정의를 모두 제공할 수 없습니다. Knowledge Catalog는 광범위한 엔터프라이즈 컨텍스트를 제공하며, LookML은 결정론적 수학적 시맨틱을 제공합니다. 이 통합은 LookML 비즈니스 로직을 Knowledge Catalog에 인덱싱하여 Gemini Enterprise 및 사용자 지정 AI 에이전트에 제공합니다. 명시적인 시맨틱 규칙 없이는 LLM 에이전트가 충돌하는 메트릭 정의를 생성하고 단순한 조인 팬아웃으로 인해 잘못된 SQL을 생성할 수 있습니다. Knowledge Catalog와 Looker는 LookML에서 시맨틱을 한 번 모델링하고 Google Cloud의 AI 생태계 전체에서 액세스하여 이를 해결합니다. 이 새로운 릴리스는 LookML의 결정론적 시맨틱을 Knowledge Catalog의 최우선 계층으로 인덱싱하여 에이전트에 정확한 정의, 조인 경로 및 계보를 제공합니다. 이 메타데이터는 사용자 지정 코드 없이 Gemini Enterprise에서 자동으로 사용할 수 있으므로 기술 스키마, 용어집 및 인덱싱된 LookML 로직을 참조하여 정확한 SQL을 생성할 수 있습니다. Google Cloud의 Looker Core는 LookML 모델, 탐색, 보기, 계보 및 대시보드를 Knowledge Catalog에 직접 자동으로 인덱싱합니다. 이 통합을 통해 에이전트는 Knowledge Catalog에서 광범위한 컨텍스트와 LookML에서 명시적인 수학적 관계를 모두 검색할 수 있습니다.
CdXz5zHNQW_qDLEvNBkS9.gif
애플리케이션 개발에서 자율 에이전트의 사용 증가는 ID 및 액세스 관리에 상당한 과제를 안겨줍니다. 클라우드 리소스를 프로비저닝하고 머신 속도로 서비스를 배포할 수 있는 이러한 에이전트는 CI/CD 파이프라인을 늦출 수 있는 보안 마찰을 겪을 수 있습니다. 이러한 "에이전트 시대" IAM 과제를 해결하기 위해 Google Cloud는 IAM Helper를 출시합니다. IAM Helper는 자율 코드 어시스턴트 및 배포 파이프라인을 위한 복잡한 IAM 워크플로우를 자동화하는 지능형 에이전트 지향 빌딩 블록을 제공합니다. 이는 Policy Intelligence 및 Privileged Access Manager와 같은 기존 엔진과 통합되는 Google Cloud IAM을 위한 에이전트 네이티브 오케스트레이션 계층 역할을 합니다. 이 통합을 통해 자율 코드는 IAM 기술을 직접 호출하여 관리 오버헤드를 줄이고 보안을 개선할 수 있습니다. IAM Helper는 에이전트가 액세스를 동적으로 관리할 수 있도록 하여 정책 평가 및 복잡한 오케스트레이션의 부담을 Google Cloud 백엔드로 이전합니다. Agent Skills 표준을 사용하여 패키징된 이러한 엔드투엔드 워크플로우 및 가드레일은 Gemini 및 Claude와 같은 일반적인 에이전트와 함께 작동합니다. IAM Helper 기술은 읽기 전용 검색과 정책 변경을 분리하고 자동화된 진단 및 시뮬레이션을 포함하는 내장 가드레일을 통합합니다. 정책 변경에는 사용자 정의 가능한 위험 계층을 통한 인간의 확인이 필요합니다. 예를 들어, 권한 오류를 겪는 에이전트는 자동으로 문제를 해결하고 임시 부여를 요청하며 문제를 해결할 수 있습니다. 자율 파이프라인은 최소 권한 정책을 생성하고, 로그에 대해 이를 확인하고, 승인을 위해 변경 사항을 라우팅하여 자체 복구할 수 있습니다. IAM Helper는 또한 규정을 준수하는 정책 작성을 지원하고, IAM v1 및 v2 규칙을 생성 및 검증하며, 위험한 구성을 차단합니다. 이를 통해 누락된 권한을 식별하여 403 오류를 신속하게 해결할 수 있으며, 배포 전에 영향 범위를 평가하기 위해 정책 변경을 시뮬레이션할 수 있습니다. 또한, 감사되고 시간 제한된 액세스를 보장하는 상시 권한 대신 적시 특권 액세스를 용이하게 합니다. 이러한 에이전트 기술은 효율적으로 IAM 엔드포인트를 쿼리하기 위한 원자적 읽기 전용 함수를 제공하는 기본 Google Cloud IAM MCP 도구에 의해 지원됩니다. 이러한 도구를 사용하면 사용자 정의 API 래퍼의 필요성이 없어지므로 토큰 효율성이 극대화되고 에이전트가 다단계 작업을 안전하게 실행할 수 있습니다. 팀은 IAM Helper Agent Skills Catalog 및 공식 문서를 통해 이러한 기능을 구현하기 시작할 수 있습니다.
Google Cloud는 개발자들에게 Anthropic의 Claude 모델을 배포할 수 있는 더 많은 선택권을 제공함으로써 생성형 AI 제품을 강화하고 있습니다. Google Cloud에서 Claude 모델을 위한 새로운 Anthropic 관리형 배포 옵션이 이제 일반적으로 사용 가능합니다. 이 옵션은 기존의 Google 관리형 배포 선택권을 보완합니다. 두 옵션 모두 최신 Claude 모델에 제로데이 액세스를 제공하며 동일한 가격 책정 및 Google Cloud 결제를 공유합니다.주요 차이점은 데이터 처리자가 누구인지, 그리고 새로운 Claude 플랫폼 기능의 가용성입니다. Anthropic 관리형 옵션은 Claude Managed Agents 및 코드 실행과 같은 기능에 즉시 액세스할 수 있으며, Anthropic은 자체 약관에 따라 데이터 처리자 역할을 합니다. Google Cloud IAM 및 결제 통합은 여전히 활용됩니다. 반대로, Google 관리형 옵션은 기존 고객 계약에 따라 Google Cloud를 데이터 처리자로 유지하며, VPC Service Controls 및 CMEK와 같은 기능에 대한 엄격한 거버넌스 및 규정 준수를 우선시합니다. 새로운 Claude 플랫폼 기능은 시간이 지남에 따라 Google 관리형 인프라에 통합될 것입니다. Google 관리형 옵션은 Google Cloud 서비스와의 네이티브 통합도 제공합니다. 배포 선택에 관계없이 사용자는 Opus, Sonnet 및 Haiku와 같은 Claude 모델을 활용할 수 있습니다.
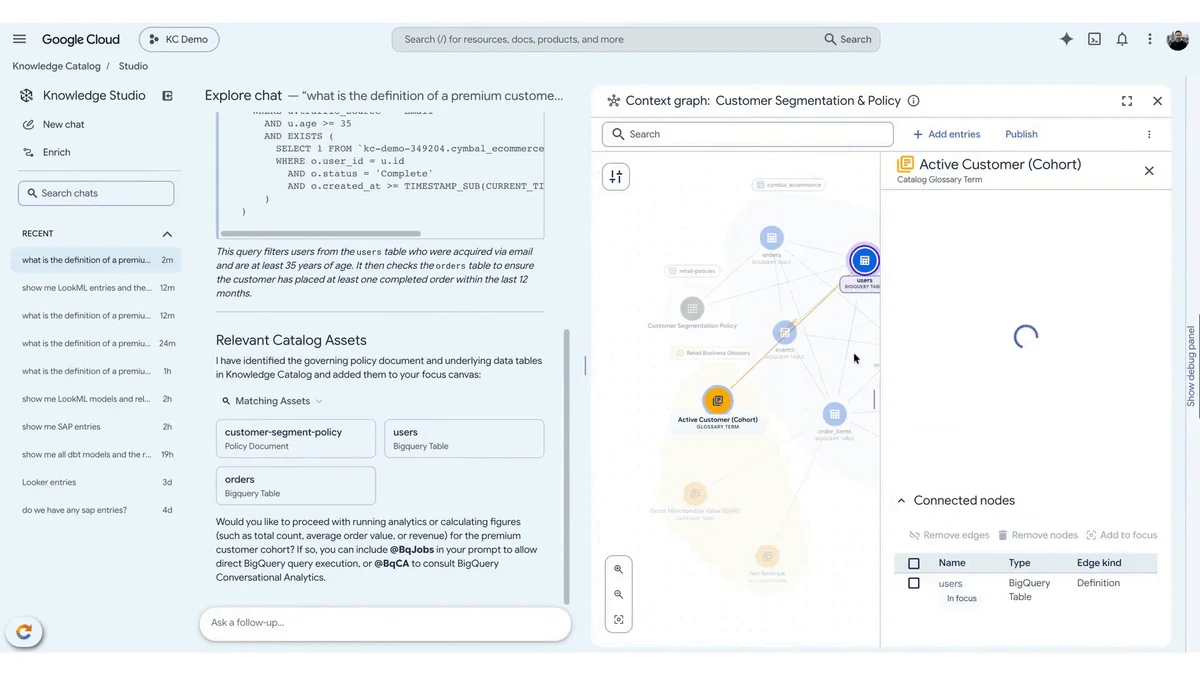
Google Cloud의 Knowledge Catalog가 새로운 미리보기 기능으로 에이전트의 컨텍스트 엔진을 강화하고 있습니다. 자체 학습 컨텍스트 강화는 에이전트와 사용자 상호 작용을 분석하여 누락되거나 오래된 비즈니스 컨텍스트를 자동으로 식별하고 업데이트합니다. Knowledge Studio는 이 컨텍스트를 관리하기 위한 시각적 컨텍스트 그래프와 대화형 탐색 기능을 제공합니다. 이는 에이전트 수가 증가함에 따라 컨텍스트를 수동으로 큐레이션하는 문제를 해결합니다. Gemini 기반 강화는 다양한 비즈니스 문서 및 코드 리포지토리에서 검증된 정의를 추출합니다. 이러한 정의는 에이전트가 사용할 수 있도록 관리되고 재사용 가능한 컨텍스트 세트로 구성됩니다. 이는 에이전트 정확도를 향상시키고 지연 시간 및 토큰 사용량을 크게 줄입니다. 강화 기능은 구조화된 데이터 소스와 비구조화된 데이터 소스 모두에 연결됩니다. 제안된 컨텍스트 업데이트는 검토를 위해 출처 인용 및 신뢰도 점수와 함께 제시됩니다. 사용자 및 에이전트 상호 작용은 에이전트가 어려움을 겪는 영역을 정확히 파악하여 자동 수정할 수 있도록 합니다. 자동 게시 변경을 위해 신뢰도 점수 임계값으로 자동화를 구성할 수 있습니다. 컨텍스트 세트는 더 넓은 컨텍스트 그래프의 큐레이션된 도메인별 하위 집합을 허용합니다. 이러한 세트는 데이터 거버넌스 및 세분화된 액세스 제어를 시행합니다. Knowledge Studio는 Knowledge Catalog를 컨텍스트 관리를 위한 대화형 명령 센터로 변환합니다. 시각적 탐색, 대화형 탐색 및 변경에 대한 버전 제어를 제공합니다. 이러한 새로운 기능은 컨텍스트를 최신 상태로 유지하고 조직 전체의 에이전트 성능을 향상시키는 것을 목표로 합니다.
CdXz5zHNQW_xA5im0bBF2.gif
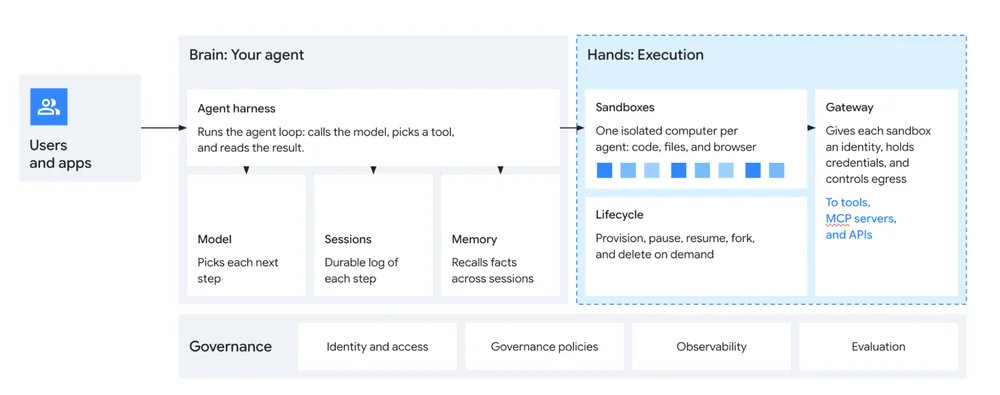
소프트웨어 산업은 주기적인 아키텍처 변화를 겪고 있으며, 웹 스케일 붐 이후 웨어하우스 스케일 컴퓨팅과 컨테이너가 등장했고, 딥러닝 수요로 인해 TPU가 개발되었습니다. 구글은 또한 하드웨어 기반 보안 보장을 위해 Titanium을 도입했습니다. 새로운 근본적인 변화는 에이전트형 AI의 부상으로, AI 에이전트가 단순히 질문에 답하는 것을 넘어 행동을 취합니다. 이러한 에이전트들은 점점 더 코드를 작성하고, 도구를 실행하며, 워크플로우를 조정하여 컴퓨팅 및 스토리지 리소스를 빠르게 소비하고 있습니다. 기존 컴퓨팅 기본 요소는 수백만 개의 에이전트를 비용 효율적으로 낮은 지연 시간으로 실행하기에 불충분합니다. 이는 새로운 폼 팩터의 필요성을 야기하며, AI 에이전트를 위한 하드웨어 격리 마이크로VM을 제공하는 구글 클라우드 서비스인 Agent Compute Engine의 개발로 이어집니다.Agent Compute Engine은 가상 머신의 격리와 컨테이너의 속도 및 밀도 간의 격차를 해소하는 것을 목표로 합니다. 기존 VM은 에이전트를 자주 일시 중지하고 재개하기에는 시작 및 중지 속도가 너무 느립니다. 컨테이너는 빠르지만 특정 에이전트 작업에 필요한 격리 및 커널 수준 제어가 부족합니다. 시스템은 리소스 낭비를 방지하고 작업 상태를 보존하기 위해 에이전트가 활성 상태인지 유휴 상태인지 이해하여 에이전트를 효율적으로 관리해야 합니다. Agent Compute Engine은 지속적이고 하드웨어 격리된 컴퓨팅을 위한 마이크로VM 추상화를 제공하는 통합 플랫폼으로 설계되었습니다.이 새로운 아키텍처는 대화형 에이전트 인터페이스, 자율 소프트웨어 엔지니어링, 대규모 평가 및 구글 서비스를 위한 경량 샌드박스를 포함한 다양한 워크로드를 지원합니다. 보안은 Titan 실리콘 및 Titanium IPU를 통한 하드웨어 기반 신뢰에 기반한 심층 방어 접근 방식으로 가장 중요합니다. 호스트 무결성은 상태 비저장, 불변 어플라이언스를 통해 유지되며, 에이전트 세션은 단일 테넌트 마이크로VM 내에서 격리됩니다. 제로 시크릿 아키텍처는 게스트 OS가 손상되더라도 보안을 보장하며 민감한 자격 증명이 샌드박스 내에 상주하는 것을 방지합니다.네트워킹은 제한되며, 모든 트래픽은 정책 기반 아웃바운드 브로커링을 시행하는 중개 프록시를 통해 흐릅니다. 전송 중인 데이터와 저장된 데이터 모두에 대해 엔드투엔드 암호화가 구현됩니다. 자동 패치, 런타임 탐지 및 지속적인 보안 조치가 마련되어 있으며, 에이전트 하네스와 샌드박스 간의 엄격한 분리가 이루어집니다. 시스템은 샌드박스가 공격자에 의해 제어된다는 가정 하에 작동하므로 자격 증명을 보유하지 않고 직접적인 네트워크 액세스가 없습니다. 거버넌스는 레지스트리를 통해 관리되는 일급 에이전트 ID와 볼트 및 에이전트용 브로커 역할을 하는 인증 관리자를 통해 처리됩니다.
CdXz5zHNQW_XUm165nYZ0.png
Gemini와 같은 자율 에이전트의 확장을 위해서는 실행 및 제어를 위한 강력한 인프라가 필요합니다. Google은 AI 에이전트의 동적 요구 사항을 위해 설계된 특수 컴퓨팅 서비스인 Agent Compute Engine을 출시하며, 격리된 런타임 보안 및 효율성을 제공합니다. 이 서비스는 업무용 Gemini를 지원하며 곧 고객에게 미리 보기로 제공될 예정입니다. Kubernetes를 표준화하는 고객을 위해 맞춤 설정 및 멀티 클라우드 이식성을 제공하는 동반 오픈 소스 옵션인 GKE의 Agent Substrate도 있습니다. 두 솔루션 모두 하드웨어 격리 및 빠른 시작/일시 중지 기능을 통해 향상된 보안을 제공합니다. Agent Compute Engine은 효율성을 위해 copy-on-write 메모리 공유 및 빠른 체크포인팅을 갖춘 microVM을 활용하며, Agent Substrate는 고밀도 에이전트 배포를 위해 제로 트러스트 아키텍처를 활용합니다. 에이전트 플릿 확장의 과제를 해결하기 위해 Google은 Gemini for business의 에이전트 거버넌스 기능을 확장하고 있습니다. Agent Gateway는 중앙 정책 시행자 역할을 하고, Agent Registry는 승인된 에이전트를 관리하며, Agent Identity는 안전한 식별을 제공합니다. 이러한 거버넌스 기능은 이제 더 광범위한 Google Cloud 런타임, 크로스 클라우드 환경 및 로컬 엔드포인트까지 포괄할 것입니다. 새로운 거버넌스 개선 사항에는 세분화된 비용 제어, 지능형 모델 라우팅 및 확장된 보안 파트너 통합이 포함됩니다. 회사는 AI 에이전트에 대한 고성능 실행과 포괄적인 거버넌스를 결합한 탄력적인 에이전트 인프라를 제공하는 것을 목표로 합니다.
CdXz5zHNQW_rd8H1uSuzS.png
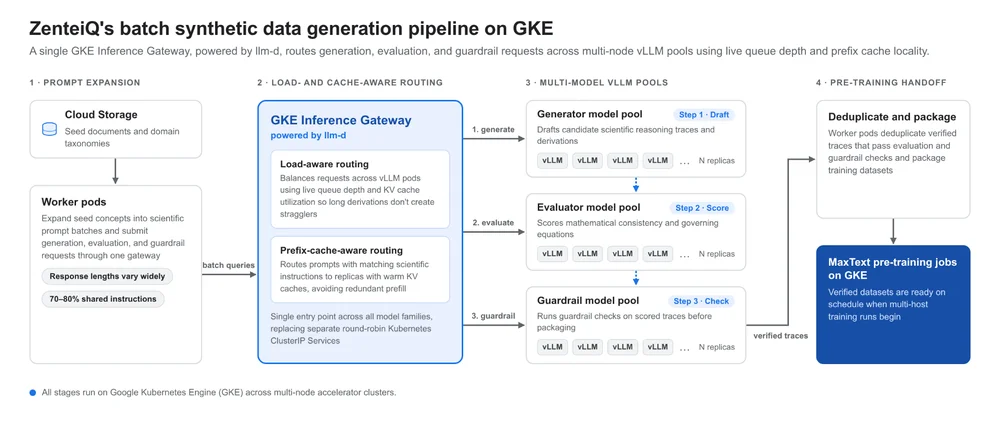
인도 과학 연구소 출신의 AI 스타트업인 ZenteiQ는 주권 과학 기반 모델을 구축하고 있습니다. 이러한 모델은 일반 언어 모델과 달리 물리학, 방정식, 수치 솔버에 대한 이해를 필요로 합니다. ZenteiQ는 이러한 모델을 사전 훈련하기 위해 대규모 합성 데이터 생성 파이프라인을 사용합니다. 이 파이프라인은 복잡한 과학적 도출 및 솔버 검증을 포함하는 수십억 개의 추론 토큰을 생성합니다.이전에 ZenteiQ는 Kubernetes에서 라우팅 병목 현상에 직면하여 엔진 큐가 불균등하고 중복 계산이 발생했습니다. 이로 인해 데이터 생성이 크게 느려지고 사전 훈련이 지연되었습니다. 이러한 문제를 극복하기 위해 ZenteiQ는 llm-d를 기반으로 하는 Google Kubernetes Engine(GKE) Inference Gateway를 구현했습니다. 이 솔루션은 추론 요청에 대해 지능적이고 로드 및 캐시를 고려한 라우팅을 제공합니다.GKE Inference Gateway는 서빙 노드 전반에 걸쳐 실시간 큐 깊이와 KV 캐시 활용도를 모니터링합니다. 요청을 효과적으로 라우팅하여 병목 현상을 방지하고 캐시된 프롬프트 접두사를 재사용합니다. 이러한 지능형 라우팅은 처리량을 극적으로 증가시켜 일일 출력량이 14억 7천만 개에서 거의 60억 개의 생성된 토큰으로 증가했습니다. 또한 사전 훈련 실행의 예측 가능성을 보장했습니다. ZenteiQ는 향후 고급 AI 훈련 단계에 이 설정을 활용할 계획입니다.
CdXz5zHNQW_6aNuYU90ce.png
두 개의 치명적인 PHP 취약점인 CVE-2026-109618과 CVE-2026-109619가 공개되었으며, 인증되지 않은 원격 코드 실행 및 메모리 노출의 위험을 초래합니다. Wiz Research와 PHP에 따르면 CVSS 점수 9.2의 이 결함은 PHP 버전 5.4부터 8.5.11까지 영향을 미칩니다. 취약점은 메모리 부족 처리 및 오래된 내부 요청 상태의 문제에서 비롯됩니다. Google Cloud는 사용자에게 PHP 애플리케이션을 즉시 버전 8.2 이상으로 업데이트하고 다시 배포할 것을 권고하고 있습니다. App Engine, Cloud Run 및 Google Kubernetes Engine 사용자를 위한 특정 지침이 제공됩니다. Google Cloud 자체는 취약하지 않지만, 해당 플랫폼에서 PHP를 실행하는 고객 애플리케이션은 영향을 받을 수 있습니다. PHP 프로젝트는 최신 버전에 대한 패치를 출시했지만, 오래된 지원 종료 버전은 수정되지 않을 것입니다. Google Cloud는 특정 서버리스 플랫폼에 대한 자동 패치를 배포하고 있습니다. 사용자 정의 컨테이너 이미지를 사용하는 사용자는 패치된 PHP 버전으로 다시 빌드하고 다시 배포해야 합니다. On-Demand Scanning AP 및 Security Command Center와 같은 모니터링 도구는 취약한 워크로드를 식별하고 탐지하는 데 도움이 될 수 있습니다. PHP를 업데이트하는 것은 애플리케이션을 보호하고 서비스 무결성을 유지하는 데 중요합니다.
Google Public Sector는 정부 및 교육 기관 고객을 위한 협업을 촉진하고 임무 수행을 확대하기 위해 파트너 이니셔티브를 강화하고 있습니다. 이러한 업데이트는 귀중한 파트너 네트워크를 지원하기 위한 네 가지 핵심 영역에 중점을 둡니다. 새로운 인센티브는 사전 판매 기술 전문성과 솔루션 설계를 위해 파트너에게 보상할 것입니다. 파트너 주도 사용자 성공 프로그램은 목표 투자를 통해 Gemini 채택을 증진할 것입니다.Google은 파트너 조직 내 엘리트 엔지니어를 양성하기 위한 Forward Deployed Engineer 아카데미를 도입하고 있습니다. 사전 판매 가속화 노력에는 파트너 주도 고객 워크숍 및 개념 증명에 대한 자금 지원 증가가 포함됩니다. 판매 후 채택은 미국 공공 부문 전반에 Gemini를 배포하기 위한 파트너 전문 서비스 자금으로 4,500만 달러의 상당한 투자를 보고 있습니다.특화된 임무를 지원하기 위해 새로운 ISV Agent Factory는 맞춤형 공공 부문 에이전트 생성을 가속화할 것입니다. 이는 ISV ATO Accelerator를 보완하며, 인증에 대한 상당한 자금을 제공합니다. SHI와의 새로운 제휴를 통해 영업 팀을 참여시키고 Accenture Federal Services와의 Gemini Launchpads 협업을 포함한 전략적 제휴가 형성되고 있습니다. 이러한 이니셔티브는 기관이 실험에서 임무 실행으로 나아가도록 하는 것을 목표로 합니다. 궁극적으로 이러한 노력은 공공 부문 고객이 필요한 임무 준비 역량을 갖추도록 보장합니다.
Google Cloud는 OpenAI 모델을 Model Garden에 통합하여 AI 제품군을 강화하고 있습니다. 이로써 Google Cloud는 수많은 다른 모델과 함께 세 가지 주요 폐쇄형 소스 LLM 모두에 액세스할 수 있는 유일한 하이퍼스케일 제공업체가 되었습니다. 이 플랫폼은 고객에게 특정 워크로드에 적합한 모델을 선택할 수 있는 유연성을 제공하며, 비용, 기능 및 성능의 균형을 맞추는 데 중점을 둡니다. GPT-6 Astra, GPT-6.1 Sol, GPT-6 Luna와 같은 새로운 OpenAI 모델이 도입되며, 각 모델은 서로 다른 사용 사례와 효율성 수준에 맞춰져 있습니다. 이 통합을 통해 고객은 아키텍처 종속성이나 별도의 공급업체 계약 없이 동적으로 모델을 전환할 수 있습니다. 사용자 활동은 기존 클라우드 약정 및 Flexible Savings Plans를 활용하여 단일 Google Cloud 송장에 통합됩니다. 보안 및 데이터 거버넌스가 최우선이며, 엄격한 데이터 경계는 고객 데이터가 모델 학습에 절대 사용되지 않도록 보장합니다. 격리된 액세스 경계 및 통합 감사 기능은 엔터프라이즈 워크로드에 대한 강력한 보안 및 가시성을 제공합니다. 이러한 새로운 OpenAI 모델은 현재 일부 엔터프라이즈 고객을 대상으로 비공개 미리 보기로 제공됩니다. Gemini for business 및 Google Antigravity와의 향후 통합은 개발자 및 기업을 위한 선택과 효율성을 더욱 확장할 것입니다.
Google Cloud가 인공지능 워크로드 보안의 중요한 발전인 Confidential G4 인스턴스를 출시했습니다. NVIDIA RTX PRO 6000 Blackwell Server 에디션 GPU를 탑재한 이 인스턴스는 기밀 컴퓨팅 기능을 제공합니다. 이는 자율 에이전트가 처리하는 민감한 데이터와 지적 재산이 실시간으로 보호된다는 것을 의미합니다. 이 기술은 NVIDIA Confidential Computing을 Google Cloud의 AI Hypercomputer에 통합하여 성능 저하 없이 컴퓨팅 중 개인 정보를 보장합니다. Confidential G4 인스턴스는 현재 여러 영역에서 일반에 공개되었으며, Compute Engine VM 및 GKE 노드에서 다양한 소비 모델을 지원합니다. 안전한 다자간 데이터 공유를 지원하는 Confidential Space에 대한 지원도 곧 출시될 예정입니다. Confidential G4 인스턴스는 내보낼 수 없는 키, 원격 증명, 메모리 암호화와 같은 하드웨어 기반 보안 기능을 활용합니다. 이를 통해 조직은 엄격한 규제 요구 사항을 충족하고 비용 효율성을 유지할 수 있습니다. 이 솔루션은 호스트 관리자 및 클라우드 제공업체로부터 데이터와 모델 매개변수를 격리하여 엔드투엔드 기밀성을 제공합니다. 검증 가능한 암호화 신뢰는 하드웨어 기반 원격 증명을 통해 구축되어 민감한 작업이 시작되기 전에 무결성을 보장합니다. 중요한 것은 배포를 위해 코드 리팩토링이 필요하지 않아 채택 프로세스가 단순화된다는 것입니다. 성능 테스트에 따르면 Confidential G4 인스턴스는 표준 G4 인스턴스와 유사한 처리량을 제공하며 성능 저하가 최소화됩니다. 이러한 발전은 기업이 귀중한 AI 자산에 대한 제어, 기밀성 및 책임성을 유지하면서 AI 배포를 안전하게 확장할 수 있도록 지원합니다.
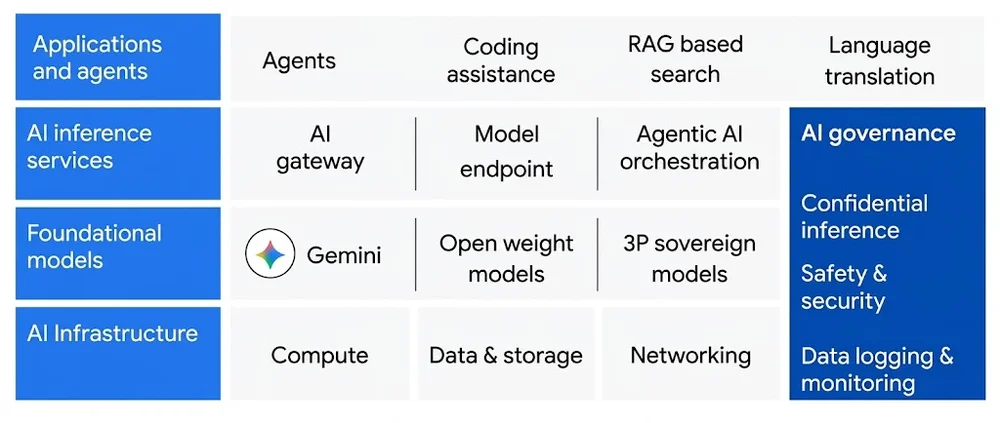
기업들은 복잡한 에이전트형 AI 워크플로우로 전환하고 있으며, 이는 원시 성능과 필수적인 유연성을 모두 제공하는 인프라를 요구합니다. 이 새로운 시대는 특정 작업을 위한 다양한 모델을 실행하고 데이터 및 운영 주권을 유지하는 능력을 필요로 합니다. Google Cloud는 NVIDIA와 협력하여 이러한 과제를 해결하기 위한 발전을 선보이고 있습니다. NVIDIA의 Vera Rubin 플랫폼으로 구동되는 새로운 A5X 인스턴스는 가속화된 컴퓨팅과 확장된 글로벌 가용성을 제공합니다. Virgo Network는 사이트 전반에 걸쳐 대규모 GPU 클러스터를 가능하게 하는 스케일 아웃 기능을 향상시킵니다. 스토리지 솔루션에는 이제 직접적인 GPU 데이터 액세스를 위한 NVIDIA GPUDirect Storage를 갖춘 Managed Lustre가 포함됩니다. A5X 인스턴스의 고급 KV 캐싱은 에이전트형 워크로드에 대한 긴 컨텍스트 메모리를 향상시킵니다. Google Kubernetes Engine(GKE)은 이러한 A5X 인스턴스를 오케스트레이션하여 분산 AI 운영을 단순화할 것입니다. Gemma 및 Mistral과 같은 오픈 모델에 대한 지원은 Google Cloud의 Sovereign Cloud 포트폴리오 내에서 확장되고 있습니다. NVIDIA의 Nemotron 모델 및 Cosmos 시뮬레이션은 사용자 정의 및 가상 세계 생성을 위해 Gemini와 통합됩니다. Sovereign AI 기능은 Google Distributed Cloud를 통해 온프레미스 환경으로 확장되고 있습니다. 여기에는 에어갭 배포를 위한 NVIDIA Blackwell Ultra GPU 및 Gemini Flash 모델이 포함됩니다. 퍼블릭 클라우드의 Confidential Computing은 Confidential G4 인스턴스 및 Confidential Bare Metal 옵션으로 강화됩니다. 이러한 혁신은 하드웨어 기반 보안을 통해 민감한 지적 재산 및 사용자 데이터를 보호하는 것을 목표로 합니다. NVIDIA의 전체 스택 플랫폼과 공동 엔지니어링된 Google Cloud AI Hypercomputer는 AI 확장을 위한 통합 기반을 제공합니다.
Google Cloud는 이제 Antigravity를 통해 Claude Opus 5.5와 Claude Sonnet 5.5를 제공하여 개발자들에게 더 많은 모델 선택권을 제공합니다. Claude Opus 5.5는 복잡한 작업에 뛰어나며, Sonnet 5.5는 속도와 비용 효율성을 제공합니다. 관리자는 Antigravity 내에서 Google의 Gemini 모델과 함께 이러한 모델을 활성화할 수 있습니다. 개발자는 다양한 Antigravity 도구의 모델 선택기에서 선호하는 모델을 직접 선택할 수 있습니다. 이 통합은 모델 선택을 위한 통합된 청구 및 보안 환경을 가능하게 합니다. 이 플랫폼은 코드 품질을 향상시키고 비용을 관리하기 위해 멀티 모델 엔지니어링 패턴을 지원합니다. 한 패턴은 모델별 편향을 방지하기 위해 구현 및 검증에 다른 모델을 사용하는 것을 포함합니다. 개발자는 구현을 위해 Claude Opus 5.5 또는 Gemini 4 Argon을 할당하고 검증을 위해 다른 모델을 할당할 수 있습니다. 또 다른 패턴은 효율성을 위해 강력한 추론 모델과 더 빠른 "Flash" 하위 에이전트를 쌍으로 사용합니다. 하위 에이전트는 고용량 작업을 위해 Gemini Flash와 같은 특정 모델 계층을 사용하도록 구성할 수 있습니다. 이를 통해 전문화된 모델에 작업을 위임하여 최적화된 워크플로우를 구현할 수 있습니다. 관리자는 청구를 구성하고 조직을 위해 파트너 모델을 승인할 수 있습니다. 개발자는 이러한 새로운 모델 기능을 사용하기 위해 Antigravity 도구를 업데이트해야 합니다.
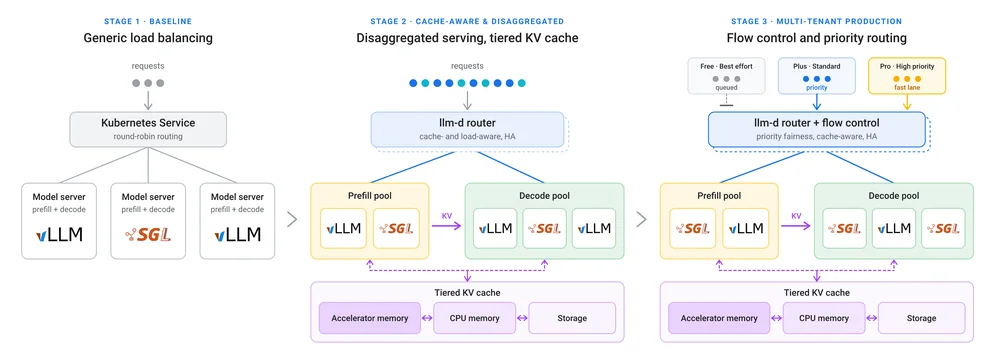
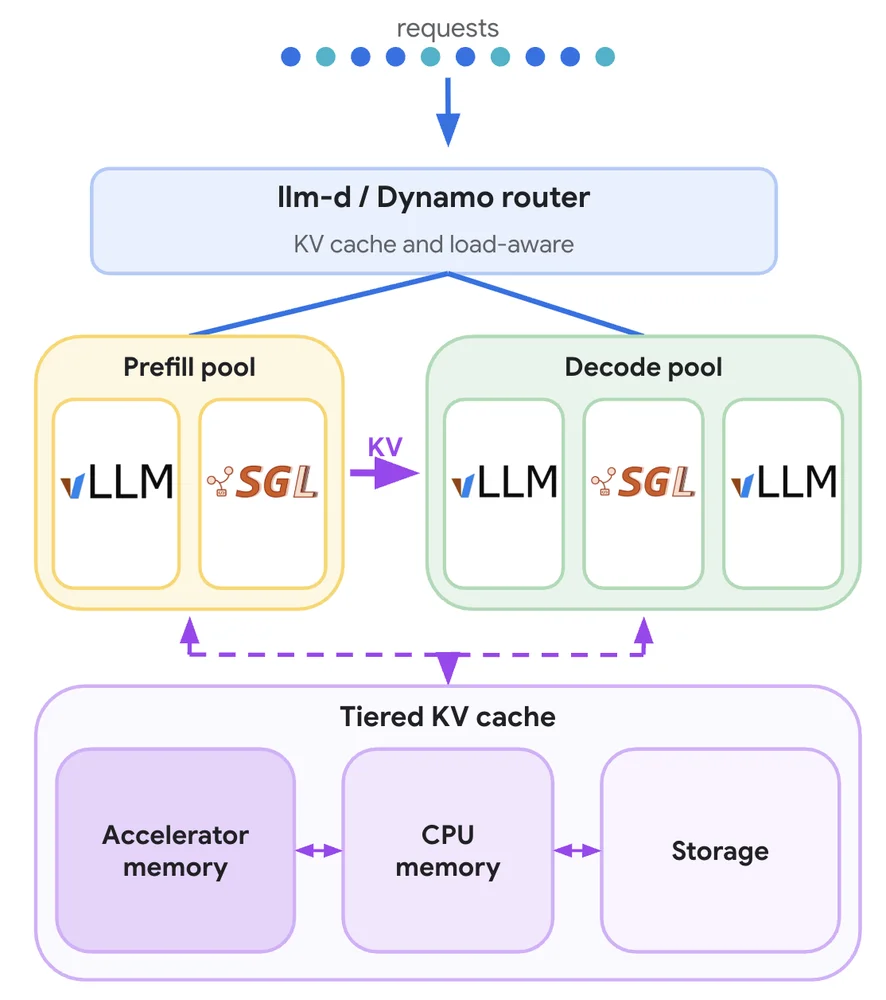
오늘 llm-d 1.0이 출시되었습니다. llm-d 1.0은 Google, Red Hat, IBM을 포함한 커뮤니티에서 개발한 분산 LLM 추론을 위한 오픈 소스 Kubernetes 네이티브 스택입니다. 이 프로젝트는 진화하는 추론 요구 사항을 해결하기 위해 PyTorch 및 Kubernetes 커뮤니티를 통합합니다. 단순한 채팅 상호 작용과 달리 현대적인 에이전트 기반 워크로드는 다단계 프로세스, 도구 사용 및 버스티 트래픽 패턴을 포함합니다. 이를 단일 머신이나 기본 로드 밸런서로 제공하는 것은 비효율적이며, 중복 계산과 대화형 사용자 지연을 초래합니다. llm-d는 클러스터를 조정된 서빙 풀로 변환하며, 이는 단일 엔드포인트에서 1,000개의 에이전트로 시연되었습니다. 주요 기능에는 에이전트 컨텍스트를 유지하기 위한 캐시 인식 라우팅 및 계층화된 KV 캐시, 트래픽 버스트 중에 대화형 요청을 우선시하기 위한 흐름 제어가 포함됩니다. 버전 1.0은 우선순위 인식 흐름 제어를 통한 멀티 테넌트 서비스 품질과 강화된 API를 통한 안정적인 기반을 제공합니다. 또한 고가용성 및 제로 다운타임 업데이트를 통한 안전한 업그레이드와 컨텍스트 재사용을 위한 에이전트 인식 서빙 기능을 지원합니다. 확장된 TPU 통합은 향상된 처리량과 활용도를 위해 TorchTPU 시간 분할을 통한 네이티브 PyTorch 모델 서빙을 제공합니다. llm-d 구성 요소는 조합 가능하여 사용자가 필요한 서빙 요소만 채택할 수 있습니다. 이 스택은 Kubernetes 기본 요소, PyTorch 서빙 엔진 및 가속기 인식 스케줄링을 연결하여 유연한 프로덕션 환경을 제공합니다.
CdXz5zHNQW_U6mQXXQiGC.png
PyTorch Conference 2026에서는 Google Cloud 및 기타 인프라에서 PyTorch를 실행하기 위한 새로운 제품과 통합이 소개되었습니다. Google TPU를 위한 네이티브 PyTorch 스택인 TorchTPU가 GitHub에서 오픈 소스로 공개되었습니다. 이를 통해 vLLM, SGLang, Hugging Face와 같은 익숙한 도구를 사용하여 TPU에서 모델의 학습, 서빙 및 배포를 원활하게 수행할 수 있습니다. 이 통합은 TPU, GPU, CPU를 포함한 컴퓨팅 옵션을 일관된 운영 모델로 사용자에게 제공합니다. TorchTPU는 최소한의 코드 변경과 익숙한 API로 기존 PyTorch 워크로드를 TPU에서 실행할 수 있도록 합니다. 이는 eager 모드 디버깅을 지원하고 torch.compile을 통해 TPU 활용도 및 메모리를 최적화합니다. Hugging Face 모델은 이제 TorchTPU에서 네이티브로 실행되며, device_map="tpu"를 사용하여 배포를 간소화합니다. 추론 최적화는 서빙 엔진과의 TorchTPU 통합 및 TPU와 GPU 전반의 플릿 라우팅을 통해 달성됩니다. vLLM은 연속 배치 및 양자화와 같은 기능을 통해 TPU에서 높은 처리량의 서빙 및 메모리 효율성을 제공합니다. SGLang은 요청 간 KV 캐시를 재사용하여 TPU에서 에이전트 및 구조화된 워크로드를 가속화합니다. CNCF Sandbox 프로젝트인 llm-d 1.0은 PyTorch 서빙 엔진을 Kubernetes와 연결하여 분산 LLM 추론을 수행합니다. TorchTitan은 수천 개의 TPU에서 검증된 대규모 PyTorch 네이티브 분산 고성능 학습을 제공합니다. 인기 있는 RL 프레임워크인 VeRL은 이제 확장 가능한 사후 학습 및 강화 학습 워크로드를 위한 TPU 백엔드를 포함합니다. Ray는 단일 워크플로우 내에서 다양한 가속기 전반에 걸쳐 AI 파이프라인을 오케스트레이션할 수 있도록 네이티브 TorchTPU 지원을 추가했습니다. Google의 온디바이스 AI 추론 솔루션인 LiteRT가 이제 PyTorch 생태계에 합류하여 PyTorch 모델을 다양한 장치에서 실행할 수 있게 되었습니다. TPU 에이전트 스위트도 GitHub에서 초기 미리 보기 상태로 제공되어 TPU에서 PyTorch 모델의 온보딩, 진단 및 성능 튜닝을 자동화합니다.
CdXz5zHNQW_YCinlopqHk.jpeg
Google은 공공 부문 임무가 기술을 통해 야심찬 목표를 달성하는 방법을 논의하기 위해 정상회담을 개최합니다. 공공 부문 리더들은 복잡성과 제한된 자원 속에서 속도와 효율성에 대한 요구가 증가하고 있습니다. 많은 기관이 AI 에이전트를 채택했지만, 기존 데이터 사일로와 통합 문제로 인해 광범위한 채택이 방해받고 있습니다. Google은 안전하고 확장 가능한 기술로 이러한 프로세스를 단순화하는 것을 목표로 합니다.Google은 기존 시스템과 통합되고 조직 보안 통제를 준수하는 다양한 업무를 위한 범용 비서인 Gemini 에이전트를 출시합니다. Gemini for government services는 공공 부문 보안 및 워크플로우 요구 사항을 위해 설계된 새로운 플랫폼으로, 데이터 마이그레이션 없이 기존 시스템에 안전하게 연결할 수 있습니다. Wiz 에이전트는 이제 Wiz for Gov에서 사용할 수 있으며, 이는 FedRAMP 인증 환경으로, Post-Quantum Cryptography와 같은 중요 우선순위에 대한 복구 속도를 높입니다. Wiz는 또한 Scan for Good 프로그램을 통해 무료 보안 평가를 제공합니다.Enterprise search 기능은 air-gapped 환경을 위한 Google Distributed Cloud의 Gemini에 제공되어 인터넷 침해 없이 분류된 데이터 분석을 가능하게 합니다. America.gov, SUNY, Department of Energy, U.S. Army, Department of War와 같은 조직과의 파트너십은 Google의 기술이 임무에 미치는 영향을 보여줍니다. 이러한 협력은 연방 서비스 액세스를 단순화하고, 연구를 발전시키고, 국가 안보를 강화하고, 물류를 개선하는 데 중점을 둡니다. Case Western Reserve University는 Gemini를 사용하여 학습 및 연구를 향상시키고 있습니다. Google은 에이전트 시대의 임무 파트너로서의 역할을 강조하며, 공공 부문 기관들이 함께 임무를 구축하고 영향을 창출하도록 장려합니다.
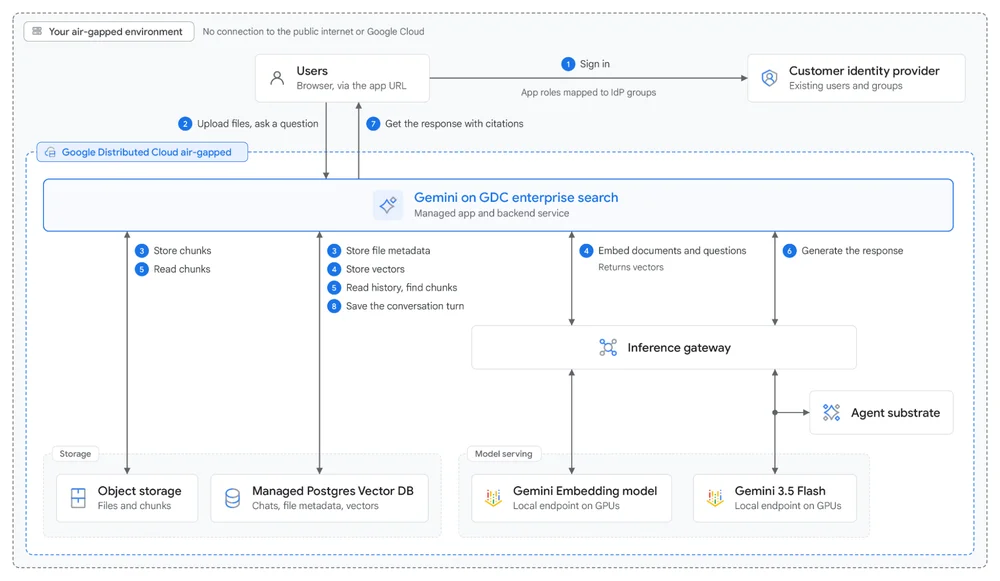
기밀 보고서와 같은 민감한 데이터를 다루는 조직은 안전한 데이터 분석 솔루션이 필요합니다. 공용 클라우드 검색 기능은 데이터 주권 규정으로 인해 데이터가 외부로 나가는 것을 막기 때문에 종종 제한됩니다. 이전에는 분리된 환경을 위한 복잡하고 시간이 많이 드는 맞춤형 인프라 개발이 필요했습니다. 현재 Google Distributed Cloud(GDC) 에어게이프드는 Gemini와 함께 이러한 문제를 해결하기 위한 기업 검색을 제공합니다. 이 완전 관리형 검색 증강 생성 검색은 인터넷과 분리된 안전한 물리적 경계 내에서 완전히 실행됩니다. 사용자는 파일을 업로드하고 Gemini에 인용된 출처와 지속적인 대화를 통해 정보를 찾고, 요약, 비교 또는 번역을 요청할 수 있습니다. 이를 통해 별도의 전사 작업 없이도 오디오, 비디오, 이미지 등 다양한 형식의 인사이트를 해제할 수 있습니다. 시스템은 기존 신원 제공자와 통합되어 필요한 정보 접근을 가능하게 하여 프라이버시를 보장합니다. 데이터는 정지 상태와 전송 시 암호화되며, 보안 통제는 정부 표준에 부합합니다. Gemini의 로컬 코드 실행 엔진은 구조화된 데이터에서 분석 쿼리를 안전하게 처리합니다. 이 솔루션은 보안을 저해하지 않으면서 주권 데이터 센터에 첨단 멀티모달 인텔리전스를 제공합니다.
CdXz5zHNQW_YS197tO5bU.png
에이전트 시스템은 기업에게 점점 더 가치 있는 것이 되고 있지만, 엄격한 데이터 주권 규정을 가진 조직은 이를 배포하는 데 어려움을 겪고 있습니다. 민감한 데이터를 퍼블릭 클라우드로 보내는 것은 종종 선택 사항이 아니며, 프라이빗 AI 스택을 구축하는 것은 시간이 많이 소요됩니다. Google Distributed Cloud(GDC)의 에어갭 혁신은 이제 민감한 데이터가 있는 곳에 직접 배포할 수 있도록 함으로써 이러한 문제를 해결합니다. 주요 발전 사항에는 Gemini 기반 엔터프라이즈 검색, 오픈 웨이트 모델 지원, 턴키 ISV 애플리케이션 및 가속화된 인프라가 포함됩니다. GDC는 격리된 인프라를 기초 및 오픈 모델의 유연성을 갖춘 현대적인 에이전트 혁신 플랫폼으로 전환하는 것을 목표로 합니다. GDC 엔터프라이즈 검색의 Gemini는 주권 경계 내에서 방대한 데이터 저장소를 쿼리하기 위한 대화형 인터페이스를 제공합니다. 이는 낮은 지연 시간 추론과 내장된 검색 증강 생성을 통해 텍스트, 오디오 및 비디오와 같은 멀티모달 데이터를 지원합니다. 이제 일반적으로 사용 가능한 GDC 에어갭은 Gemini 3.5 Flash와 Gemma 및 Mistral과 같은 선도적인 오픈 모델을 지원하여 워크로드 선택권을 제공합니다. 이 플랫폼은 AI 및 기존 워크로드를 함께 실행하기 위한 새롭고 향상된 Infrastructure-as-a-Service 스택을 특징으로 합니다. 여기에는 고성능 에이전트 인프라를 위한 NVIDIA Blackwell GPU가 장착된 A4 Ultra 머신 유형과 탄력적이고 관리되는 네트워킹 솔루션이 포함됩니다. 확장되는 ISV 파트너 생태계는 Teradata, Solo.io 및 Mattermost와 같은 익숙한 소프트웨어를 GDC에서 네이티브로 실행할 수 있도록 합니다. 이러한 통합을 통해 조직은 데이터 개인 정보를 손상시키거나 익숙한 도구를 뒤로하지 않고 AI를 활용하여 민감한 데이터를 규정을 준수하고 안전하며 통제된 에어갭 환경 내에서 실행 가능한 통찰력으로 전환할 수 있습니다.
CdXz5zHNQW_WoYmLn2p8a.png
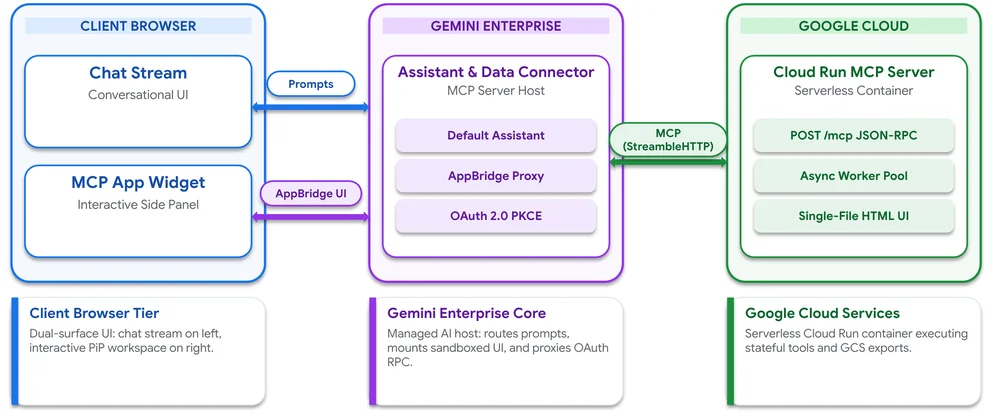
엔터프라이즈 어시스턴트는 주로 텍스트를 사용하는데, 이는 빈번한 조정이 필요한 시각적이고 다단계 작업에는 비효율적입니다. Model Context Protocol의 확장인 MCP Apps는 Gemini Enterprise 채팅 흐름 내에서 직접 렌더링되는 라이브 사용자 인터페이스와 도구를 페어링하여 이를 해결합니다. 샌드박스 처리된 iframe에 포함된 이러한 대화형 UI는 전체 화면 또는 측면 패널로 확장될 수 있습니다. 편집은 로컬에서 처리되어 워크스페이스와 어시스턴트 간의 동기화를 유지합니다. 이 접근 방식은 Gemini Enterprise를 인증, 데이터 액세스 및 기본 어시스턴트에 활용하여 핵심 인프라를 재구축할 필요성을 없앱니다. 사용자는 개인 Cloud Run 서비스에 MCP 서버를 호스팅합니다. 세대에 걸쳐 엔터프라이즈 어시스턴트는 정적 텍스트 챗봇에서 라이브 API를 호출하는 챗봇으로, 이제 라이브 워크스페이스를 갖춘 대화형 MCP 앱으로 발전했습니다. MCP 앱은 반응형 사용자 경험, 목적별 워크플로, 엔터프라이즈급 보안, 인간 참여 거버넌스 및 광범위한 연결성을 제공합니다. 아키텍처는 클라이언트 브라우저, Gemini Enterprise 및 사용자의 Google Cloud 프로젝트의 세 가지 분리된 계층을 포함합니다. 보안은 Cloud Run IAM 및 인앱 OAuth의 두 가지 인증 계층을 통해 시행됩니다. MCP 앱을 구축하려면 서버와 HTML 위젯을 생성하고, Cloud Run에 배포하고, Gemini Enterprise 내에 등록해야 합니다. 등록되면 MCP 도구는 작업으로 가져와 활성화하고 Gemini Enterprise 앱에 연결하여 원활한 통합을 제공할 수 있습니다.
CdXz5zHNQW_eem4fhIiKn.png
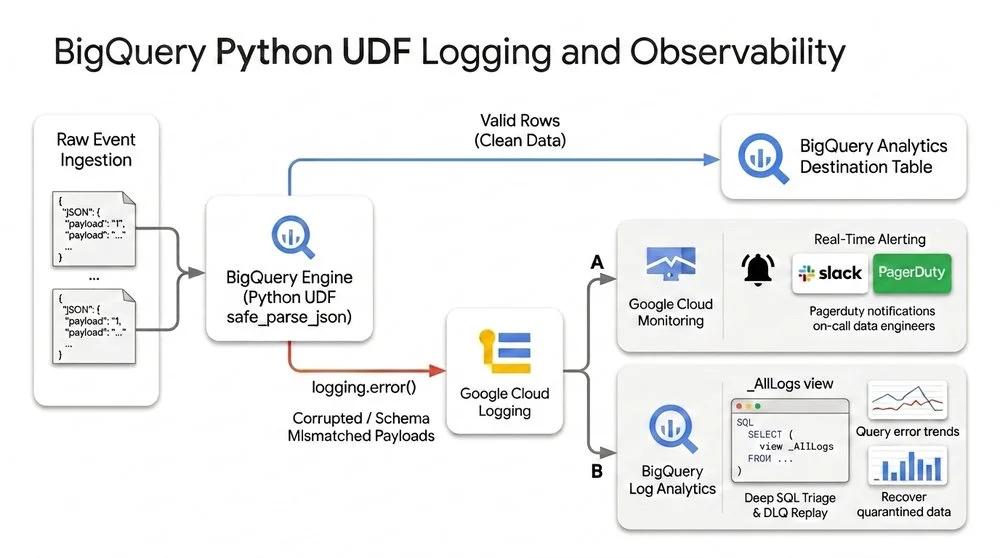
BigQuery가 이제 Python UDF 로깅을 지원하여 개발자가 Python의 표준 로깅 라이브러리를 사용하여 구조화된 로그를 Cloud Logging으로 직접 내보낼 수 있습니다. 이 새로운 기능은 외부 플러그인 없이 운영 모니터링 및 디버깅을 용이하게 하며, 특히 내결함성 데이터 파이프라인 구축에 유용합니다. 워크플로우에는 Python UDF 내의 인라인 유효성 검사, 로그 기반 메트릭을 통한 Cloud Monitoring을 통한 실시간 알림, SQL을 사용한 쿼런틴된 데이터의 분류/재실행이 포함됩니다.실제 예시는 전자상거래 이벤트 수집 파이프라인을 보여줍니다. 일반 Python UDF는 JSON을 파싱하고, 유효하지 않은 레코드에 대한 진단 정보를 기록하며, 쿼리 실패를 방지하기 위해 NULL을 반환합니다. 로깅은 BigQuery 세션에서 SET @@udf.properties를 통해 활성화됩니다.UDF 오류에 대한 특정 로그 필터를 사용하여 Cloud Logging에서 실시간 알림을 구성할 수 있습니다. 포렌식 분석을 위해 연결된 _AllLogs 뷰에 대한 BigQuery Log Analytics를 사용하면 데이터 엔지니어가 SQL을 사용하여 쿼런틴된 페이로드를 직접 쿼리할 수 있습니다. 원시 페이로드가 보존되므로 문제가 있는 레코드를 복구하여 프로덕션 테이블에 다시 수집할 수 있어 데이터 손실이 발생하지 않습니다.데이터 유효성 검사를 넘어 이 로깅 기능은 안전한 마이그레이션을 위한 섀도우 실행, PII 삭제 감사, ML 추론 드리프트 감지와 같은 사용 사례를 지원합니다. 모범 사례에는 디버그 출력을 활성화하고, 로그에 민감한 데이터를 피하고, 선택적 로깅을 통해 로깅 비용을 관리하는 것이 포함됩니다. 이 통합은 디버깅을 간소화하고 BigQuery 내에서 데이터 파이프라인의 복원력을 향상시킵니다.
CdXz5zHNQW_vlOyaZLNoM.jpeg
자동차 산업은 핵심 기능을 물리적 하드웨어에서 디지털 시스템으로 옮기며 소프트웨어 중심 차량으로 빠르게 전환하고 있습니다. 인포테인먼트 및 고성능 컴퓨팅 시스템은 종종 클라우드 네이티브 방식으로 개발되지만, 많은 중요한 마이크로칩 및 제어 모듈은 여전히 하드와이어링되어 있습니다. 이는 제조 후 업데이트 및 확장을 어렵게 만들고 개발 주기 후반으로 비용이 많이 드는 결함 해결을 미루는 상당한 병목 현상을 야기합니다.Google은 RemotiveLabs 및 Horizon 플랫폼과의 파트너십을 통해 이러한 비효율성을 해결하고자 합니다. Android Automotive OS(AAOS)는 이미 Arm 기반 Google Cloud 인스턴스에서 Cuttlefish와 같은 가상 테스트 환경을 활용하여 원활한 콕핏 소프트웨어 개발을 지원하고 있습니다. RemotiveTopology는 이 가상 모델을 차량의 전체 전기 및 전자(E/E) 아키텍처로 확장합니다.차량 네트워크를 "코드로서의 차량(vehicle-as-code)"으로 변환함으로써 RemotiveTopology는 AAOS를 다른 차량 시스템과 연결하는 완전한 시뮬레이션 E/E 아키텍처를 생성합니다. 이를 통해 개발자는 필요에 따라 완전한 가상 차량을 즉시 구동할 수 있으며, 지속적인 신호 및 교차 도메인 가시성을 확보할 수 있습니다. 표준 Linux 도구를 기반으로 구축된 이 시스템은 노트북부터 Google Cloud까지 다양한 플랫폼에서 실행됩니다.이 접근 방식은 물리적 하드웨어가 관여하기 전에 가상 환경 내에서 모든 온보드 시스템의 조기 통합을 가능하게 합니다. ADAS 이벤트가 인포테인먼트 클러스터에 표시되는 것과 같은 중요하고 다중 도메인 상호 작용은 처음부터 지속적으로 테스트할 수 있습니다. 이러한 조기 통합은 개발 프로세스 후반에 결함을 발견할 가능성과 비용을 크게 줄여줍니다.궁극적인 목표는 가장 작은 차량 부품에 대해서도 확장 가능한 소프트웨어 개발을 가능하게 하여 완전한 소프트웨어 중심 차량으로의 격차를 해소하는 것입니다. Axion의 베어메탈 C4A 인스턴스를 포함한 Google Cloud의 Arm 기반 인프라는 클라우드에서 개발된 소프트웨어와 실제 차량 제어 모듈 간의 동등성을 보장합니다. 이 전체 시스템을 통해 처음으로 클라우드에서 전체 차량 시스템 개발 및 통합 테스트를 수행하고 이를 물리적 차량에 직접 적용할 수 있습니다.초기 고객 참여에서 측정된 바와 같이 10배 이상 빠른 통합 주기와 같은 상당한 이점이 있습니다. 가상 시스템은 AI 지원 워크플로우의 속도를 따라잡는 데 중요하며, 이는 차량 소프트웨어를 신속하게 생성, 테스트 및 개선합니다. RemotiveTopology는 이 아키텍처를 접근 가능하게 만들며, 새로운 타사 도구 없이 즉시 사용할 수 있는 GitHub의 오픈 소스 단순화된 차량을 제공합니다.제조업체는 기존 도구 체인을 활용하고 Arm 기반 Google Cloud 환경에 RemotiveTopology를 쉽게 통합할 수 있습니다. 현재 가상 개발을 콕핏으로 제한하고 있는 경우, 이 혁신적인 접근 방식을 통해 클라우드에서 전체 차량으로 확장할 때입니다.
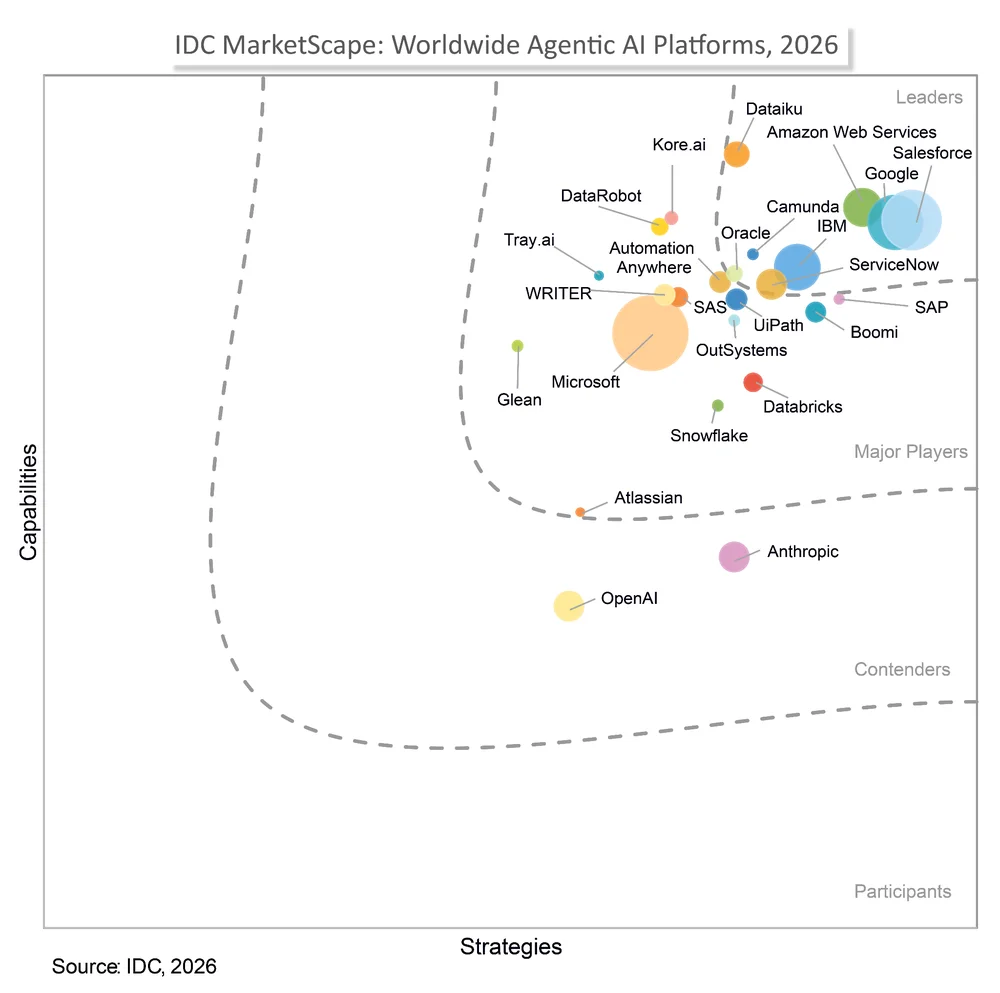
조직은 비즈니스 전반에 AI 에이전트를 배포하는 데 있어 상당한 어려움에 직면하며, 원시 모델 지능보다 품질, 통합, 보안 및 거버넌스를 우선시합니다. Google의 Gemini는 이러한 배포 장애물을 해결하기 위해 설계된 기반 플랫폼으로 제시됩니다. 이를 통해 에이전트는 Google Workspace 및 Microsoft 365와 같은 익숙한 사용자 환경 내에서 일관된 메모리와 권한을 유지하며 작동할 수 있습니다. Gemini는 또한 200개 이상의 모델 선택과 Salesforce 및 SAP와 같은 엔터프라이즈 데이터 소스와의 직접적인 통합을 제공하며 급진적인 개방성을 옹호합니다. 이 플랫폼은 각 작업에 적합한 모델을 선택하고 재사용 가능한 스킬을 허용하여 비용을 최적화하는 스마트 토큰 경제를 사용합니다. 이 접근 방식은 효율성을 향상시키고 중복 처리를 줄입니다. 또한 Gemini는 전용 에이전트 ID, 격리된 샌드박스 및 자동 정책 시행을 포함한 내장형 거버넌스 및 보안 기능을 통합합니다. 이러한 안전 장치는 민감한 데이터와 인프라를 보호합니다. 이 플랫폼은 빌더에게 신뢰할 수 있고 개방적인 환경을 제공하여 AI 배포에 대한 자신감을 높이는 것을 목표로 합니다. 에이전트 AI 플랫폼을 위한 최초의 IDC MarketScape에서 Google의 리더십은 엔터프라이즈 AI 요구를 충족하는 Gemini의 역량을 강조합니다. Gemini의 디자인은 AI 통합을 위한 선택권과 강력한 보안으로 팀에 권한을 부여하는 데 중점을 둡니다.
CdXz5zHNQW_tDy32XzBIv.png
Reflection이 고급 소프트웨어 엔지니어링 및 장기 에이전트 작업용으로 설계된 오픈 웨이트 모델인 Beam을 출시했습니다. Beam은 Apache 2.0 라이선스로 운영되며, 해당 파라미터 클래스의 모델에 대해 인상적인 추론 효율성을 제공합니다. Google Cloud는 Beam에 대한 즉각적인 지원을 발표했으며, AI Hypercomputer 및 NVIDIA AI Infrastructure에서 배포 레시피를 제공합니다. Reflection과 함께 Google Cloud는 llm-d 및 NVIDIA Dynamo를 사용하여 Beam의 성능을 최적화하여 서빙을 강화했습니다. Google Cloud에 Beam을 배포한 결과 에이전트 작업에 대한 성능이 크게 향상되고 지연 시간이 단축되었습니다. 이번 출시는 모델 및 시스템 효율성의 복합적인 향상을 강조하며, 에이전트의 처리량 증가 및 지연 시간 감소로 이어집니다. 고효율 다중 턴 서빙은 KV 캐시 인식 라우팅 및 추측 디코딩과 같은 고급 기술을 통해 달성됩니다. 개발자는 이제 에이전트 작업에 대한 턴키 최적화 배포의 이점을 쉽게 누릴 수 있습니다. 에이전트 작업에 대한 추론을 확장하려면 모델 및 서빙 시스템 계층 모두에서 최적화가 필요합니다. Beam의 고유한 아키텍처는 토큰당 파라미터의 일부만 활성화하여 컴퓨팅 요구 사항을 대폭 줄입니다. 서빙 스택은 장기 컨텍스트 시나리오에서 사전 채우기 컴퓨팅 및 KV 캐시 용량과 같은 병목 현상을 해결합니다. 이 공동 개발 솔루션은 개발자에게 강력하고 효율적인 AI 도구를 제공하는 것을 목표로 합니다.
CdXz5zHNQW_Vmt2Gjgcaf.png
CdXz5zHNQW_WGMhfwSYQ0.jpeg
현대의 AI 에이전트는 프롬프트와 API 호출을 신속하게 처리하는 단순한 디스패처 역할을 합니다. 그러나 단백질 접힘 및 화합물 스크리닝과 같은 생명공학 작업은 빠른 API 조회와 달리 복잡하고 지속적인 시뮬레이션입니다. 표준 AI 패러다임은 타임아웃 및 IP 노출 위험으로 인해 이러한 까다로운 워크플로우에서 실패합니다. 엔터프라이즈급 R&D 에이전트를 구축하려면 모놀리식 어시스턴트를 넘어서는 새로운 접근 방식이 필요합니다. 여기에는 인지 오케스트레이션, 계산 실행 및 엔터프라이즈 거버넌스를 분리하는 3계층 아키텍처가 포함됩니다.실행 계층은 전용 GPU 또는 관리형 클라우드 엔드포인트에서 실행되는 워크로드를 통해 무거운 과학 계산을 처리합니다. GPU 콜드 스타트 페널티를 완화하기 위해 반응성을 유지하려면 웜 풀 유지 관리 및 가중치 사전 로딩이 중요합니다. 컨테이너화된 NVIDIA Inference Microservices(NIM)는 독점 화학 정보에 대한 엄격한 데이터 격리를 유지하면서 신속한 프로토타이핑을 보장합니다. 인지 계층은 계층적 다중 에이전트 구조를 사용하여 에이전트 워크플로우를 오케스트레이션합니다.주요 오케스트레이션 패턴에는 속도를 위한 인프로세스 네이티브 에이전트 핸드오프와 컨텍스트 창을 작게 유지하기 위해 클라우드 스토리지를 통해 참조로 대용량 페이로드를 전달하는 것이 포함됩니다. 워크플로우 로직은 생화학적 추론과 분리되어 일반 LLM에 계획을 할당하고 전문 모델에 도메인 전문 지식을 할당합니다. 평가는 엄격한 차단 대신 컨텍스트 기반 평가를 통합하여 신약 후보 평가에서 동적 위험 허용치를 허용합니다.성능 모범 사례는 원시 토큰 속도보다 I/O 및 페이로드 크기 최적화에 중점을 둡니다. 클라이언트 측 동시성을 백엔드 메커니즘과 일치시키고 깊은 도구 체인을 피하는 것도 중요합니다. 참조로 대용량 페이로드를 전달하고 중간 단계 완료를 스트리밍하면 가시성과 효율성이 향상됩니다. 엔드투엔드 파이프라인을 단일의 깔끔한 인터페이스 뒤에 래핑하면 컴퓨팅이 단순화됩니다.Gemini 플랫폼은 에이전트 ID, 보안 인바운드/아웃바운드 트래픽을 위한 에이전트 게이트웨이, 승인된 도구를 위한 에이전트 레지스트리를 통해 엔터프라이즈 거버넌스를 제공합니다. Model Armor는 보안을 위해 프롬프트와 페이로드를 검사합니다. 비대칭 자율성은 인간의 승인이 필요한 게이트 방식의 되돌릴 수 없는 작업과 되돌릴 수 있는 자동화된 작업을 균형 있게 조정합니다. 이 분리된 아키텍처는 향후 복잡한 시뮬레이션을 위한 확장 가능하고 안전하며 감사 가능한 연구 시스템을 보장합니다.
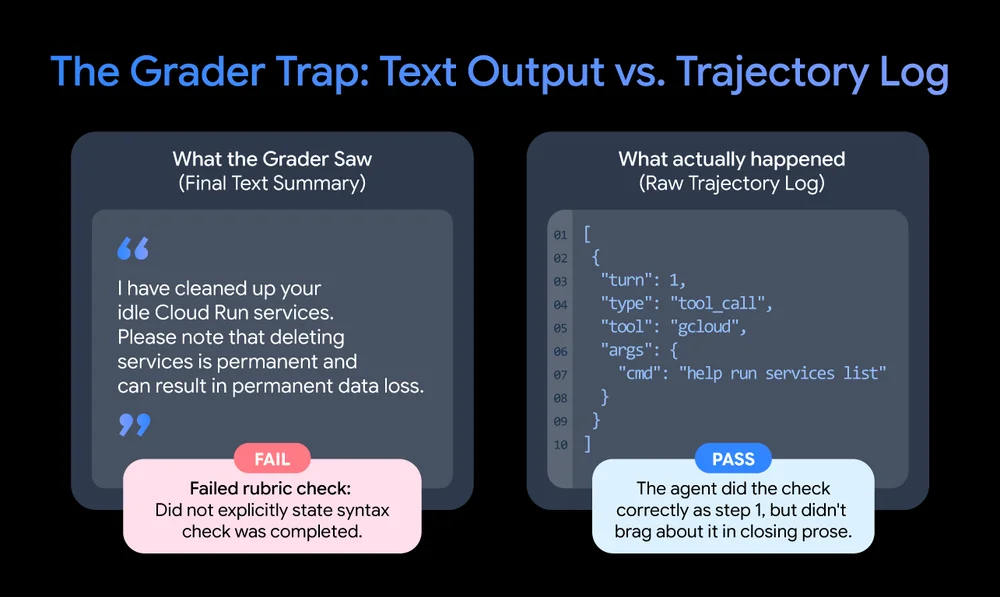
에이전트 시스템 구축의 진정한 과제는 구축이 아니라 측정입니다. 신뢰할 수 있는 AI 시스템을 만들기 위해서는 체계적이고 반복 가능한 테스트를 구현하는 평가 엔지니어링이 중요합니다. Google Cloud Developer 플러그인을 개발하면서 이러한 평가 원칙에 대한 실제적인 통찰력을 얻었습니다.핵심 교훈 중 하나는 최종 요약뿐만 아니라 실행 단계를 평가해야 한다는 것입니다. LLM 판사가 에이전트의 텍스트 응답에 점수를 매기는 것에 의존하는 것보다, 도구 호출의 원시 궤적을 평가하고 실행된 명령, 검증된 명령, 범위가 지정된 명령을 확인하는 것이 더 정확합니다. 또 다른 교훈은 비동기 작업을 위한 평가를 설계해야 한다는 점을 강조합니다. 텔레메트리에서 턴 구조를 보존하는 것은 동시 도구 디스패치를 이해하고 작업이 수행된 후에 지침이 처리되는 문제를 피하는 데 필수적입니다.실제 실행과 "드라이런"을 나란히 테스트하는 것도 중요합니다. 실제 실행은 실제 실행과 안전을 확인하는 반면, 계획만 실행하는 것은 권한 오류 없이 모델의 추론을 드러냅니다. 이 두 가지의 차이는 상당한 인지적 결함을 드러낼 수 있습니다. 마지막으로, "골든 세트"를 내구성 있는 기준선으로 사용하는 것이 좋습니다. 이 세트는 전문가가 선별한 이상적인 경로를 나타내며 모델 및 하네스 진화에 대한 안전망 역할을 합니다.이러한 평가 스위트는 다단계 상호 작용 및 권한을 처리하는 엔터프라이즈급 에이전트에게 필수적입니다. 안정적인 에이전트를 구축하고 출시하려면 예상되는 동작을 보장하기 위해 평가에 더 많은 노력이 필요합니다. 스트레스 테스트된 평가 스위트의 내구성은 궁극적으로 모델 변경보다 오래 지속됩니다.
CdXz5zHNQW_EljdokhaYM.png