AI 시대를 위한 인프라: 에이전트의 동적 용량 관리
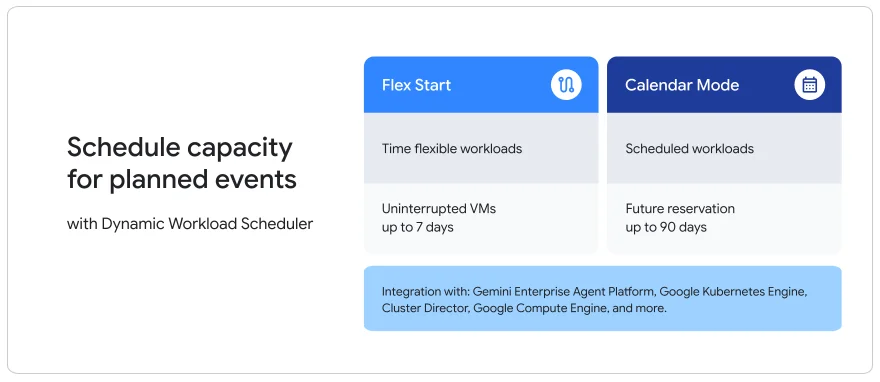
인터넷의 확장과 모바일 기기는 인간과 함께 일하는 자율 AI 에이전트의 새로운 시대를 열었습니다. 이러한 AI 워크로드는 리소스 집약적이고 버스티(bursty)한 특성으로 인해 비용 및 인프라 요구 사항을 관리하는 것이 중요하며, 잠재적인 활용도 저하로 이어질 수 있습니다. 조직은 인프라 투자를 최적화하고 엔터프라이즈 및 AI 애플리케이션 모두에 대해 예측 가능한 비용과 성능을 보장하기 위해 동적 용량 관리 전략이 필요합니다. 여기에는 예측 가능한 수요를 위한 리소스 확보와 예상치 못한 변경에 대한 자동화된 응답이 포함됩니다.한 가지 핵심 전략은 Dynamic Workload Scheduler를 사용하여 계획된 이벤트에 대한 용량을 예약하는 것입니다. 이는 지연 시간에 민감한 배치 작업의 비용 최적화를 위한 "flex-start 모드"와 미션 크리티컬하고 시간 제한이 있는 이벤트 동안 보장된 용량을 위한 "캘린더 모드"를 제공합니다. 또 다른 중요한 측면은 모든 애플리케이션에 대한 장애 조치 계획을 통해 서비스 연속성을 유지하는 것입니다. 여기에는 Google Compute Engine의 컨테이너화되지 않은 워크로드에 대한 관리 인스턴스 그룹(MIG)을 사용하여 자동화되고 우선 순위가 지정된 하드웨어 장애 조치 목록을 정의하여 애플리케이션이 대체 컴퓨팅 옵션으로 자동 전환할 수 있도록 하는 것이 포함됩니다.컨테이너화된 워크로드의 경우 Google Kubernetes Engine(GKE)은 전체 용량 관리 수명 주기를 자동화하는 적응형 제어 플레인을 제공합니다. GKE의 사용자 지정 ComputeClasses는 여러 VM 제품군, 크기 및 영역 및 소비 모델 전반에 걸친 확장을 동적으로 결합하는 다차원 장애 조치 목록을 설계할 수 있도록 합니다. GKE는 또한 동적 리소스 할당을 제공하여 애플리케이션이 정확한 하드웨어 매개변수를 정의할 수 있도록 함으로써 전체 GPU 또는 TPU 대신 필요한 하드웨어 "슬라이스"만 할당하여 활용도를 극대화하고 비용을 절감합니다.인프라 제약을 극복하려면 예측 가능한 수요를 위한 리소스 확보와 예측 불가능한 수요를 위한 자동화 구축이라는 두 가지 접근 방식이 필요합니다. 이 결합된 전략은 계획된 이벤트에 대한 사전 예약된 용량을 보장하는 동시에 수동 개입 없이 인프라가 예기치 않은 변경에 적응할 수 있도록 합니다. 90%의 기업이 에이전트 배포를 계획하고 있지만 17%만이 현재 IT 설정에 확신을 가지고 있기 때문에 아키텍처 유연성이 가장 중요합니다. 이는 전문화된 인프라뿐만 아니라 실행 비효율성을 해결하기 위한 지능적인 활용 전략도 필요로 합니다.동적 인프라 구현을 시작하려면 조직은 즉각적인 비용 절감을 위해 워크로드를 감사하고, 단일 VM 제품군 또는 영역에 긴밀하게 결합된 애플리케이션을 식별하고, 실행 가능한 대체 하드웨어 모양을 매핑해야 합니다. 최소 지출을 약속하면 약정 사용 할인(committed use discounts)을 통해 크게 할인된 가격을 이용할 수도 있습니다. 마지막으로 맞춤형 용량 관리 전략을 수립하고 자동화된 장애 조치 목록을 구성하기 위해 Google Cloud 계정 팀과 협력하는 것이 좋습니다.