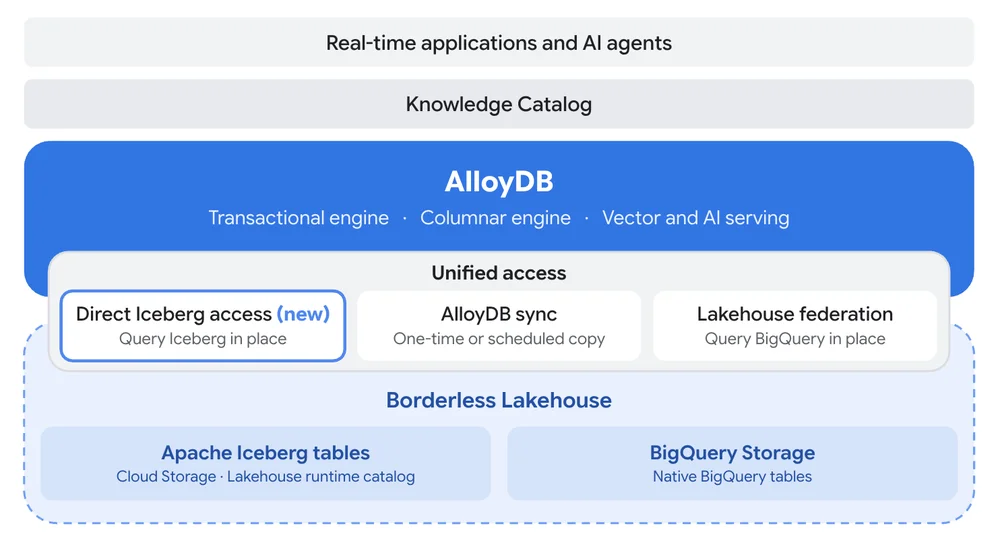
AlloyDB for PostgreSQL에서 직접 Iceberg 액세스를 통해 운영 및 Lakehouse 데이터를 통합
효과적인 의사결정을 위해 기업은 실시간 운영 데이터와 과거 분석 데이터를 모두 필요로 합니다. 전통적으로 분리되어 있던 이러한 데이터 시스템이 이제 통합되고 있으며, 이는 PostgreSQL용 AlloyDB의 새로운 기능으로 대표됩니다. Google Cloud는 직접 Iceberg 액세스를 도입하여 개발자가 클라우드 스토리지의 Apache Iceberg 테이블을 AlloyDB에서 직접 쿼리하고 단일 SQL 쿼리에서 실시간 데이터와 조인할 수 있도록 합니다. 현재 미리 보기 상태인 이 통합은 다른 서비스에 비해 집계 쿼리에 훨씬 빠릅니다.또한, AlloyDB sync 및 Lakehouse federation이 이제 일반적으로 사용할 수 있게 되어 "경계 없는 Lakehouse"와 상호 작용하는 세 가지 주요 방법을 제공합니다. 직접 Iceberg 액세스는 AlloyDB의 컬럼 엔진을 활용하여 가속화하면서 Iceberg 테이블을 제자리에서 읽습니다. AlloyDB sync는 BigQuery에서 Lakehouse 데이터를 AlloyDB로 복사하여 낮은 지연 시간으로 자주 액세스되는 워크로드를 처리하며, 사용자 정의 일정에 따라 새로 고쳐집니다. Lakehouse federation은 AlloyDB가 네이티브 BigQuery 테이블을 직접 쿼리할 수 있도록 하여 BigQuery가 처리를 담당합니다. 이러한 통합은 사용자 정의 파이프라인의 필요성을 없애고 애플리케이션 및 AI 에이전트가 통합된 운영 및 Lakehouse 데이터에 원활하게 액세스할 수 있도록 합니다.실제 사례로는 사기 탐지, 개인화 및 동적 가격 책정이 있으며, 여기서 Lakehouse의 과거 컨텍스트는 데이터베이스의 실시간 결정에 정보를 제공합니다. 데이터 팀은 또한 큐레이션된 테이블을 Iceberg에 한 번 게시하여 여러 애플리케이션이 제자리에서 읽을 수 있도록 할 수 있습니다. 직접 Iceberg 액세스를 통해 다른 PostgreSQL 테이블과 마찬가지로 Iceberg 테이블을 등록하고 쿼리할 수 있으며, 내장 지원 및 컬럼 엔진의 이점을 누릴 수 있습니다. AlloyDB sync는 지속적으로 변경되지 않는 데이터에 대한 매우 낮은 지연 시간 읽기 요구를 충족하기 위해 AlloyDB에 로컬에서 새로 고칠 수 있는 복사본을 만듭니다. Lakehouse federation은 BigQuery에 방대한 과거 데이터가 있는 조직을 대상으로 하며, 처리를 BigQuery로 푸시 다운하고 결과만 반환합니다. 통합 선택은 데이터 위치, 애플리케이션 읽기 패턴 및 지연 시간 요구 사항에 따라 달라집니다.