AWS S3, Bedrock KnowledgeBase, OpenSearch Serverless, IAM을 사용한 Terraform으로 RAG 구현
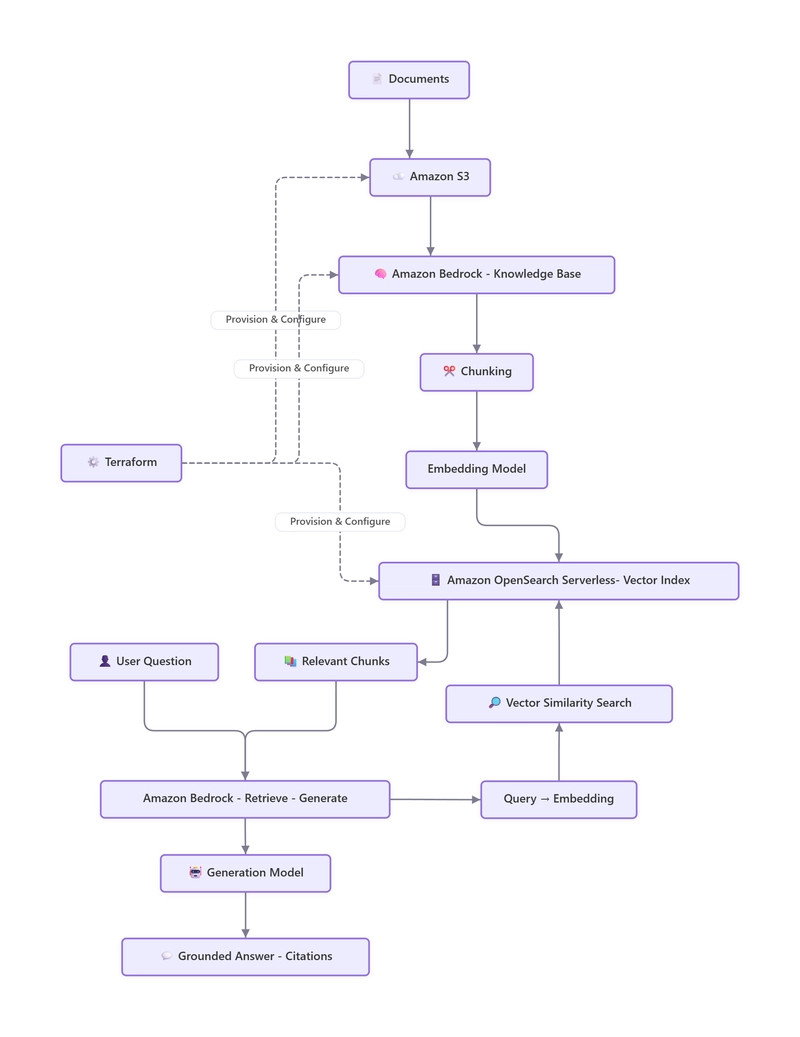
이 게시물은 Terraform, S3, Bedrock Knowledge Bases 및 OpenSearch Serverless를 사용하여 AWS에서 Retrieval-Augmented Generation (RAG) 시스템을 구현하는 과정을 자세히 설명합니다. RAG는 대규모 언어 모델(LLM)이 외부 지식 소스를 활용하여 답변을 생성할 수 있도록 하여 정확도를 향상시킵니다. RAG 프로세스는 수집(ingestion)과 질의(querying)의 두 가지 주요 단계로 구성됩니다. 수집 단계에서는 S3의 문서가 분할(chunked)되고 Bedrock에 의해 수치 임베딩으로 변환되어 OpenSearch Serverless에 저장됩니다. 질의 단계에서는 사용자의 질문이 임베딩으로 변환되고, OpenSearch에서 관련 문서 조각이 검색되며, 이를 LLM의 컨텍스트로 사용하여 출처가 명시된 답변을 생성합니다.이 시스템은 문서 소스로 Amazon S3를 사용하고 수집 파이프라인 관리를 위해 Amazon Bedrock Knowledge Bases를 활용합니다. OpenSearch Serverless는 벡터 데이터베이스로 구성되며, 임베딩을 위한 knn_vector 필드와 효율적인 유사도 검색을 위한 FAISS를 사용한 HNSW를 사용합니다. OpenSearch 인덱스는 원본 텍스트와 메타데이터도 저장하여 벡터, 어휘 및 메타데이터 필터링 검색을 지원합니다. 코사인 유사도는 벡터 비교에 사용됩니다. Terraform 스크립트는 IAM 역할, S3 버킷, Bedrock Knowledge Base 구성 및 OpenSearch Serverless 액세스 정책을 포함한 AWS 인프라를 정의합니다. Streamlit 애플리케이션은 S3에 문서를 업로드하고, 지식 기반 동기화를 트리거하며, RAG 시스템에 쿼리를 제출하기 위한 사용자 인터페이스를 제공합니다. 이 포괄적인 설정은 사용자 정의 RAG 시스템 구축을 위한 실용적인 시작점을 제공합니다.