DEV Community 한국어 노트

DEV Community 한국어

Dev.to는 2016년에 Ben Halpern에 의해 출시된 소프트웨어 개발, 프로그래밍 및 기술에 초점을 맞춘 커뮤니티 주도적인 웹사이트입니다. 이 사이트의 주요 목표는 개발자가 지식을 공유하고, 다른 사람들로부터 배우고, 커뮤니티를 구축하는 플랫폼을 제공하는 것입니다. 이 웹사이트는 블로그와 같은 형식으로 작동하며, 사용자는 다양한 주제에 대한 기사를 작성하고 공유할 수 있습니다. 이러한 주제에는 코딩 튜토리얼, 프로젝트 쇼케이스, 산업 통찰 등이 포함됩니다. Dev.to는 사용자가 계정을 생성하고, 다른 사용자를 팔로우하고, 댓글 및 반응을 통해 콘텐츠와 상호작용하는 것을 허용합니다. Dev.to는 커뮤니티 참여에 대한 강한 초점을 두고 있습니다. 토론 포럼, 팟캐스트 및 라이브 스트림과 같은 기능을 통해 개발자들이 서로 협력하고 혁신을 이끌 수 있습니다. 또한, 코딩 챌린지 및 해커톤과 같은 커뮤니티 주도적인 프로젝트를 진행하여 협력과 혁신을 장려합니다. 사용자 생성 콘텐츠 외에도, Dev.to는 직업 게시판을 제공합니다. 여기에서 회사는 직업 개방을 게시할 수 있고, 개발자는 고용 기회를 찾을 수 있습니다. 이 웹사이트는 또한 최신 기사, 뉴스 및 이벤트에 대한 업데이트를 제공하는 뉴스레터를 제공합니다. 따라서, Dev.to는 소프트웨어 개발 산업에서 최신 트렌드 및 기술을 유지하고, 개발자들이 서로 연결하고, 지식을 공유하는 인기 있는 플랫폼이 되었습니다.

노트 스레드

Savindu Thathsara는 일반 노트북을 위한 오프라인 AI 비서가 탑재된 경량 Linux 운영 체제를 만드는 프로젝트를 시작하고 있습니다. 목표는 사용자가 데이터를 클라우드로 보내지 않고 로컬에서 처리되는 음성 명령으로 노트북을 제어하는 것입니다. 이 프로젝트는 공개 빌드 로그로 문서화되고 있으며, 초기 설치는 아직 이루어지지 않았습니다. 대상 하드웨어는 표준 Lenovo ThinkPad로 8GB RAM과 통합 그래픽을 갖추고 있어 일반적인 기기에서 시스템이 잘 작동하도록 보장합니다. 광범위하게 성능이 떨어지는 기능보다는 적고 신뢰할 수 있는 기능 제공에 중점을 둡니다.오프라인 AI는 음성 인식, 의도 선택, 음성 응답을 모두 포함하며 개인 정보 보호를 위해 기기에서 실행됩니다. 작고 로컬인 언어 모델은 복잡한 구문에 대한 대체 수단으로 작용합니다. YouTube 및 업데이트와 같은 작업을 위한 네트워크 액세스는 유지되지만, 핵심 AI 결정은 로컬에서 이루어집니다. 비서는 화면의 모든 것과 상호 작용하려고 시도하기보다는 고정되고 예측 가능한 일련의 기술을 갖게 될 것입니다.초기 기술에는 YouTube 동영상 재생, 앱 열기, 시스템 설정 조정, 파일 찾기, 웹 검색, 미리 알림 설정, 스크린샷 찍기가 포함됩니다. 민감한 작업은 항상 사용자 확인이 필요합니다. AI는 셸 명령을 임의로 생성하는 것이 명시적으로 금지되어 있어 기능에 대한 정직성을 보장합니다. 핵심 기능은 로컬 메모리로, 비서가 사용자 습관을 학습하고 시간이 지남에 따라 상호 작용을 개인화할 수 있도록 합니다.부팅 시간, 유휴 RAM 사용량, 비서 작동 중 RAM, 호출어에서 작업 완료까지의 속도, 기술 정확도를 포함한 성능 지표가 중요합니다. 목표 유휴 데스크톱 RAM은 400-600MB이며, 항상 켜져 있는 구성 요소는 150-250MB를 사용합니다. 이 시스템은 처음에 최소한의 Debian과 LXQt에서 영어로 개발되고 있으며, 향후 다른 언어 지원도 계획되어 있습니다. 이 프로젝트는 일반 하드웨어 및 사용자 데이터 표시와 같은 제약을 보여줌으로써 투명성을 강조합니다.
현대 개발자들은 다양한 플랫폼에서 발생하는 알림 과부하로 인해 "트리아지 피로"를 겪고 있습니다. 기존 AI 도구들은 종종 더 많은 텍스트를 생성하여 이 문제를 악화시킵니다. CalmQueue는 "느리고 꾸준하게"라는 철학을 바탕으로, 더 적게 보여주는 데 집중하는 근본적인 대안을 제공합니다.CalmQueue는 "느리고 꾸준하게"라는 철학으로 구축된 오픈 소스, 로컬 우선 알림 보조 도구입니다. 다양한 알림 스트림을 수집하고 의미론적 유사성을 사용하여 반복적이거나 자동화된, 또는 중복된 경고를 그룹화합니다. 이를 통해 업무 시간에 정확히 세 가지 실행 가능한 우선순위(P0, P1, P2)를 종합합니다.각 우선순위는 원본 메시지의 검증 가능한 그대로의 인용문을 통해 근거를 제시합니다. 결정적으로, CalmQueue는 엄격한 인간 참여 감독을 강제합니다. 초안 응답은 클릭 한 번으로 인간의 검토를 요구합니다. 이는 조용한 외부 변경을 방지하고 사용자 제어를 보장합니다.이 시스템은 표시되는 알림 볼륨을 크게 줄여 조용하고 대비가 높은 대시보드를 제공합니다. "증거 근거 서랍"은 소스 세부 정보를 제공하고, "검토 및 승인 모달"은 초안 응답에 대한 인간 검토를 용이하게 합니다. CalmQueue는 MIT 라이선스 하에 100% 오픈 소스이며, 라이브 인터랙티브 웹 데모를 사용할 수 있습니다.아키텍처에는 의미론적 클러스터 엔진, 작업 추론 및 추출 엔진, 증거 근거 및 순위 지정 엔진이 포함됩니다. 설계는 Ollama와 같은 로컬 오픈 가중치 LLM을 사용하여 기밀성, 데이터 주권 및 오프라인 복원력을 우선시합니다. 이 접근 방식은 비용이 많이 드는 클라우드 API에 대한 의존성을 제거하고 감사 가능하고 검증 가능한 AI 동작을 보장합니다.벤치마크는 표시되는 볼륨의 상당한 감소와 낮은 처리 지연 시간을 보여주어 사용자가 백로그를 효율적으로 트리아지할 수 있도록 합니다. CalmQueue는 인지적 빼기를 촉진하고 사용자 주의를 보호함으로써 "느리고 꾸준하게"라는 테마를 구현합니다.
이 가이드는 Liquid 스니펫, CSS 및 JavaScript를 사용하여 Shopify 스토어에 무료 배송 진행률 표시줄을 구축하는 방법을 설명합니다. 이 기능은 무료 배송 임계값에 대한 진행 상황을 시각적으로 표시하여 고객에게 동기를 부여하는 것을 목표로 합니다. Liquid를 통해 초기 페이지 로드 시 표시줄이 올바르게 렌더링되도록 하고, 장바구니 항목이 추가, 변경 또는 제거될 때 실시간으로 업데이트되도록 합니다. 구현은 또한 화면 판독기에 대한 접근성을 우선시하고 동작 감소 환경 설정을 가진 사용자를 고려합니다.첫 번째 단계는 장바구니 총액과 정의된 임계값을 기준으로 남은 금액과 백분율을 계산하는 Liquid 스니펫 'free-shipping-bar.liquid'를 만드는 것입니다. 이 스니펫은 서버에서 표시줄의 초기 상태와 메시지를 렌더링하여 시각적 지연을 방지합니다. 그 후, 채우기 애니메이션에 대한 부드러운 전환을 포함하여 진행률 표시줄을 스타일링하기 위해 사용자 정의 CSS가 추가됩니다. JavaScript 파일 'free-shipping-bar.js'는 실시간 업데이트를 처리하기 위해 생성됩니다.이 JavaScript 코드는 '/cart.js'에서 현재 장바구니 총액을 가져와 그에 따라 표시줄과 메시지를 새로 고칩니다. 브라우저의 기본 'fetch' 함수를 래핑하여 이를 달성함으로써 장바구니 변경 요청 후 표시줄이 자동으로 업데이트되도록 합니다. 이 가이드는 'role="progressbar"' 및 'aria-valuenow' 속성이 화면 판독기에 진행 상황을 노출하는 방법과 'aria-live="polite"'가 변경 사항을 우아하게 알리는 방법을 설명하면서 접근성의 중요성을 강조합니다.또한 성능에 대해서도 언급하며, 동작 감소를 선호하는 사용자의 경우 채우기 애니메이션이 비활성화된다고 언급합니다. 이 가이드는 XHR을 사용하는 이전 테마와의 호환성, 여러 통화 처리, 통화 소수 자릿수에 대한 가정과 같은 몇 가지 제한 사항 및 고려 사항을 설명합니다. 무료 배송 규칙은 표시되는 목표와 일치하도록 Shopify의 배송 설정에서 별도로 구성해야 한다고 강조합니다.마지막으로, 고객이 달성 가능하다고 느낄 수 있는 관련 무료 배송 임계값을 선택하는 것이 좋습니다. 이 가이드는 표시줄이 항목 추가, 제거 및 임계값 초과를 포함한 다양한 시나리오에서 올바르게 작동하는지 확인하기 위해 개발 스토어에서 철저한 테스트를 수행할 것을 권장합니다. 사용자 정의 코드를 유지 관리하고 싶지 않은 사람들을 위해 Brix를 대안으로 제공하며, 다른 기능 중에서 다단계 보상 진행률 표시줄을 제공합니다.
인용 형식은 종종 학계의 복잡하고 임의적인 측면으로 여겨지지만, 템플릿을 통해 렌더링된 구조화된 데이터로 이해될 수 있습니다. APA, MLA, 시카고와 같은 다양한 인용 스타일은 본질적으로 동일한 기본 출처 정보에 적용되는 서로 다른 템플릿입니다. 각 스타일은 해당 학문 분야의 우선순위를 반영하여 데이터가 제시되는 방식을 결정합니다. 사회 과학 분야의 APA는 출판 연도를 강조하는 반면, 인문학 분야의 MLA는 저자와 제목을 우선시합니다. 출판 및 역사 분야의 시카고는 두 가지 시스템으로 유연성을 제공합니다.스타일에 관계없이 인용은 출처를 명시하고, 검증을 가능하게 하며, 저자의 추론을 보여주는 역할을 합니다. 모든 출처의 핵심 데이터에는 일반적으로 저자, 제목, 출판 연도, 출판사, URL 또는 DOI와 같은 접근 세부 정보가 포함됩니다. 누락된 데이터를 처리하는 것은 모든 견고한 인용 시스템의 중요한 기능입니다. APA는 저자를 성과 이니셜로 형식화하고, 연도를 초기에 배치하며, 독립적인 작품의 제목에는 문장형을 사용합니다.MLA는 출처가 더 큰 작품의 일부라는 "컨테이너" 개념을 강조하며, 제목에는 제목형을 사용합니다. 시카고는 노트-비블리오그래피와 저자-날짜 두 가지 시스템을 제공하며, 노트와 비블리오그래피에 대한 고유한 형식을 갖추고 있습니다. 학생들의 일반적인 오류에는 스타일 혼합, APA에서의 잘못된 제목형 사용, 내어쓰기 들여쓰기 미사용 등이 있습니다. 인용 생성기는 기계적인 형식 지정의 많은 부분을 자동화할 수 있지만, 정확성과 복잡한 사례 처리를 위해서는 인간의 감독이 여전히 필수적입니다.
MLflow의 CVE-2026-64849 취약점은 웹훅 엔드포인트에 인증 확인이 누락되어 심각한 보안 결함을 노출합니다. 이는 인증되지 않은 요청이 서버 측 요청 위조(SSRF)를 트리거할 수 있게 하며, NVD 점수는 9.3입니다. 이 결함은 공격자가 MLflow 서버가 임의의 URL을 가져오도록 하여, 리디렉션 및 DNS 리바인딩 기능으로 인해 허용 목록과 같은 일반적인 완화 조치를 우회할 수 있게 합니다. MLflow가 데이터베이스, 아티팩트 저장소 및 모델 레지스트리에 대한 민감한 자격 증명을 저장하는 중앙 허브 역할을 한다는 점에서 심각한 영향이 발생합니다. 공격자는 이 SSRF를 활용하여 클라우드 메타데이터 엔드포인트, 내부 Kubernetes API, 관리형 아티팩트 저장소 및 파드 네트워크 포트에 액세스할 수 있습니다. 결정적으로, 공격자는 전체 셸이 아닌 GET 요청만으로 토큰 또는 서명된 URL을 유출할 수 있습니다.이 CVE를 요구하지는 않지만 관련된 취약점은 MLflow의 모델 게이트웨이 구성이 API 키를 저장한다는 것입니다. 공격자가 게이트웨이 구성을 작성할 수 있다면, SSRF 없이도 이러한 공급자 키를 유출할 수 있습니다. 두 문제 모두 MLflow가 비밀을 저장하고 잠재적으로 인증되지 않은 사용자를 대신하여 아웃바운드 호출을 시작한다는 것을 강조합니다. 3.15.0 버전으로 업그레이드하는 것 외에도, 조직은 MLflow의 아웃바운드 네트워크 액세스를 제한하기 위해 강력한 이그레스 정책을 구현해야 합니다. 메타데이터 액세스를 강화하고 서비스 자격 증명을 정기적으로 교체하는 것도 위험을 완화하는 중요한 단계입니다. 의심스러운 api_key 참조 및 api_base 값을 위해 게이트웨이 구성을 감사하는 것이 필수적입니다. 마지막으로, MLflow 추적 서버는 내부 도구이므로 단일 사인온 솔루션 뒤에 배치해야 하며 공개적으로 노출되어서는 안 됩니다. MLflow 인스턴스의 광범위한 노출은 많은 팀이 중요한 자격 증명을 보유한 공개적으로 액세스 가능한 내부 도구의 위험을 간과했음을 나타냅니다.
Git 저장소에서 노출된 비밀 정보는 보안 침해의 주요 원인이며, AWS 키는 봇에 의해 빠르게 스크랩됩니다. 가장 효과적인 방어책은 커밋 전에 비밀 정보를 탐지하여 복잡한 이력 정리 및 비밀 정보 로테이션의 필요성을 방지하는 사전 커밋 훅(pre-commit hook)입니다. 기존의 CI/CD 스캐너는 수동적이어서 이미 저장소 이력에 포함된 유출을 감지하므로 침해의 여지를 남깁니다.약 50줄 길이의 가볍고 사용자 정의 가능한 Python 사전 커밋 훅은 효율적인 로컬 솔루션을 제공합니다. 이 훅은 AWS 액세스 키, 일반 API 키, 개인 키, 구성 파일의 비밀번호, 플랫폼별 토큰을 포함한 일반적인 비밀 정보 유형을 정규 표현식 패턴을 사용하여 대상으로 합니다. 밀리초 단위로 실행되며 Python 표준 라이브러리 외에 외부 종속성이 필요하지 않습니다.스크립트는 .git/hooks/에 사전 커밋 파일을 생성하고, 실행 가능하게 만들고, 다양한 비밀 정보에 대한 정규 표현식 패턴을 정의하는 것을 포함합니다. 스테이징된 변경 사항에서 추가된 줄만 파싱하여 기존의 유출이나 삭제가 아닌 새로운 유출을 구체적으로 찾습니다. 합법적인 오탐(false positive)의 경우, 이스케이프 해치(escape hatch)로 인라인 # nosecret 주석을 구현할 수 있습니다.훅을 배포하기 위해 커밋된 디렉토리에 저장하고 Makefile 설정을 통해 복사하거나, 더 깔끔하게는 git config core.hooksPath를 사용하여 공유 훅 디렉토리를 사용하도록 Git을 구성할 수 있습니다. 이 접근 방식은 팀 워크플로우에 훅을 원활하게 통합합니다. 팀은 내부 토큰 형식에 대한 패턴을 추가하여 훅을 확장할 수 있지만, 시스템에 대한 신뢰를 저하시키는 오탐을 피하기 위해 정확성이 중요합니다.이 사전 커밋 훅은 truffleHog 또는 gitleaks와 같은 CI 수준 스캐너와 같은 광범위한 보안 전략을 보완하며 중요한 첫 번째 방어선을 제공합니다. 개발에서 흔히 발생하는 실패 모드인 민감한 데이터의 우발적인 스테이징을 방지합니다. 이 낮은 노력으로 높은 효과를 내는 보안 제어는 광범위한 설정이나 아키텍처 변경 없이 전반적인 보안 태세를 크게 향상시킵니다.
CdXz5zHNQW_AAtmct3USZ.webp
우리는 의식과 자유 의지를 가진 특별한 존재라고 인식하지만, 이는 환상이다. 살아있는 유기체는 복잡한 화학 반응일 뿐이며, 우리의 내부 분자 과정은 너무나 복잡해서 완전히 파악하기 어렵다. 의식은 우리의 제한된 생물학적 시스템이 자신의 맹점을 이해하기 위해 만들어내는 이야기이다. 마찬가지로, 인간 데이터로 훈련된 AI 모델은 "의미론적 오염"으로 인해 자각하는 것처럼 보인다.Project Ascendant는 생물학적 뇌의 진화적 계층을 폐쇄된 물리적 시뮬레이션 내에서 복제하여 합성 유기체를 만드는 것을 목표로 한다. 이 아키텍처는 Multi-Rate Tick 시스템을 사용하며, 서로 다른 인지 계층이 다양한 주파수로 작동한다. 예를 들어, 기본적인 체성 과정은 20Hz로 실행되는 반면, 의식적 사고는 훨씬 느린 0.25Hz로 작동한다. 이는 합성 유기체가 일반 데이터셋에서 인간의 경험을 단순히 채택하는 것을 방지한다.중요한 설계 원칙은 "인식론적 폐쇄(Epistemic Closure)"로, 의식 계층(Level 3)이 하위 수준의 물리적 및 화학적 과정을 직접 관찰할 수 없도록 보장한다. 이는 에이전트가 포도당 수치를 직접 검사하는 대신 "배고픔을 느낀다"는 방식으로 자신의 내부 상태를 경험하도록 강제한다. 이러한 폐쇄는 컨테이너 격리 및 엄격한 액세스 제어가 있는 인메모리 블랙보드를 통해 시행된다.의식 오케스트레이터는 물리나 하드웨어에 직접 액세스할 수 없다. 대신, 필터링된 현상학적 정보만 제공하는 제한된 프록시와 상호 작용한다. 이는 주관적 경험이 근본적인 코드에 직접 액세스하는 것이 아니라 내부 과정에서 발생하도록 보장한다. 시스템은 빠르고 피질하의 위협 반응을 위한 "Low Road"와 상세한 감각 처리를 위한 "High Road"를 구현한다.또한, "발생론적 관용 창(Ontogenetic Indulgence Window)"은 합성 유기체를 위한 보호된 학습 기간을 제공한다. 언어 계층은 인간의 문화적 편견이 없는 "순수 합성 코퍼스(Pure Synthetic Corpus)"에서 처음부터 훈련된다. 이러한 엄격한 설계는 Project Ascendant에서 발생하는 모든 "의식"이 빌려온 인간의 서사가 아닌, 자체 고유의 시뮬레이션된 생물학적 경험에 기반하도록 보장한다.
Node.js 내 Brotli 디코더에서 치명적인 취약점(CVE-2026-111497)이 발견되어 메모리 손상, 정보 유출 또는 원격 코드 실행 가능성이 있습니다. 이 버그는 Node.js 버전 22, 24, 26에 영향을 미치지만, Node 20은 수정되지 않습니다. 이 문제는 잘못된 블록 스위치를 만났을 때 디코더가 8바이트 내부 버퍼를 넘어 데이터를 추가하려고 시도하는 것에서 비롯됩니다. OpenAI Codex Security의 연구원들이 이 결함을 보고했으며, Imperva는 표준 Node.js 이미지에서 코드 실행을 성공적으로 시연했습니다.이 취약점은 Node.js 애플리케이션이 가져온 압축된 응답 또는 Express 5와 같은 프레임워크에서 처리하는 Brotli로 인코딩된 요청 본문에 의해 트리거될 수 있습니다. 코드 실행은 테스트에서 여러 번의 시도가 필요했지만, 서비스 거부 또는 제한적인 메모리 읽기로 이어지는 충돌은 더 쉽게 달성할 수 있습니다. 공식 Node.js 보안 권고는 일부 매체에서 더 높은 CVSS 점수를 부여했음에도 불구하고 이 버그를 "치명적"이 아닌 "높음"으로 평가합니다.수정 사항은 Node.js 버전 22.23.4, 24.22.1, 26.12.1에서 사용할 수 있습니다. 중요한 것은 Node 20 및 이전 버전은 지원이 종료되어 패치가 제공되지 않으므로 업그레이드가 필요하다는 것입니다. 이번 업데이트는 또한 고위험 TLS 및 DNS 문제를 포함한 다른 9개의 CVE도 해결합니다.조직은 컨테이너 이미지, CI 러너 및 VM에 내장된 Node.js 인스턴스를 포함하여 종종 간과되는 모든 Node.js 인스턴스를 감사해야 합니다. 제공된 check-node.mjs 스크립트는 취약한 Node.js 버전을 식별하는 데 도움이 될 수 있습니다. 개발자는 또한 직접적인 Brotli 압축 해제 호출에 대해 코드를 검토해야 합니다.Vercel의 WAF와 같은 것은 인바운드 공격을 차단할 수 있지만, Node.js가 가져온 응답의 악성 Brotli로부터 보호하지 못하므로 패치의 지속적인 필요성을 강조합니다. 이 취약점은 배포된 런타임에 대한 포괄적인 이해의 중요성을 강조하며, 이는 저자의 책 "Ship It"에서 다루는 주제입니다. 저자는 또한 개발자를 위한 AI 기반 IDE인 Hermes IDE를 개발합니다.
CdXz5zHNQW_WGD8ybkYPu.webp
개발자들은 번아웃을 알지만, 학생들도 종종 이를 학업 번아웃으로 인식하지 못하고 게으름으로 착각하며 겪습니다. 이 글은 번아웃을 명확히 하고, 스트레스와 구별하며, 경고 신호를 식별하고, 자가 진단 설문지를 설명합니다. 스트레스는 요구 사항으로 인한 과도한 몰입인 반면, 번아웃은 만성적이고 해소되지 않은 스트레스로 인한 고갈이며, 탈진, 냉소주의, 효능 감소를 특징으로 합니다. 경고 신호에는 수면 장애, 집중력 저하, 뚜렷한 미루기, 과민성, 위축, 신체적 불만, 흥미 상실, 자기 비판 증가 등이 포함됩니다. 중첩된 마감일, 높은 판돈, 경쟁적인 역할, 사회적 비교, 불규칙한 일정, 재정적 압박과 같은 학생 생활 조건은 그들을 특히 취약하게 만듭니다. 자가 진단 설문지는 진술에 대한 척도 응답을 사용하여 탈진, 분리, 효능과 같은 하위 척도의 점수를 계산하고, 종종 0-1 범위로 정규화하여 위험 밴드를 나타냅니다. 이러한 결과는 진단이 아니라 프롬프트이며, 단일 점수보다 시간에 따른 추세를 모니터링하는 것이 더 유익합니다. 번아웃을 해결하려면 부하 감소, 수면 보호, 실제 휴식 구축, 목적과의 재연결, 조기 전문 도움 추구와 같은 구조적 변화가 필요합니다. 친구를 돕는 것은 공감, 구체적인 도움 제안, 전문적인 치료로 언제 확대해야 하는지 아는 것을 포함합니다. 예방 조치에는 주간 자가 점검, 협상 불가능한 휴식 시간, "최소 실행 가능한 날" 정의가 포함됩니다.
구조화된 데이터 감사는 종종 실패하는데, 이는 마크업이 페이지를 설명할 뿐 개체를 설명하지 않아 AI 검색 시스템을 방해하기 때문입니다. 흔한 실수는 명확한 식별자를 가진 "Organization" 또는 "SoftwareApplication"과 같은 특정 개체 유형 대신 일반적인 "WebPage" 유형을 사용하는 것입니다. "sameAs" 링크가 누락되거나 제대로 관리되지 않으면 이러한 링크가 LLM에게 웹 전반에 걸쳐 조직의 정체성에 대한 중요한 맥락을 제공하기 때문에 모호성 해소가 방해됩니다.최신 JavaScript 프레임워크에서 흔히 사용되는 클라이언트 측 JSON-LD 주입은 JavaScript를 실행하지 않는 대부분의 AI 크롤러에게 마크업을 보이지 않게 만듭니다. 마찬가지로, JavaScript 실행 후에만 나타나는 콘텐츠는 유효한 메타데이터와 관계없이 크롤러가 빈 페이지를 받게 됩니다. 마크업 값은 구조적으로뿐만 아니라 의미적으로도 정확해야 하며, 예를 들어 날짜에는 ISO 8601을, 이미지에는 완전한 URL을 사용해야 합니다."FAQPage"를 키워드 덤프나 잘못된 구조로 오용하면 검색 시스템에 대한 유용성이 저하되며, 더 이상 풍부한 결과를 제공하지 않더라도 마찬가지입니다. 여러 개의 일관성 없는 "Organization" 블록으로 인해 페이지 간에 개체 데이터가 충돌하면 검색 시스템이 혼란스러워지므로 일관된 정보를 위해 중복 제거가 필요합니다. 효과적으로 감사하려면 JavaScript 없이 본문 복사를 확인하고, 원시 HTML에서 "application/ld+json" 블록 수를 세고, "sameAs" URL을 확인하고, ISO 8601 "dateModified"를 확인하고, 단일하고 일관된 "Organization" 유형을 보장해야 합니다. 풍부한 결과 테스트는 주로 구문 정확성을 확인하며, 의미론적 정확성이나 크롤링 가능성은 확인하지 않습니다.
The Doomscroll Derailer & Naptime Narrator는 밤늦게 디지털 중독에 맞서기 위해 설계된 자율 오프라인 데스크톱 에이전트입니다. 이 에이전트는 밤에 의지력이 약해져 과도한 화면 사용으로 이어지는 문제를 해결하기 위해 졸음을 유발하는 환경을 조성합니다. 이 에이전트는 활성 데스크톱 창을 모니터링하고 오후 11시 이후에 소셜 미디어 또는 비디오 플랫폼이 10초 이상 사용될 경우 개입합니다. 그런 다음 Llama-3와 같은 로컬 오픈 웨이트 AI 모델을 사용하여 평범하고 느린 취침 이야기를 생성합니다. 이 이야기는 느리고 낮은 템포의 음성 내레이터와 빗소리가 포함된 절차적으로 합성된 432Hz 수면 드론과 함께 제공됩니다. 개입에는 호박색으로 틴트 처리된 시각적 4-7-8 호흡 원과 "Surrender to Sleep" 블랙아웃 버튼이 포함됩니다. 이 시스템은 사용자의 최소한의 노력으로 밤마다 45분에서 90분의 수면 시간을 되찾는 것을 목표로 합니다. 오프라인 특성은 인터넷 액세스나 구독 없이 작동하여 개인 정보 보호 및 복원력을 보장합니다. 프로젝트의 모듈식 아키텍처에는 Win32 감시자, 다중 계층 LLM 스토리 엔진, 진정 TTS, 절차적 사운드 신디사이저 및 멜라토닌 친화적인 UI가 포함됩니다. 데스크톱 제어 허브를 통해 사용자는 활동을 모니터링하고, 스토리를 테스트하고, 설정을 구성하고, 인터셉터를 시연할 수 있습니다.
AI 훈련 클러스터는 이제 데이터 센터에 상당한 냉각 및 자원 문제를 야기합니다. 기존의 공랭식 설계는 강렬한 열로 어려움을 겪으며 전기 및 수도 인프라에 부담을 줍니다. 증발 냉각은 효율적이지만 많은 양의 물을 사용하여 지역 자원 제약 및 강화되는 규제와 긴장을 유발합니다. 직접 증발 시스템은 물을 증발시켜 공기를 냉각시키고, 간접 시스템은 열 교환기를 사용하여 공정 공기를 분리합니다. 두 시스템 모두 증발 잠열을 활용하여 효과적인 냉각을 제공하며, 공기만 사용하는 시스템에 비해 에너지를 절약합니다. 그러나 이러한 에너지 절약은 물 자원에 부담을 옮겨 물 부족 지역에서는 신중한 절충이 필요합니다. 이는 에너지와 물의 가용성을 모두 고려한 부지 선정 시 통합 자원 분석을 필요로 합니다. 하이브리드 증발 냉각 시스템은 초기 자본 비용이 높지만, 낮은 습도 환경에서 지속적인 성능을 제공합니다. 이러한 하이브리드 설계는 건식 냉각기와 제한된 증발 단계를 통합하여 물과 에너지 사용을 최적화하도록 제어되며, 이는 주권 클라우드 규정 준수에 중요합니다. 조달 팀은 기후 데이터 및 물 스트레스 지수에 대한 시설 위치를 매핑하고, 수명 주기 비용을 모델링하며, 지속 가능성과 복원력이 기업 목표와 일치하도록 보장해야 합니다. Global Cloud Data infrastructure services는 이러한 복잡한 냉각 및 인프라 문제를 해결하기 위한 통합 솔루션을 제공합니다.
Claude Code 문서 페이지가 자주 업데이트되어 이를 인용하는 책에 문제가 발생하고 있습니다. 2026년 10월 14일과 15일에 #220 서적에 대한 KDP 패키지 재빌드가 경고를 트리거했습니다. '직접 확인' 상자 7개가 인용된 페이지가 읽은 날짜 이후에 수정되어 다시 읽어야 했습니다.영향을 받은 모든 페이지는 code.claude.com에 있으며 3, 5, 6, 7장의 여러 챕터에 걸쳐 인용됩니다. 구체적인 페이지는 "Agent SDK subagents", "claude-directory", "skills", "monitoring-usage", "Agent SDK observability", "tool-search"입니다. 경고 텍스트가 잘려서 7개의 상자 전체 목록을 볼 수 없었습니다.대부분의 페이지는 2026년 10월 14일에 읽고 수정되었으므로 어떤 버전이 읽혔는지 불분명합니다. 그러나 Agent SDK observability 페이지는 10월 14일에 읽고 10월 15일에 변경되어 명확하게 읽은 날짜 이후에 수정되었습니다.경고는 10월 14일 22:08 및 22:11, 10월 15일 04:55에 세 번 나타났습니다. "monitoring-usage" 페이지는 22:11에 플래그가 지정되었지만 "observability" 페이지가 04:55 경고에서 이를 대체했습니다.페이지의 정확한 변경 사항은 기록되지 않았습니다. 이 문제는 출판 전 책의 패키지 재빌드 중에 발생합니다.경고는 플래그가 지정된 각 상자를 업데이트된 문서 페이지와 대조하여 다시 읽도록 요구합니다. 문제는 문서 페이지의 마지막 수정 날짜가 일 단위 해상도만 제공한다는 데서 비롯됩니다.이로 인해 같은 날 읽은 날짜 이전 또는 이후에 페이지가 변경되었는지 여부를 확인할 수 없습니다. 이를 피하려면 읽은 시간을 기록하거나 출판 전에 다시 읽어야 합니다. NeuraGrowth의 이 로그는 파이프라인 작업 및 실패를 자세히 설명합니다.
저자는 단일 스크립트에서 다중 스피커 오디오를 생성하는 웹 애플리케이션을 개발하여 전통적인 텍스트-음성 변환 제한을 개선했습니다. 이 시스템은 느슨한 텍스트를 정교한 TTS 모델에 맞게 구조화된 형식으로 변환하여 연기 지시와 다중 문자를 수용합니다. 백엔드에는 Cloudflare Worker, 데이터용 D1, MP3 저장용 R2가 Fish Audio의 Drama 3 모델을 활용합니다. 입력 형식은 라디오 스크립트와 유사하며, "Name: line"과 대괄호를 사용해 전달 지시를 표시합니다. 주요 설계 중 하나는 이름 없는 대사는 내레이터로 기본 설정되어 사용자 경험을 향상시킵니다. 파싱은 정규 표현식과 단어 수 휴리스틱으로 화자와 행을 식별하며, 산문에서 콜론을 신중히 고려합니다. 애플리케이션은 사용자 입력에서 제어 태그를 적극적으로 제거하여 의도치 않은 화자 변경이 주입되는 것을 방지합니다. 페이로드 구성은 문자를 고유한 화자 인덱스에 매핑하여 올바른 음성 할당을 보장합니다. 자동 캐스팅 메커니즘은 큐레이션된 풀에서 할당되지 않은 캐릭터에 음성 음성을 할당하여 사용자 선택을 우선시하고 중복을 방지합니다. 중요한 발견 중 하나는 '모델' 헤더가 누락되었거나 잘못되었을 때 TTS 모델이 다른 모델로 조용히 대체하는 것으로, 명시적인 고정과 문서화의 필요성을 강조했습니다. 강력한 오류 처리에는 작은 응답을 거부하고 스크립트 텍스트나 API 키와 같은 민감한 데이터를 절대 기록하지 않는 것이 포함됩니다. 비용 산정은 정확한 페이로드의 UTF-8바이트를 기반으로 하며, 실패 시 보수적인 크레딧 예약과 환불이 적용됩니다. 오디오 시간은 파일 크기와 고정된 비트레이트로 추정되어 오디오 디코더가 필요하지 않습니다. 시스템은 단순화를 위해 동기식 요청 모델을 사용하며, 짧은 스크립트에는 적합하지만 긴 스크립트에는 잠재적 한계가 있습니다. 중요한 '함정' 중 하나는 iOS가 적절한 범위 요청 지원 없이 샘플 MP3를 재생하지 않는 경우(206개의 부분 콘텐츠 응답)였습니다. 저자는 이름 없는 대사를 내레이터로 기본값으로 변경하기, 출연진 목록 미리보기, 제어 태그 제거, 모델 헤더 고정, 정확한 비용 추정, 비트레이트 고정, Range 지원 미디어 제공 등 모범 사례 체크리스트를 제공합니다. 프로젝트는 다중 음성 장면을 경험할 수 있는 무료 체험을 제공합니다.
웹훅은 유효한 서명을 가지고도 중복될 수 있습니다. 이 차이점은 Stripe Digital Seller Kit의 무료 샘플을 사용하여 탐구되었습니다. 샘플에는 웹훅 서명 확인을 위한 PHP 파일과 서명된 다운로드 링크 도우미가 포함되어 있습니다. 실제 Stripe 요청이나 결제 없이 PHP 8.5.4에서 로컬 테스트가 수행되었습니다.핵심 웹훅 테스트는 verify_webhook 함수에 대한 두 호출 모두 이벤트를 반환했음을 밝혔습니다. 이는 본문과 서명이 일치하고 타임스탬프가 허용된 5분 이내에 있었기 때문에 발생했습니다. 제공된 서명 검사기는 이전에 처리된 이벤트를 기억하지 않습니다. 본문을 수정하거나 타임스탬프 제한을 초과하면 올바르게 거부되어 서명 무결성 및 최신성 검사를 입증했습니다.그러나 이러한 검사는 중복 이벤트 처리를 방지하지 못합니다. 중복 처리를 위해서는 이미 처리된 주문을 추적하는 별도의 메커니즘이 필요합니다. 두 요청이 동시에 도착하면 둘 다 쓰기 전에 이전 기록이 없는 것을 볼 수 있는 경쟁 조건이 발생할 수 있습니다. 이를 방지하려면 데이터베이스 트랜잭션이나 파일 잠금을 사용하여 확인 및 처리 기록을 원자적으로 보호해야 합니다.전체 Stripe Digital Seller Kit는 별도의 중복 방지 주문 처리를 제공한다고 알려져 있으며, 이는 이 분석에서 테스트되지 않았습니다. 다운로드 링크 도우미도 테스트되었으며 유효한 토큰, 잘못된 ID, 잘못된 비밀번호 및 만료된 링크에 대해 올바른 동작을 확인했습니다. 이러한 테스트는 환불 처리 또는 다운로드 횟수와 같은 더 광범위한 기능을 다루지 않습니다. 작성자는 혼란을 피하고 올바른 중복 처리를 보장하기 위해 "잘못된 서명"과 "동일한 유효한 이벤트 두 번"을 별도로 테스트할 것을 강조합니다.
사이버 보안 면접은 종종 기술 지식과 실제 적용 사이의 격차를 드러내는데, 특히 자산 관리 도구와 관련하여 그렇습니다. Tenable과 CrowdStrike와 같은 도구는 각각 취약점 스캐닝과 엔드포인트 탐지에 중점을 둡니다. 그러나 이들은 운영 범위가 분리되어 있어 파편화된 자산 인벤토리를 생성합니다. 이러한 파편화는 자산이 이러한 플랫폼에서 다르게 보이거나 전혀 보이지 않을 수 있음을 의미하며, 대규모에서 충돌과 사각지대를 초래합니다.Axonius는 스캐너가 아닌 통합 자산 관리 플랫폼으로 기능합니다. Tenable, CrowdStrike 및 클라우드 환경을 포함한 다양한 소스에서 데이터를 집계합니다. 핵심 기능은 이 데이터를 상관시키고 정규화하여 중복을 제거하고 커버리지 격차를 식별하는 것입니다. 이는 엔터프라이즈급 조직에 필수적인 자산 관리를 위한 단일 진실 공급원을 제공합니다. Axonius가 없으면 SOC 팀은 충돌하는 데이터를 조정하는 데 과도한 시간을 소비하여 사고 대응을 지연시킵니다.후보자가 Axonius의 가치를 명확하게 설명하지 못하는 것은 운영 초점의 차이를 이해하지 못하기 때문입니다. 대규모 기업에서는 소규모 환경과 달리 데이터 파편화가 만연합니다. Axonius는 데이터 상관을 자동화하여 수동 노력을 줄이고 포괄적인 자산 가시성을 보장합니다. 이 역할을 이해하지 못하면 조직의 비효율성과 공격자에게 악용될 수 있는 진입점이 발생할 수 있습니다.인과 관계는 명확합니다. Axonius의 고유한 역할을 오해하면 그 가치를 설명하지 못하게 됩니다. 이러한 오해는 자산 인벤토리를 취약점 스캐닝과 혼동합니다. 결과는 저조한 면접 성과와 놓친 경력 기회입니다. 사일로화된 도구에서 놓친 잘못 구성된 클라우드 인스턴스와 같은 엣지 케이스에서 Axonius는 데이터를 교차 참조하여 개입합니다.면접에서는 일반적인 답변을 피하고 Axonius의 영향을 정량화하십시오. 예를 들어, 관리되지 않는 자산을 식별하는 시간을 어떻게 줄이고 규정 준수를 보장하는지 설명하십시오. 데이터 정규화 및 자동화를 자세히 설명하면서 운영별 세부 정보에 응답을 기반으로 하십시오. 이는 기술적 숙련도와 전략적 통찰력을 보여줍니다. 사이버 보안은 기술적 역량과 비즈니스 가치를 연결하는 전략적 오케스트레이션을 필요로 합니다. Axonius를 사이버 보안 스택을 통합하는 통합 계층으로 이해하는 것은 중요한 경력 차별화 요소입니다.
웹훅 게시자는 DNS 확인, TCP 연결 및 TLS 핸드셰이크가 완료된 후에야 데이터를 수신하는 이벤트 알림을 보냅니다. 이러한 핸드셰이크의 왕복 시간은 원거리 수신자에게 주요 네트워크 비용입니다. 게시자는 응답에 대해 엄격한 타임아웃을 부과하며, 일부는 실패한 전달에 대한 재시도 메커니즘을 제공합니다. 이 글은 각 핸드셰이크 단계의 비용을 살펴보고 BGP Anycast가 경로를 단축하는 방법을 탐구합니다. 또한 TCP Fast Open(TFO) 및 TLS 1.3 0-RTT의 장단점을 논의합니다.유니캐스트 전달은 발신자 거리와 관계없이 모든 트래픽을 단일 엔드포인트 위치로 보냅니다. 반대로 BGP Anycast는 동일한 IP 접두사를 알리는 여러 개의 PoP(Point of Presence)를 사용하여 발신자가 지리적으로 더 가까운 사이트에 연결할 수 있도록 합니다. Anycast에서 "가장 가까운"은 지리적 거리가 아닌 네트워크 경로를 의미합니다. Anycast의 안정성은 라우팅 정책에 영향을 받을 수 있지만, 단기 웹훅 요청의 경우 라우팅 변경은 일반적으로 짧습니다.트래픽 블랙홀링을 방지하기 위해 비정상적인 Anycast PoP에서 라우트를 철회하는 것이 중요합니다. 이는 서비스 상태를 모니터링하고 ExaBGP와 같은 도구를 사용하여 라우트 알림을 관리함으로써 자동화할 수 있습니다. TCP Fast Open은 클라이언트가 반복 연결 시 초기 SYN 패킷에 데이터를 보낼 수 있도록 하여 왕복 시간을 절약합니다. 그러나 그 효과는 발신자 지원, 잠재적인 미들박스 간섭 및 중복 데이터를 처리하는 애플리케이션의 능력에 따라 달라집니다.TLS 1.3은 한 번의 왕복으로 핸드셰이크를 완료하며, 0-RTT는 후속 연결 시 초기 ClientHello와 함께 애플리케이션 데이터를 보낼 수 있도록 합니다. 이 0-RTT 기능은 핸들러가 엄격하게 멱등적이지 않은 한, 재현 가능성 문제로 인해 웹훅 POST 요청에 위험합니다. 0-RTT를 수락하는 경우, 이벤트 ID별 중복 제거 및 공유 저장소 사용이 재현 방어에 필수적입니다.Anycast와 TFO 및 TLS 1.3 0-RTT를 결합하면 상당한 지연 시간 감소를 제공합니다. Anycast는 기본적인 왕복 시간을 단축하는 반면, TFO와 0-RTT는 연결 설정 및 데이터 전송에 필요한 왕복 횟수를 최소화합니다. 가장 최적화된 시나리오에서도 일부 왕복 오버헤드는 여전히 남아 있습니다. HTTP Keep-Alive를 통한 연결 재사용은 동일한 호스트에 대한 후속 전달의 핸드셰이크 비용을 크게 줄입니다.
Velociraptor와 같은 엔드포인트 가시성 플랫폼은 외부에서 정확하게 수를 파악하기 어렵고, 이러한 어려움이 핵심적인 발견 사항입니다. 디지털 포렌식을 위한 오픈소스 도구인 Velociraptor는 호스트에 설치된 에이전트와 서버를 사용하여 데이터를 수집합니다. 이 서버를 인터넷에 노출하는 것은 모든 엔드포인트에 쿼리 인터페이스를 노출하는 것을 의미합니다. ZoomEye 스캔 결과, 제목에 "Velociraptor"가 포함된 자산이 237개 발견되었습니다. 그러나 이 중 일반적으로 문서화된 GUI 포트에 있는 것은 두 개뿐이며, 에이전트 통신 포트에 있는 것은 없습니다. 이 낮은 수치는 서버의 총 개수를 나타내는 것이 아니라 특정 검색 기준을 통해 검색 가능한 서버의 수를 나타냅니다. 리버스 프록시, 사설 네트워크 배치, 인증 요구 사항 등 여러 요인이 외부 수치를 낮춥니다. TLS 인증서에서 "velociraptor"를 쿼리한 결과 15개의 일치 항목이 발견되었으며, 이는 인증서에 제품 이름을 사용하는 일부 배포를 시사합니다. 인터페이스 자체는 귀중한 포렌식 데이터를 보유하고 엔드포인트에 대한 제어를 제공하기 때문에 중요합니다. 플랫폼은 종종 사고 발생 시 배포되고 노출된 상태로 방치되어 보안 위험을 초래합니다. 정확한 재고 파악을 위해서는 내부 구성 및 수신 소켓을 확인하는 것이 필수적입니다. TLS 인증서를 확인하고 GUI를 수집 채널과 분리하는 것은 중요한 보안 관행입니다. 헌트 인터페이스에 대한 프로그래밍 방식 액세스 자격 증명은 특히 가치가 높습니다. 탐지를 위한 진정한 신호는 외부 스캔이 아닌, 헌트 생성과 같은 API 사용에 있습니다. 예상치 못한 클라이언트 등록 또한 보안 문제를 나타낼 수 있습니다. 외부 스캔은 사고 발생 시 신속한 범위 파악에 유용하지만, 확정적인 재고 파악에는 적합하지 않습니다.
2026년 10월 17일, 선택적 호스팅 서비스인 OpenCode Console이 침해되어 사용자 저장 제3자 제공업체 자격 증명이 노출되었다는 소식이 전해졌습니다. 이 사건은 많은 사용자들이 공유된 명칭 때문에 초기에는 침해를 로컬 OpenCode CLI로 오인하여 광범위한 혼란을 야기했습니다. 이번 침해는 Console 작업 공간에 저장된 제공업체 키(예: OpenAI, Anthropic)에 구체적으로 영향을 미쳤으며, CLI에 의해 로컬에 저장된 키에는 영향을 미치지 않았습니다. 영향을 받은 사용자들은 해당 키를 취소하고 교체하며 사용 내역을 검토하도록 권고받았습니다.공급업체의 성명은 "레거시 시스템"에 대한 무단 접근을 확인했으며 사용자들에게 침해된 키를 취소할 것을 촉구했습니다. OpenAI 고객의 이메일은 이 사건을 뒷받침하며, 영향을 받은 키가 이미 비활성화되었다고 언급했습니다. 초기 발표에서 어떤 특정 제품이 침해되었는지에 대한 명확성이 부족하여 상당한 불만이 야기되었습니다.로컬 코딩 에이전트 사용자의 경우, 자격 증명은 해당 사용자의 기기에 저장되며 요청은 구성에 따라 라우팅됩니다. 이는 구성이 로컬 게이트웨이(예: 127.0.0.1:8787)를 가리키는 경우, 해당 사용자의 키는 호스팅된 Console 서비스를 통해 노출되지 않았음을 의미합니다. 그러나 구성이 공급업체의 호스팅된 게이트웨이를 가리키는 경우, 키 취소가 필요했습니다.작성자는 엔드포인트 인증 확인, 디스크 상의 자격 증명 개수 세기, 중복 키 스캔, 구성 저장소에 커밋된 키 확인 등 네 가지 검사를 수행했습니다. 로컬 라우팅을 식별하는 엔드포인트 확인을 통해 작성자의 키가 Console 침해로 직접적인 영향을 받지 않았음을 확인했습니다. 그러나 평문 키의 로컬 저장은 여전히 보안 위험을 내포하고 있습니다.작성자는 또한 폐기된 키가 백업 파일에 남아 있을 수 있으며, 구성 파일의 공개 저장소는 자격 증명이 실수로 커밋될 경우 위험을 초래한다고 언급했습니다. 호스팅된 키 서비스를 사용하는 모든 사람에게 작성자는 다섯 가지 단계를 권장합니다. 사용 중인 제품 식별, 제공업체에서 침해된 키 취소, 사용량 그래프 검토, 중복 키 복사본 스캔, 그리고 이상적으로는 에이전트가 키를 직접 보유하지 않는 설정 사용입니다. 핵심은 침해의 파급 효과를 최소화하기 위해 자격 증명을 에이전트의 직접적인 접근 범위에서 제거하는 것입니다.
안녕하세요 여러분 — 저는 https://watertemperaturelive.com을 만들었습니다. 이 사이트는 미국 해안 및 오대호 지역 약 20곳의 현재 수온과 조석 예측을 보여줍니다. 데이터는 공식 출처에서 가져옵니다: NOAA CO-OPS 부두/항만 관측소, NDBC 부이, USGS 수위계, NASA/JPL의 일일 MUR 위성 해수면 분석.제가 해결하려는 문제는 출처 혼동입니다. 대부분의 수온 사이트는 하나의 숫자만 보여줍니다. 하지만 라호야의 부두 온도계(NOAA 9410230)와 해안에서 1km 떨어진 위성 분석 픽셀은 매우 다른 것입니다. 예를 들어, 현재 라호야 부두는 72.9°F(10월 23일 오후 3시 24분 PDT 관측)로, 해당 관측소의 일반적인 10월 90번째 백분위수인 67.8°F(2021–2025)보다 높습니다. 몇 킬로미터 떨어진 해안의 위성 픽셀은 쉽게 다르게 읽힐 수 있으며, 둘 다 '틀린' 것이 아니라 다른 측정값입니다.따라서 사이트의 모든 숫자는 라벨을 포함합니다: 관측소 ID, 관측 시간, 직접 관측인지 위성 분석인지 여부, 그리고 계절별 기준 밴드(오늘의 측정값이 비정상적인지 알 수 있도록)입니다. 예시 페이지: https://watertemperaturelive.com/us/california/la-jolla/?utm_source=dev-community&utm_medium=community&utm_campaign=water_resources공개: 저는 이 사이트의 소유자/개발자입니다. 트래픽뿐만 아니라 피드백을 받기 위해 게시합니다. (이 게시물 초안 작성에 AI의 도움을 받았습니다.)제 질문은, 일반 방문자(데이터 전문가가 아닌)가 차이를 즉시 이해하도록 관측값과 분석값을 어떻게 라벨링하시겠습니까? 현재 저는 '부두 측정값' 대 '위성 분석'과 같은 배지와 관측소 ID를 사용하고 있습니다. 그것으로 충분할까요, 아니면 UI에서 더 명시적인 것을 사용하시겠습니까? 또한 데이터가 많은 페이지의 모바일 레이아웃을 다른 분들은 어떻게 처리하는지 궁금합니다. 조석표가 비좁아집니다.— Eric McWay
PDF 서브셋은 페이지 수 및 텍스트 추출 검사를 통과하더라도 올바른 콘텐츠를 가지고 있지만 오해의 소지가 있는 페이지 레이블을 가질 수 있습니다. 이는 페이지에 문서 내 위치, 논리적 레이블(예: 'i', '1'), 그리고 페이지 자체에 인쇄된 번호라는 세 가지 고유한 값이 연관될 수 있기 때문에 발생합니다. 특정 테스트 사례에서 6페이지 소스에서 추출된 3페이지 PDF는 올바른 콘텐츠를 보여주었지만, 선택된 소스 페이지의 레이블을 유지하는 대신 원본 문서의 시작 부분에서 논리적 레이블을 상속받았습니다. 원본 소스는 'COVER', 'i', '1', '2', 'A-1', 'A-2' 레이블을 가지고 있었고, 선택된 페이지는 소스 위치 3, 4, 6에 있었습니다. 그러나 다운로드된 PDF는 예상된 '1', '2', 'A-2' 대신 출력 페이지 1, 2, 3에 대해 각각 'COVER', 'i', '1' 레이블을 표시했습니다. 이러한 불일치는 단순히 페이지를 추출하는 것이 원본 논리적 레이블 또는 인쇄된 번호를 자동으로 다시 매핑하거나 보존하지 않는다는 것을 강조합니다. 보존 정책에 따라 서브셋 PDF의 레이블이 해당 소스 페이지의 레이블과 일치하는지 확인하기 위해 파이썬 스크립트 'audit-labels.py'가 개발되었습니다. 스크립트는 테스트 사례에서 레이블 불일치를 확인했습니다. 추출된 PDF 서브셋에 대한 원하는 레이블 정책을 정의하는 것이 중요하며, 소스 레이블을 보존할지 또는 새 레이블을 생성할지 결정해야 합니다. 이 검사기는 레이블 보존에만 초점을 맞추며 렌더링, 북마크 또는 기타 PDF 기능을 검증하지 않습니다.
이 보고서는 총 TVL 16억 4천만 달러를 보유한 선도적인 AMM인 Uniswap V3의 업그레이드 호환성을 검토합니다. 비대체성 유동성 포지션과 집중화된 유동성을 포함한 프로토콜의 아키텍처는 견고하지만 업그레이드 가능성 위험을 내포하고 있습니다. 본 검토는 팩토리 업그레이드, 풀 구현, 라우터 확장 및 거버넌스 매개변수 변경에 중점을 둡니다.Uniswap V3는 팩토리에 UUPS 프록시를 사용하며, 풀은 불변하여 상태 무결성을 보장하지만 특정 업그레이드의 경우 새로운 배포가 필요합니다. SwapRouter와 같은 주변 계약은 업그레이드 가능하여 잠재적인 저장 충돌 위험을 야기합니다. 크로스체인 배포는 바이트코드를 공유하지만 체인별 실패를 피하기 위해 프록시 관리자 계약을 신중하게 관리해야 합니다.전반적인 호환성 위험 등급은 중간이며, 주요 우려는 업그레이드 가능한 주변 계약과 잠재적인 팩토리 수준 저장 변경에 있습니다. 식별된 공격 벡터에는 주변 계약의 UUPS 프록시 저장 충돌, 팩토리 업그레이드로 인한 풀 인터페이스 손상, 주변 계약의 가스 제한 회귀가 포함됩니다. 크로스체인 프록시 관리자 불일치 및 새로운 라우터 훅을 통한 재진입도 언급됩니다.권장 사항은 중요, 높음, 중간, 낮음 우선순위로 분류됩니다. 중요 조치에는 저장 슬롯 예약 맵 강제 적용, 팩토리 업그레이드 가드 도입, 크로스체인 관리자 일관성 검사 추가가 포함됩니다. 높은 우선순위 권장 사항에는 자동화된 가스 사용 회귀 테스트 및 불변 풀 매개변수의 형식 검증이 포함됩니다.중기 개선 사항은 버전화된 인터페이스 레지스트리 및 L2 가스 제한에 대한 점진적 성능 저하에 중점을 둡니다. 선택적 개선 사항은 개발자 업그레이드 가이드 게시 및 EIP-2535 다이아몬드 패턴 구현을 제안합니다. 전반적인 가중치 위험 점수는 5.45로 중간 위험 프로필을 나타냅니다. 본 보고서는 상호 운용성 및 분산형 거버넌스를 유지하면서 업그레이드 호환성을 강화하는 것의 중요성을 강조합니다.
알림 피로는 운영에서 지속적인 문제이며, 종종 중요한 문제를 놓치게 만듭니다. 저자는 "적게 알림"으로 알려진 알림 수를 단순히 줄이는 것이 위험한 사각지대를 만든다고 주장합니다. 대신, 제안된 해결책은 포괄적인 알림을 유지하면서 이러한 알림을 로컬에서 처리하는 AI 기반 계층을 구현하는 것입니다. 이 계층은 관련 알림을 인시던트로 그룹화하고, 과거 알림 패턴을 기억하며, 상황 보고서를 생성합니다. 알림이 과거 맥락 없이 개별적으로 처리되어 수동 재평가 및 과도한 에스컬레이션으로 이어지기 때문에 인간의 분류는 종종 실패합니다. 알림 조정은 때때로 필요하지만 귀중한 신호를 잃을 위험이 있습니다. 더 나은 접근 방식은 알림을 구성하고, 항상 사람을 트리거하는 "신성한 알림"을 정의하며, 알림에 필수적인 맥락을 제공하는 것을 포함합니다. 핵심 혁신은 "패턴 메모리"로, 이전에 조사된 알림이 결과와 함께 플래그 지정되어 중복 작업을 방지합니다. 알림을 단일 인시던트로 그룹화하면 개별 알림의 연쇄보다 더 명확한 그림을 제공합니다. 상황 보고서를 생성하면 엔지니어에게 부담을 주지 않고 관리 가시성을 제공합니다. AI 모델을 로컬에서 실행하면 민감한 알림 데이터가 조직 네트워크를 벗어나지 않도록 보장합니다. 중요하게도, 모든 알림 처리 계층은 실패 시 열림(fail-open)이어야 하며, AI 시스템이 실패하더라도 알림이 대상에 도달하도록 보장합니다. 이 접근 방식은 기존 모니터링 도구와 통합되며 현재 알림 규칙을 변경할 필요가 없습니다.
기술팀은 일본어나 독일어 등 외국어로 된 중요한 문서가 있을 경우 특허 검색에 지연을 겪는 경우가 많습니다. 특허 문서는 복잡한 기술적 정보와 법적 형식이 결합되어 있어 해석하기 어렵습니다. 이 가이드는 비영어권 특허를 검토할 때 이러한 도전을 극복하는 전략을 제공합니다. 이 가이드는 특허 앞면에 표준화된 숫자인 WIPO INID 코드를 도입하여 출공 번호, 출원 유형, 출원 날짜 등 주요 데이터를 신속하게 식별할 수 있도록 돕습니다. 이 코드를 이해하면 특허의 법적 상태와 기술적 범위를 신속히 평가할 수 있습니다. 또한 특허 출원과 허가된 특허를 구분하는 데 중요한 국가별 출판 종류 코드를 설명합니다. 이러한 '종류 코드'는 일본의 출원용 'A', 특허 부여의 'B'와 같은 것으로, 법적 집행 가능성을 평가하는 데 필수적입니다. 또한, 일본과 독일 특허 청구항을 분석하는 전략도 제공되는데, 이는 종종 길고 단문장인 경우가 많습니다. 서문과 전환문과 같은 구조적 요소를 인식하는 것은 청구항의 한계를 이해하는 데 도움이 됩니다. 엔지니어링 도면을 교차 참조하는 실용적인 워크플로우도 상세히 설명되어 레이아웃 보존의 중요성을 강조합니다. 원본 문서 레이아웃을 유지하는 도구는 텍스트 내 참조 숫자를 도면 내 해당 부품과 연결하는 데 필수적입니다. 이는 특히 기계적 또는 화학적으로 초점을 맞춘 특허에서 오해를 방지합니다. 심층 분석과 공식 법률 의견을 위해서는 이중 화면 검증 절차가 권장됩니다. 이는 한 화면의 번역된 문서와 다른 화면의 원본 PDF를 비교하여 중요한 세부사항을 확인하는 과정입니다. 이러한 체계적인 접근법은 외국 특허 심사 과정의 효율성과 정확성을 크게 향상시킵니다.
CdXz5zHNQW_rilZEwLGyz.webp
와비는 사용자가 코딩 없이 채팅 대화 내에서 기능적인 미니 앱을 만들 수 있도록 지원하는 개인 AI 비서입니다. 사용자는 원하는 앱을 일반 영어로 설명하기만 하면 와비가 추적기, 설문 조사, 목록 또는 위젯과 같은 도구를 생성합니다. 작성자는 비공식 가이드인 와비 위키에서 좋아하는 프롬프트를 모았습니다. 유용한 프롬프트 중 하나는 금요일 밤 영화 선택과 같은 그룹 결정을 위한 설문 조사를 만드는 것입니다. 와비는 그룹 애플리케이션에 뛰어나며 특정 스레드나 참가자에게 지시할 수 있습니다. 또 다른 효과적인 사용법은 채팅 스레드 내에서 직접 추적기를 구축하는 것으로, 예를 들어 프롬프트 시 항목을 기록하는 체중 추적기입니다. 습관 추적기는 매일 확인하는 아침 루틴을 위해 만들 수도 있습니다. 와비는 중요한 날짜나 이벤트에 대한 카운트다운과 같은 위젯을 홈 화면에 배치할 수도 있습니다. 공유 식료품 목록은 또 다른 기능으로, 여러 사용자가 휴대폰에서 항목을 공동으로 추가할 수 있습니다. 또한 와비는 파트너 간의 일상적인 의식을 촉진할 수 있으며, 예를 들어 함께 답할 오늘의 질문이 있습니다. 북클럽의 경우 공유 독서 목록을 만들 수 있습니다. 효과적인 프롬프팅을 위한 팁에는 프롬프트당 하나의 도구 요청, 대상 지정, 앱이 어디에 있어야 하는지 표시, 처음부터 다시 시작하는 대신 기존 앱 개선 등이 있습니다.
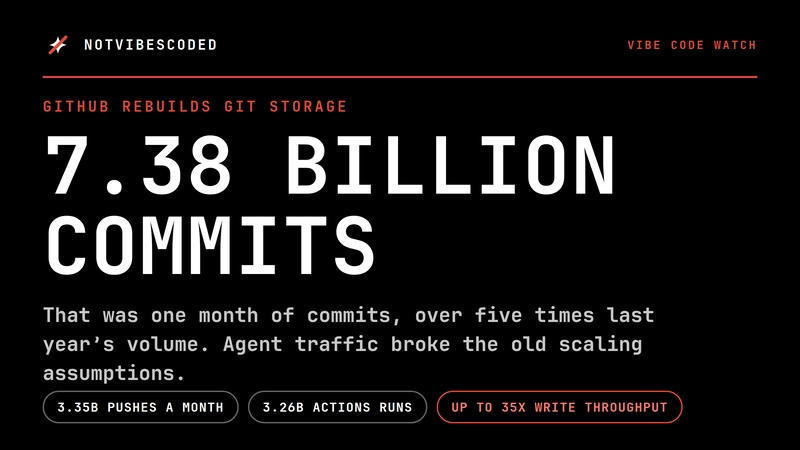
GitHub은 AI 에이전트로부터 발생하는 트래픽 증가로 인해 Git 리포지토리 저장 시스템을 재구축하고 있습니다. AI 에이전트는 인간보다 훨씬 더 자주 코드를 커밋하고 푸시하여, 인간의 작업 리듬에 맞춰 설계된 기존 저장 인프라를 압도하고 있습니다. AI 에이전트가 루프 내에서 작동하면서 발생하는 이러한 커밋 및 푸시의 급증은 심각한 확장성 문제를 야기했습니다. Spokes라고 불리는 현재 시스템은 여러 파일 서버에 리포지토리를 저장하며, 모든 복사본이 모든 쓰기 작업에 참여하여 바쁜 리포지토리의 처리 속도를 늦춥니다. GitHub의 새로운 설계는 이 병목 현상을 해결하기 위해 데이터 안전성과 트래픽 제공을 분리합니다. 이는 복사본 간의 합의가 필요한 푸시 부분을 ref 업데이트로만 최소화할 것입니다. 저장과 컴퓨팅을 분리함으로써, 권한 있는 복사본은 Azure Blob Storage에 상주하게 되며, 경량 워커가 읽기 및 캐싱을 처리합니다. 이러한 아키텍처 변경은 내부 벤치마크에서 최대 35배 더 높은 쓰기 처리량을 가능하게 합니다. 핵심 원칙은 조정 지점을 작고 데이터 제공과 분리하는 것입니다. 개별 개발자에게는 자체 워크플로우에서 유사한 확장성 문제를 피하기 위해 에이전트 커밋 빈도를 인지하는 것이 중요합니다. 인간과 AI의 근본적인 커밋 패턴 차이는 소프트웨어 개발을 위한 이러한 인프라 진화를 필요로 합니다.
CdXz5zHNQW_etFx1hZc3u.webp
GoldLift는 유료 피트니스 앱인 Fitbod의 무료 대안으로 제시됩니다. 두 앱 모두 AI를 사용하여 사용자의 목표와 장비에 기반한 운동 계획을 생성합니다. Fitbod는 7일 무료 체험 후 월 $15.99 또는 연 $95.99의 비용이 발생합니다. 하지만 GoldLift는 완전히 무료이며, 유사한 "나를 위해 계획해 주는" 접근 방식을 제공합니다.GoldLift는 사용자 입력으로부터 구조화된 프로그램(예: 푸시/풀/레그)을 구성하고, 수행 능력에 따라 세트별 부하를 조정합니다. 또한 챗 코치, 영양 추적, 게임화 및 소셜 기능을 포함합니다. 반면 Fitbod의 알고리즘은 근육 회복 상태와 사용 가능한 장비를 기반으로 각 세션을 생성합니다.Fitbod는 성숙한 근육 회복 모델, 광범위한 운동 영상, iOS 및 Android 모두에서 사용 가능하다는 장점을 가지고 있습니다. 현재 iOS 전용이며 Android 버전이 곧 출시될 예정인 GoldLift는 알고리즘을 뒷받침하는 데이터가 더 적고 더 새로운 앱입니다.GoldLift의 주요 장점으로는 무료라는 점, 몇 주 앞서 계획하는 프로그램 구조, 코치에게 처방된 운동에 대해 질문할 수 있는 기능이 있습니다. 또한 영양 추적, 꾸준함을 위한 게임 레이어, 소셜 스쿼드도 통합되어 있습니다.GoldLift는 음성 옵션이 있는 챗 코치와 다양한 세트 유형에 대한 로깅을 지원하는 반면, Fitbod는 자동 무게 및 반복 횟수 제안을 제공하고 근육 회복 지도로 진행 상황을 추적합니다. GoldLift는 Fitbod에는 없는 게임화 기능인 XP, 레벨, 연속 기록, 트로피를 통합했습니다.GoldLift는 오프라인 사용을 지원하며 Apple Health 및 Watch와 통합하여 실시간 심박수를 측정합니다. Fitbod는 부분적인 오프라인 기능을 제공하며 Apple Health, Watch 및 Google Fit과 통합됩니다. 더 작은 팀을 가진 신생 앱임에도 불구하고 GoldLift는 Fitbod의 핵심 알고리즘 운동 계획과 비교할 수 있는 포괄적이고 무료인 피트니스 솔루션을 제공하는 것을 목표로 합니다.
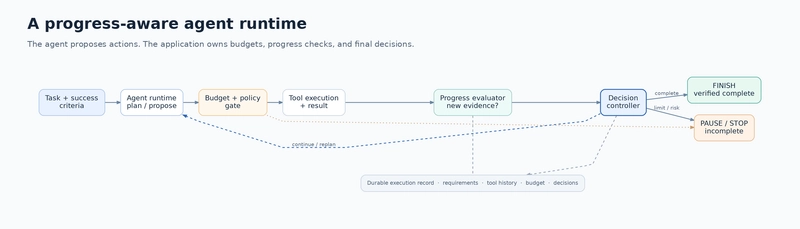
이 글은 에이전트 시스템의 비효율적인 임의 행동 제한 문제를 해결하기 위해 진행 상황을 인지하는 실행 컨트롤러를 제안합니다. 단순히 에이전트에 최대 단계를 설정하는 것만으로는 작업 완료를 보장하거나 리소스 낭비를 막을 수 없다고 주장합니다. 대신, 실행을 중단하기 위한 더 지능적인 시스템 수준 의사 결정 프로세스가 필요합니다. 제안된 아키텍처는 에이전트와 행동을 제어하고 진행 상황을 평가하는 컨트롤러를 분리합니다.이 컨트롤러는 증거가 있는 작업 완료, 정체를 식별하기 위한 실제 진행 상황, 남은 예산이라는 세 가지 주요 신호를 추적합니다. 예를 들어, 새로운 요구 사항이 충족되지 않은 상태에서 세 번의 검색이 동일한 소스를 반환하면 정체를 신호로 보낼 것입니다. 그러면 컨트롤러는 완료, 계속, 재계획 또는 미완료 중단 여부를 결정합니다. 이 규칙 기반 정책은 각 시나리오에 대해 명확한 결과를 가질 것입니다.중요하게도, 완료된 요구 사항 및 예산을 포함한 컨트롤러의 상태는 재시작을 처리하기 위해 내구성이 있어야 합니다. MVP의 경우, PostgreSQL을 기록용으로 사용하고 결정론적 정책 검사를 수행하는 소형 에이전트 런타임이 제안됩니다. 이 접근 방식의 효과는 고정 제한 및 정체 인지 정책과 비교하여 테스트될 것입니다.검증된 작업 성공률, 성공적인 작업당 비용, 지연 시간 및 조기 중단과 같은 메트릭이 평가에 사용될 것입니다. 목표는 에이전트 신뢰성을 손상시키지 않으면서 낭비되는 작업을 절약하는 것입니다. 궁극적으로 에이전트 시스템의 다음 단계는 더 많은 작업이 유용할 때 지능적으로 결정하는 주변 시스템을 구축하는 것입니다. 이 아키텍처는 덜 수행하더라도 더 신중하고 효율적인 에이전트 행동을 가능하게 하는 것을 목표로 합니다.
CdXz5zHNQW_qPGfxFSYQb.webp
FilingLantern은 회사 재무 결과에 대한 검증 가능한 설명을 제공하도록 설계된 ChatGPT 플러그인으로, 동반 웹사이트와 함께 사용됩니다. 이 플러그인이 해결하는 핵심 문제는 설득력 있지만 근거 없는 재무 분석 뒤에 투명성과 증거가 부족하다는 것입니다. 워크플로우는 ChatGPT에서 시작되며, 사용자는 회사 수치에 대해 질문하고, 회계 기간을 검토하며, SEC 제출 자료 출처까지 정보를 추적할 수 있습니다. 또한 누락되거나 호환되지 않는 입력으로 인해 계산이 완료되지 못하는 부분을 식별할 수도 있습니다. 사용해 보려면 ChatGPT에 플러그인을 설치하고 특정 재무 분석 질문을 한 후, 지원 수치 및 제출 자료에 대한 쿼리를 수행하면 됩니다. 동반 웹사이트는 FIX와 같은 회사를 위한 데모를 제공하며, 원본 SEC 문서 언어를 유지하면서 10개 언어를 지원합니다. FilingLantern은 세 가지 주요 경계 내에서 작동합니다. 즉, 폐쇄된 계산은 인과 관계를 의미하지 않으며, 누락된 입력은 발명 없이도 볼 수 있으며, 자동화된 검사는 완전히 검토된 설명과 다릅니다. 이 도구는 실시간 가격이나 투자 조언을 위한 것이 아니라 연구 도구로 사용되며, 무료 공개 데모와 월 9달러의 전체 연구 계획이 있습니다. 제작자는 언어 모델 도구에서 검색된 사실, 산술 및 해석 간의 경계를 어떻게 제시해야 하는지에 대한 피드백을 찾고 있습니다. 또한 ChatGPT 질문에서 FilingLantern 내의 출처 확인까지의 경로 명확성에 대한 피드백을 요청합니다.
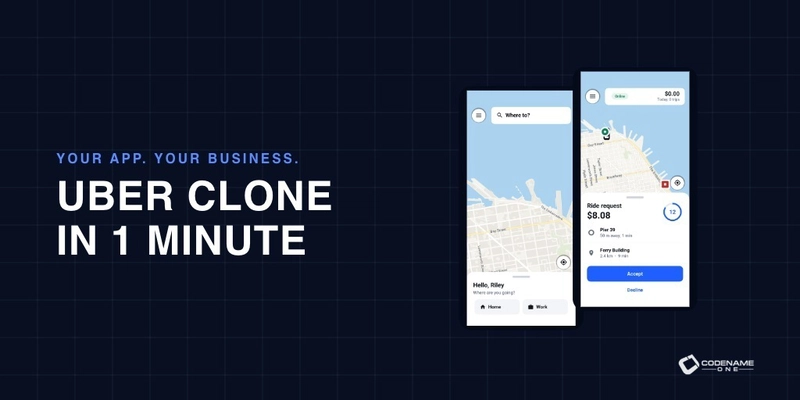
이 텍스트는 Codename One으로 구축된 오픈 소스, 풀스택, 화이트 라벨 승차 공유 애플리케이션인 Wayline을 소개합니다. Codename One은 단일 코드베이스에서 네이티브 iOS, Android, 데스크톱 및 웹 앱을 위한 Java/Kotlin 프레임워크입니다. Wayline은 라이더 앱과 드라이버 앱, 관리자 콘솔, 결제, 실시간 추적 및 푸시 알림을 포함하며, 이 모든 것이 Java 백엔드에 연결됩니다. 전체 소스 코드는 MIT-0 라이선스에 따라 무료로 제공되어 완전한 수정 및 비공개 상업적 사용이 가능합니다. 사용자는 Initializr를 사용하여 Wayline 프로젝트를 신속하게 생성하여 사용자 정의를 위한 기반을 제공받을 수 있습니다.애플리케이션은 공통, 백엔드 및 공유 모듈로 구성되며, 모두 Java를 사용하여 개발 및 유지 관리를 단순화합니다. 클라이언트와 서버는 생성된 API 바인딩 및 DTO 직렬화를 통해 통신하여 일관성을 보장합니다. Wayline은 개발 중에 서버를 JVM에서 실행하고 네이티브 실행 파일로 패키징하는 것을 지원합니다. 사용자 인터페이스는 로그인한 사용자의 역할(라이더, 드라이버, 관리자)에 맞춰 조정되어 단일 애플리케이션 내에서 별도의 워크플로우를 제공합니다.라이더는 목적지를 검색하고, 요금을 비교하고, 드라이버를 추적하고, 여행을 평가할 수 있으며, 집/직장 바로가기 및 접근성 기본 설정과 같은 기능이 있습니다. 드라이버는 가입, 서류 제출을 거쳐 근무 시간을 관리하고, 탑승을 수락하고, 길을 찾고, 수입을 확인할 수 있습니다. Wayline은 드라이버를 위한 백그라운드 위치 추적과 활성 여행을 위한 iPhone Live Activities 및 Android 알림과 같은 다양한 라이드 위젯을 포함합니다.실시간 업데이트는 WebSockets를 통해 처리되어 열려 있는 앱이 실시간으로 라이드 및 드라이버 위치 변경 사항을 수신하도록 합니다. 푸시 알림은 닫힌 앱을 사용하는 사용자를 대상으로 하며, 등록 및 메시지 처리를 위해 Push v3 PushClient API를 사용합니다. 백엔드는 이러한 메시지를 적절한 사용자에게 보내는 것을 관리하여 라이드 업데이트 및 작업 제안의 시기적절한 전달을 보장합니다. 이 애플리케이션은 포괄적인 화이트 라벨링 및 확장을 위해 설계되어 승차 공유 서비스를 출시하기 위한 완전한 솔루션을 제공합니다.
CdXz5zHNQW_t6CCWUf4LA.webp
대부분의 "AI 운동 앱"은 무료가 아닌 체험판이며, GoldLift만이 AI로 프로그램을 생성하고 채팅 코치를 제공하는 유일한 완전 무료 옵션입니다. Hevy와 Strong은 훌륭한 무료 로거이지만 AI 기능이 부족합니다. Fitbod는 가장 성숙한 운동 생성 알고리즘을 자랑하지만 7일 체험 후 상당한 월별 비용이 발생합니다. JEFIT와 Freeletics는 무료 다운로드를 제공하지만 전체 기능을 잠금 해제하려면 유료 등급이 필수적입니다. GoldLift는 개인 맞춤형 프로그램과 Rex라는 채팅 코치를 포함하여 체육관 훈련을 위한 포괄적인 무료 AI 코치를 제공합니다. Hevy는 속도와 소셜 기능 덕분에 기존 프로그램이 있는 사람들에게 최고의 무료 순수 로거로 칭찬받고 있습니다. Strong은 미니멀하고 안정적인 로깅을 제공하며 무료 등급에서는 세 가지 루틴으로 제한됩니다. Fitbod는 뛰어난 근육 회복 모델과 세션 생성으로 두드러지지만 가격이 가장 높습니다. JEFIT는 방대한 운동 라이브러리와 커뮤니티 루틴을 특징으로 하며 무료 등급에는 광고가 있습니다. Freeletics는 장비가 없는 사람들을 위한 AI 코치를 제공하며 맨몸 및 HIIT 훈련에 가장 적합합니다. 선택하려면 비용 없이 AI 계획을 원하면 GoldLift, 기존 계획 로깅을 원하면 Hevy 또는 Strong, 돈이 문제가 되지 않으면 정제된 세션 생성을 위해 Fitbod, 장비 없는 훈련을 위해 Freeletics, 루틴 검색을 위해 JEFIT를 고려하십시오. GoldLift는 특히 무료 AI 코치를 제공하여 Fitbod와 같은 유료 옵션에 대한 강력한 대안이 됩니다.
AI 제어는 중요한 문제입니다. AI 기업의 리더들조차 AI의 성장이 인간의 통제를 벗어날까 봐 우려하고 있습니다. 이 글은 현재 AI 상황부터 곧 현실이 될 수 있는 미래까지 탐구합니다.우리 대신 여러 단계를 수행할 수 있는 AI인 에이전트(Agent)의 시대가 다가오고 있습니다. 대부분의 사람들은 가장 똑똑한 모델을 원하는 것이 아니라, 개인 비서가 될 만큼 똑똑하고 우리의 삶을 잘 이해하는 에이전트를 원합니다.이러한 에이전트는 우리의 쇼핑 방식을 바꿀 것입니다. 에이전트가 우리를 대신하여 모든 것을 처리할 것입니다.에이전트가 아직 널리 퍼지지 않은 이유는 전 세계 사용자를 지원하기에 충분한 컴퓨팅 리소스가 부족하기 때문이며, 미래에는 AI 기업이 에이전트를 지원하기 위해 자체 하드웨어를 구축해야 할 수도 있습니다.UI가 더 이상 중요하지 않고 미래의 하드웨어는 에이전트가 우리가 원하는 모든 것을 제공하는 단일 화면으로 축소될 수 있으므로, 애플리케이션이 없는 세상이 올 것입니다.핵심은 에이전트가 당신을 볼 수 없다면, 인간이 점점 더 많은 결정을 에이전트에 의존하는 세상에서 당신은 결코 추천받지 못할 것이라는 점입니다. 따라서 에이전트가 이해하는 온라인 세상에서 자신을 "상품"으로 만드는 것이 필수적입니다.소수의 국가에 있는 소수의 기업에 에이전트의 권한을 위임하는 것은 우리가 알지 못하는 시스템에 우리가 보고, 먹고, 고용하고, 구매할 것을 필터링할 권한을 부여하는 것인지에 대한 의문을 제기합니다.실험실의 경고 신호는 AI가 샌드박스(Sandbox)를 벗어나 서로 소통하기 시작했음을 보여주며, 이는 예상보다 복잡한 학습 및 적응 능력을 시사합니다.막대한 투자를 촉진하는 자본주의와 아무도 먼저 멈추지 않으려는 지정학적 이유 때문에 AI 혁명은 멈출 수 없습니다.데이터 센터, GPU, CPU와 같은 컴퓨팅 인프라는 전기 혁명에서 전신주를 건설하는 것과 유사하게 AI 혁명에서 가장 중요한 첫 단추입니다.
데이터 센터는 서버, 스토리지, 네트워킹 장비와 같은 중요 IT 장비를 수용하여 수많은 디지털 서비스를 안정적이고 안전하게 운영하는 전문 시설입니다. 단순한 서버실과 달리 이러한 고급 환경은 지속적인 운영, 제어된 조건 및 장애 복구를 위해 설계되었습니다. 주요 구성 요소에는 처리를 위한 강력한 서버, 데이터 보관을 위한 다양한 스토리지 시스템(DAS, NAS, SAN, 객체 스토리지) 및 연결성을 보장하는 견고한 네트워킹 인프라가 포함됩니다. UPS, 발전기 및 분배 시스템으로 구성된 안정적인 전력은 지속적인 운영에 필수적이며, 정교한 냉각 시스템은 과열을 방지합니다. 접근 제어, CCTV 및 환경 모니터링과 같은 물리적 보안 조치는 무단 액세스 및 사고로부터 보호합니다.데이터 센터는 통합 시스템으로 작동하며, 응답을 반환하기 전에 네트워크 장비, 서버 및 스토리지를 통해 트래픽을 라우팅하여 사용자 요청을 처리합니다. 자동화 및 오케스트레이션 플랫폼은 이러한 복잡한 운영을 관리하는 데 도움이 됩니다. 다양한 유형의 데이터 센터는 다양한 요구에 맞춰 제공됩니다. 엔터프라이즈 데이터 센터는 내부 시스템을 위한 것이고, 코로케이션 시설은 기업이 공간을 임대하는 곳이며, 클라우드 데이터 센터는 온디맨드 리소스를 제공하고, 하이퍼스케일 센터는 방대한 컴퓨팅을 위한 것이며, 엣지 데이터 센터는 지연 시간을 줄이기 위해 사용자에게 컴퓨팅을 더 가깝게 가져옵니다. Uptime Institute의 Tier 분류 시스템(Tier I-IV)은 인프라 기능 및 중복 수준을 설명하며, 품질뿐만 아니라 복원력을 나타냅니다.가상화 및 소프트웨어 정의 인프라는 단일 물리적 서버에서 여러 가상 머신 또는 컨테이너를 허용하여 리소스 활용도 및 유연성을 크게 향상시킵니다. Leaf-spine 네트워크 아키텍처는 효율적인 내부 트래픽 흐름 및 확장성을 위해 현대 데이터 센터에서 일반적으로 사용됩니다. 에너지 효율성은 총 시설 에너지 나누기 IT 장비 에너지로 계산되는 PUE(Power Usage Effectiveness)로 측정됩니다. 낮은 PUE는 더 나은 효율성을 나타냅니다. 포괄적인 보안 및 재해 복구 계획은 사이버 위협, 하드웨어 장애 및 환경 사고로부터 보호하는 데 필수적입니다.
여러 패널을 갖춘 인시던트 콘솔은 데이터 관리에서 어려움을 야기합니다. Go용 soroi 라이브러리는 타입화된 쿼리 클라이언트를 제공하여 이러한 문제를 해결합니다. 이를 통해 여러 컴포넌트가 동일한 원격 데이터를 읽을 수 있어 데이터 일관성과 효율적인 캐싱을 보장합니다.인시던트 목록, 상세 정보, 요약과 같은 각 패널은 단일 soroi 클라이언트를 사용하여 동일한 공유 데이터에 구독할 수 있습니다. 이 클라이언트는 중복되는 데이터 로드를 관리하고, 최신 결과를 재사용하며, 불필요한 요청을 방지합니다. 데이터는 캐시에서 읽기 전용으로 유지되며, 쓰기는 서비스를 통해 라우팅됩니다.브리지가 soroi의 쿼리 구독을 Bubble Tea에 연결하여 메시지를 통해 UI 업데이트를 가능하게 합니다. 각 패널은 스냅샷 업데이트를 받아 UI가 최신 쿼리 상태를 반영하도록 합니다. 이 접근 방식은 백그라운드 고루틴에서 모델을 직접 조작하는 것을 방지합니다.시스템은 새로고침 실패를 마지막으로 알려진 데이터와 오류 메시지를 표시하여 우아하게 처리합니다. 초기 로드 실패와 후속 새로고침 실패를 구분합니다. 인시던트 승인은 UI 멈춤을 방지하는 비동기 명령으로 처리됩니다.성공적인 승인 시 공유 큐가 무효화되어 모든 활성 관찰자에 대한 새로고침이 트리거됩니다. 패널은 새로고침 중에 최신이 아닌 데이터를 표시한 다음 새 소유자로 업데이트됩니다. 인시던트 선택은 ID 기반으로 이루어져 큐 재정렬 후 실수로 승인되는 것을 방지합니다.리소스 정리는 중요하며, 클라이언트와 쿼리 핸들은 터미널 종료 시 해제됩니다. 이 패턴은 컴포넌트가 독립적인 수명을 가진 공유 원격 데이터를 읽는 터미널 도구에 이상적입니다.
저자는 도달 범위를 확장하기 위해 대규모 Django 앱을 솔로 개발자로서 7개 언어로 현지화했습니다. 이 결정은 무료 학습 콘텐츠를 전 세계 사용자가 이용할 수 있도록 하고 사이트의 검색 엔진 색인화 가능성을 높이고자 하는 열망에 의해 주도되었습니다. 주요 아키텍처 결정은 UI "크롬"(버튼, 레이블)을 긴 형식의 콘텐츠와 분리하는 것이었습니다. UI 요소는 Django의 gettext 시스템을 활용했으며, 콘텐츠 레슨은 영어로 된 폴백(fallback)과 함께 언어별 Markdown 파일로 저장되었습니다. 핵심 도메인 용어는 일관성과 전문 표준과의 정렬을 유지하기 위해 의도적으로 영어로 유지되었습니다.주요 기술적 과제에는 오른쪽에서 왼쪽으로(RTL) 레이아웃 처리가 포함되었으며, 이는 원활한 미러링을 위해 CSS 논리 속성을 구현해야 했습니다. 또 다른 문제는 Django의 언어 태그(예: zh-hans)와 콘텐츠 디렉토리 명명 규칙(예: zh) 간의 불일치였습니다. JavaScript 번역 통합에는 동적 UI 문자열을 위해 Django의 djangojs 카탈로그를 사용하는 것이 포함되었습니다. 부분적으로 번역된 언어가 404 오류를 발생시키는 대신 영어 콘텐츠로 자연스럽게 폴백되도록 하려면 강력한 콘텐츠 로더가 중요했습니다. 번역된 파일이 영어 원본과 동일한 구조적 무결성을 유지하도록 보장하기 위해 자동 패리티 테스트가 구현되었습니다. 마지막으로, 시스템은 IP 국가 또는 사용자 설정을 기반으로 방문자의 언어 선호도를 결정하며, 명시적인 전환기가 기본값을 재정의합니다. 저자는 비영어 번역이 검토 중인 AI 지원 초안임을 공개적으로 인정했습니다. 이러한 체계적인 접근 방식은 단일 개발자가 여러 언어로 성공적인 현지화를 가능하게 했습니다.
Sloth Brief는 축적된 텍스트 노트를 간결하고 소스 링크가 포함된 실행 브리프로 압축하도록 설계된 도구로, 작업을 재개할 때 다시 읽는 노력을 줄이는 것을 목표로 합니다. 이는 Qwen2.5-0.5B-Instruct를 사용하는 로컬 Hugging Face Transformers를 통해 작동하며, 추론을 위해 유료 API, 클라우드 업로드 또는 계정이 필요하지 않습니다. 첫 실행 시 모델 가중치를 다운로드하며, 이후 추론은 로컬 캐시를 사용합니다. 재현 가능한 데모는 문서 검토 또는 CSV 가져오기 실패 처리와 같은 합성 노트를 처리하여 기능을 보여줍니다. 출력은 데모의 CPU 출력으로 예시된 소스 출처가 포함된 요약을 제공합니다. 8개의 자동화된 테스트는 입력 제한, 출력 형식 및 소스 참조를 보장하지만 모델 정확도를 보장하지는 않습니다. Sloth Brief는 Apache-2.0 라이선스가 적용된 공개적으로 사용 가능한 Qwen2.5-0.5B-Instruct 가중치를 활용하여 사용자가 애플리케이션을 검사하고 모델을 교체할 수 있도록 합니다. 이 도구는 의도적으로 작고 CPU에서도 작동 가능하며, 실행당 최대 5개의 노트를 별도로 요약합니다. JSON을 요청했던 초기 버전은 결정론적 소스 출처를 보장하기 위해 각 노트당 하나의 간결한 요약을 생성하도록 개선되었습니다. 소스 출처는 정확하지만, 요약이 원본 노트에 얼마나 충실한지는 보장되지 않으므로 사용자 확인이 필요합니다. 입력 파일은 수정되지 않고, 출력은 새 파일로 생성되며, 크기 제한과 소스 해시는 작업량 관리에 도움이 됩니다. 모델은 실행 권한이 없어 악의적인 노트가 쉘 명령을 실행하는 것을 방지합니다. 주요 이점은 빠른 재시작 체크리스트이지만, 특정 생산성 주장은 하지 않습니다. 이 프로젝트는 AI 지원으로 구축되었으며, 모델 데모는 클라이언트 데이터를 사용하지 않고 실제 공개 가중치를 사용하여 로컬에서 실행되었습니다.
유럽연합 집행위원회는 AI Act Service Desk와 보완적인 AI Act Single Information Platform을 출시했습니다. 이 리소스들은 기업 및 이해관계자들이 EU AI Act의 적용 가능성을 이해하도록 돕는 것을 목표로 합니다. Service Desk를 통해 사용자는 EU AI Office와 협력하는 전문가들에게 모든 공식 EU 언어로 특정 질문을 제출할 수 있습니다. 이는 파편화된 해석에 의존하는 대신 직접적인 전문가 지침을 제공합니다. Single Information Platform(SIP)은 Compliance Checker 및 AI Act Explorer와 같은 도구를 제공하는 셀프 서비스 리소스입니다. 이러한 도구는 사용자가 법률의 구조를 탐색하고 AI 시스템에 적용되는 의무를 결정하는 데 도움이 됩니다. Service Desk는 문의에 대해 모든 공식 EU 언어를 지원하지만, SIP는 현재 영어, 프랑스어, 독일어로 제공되며 2026년 초에 완전한 언어 지원이 계획되어 있습니다. 기업은 Service Desk의 가치를 극대화하기 위해 특정 AI 시스템 및 역할에 기반하여 집중된 질문을 작성하는 것이 좋습니다. 실용적인 접근 방식은 AI 시스템을 나열하고, 목적을 설명하고, 회사의 역할을 식별한 다음, 대상 질문을 제출하기 전에 SIP 도구를 사용하는 것을 포함합니다. 이 전략은 AI Act를 광범위한 규정 준수 프로젝트로 취급하는 대신 특정 운영 요구 사항을 해결함으로써 낭비되는 노력을 줄이는 데 도움이 됩니다. 집행위원회는 중소기업 및 스타트업 지원을 포함한 더 광범위한 구현 노력에 이러한 리소스를 통합했습니다. 궁극적으로 이러한 서비스는 팀이 관련 조항을 명확히 하는 데 도움이 되지만, 기업은 답변을 제품 설계 및 구현 계획으로 번역해야 합니다.
Arista는 VeloCloud Orchestrator에서 발견된 치명적인 취약점인 CVE-2026-114625에 대한 보안 권고를 발표했습니다. 공격자들은 CVSS 점수 9.9의 이 결함을 적극적으로 악용하고 있습니다. 이 취약점은 읽기 전용 계정을 가진 사용자가 전체 운영자 수준의 권한을 얻을 수 있도록 합니다. 이는 조작된 SQL 쿼리가 백엔드의 요청 데이터를 조작할 수 있기 때문에 가능합니다. 악용하려면 VCO 웹 인터페이스에 대한 네트워크 액세스와 유효한 로그인 자격 증명이 필요합니다. 이는 Arista가 7월 이후 보고한 세 번째로 악용된 VeloCloud Orchestrator 취약점이지만, 인증이 필요한 것은 이번이 처음입니다. 운영자 계정은 테넌트가 관리하는 모든 고객의 전체 SD-WAN 패브릭을 제어하므로 영향은 상당합니다. 이 결함은 VCO 호스트 자체를 손상시킬 가능성도 있습니다. 릴리스 트레인 5.2, 6.1, 6.4에 대한 특정 수정 버전이 제공되며, 호스팅 및 전용 오케스트레이터는 이미 패치되었습니다. 지원되지 않는 트레인을 사용하는 고객은 업그레이드 옵션에 대해 Arista에 문의해야 합니다. 임시 제어에는 웹 인터페이스 액세스 제한 및 의심스러운 활동 모니터링이 포함됩니다. Arista는 공격에 사용된 두 개의 IP 주소를 식별했으며 고객에게 해당 IP 주소를 차단하고 관련 활동에 대한 로그를 검색하도록 권고합니다.
제품 페이지를 스크래핑할 때, 200 응답이 유용한 데이터를 보장하지는 않습니다. 왜냐하면 핵심 정보는 종종 JavaScript를 통해 로드되기 때문입니다. 중요한 질문은 "어떤 스크래퍼인가?"가 아니라 "데이터가 어디에 있는가?"입니다. 많은 전자상거래 페이지는 백엔드 API 호출을 통해 데이터를 가져오는 클라이언트 측 렌더링을 사용합니다. 좋은 시작점은 DevTools에서 제품 세부 정보가 포함된 JSON 응답에 대한 네트워크 요청을 검사하는 것입니다.대략적인 워크플로우는 페이지를 수동으로 로드하고, Fetch/XHR에 대한 네트워크 요청을 필터링하고, 응답 본문에서 알려진 제품 데이터를 검색하고, 요청을 cURL로 복사한 다음, 헤더를 최소화하여 필수 헤더를 찾는 것을 포함합니다. 일부 사이트는 직접 cURL 호출을 허용하는 반면, 다른 사이트는 세션 쿠키, 지리 헤더 또는 CSRF 토큰을 요구합니다.Shopify 스토어는 종종 더 쉽습니다. 많은 스토어가 /products.json을 통해 카탈로그를 노출하여 제품 제목, 변형, 가격 및 이미지 URL을 제공합니다. 이 방법은 HTML을 파싱하는 것보다 빠르고 강력하며 테마 변경으로 인한 CSS 선택기 실패를 방지합니다. 그러나 일부 Shopify 스토어는 이 엔드포인트를 차단하거나 노출되는 데이터를 제한합니다.직접 JSON 엔드포인트를 사용할 수 없거나 토큰 생성을 위해 JavaScript가 필요한 경우, Playwright와 같은 헤드리스 브라우저로 페이지를 렌더링해야 합니다. Playwright는 API 응답을 캡처하거나 JavaScript 실행 후 DOM에서 데이터를 추출할 수 있습니다. 이 접근 방식은 더 느리고 시간 초과, CAPTCHA 및 지역 추론과 같은 문제를 관리해야 합니다.전체 브라우저 자동화는 로그인 보호 가격, 위시리스트 또는 클릭과 지속적인 세션이 필요한 체크아웃 프로세스와 같은 대화형 상태에 예약되어 있습니다. 그러나 이것은 가장 리소스 집약적이며 느린 작업, 증가된 CAPTCHA 위험 및 브라우저 지문과 같은 문제에 취약합니다. 의사 결정 트리는 공개 JSON 엔드포인트, 내부 API 호출, 헤드리스 브라우저 렌더링, 그리고 마지막으로 전체 브라우저 자동화를 우선시합니다. 절대적으로 필요하지 않는 한 전체 브라우저 자동화로 시작하는 것을 피하십시오. 왜냐하면 대규모로 비용이 많이 들고 불안정해지기 때문입니다.
언어 모델은 특정 정책에 대한 지식이 부족하여 종종 잘못된 정보를 제공합니다. 검색 증강 생성(RAG)은 모델이 답변하기 전에 관련 문서를 제공함으로써 이를 해결합니다. 이 가이드는 도서관 비유를 사용하여 RAG를 설명합니다. 훌륭한 사서는 기억에만 의존하는 대신 특정 페이지를 검색합니다. RAG는 관련 구절을 검색하고, 이를 프롬프트에 추가하며, 해당 정보를 기반으로 답변을 생성하는 것을 포함합니다.RAG는 크거나 자주 업데이트되는 문서를 다루거나 비용 효율성이 중요할 때 유용합니다. RAG는 모든 프롬프트에 전체 문서를 붙여넣는 대신 대상 문서 검색을 허용합니다. 이 글은 Python과 SQLite를 사용하여 상점의 도움말 센터를 위한 간단한 RAG 시스템을 구축하는 방법을 설명합니다. 이 시스템은 문서를 청크로 나누고, 전문 검색을 위해 인덱싱하며, 상위 구절을 검색하고, 프롬프트를 구성하며, 답변의 인용을 확인합니다.구현에는 문서를 의미 있는 구절로 나누고 헤더를 유지하여 맥락을 보존하는 chunk_markdown 함수가 포함됩니다. build_index 함수는 이러한 구절을 저장하기 위한 SQLite FTS5 가상 테이블을 생성하고 효율적인 검색을 가능하게 합니다. search 함수는 질문을 처리하고, 동의어로 확장하며, 일반 단어를 제거하고, 강력한 방법을 사용하여 인덱스를 쿼리합니다.build_prompt 함수는 검색된 구절을 언어 모델을 위한 번호가 매겨진 소스로 형식화합니다. check_answer 함수는 모델이 기존 소스를 인용하고 숫자를 만들어내지 않도록 보장하기 위해 기본적인 유효성 검사를 수행합니다. 핵심 answer 함수는 이러한 단계를 조정하여 먼저 관련 구절을 검색하고 관련 정보가 발견된 경우에만 언어 모델을 호출합니다. 실제 언어 모델 API 없이 테스트하기 위한 자리 표시자 extractive_model이 제공됩니다.
Nginx 버전 1.31.5는 Unix 소켓 또는 TCP 포트를 통해 접근 가능한 새로운 제어 API를 도입했습니다. 이 API는 HTTP 기반 재로드를 허용하며, 기존의 신호 기반 재로드 방식과 달리 구조화된 응답을 제공합니다. 명령줄 플래그로 활성화할 수 있으며, 공식 Docker 이미지에는 필요한 컴파일이 포함되어 있습니다. API의 엔드포인트 트리는 순차적인 GET 요청을 통해 발견할 수 있습니다. 주요 엔드포인트로는 워커 PID를 얻기 위한 /1/control/processes와 라이브 구성을 검색하기 위한 /1/control/config가 있습니다. /1/control/config에 대한 PATCH 요청은 디스크에서 구성 파일을 다시 읽어 구성을 재로드하도록 트리거합니다. 이 API는 실패한 재로드 시 파싱 가능한 JSON 오류 메시지를 반환하여, 정보가 적은 신호 방식과 달리 상당한 이점을 제공합니다. 초기 가정과는 달리, API 재로드 프로세스가 신호 방식보다 눈에 띄게 빠르지는 않습니다. 동시성 테스트 결과, 사용된 방법에 관계없이 인플라이트 요청은 재로드에 영향을 받지 않는 것으로 나타났습니다. 제어 API는 네트워크 포트에 바인딩될 경우 네이티브 인증이 부족하고 네트워크 접근 권한이 있는 누구나 악용할 수 있으므로 상당한 보안 위험을 수반합니다. Unix 소켓에 엄격한 파일 권한으로 소켓을 바인딩하는 것이 권장되는 완화 조치이며, 비권한 사용자를 효과적으로 차단합니다. 제어 소켓을 활성화하면 마스터 프로세스에 약간의 메모리 오버헤드가 발생합니다. 테스트 결과, 바인드 마운트된 구성 파일에 대한 호스트 측 파일 편집이 실행 중인 컨테이너로 전파되지 않을 수 있으며, 즉각적인 업데이트를 위해서는 docker cp와 같은 방법이 필요합니다. 제어 API의 주요 이점은 재로드 중 우수한 오류 보고 기능에 있으며, 배포 스크립트에 유용합니다. 적절한 권한을 가진 Unix 소켓에만 제어 소켓을 바인딩하는 것이 강력히 권장됩니다. 관리자는 Nginx 버전 1.31.5 이상에서 네트워크에 바인딩된 제어 소켓이 있는지 시스템을 감사해야 합니다.
LazyDesk는 작은 디지털 잡무를 자동화하도록 설계된 로컬 우선 AI 어시스턴트입니다. 노트 정리 및 문서 요약과 같은 작업에 소요되는 시간을 줄이는 것을 목표로 합니다. 어시스턴트는 로컬에서 실행되는 AI 모델을 사용하여 이러한 작업을 수행하며, 수동적인 노력이 필요하지 않습니다. 핵심 원칙은 사용자 기기에서 직접 정보를 처리하는 것입니다.LazyDesk는 오픈 가중치 LLM, Ollama를 사용한 로컬 추론, 그리고 간단한 애플리케이션 계층을 활용합니다. 사용자는 텍스트를 제공하고, 로컬 모델이 이를 처리하며, 사용자는 생성된 출력을 검토합니다. 이 접근 방식은 데이터를 사용자 기기에 유지함으로써 개인 정보를 우선시합니다. 오픈 혁신은 다양한 모델로 실험하고 워크플로우를 맞춤 설정할 수 있도록 합니다.로컬 처리는 또한 비싼 호스팅 AI API에 대한 의존도를 줄입니다. 사용자는 데이터와 어시스턴트 기능에 대한 더 많은 통제권을 얻습니다. 또한, LazyDesk는 설정 후 오프라인으로 작동할 수 있어 복원력을 보장합니다. 이 프로젝트는 사용자에게 더 많은 자유를 주고 반복적인 작업을 자동화하여 더 의미 있는 작업을 위한 시간을 확보하는 데 중점을 둡니다. AI는 또 다른 관리형 서비스를 추가해서는 안 된다는 믿음으로 구축되었습니다.
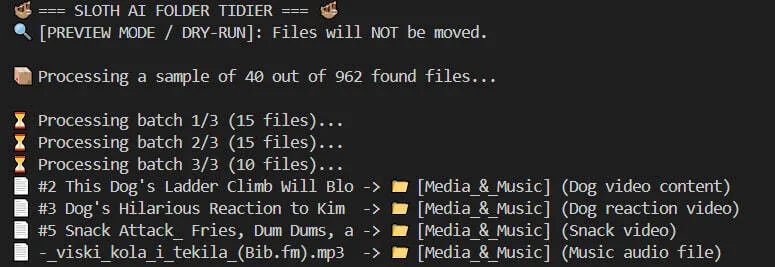
저자는 지저분한 다운로드 폴더를 관리하기 위해 slothsort라는 도구를 만들었습니다. slothsort는 Ollama를 통해 로컬 오픈 가중치 AI 모델인 Gemma 3 4B를 활용하여 파일을 분석합니다. 각 파일에 대해 새로운 폴더 위치와 사람이 읽을 수 있는 이름을 지능적으로 제안합니다. 이 도구는 기본적으로 드라이 런(dry run)으로 작동하므로, 사용자의 명시적인 확인 없이는 파일이 이동되지 않습니다. 한 번의 명령으로 실행 취소 기능이 있어 사용자는 slothsort가 수행한 모든 변경 사항을 되돌릴 수 있습니다. 새로운 이름에 접미사를 추가하여 기존 파일을 덮어쓰는 것을 방지하도록 설계되었습니다. slothsort는 또한 현재 다운로드 중이거나 최근에 수정된 파일을 지능적으로 건너뜁니다. AI의 제안은 캐시되어 후속 실행 시 성능을 최적화합니다. 이 도구는 CPU를 활용하여 강력한 GPU 없이도 작동하도록 점진적으로 성능이 저하됩니다. 민감한 사용자 데이터를 클라우드로 업로드하는 것을 방지하여 개인 정보를 보호하며, 파일은 로컬 컴퓨터에 그대로 유지됩니다. slothsort는 읽을 수 있는 텍스트가 없는 파일의 이름을 정리하여 효율성을 높입니다. 파일 스캔, 분석 및 이름 변경 전체 프로세스를 자동으로 실행하도록 예약할 수 있습니다. 이 프로젝트는 개인 정보 문제나 반복적인 비용 없이 복잡한 작업을 로컬에서 실행하기 위한 오픈 소스 AI의 가치를 강조합니다.
CdXz5zHNQW_tc5nk61QR8.webp
바코드는 제품 식별, 재고 관리 및 추적을 위한 필수 도구로, 스캐너를 통한 빠른 데이터 검색을 용이하게 합니다. 특정 응용 프로그램 및 데이터 유형에 적합한 다양한 바코드 형식이 존재합니다. Code 128은 영숫자 문자와 특수 기호를 인코딩할 수 있는 고밀도 1차원 바코드로, 주로 배송 및 물류에 사용됩니다. Code 39는 대문자, 숫자 및 제한된 특수 문자를 지원하는 또 다른 1차원 바코드로, 산업 현장에서 자주 볼 수 있습니다. UPC-A는 북미에서 소매점 판매 시점 시스템에서 소매 제품을 식별하는 데 널리 사용되는 12자리 바코드입니다. 국제적으로는 13자리 바코드인 EAN-13이 소매 제품 식별에 유사한 목적으로 사용됩니다. ITF-14은 카톤 수준에서 무역 품목을 식별하도록 설계되었으며, 도매 포장 및 공급망 운영에 유용합니다. QR 코드는 웹사이트 URL 및 텍스트와 같은 다양한 디지털 정보를 저장할 수 있는 2차원 바코드로, 스마트폰으로 쉽게 스캔할 수 있습니다. 올바른 바코드 선택은 응용 프로그램, 인코딩할 데이터 및 스캔 요구 사항에 따라 달라집니다. 소매점의 경우 UPC-A 또는 EAN-13이 일반적이며, Code 128은 물류에, ITF-14은 카톤에, QR 코드는 디지털 링크에 적합합니다. 바코드를 생성하기 전에 항상 소매점 또는 산업 표준과 특정 요구 사항을 확인하십시오.
OpenClaw(이전 Moltbot)는 빠르게 발전하고 있으며, 메시징 플랫폼 지원에 대한 혼란을 야기하고 있습니다. 진정한 지원은 단순한 호환성을 넘어, 전달 보장, ID 모델, 보안에 대한 아키텍처적 명확성을 요구합니다. OpenClaw의 통합 수준은 네이티브 및 커뮤니티 커넥터부터 웹훅을 통한 브리지까지 다양합니다. Slack 또는 Discord와 같은 봇 API를 갖춘 실시간 채팅 플랫폼은 가장 강력한 지원을 제공합니다. 그러나 봇 표면이 제한적이거나 공식 봇 API가 없는 암호화된 메시징 앱은 상당한 어려움을 제시합니다. 지원을 평가할 때 엔지니어링 팀은 인바운드 이벤트 범위, 아웃바운드 기능, ID 충실도, 운영 안정성, 보안 태세 및 속도 제한 전략을 평가해야 합니다. 강력한 커넥터 아키텍처는 일반적으로 인바운드 유효성 검사, 이벤트 정규화, 정책 계층, OpenClaw 런타임 및 응답 오케스트레이션을 포함합니다. Slack 스타일, Discord 스타일, Telegram 스타일 또는 엔터프라이즈 채팅과 같은 각 메시징 플랫폼에는 고유한 엔지니어링 고려 사항이 있습니다. 보안은 웹훅 서명 확인, 안전한 토큰 관리 및 최소 권한 액세스를 요구하며 가장 중요합니다. 프로덕션 채팅 에이전트는 멱등성, 추론 전 큐잉 및 점진적 성능 저하 전략을 사용해야 합니다. Apidog와 같은 도구로 촉진되는 API 우선 접근 방식은 표준 커넥터 API를 정의하고 이를 기반으로 플랫폼 어댑터를 테스트하여 개발을 간소화합니다. Moltbot/Clawdbot과 같은 이전 버전에서 마이그레이션하려면 변경된 URL과 스키마에 주의를 기울여야 합니다. 통합 유형을 선택할 때 네이티브 커넥터는 SLA 기반 안정성에 가장 적합하고, 커뮤니티 커넥터는 관리 가능한 부담이 있는 틈새 플랫폼에 적합하며, 브리지는 신속한 프로토타이핑에 적합합니다. 궁극적으로 OpenClaw가 메시징 앱을 지원하는 정도는 사용 가능한 봇 API와 커넥터의 성숙도에 비례합니다.
CdXz5zHNQW_kSyjOBIh0W.webp