BigQuery에 TabFM 소개: 예측 분석의 재해석
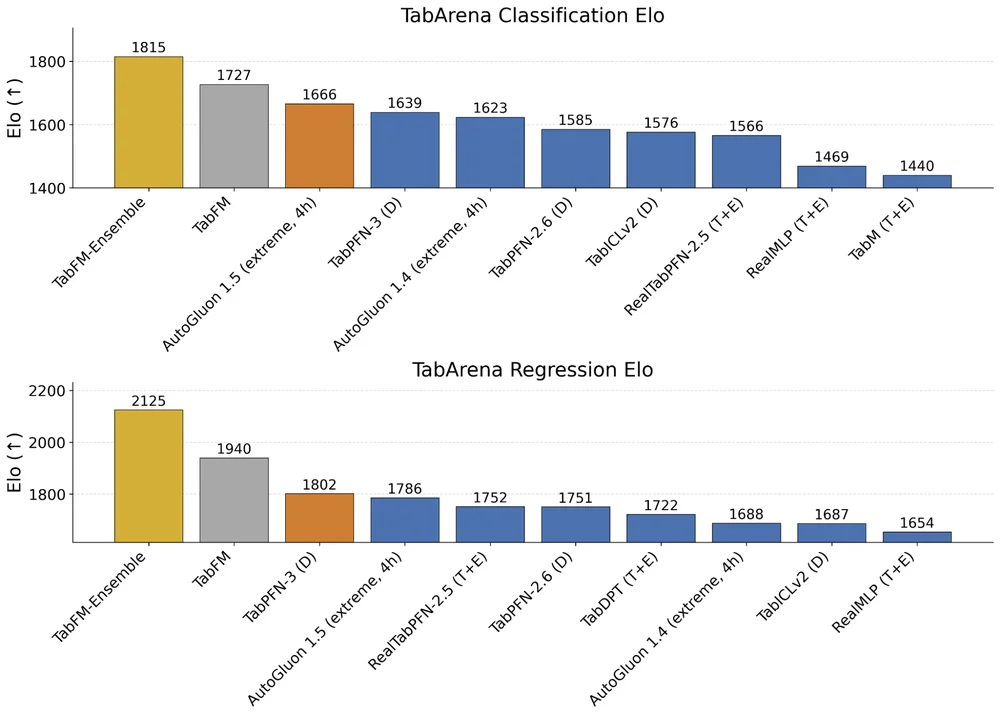
예측 분석은 이전에는 복잡한 맞춤형 모델 구축 및 학습 주기를 필요로 했습니다. 이러한 전통적인 접근 방식은 수동 특징 공학, 긴 튜닝, 전문 기술을 포함했으며, 종종 예측 모델의 활용 저하로 이어졌습니다. Google Research는 이제 BigQuery에서 사용할 수 있는 테이블 데이터용 사전 학습된 기반 모델인 TabFM을 출시했습니다. TabFM은 인컨텍스트 학습을 활용하여 단일 SQL 문을 통해 즉각적이고 매우 정확한 예측을 제공하며, 별도의 학습 및 배포 단계를 제거합니다. 이 시스템은 제로샷 예측을 제공하여 광범위한 머신러닝 전문 지식이 없는 사용자에게 프로세스를 단순화합니다. 또한 인프라를 관리하지 않고 예측 기능을 제공하여 에이전트 애플리케이션을 향상시킵니다. TabFM은 벤치마크에서 전통적인 모델을 능가하는 최첨단 정확도를 보여줍니다. 개발자 경험은 네이티브 BigQuery 통합 및 간단한 SQL 구문을 통해 단순화됩니다. TabFM은 특징 공학 작업을 자동으로 처리하며, 확장성을 통해 수백만 행을 빠르게 처리할 수 있습니다. 사용자는 AI.PREDICT를 활용하여 즉각적인 예측을 수행하고 AI.EVALUATE를 사용하여 모델 성능을 평가할 수 있습니다. TabFM은 빠른 인사이트 및 빈번한 재학습에 뛰어나지만, 전통적인 모델은 매우 큰 데이터셋이나 특징 중요도 설명 가능성이 중요한 경우에 여전히 적합합니다. 이 통합은 예측 머신러닝을 표준 SQL 쿼리 실행만큼 쉽게 만듭니다.