대규모 Apache Iceberg 관리: Spanner가 Lakehouse 런타임 카탈로그를 지원하는 방법
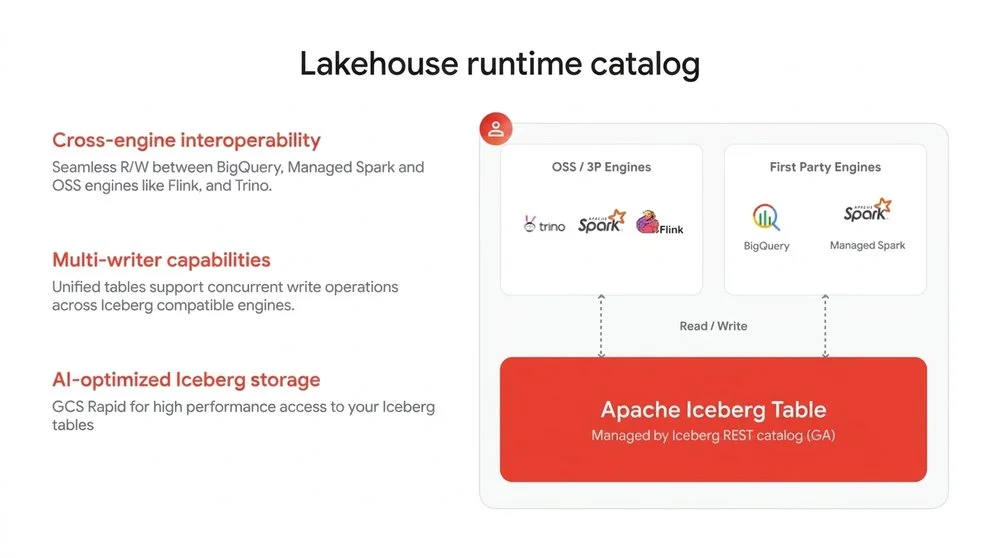
고객들은 AI 네이티브 솔루션을 위한 공유 데이터 에스테이트를 구축하기 위해 Apache Iceberg와 같은 개방형 형식을 표준화하여 레이크하우스 아키텍처를 채택하고 있습니다. 핵심 구성 요소는 테이블 포인터, 원자적 커밋을 관리하고 단일 진실 공급원 역할을 하는 Apache Iceberg REST Catalog입니다. 기업은 AI 에이전트의 대규모의 작고 반복적인 쿼리를 지원하기 위해 확장성, 가용성 및 관리 기능이 뛰어난 카탈로그가 필요합니다. 이러한 카탈로그는 원자적 커밋, 고가용성, 데이터베이스 확장, 테이블 유지 관리 및 강력한 거버넌스와 같은 과제를 해결해야 합니다. Spanner 기반의 Google Cloud 서버리스 레이크하우스 런타임 카탈로그는 이러한 과제에 대한 솔루션을 제공합니다.이 카탈로그는 완전 서버리스이며 고가용성을 갖추고 있으며 메타데이터를 통합하고 Apache Iceberg REST Catalog 사양을 네이티브로 구현합니다. 주요 이점으로는 개방형 API, 멀티 엔진 상호 운용성(BigQuery, Managed Spark) 및 Iceberg 테이블에 대한 읽기/쓰기 기능이 있습니다. 객체 스토리지의 기존 데이터에 직접 연결하여 데이터 복사 없이 엔터프라이즈급 기능을 갖춘 완전 관리형 Iceberg 스토리지를 제공합니다. 또한 이 카탈로그는 클라우드 간 양방향 페더레이션(Databricks Unity, Snowflake Horizon, AWS Glue)과 자격 증명 발급을 통한 보안 액세스를 지원합니다. AI 기반 컨텍스트 및 거버넌스를 위해 Knowledge Catalog 및 Cloud IAM과 통합되어 테이블 수준 보안, 검색 및 계보를 제공합니다.중요하게도 Google의 행성 규모 인프라와 Spanner를 기반으로 원자적 커밋, 동시성 제어, 고가용성 및 확장성을 보장합니다. Spanner는 읽기 및 쓰기에 대한 수평 확장 탄력성과 함께 완전한 관계형 SQL 의미론을 제공하며 지역 구성을 통해 고가용성을 달성합니다. 데이터 볼륨과 쿼리 로드를 동적으로 모니터링하여 컴퓨팅 및 스토리지를 자동으로 확장합니다. 이 기반은 직렬화 가능한 트랜잭션을 가능하게 하여 에이전트 규모 작업에 대해 업계 최고의 일관성 보장을 제공합니다. 레이크하우스 런타임 카탈로그는 Knowledge Catalog와 통합되어 Spanner의 전체 텍스트 및 네이티브 벡터 검색을 활용하여 검색 정확도를 높여 Iceberg 테이블을 효율적으로 검색합니다. 이 통합 접근 방식은 운영 오버헤드를 제거하고 AI 에이전트 사용 사례의 시장 출시 시간을 단축합니다. Google Cloud의 국경 없는 레이크하우스는 데이터, 거버넌스 및 AI 컨텍스트를 통합하는 동시에 운영 총 소유 비용을 절감합니다.