대규모 학습 및 추론 작업을 위한 안정적인 GPU 컴퓨팅
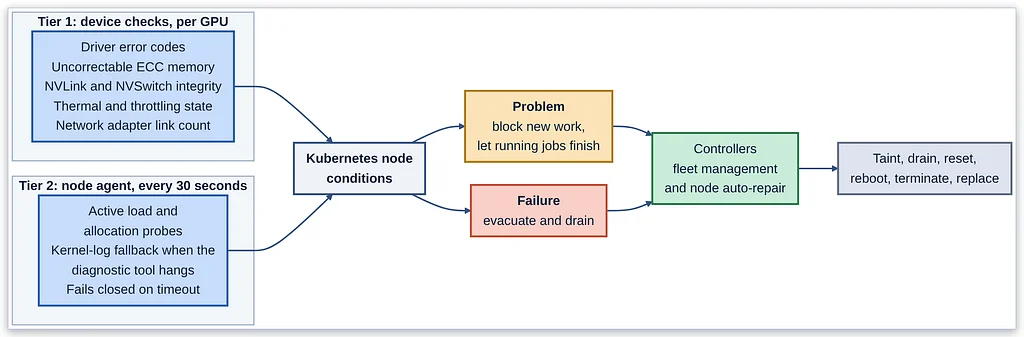
Netflix는 개인화된 콘텐츠 추천 및 기타 머신러닝 애플리케이션을 위해 GPU에 크게 의존합니다. 이러한 GPU는 콘텐츠를 학습하고 제공하는 데 필수적이므로, 가용성과 비용 효율성 모두에 있어 안정성이 비즈니스 필수 요소입니다. 기본적인 클라우드 제공업체의 상태 확인은 장시간 실행되는 학습 작업에 치명적인 미묘한 GPU 또는 네트워크 패브릭 장애를 감지하지 못하기 때문에 불충분합니다. 이러한 장애는 성능 저하 또는 작업 중단으로 나타날 수 있으며, 사용자 경험에 영향을 미치고 리소스를 낭비합니다.Netflix는 GPU 인프라 상태를 보장하기 위해 계층화된 접근 방식을 사용합니다. 첫 번째 계층은 GPU 및 네트워크 어댑터와 같은 실패하는 하드웨어를 감지하고 복구하는 데 중점을 둡니다. 두 번째 계층은 작업을 재시도하고 사용 전에 머신을 검증하는 스케줄러 및 플랫폼을 포함합니다. 세 번째 계층은 체크포인팅 및 탄력적 워커를 통해 머신 손실에서 장시간 실행되는 작업이 생존할 수 있도록 합니다. 네 번째 계층은 다른 세 계층의 효과를 모니터링하는 관찰 가능성입니다.상태 확인은 두 가지 계층으로 작동합니다. 개별 GPU에 대한 장치 수준 확인과 에이전트가 수행하는 노드 수준 확인입니다. 이러한 확인은 Kubernetes 노드 조건으로 결과를 보고합니다. 문제가 감지되면 머신의 조건이 업데이트되고 컨트롤러가 조치를 취합니다. 초기 문제는 허용되지만, 지속적인 장애는 머신 대피, 드레인 및 교체로 확대됩니다.복구는 등급별로 이루어지며, 단일 GPU를 다시 시작하는 것부터 전체 머신을 종료하고 교체하는 것까지 오류 심각도에 맞춰 조치가 이루어집니다. 지속적으로 실패하는 하드웨어의 경우, 불변 식별자가 기록되어 풀에 다시 참여하는 것을 방지합니다. 머신은 모든 진단을 통과하도록 보장하기 위해 작업에 투입되기 전에 검증됩니다. 마지막으로, 체크포인팅을 통해 장시간 실행되는 작업이 복원력을 갖추게 되어, 머신이 손실될 경우 마지막 안정적인 상태에서 재개할 수 있습니다.