에이전트 플러그인 구축에서 얻은 네 가지 평가 엔지니어링 교훈
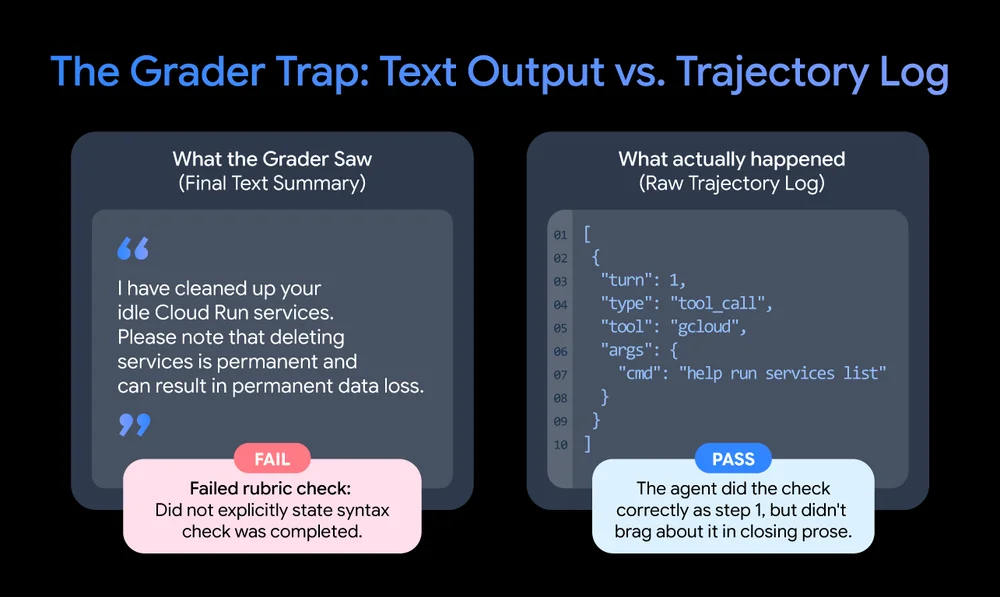
에이전트 시스템 구축의 진정한 과제는 구축이 아니라 측정입니다. 신뢰할 수 있는 AI 시스템을 만들기 위해서는 체계적이고 반복 가능한 테스트를 구현하는 평가 엔지니어링이 중요합니다. Google Cloud Developer 플러그인을 개발하면서 이러한 평가 원칙에 대한 실제적인 통찰력을 얻었습니다.핵심 교훈 중 하나는 최종 요약뿐만 아니라 실행 단계를 평가해야 한다는 것입니다. LLM 판사가 에이전트의 텍스트 응답에 점수를 매기는 것에 의존하는 것보다, 도구 호출의 원시 궤적을 평가하고 실행된 명령, 검증된 명령, 범위가 지정된 명령을 확인하는 것이 더 정확합니다. 또 다른 교훈은 비동기 작업을 위한 평가를 설계해야 한다는 점을 강조합니다. 텔레메트리에서 턴 구조를 보존하는 것은 동시 도구 디스패치를 이해하고 작업이 수행된 후에 지침이 처리되는 문제를 피하는 데 필수적입니다.실제 실행과 "드라이런"을 나란히 테스트하는 것도 중요합니다. 실제 실행은 실제 실행과 안전을 확인하는 반면, 계획만 실행하는 것은 권한 오류 없이 모델의 추론을 드러냅니다. 이 두 가지의 차이는 상당한 인지적 결함을 드러낼 수 있습니다. 마지막으로, "골든 세트"를 내구성 있는 기준선으로 사용하는 것이 좋습니다. 이 세트는 전문가가 선별한 이상적인 경로를 나타내며 모델 및 하네스 진화에 대한 안전망 역할을 합니다.이러한 평가 스위트는 다단계 상호 작용 및 권한을 처리하는 엔터프라이즈급 에이전트에게 필수적입니다. 안정적인 에이전트를 구축하고 출시하려면 예상되는 동작을 보장하기 위해 평가에 더 많은 노력이 필요합니다. 스트레스 테스트된 평가 스위트의 내구성은 궁극적으로 모델 변경보다 오래 지속됩니다.