GitHub, AI 에이전트 시대를 위한 Git 저장소 재구축 방법
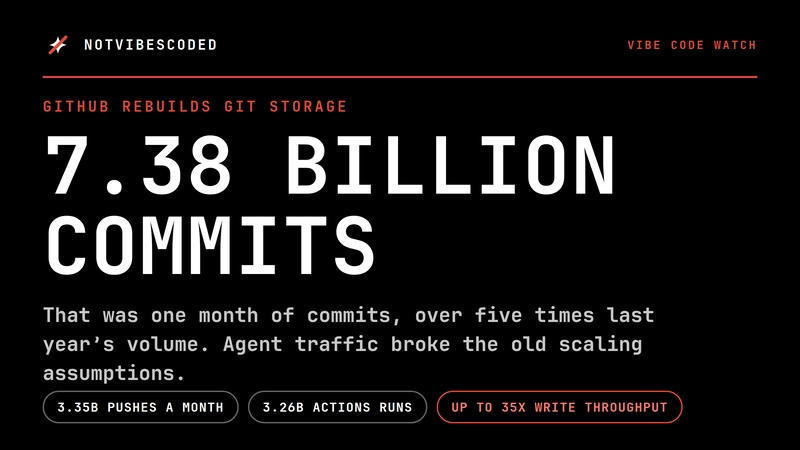
GitHub은 AI 에이전트로부터 발생하는 트래픽 증가로 인해 Git 리포지토리 저장 시스템을 재구축하고 있습니다. AI 에이전트는 인간보다 훨씬 더 자주 코드를 커밋하고 푸시하여, 인간의 작업 리듬에 맞춰 설계된 기존 저장 인프라를 압도하고 있습니다. AI 에이전트가 루프 내에서 작동하면서 발생하는 이러한 커밋 및 푸시의 급증은 심각한 확장성 문제를 야기했습니다. Spokes라고 불리는 현재 시스템은 여러 파일 서버에 리포지토리를 저장하며, 모든 복사본이 모든 쓰기 작업에 참여하여 바쁜 리포지토리의 처리 속도를 늦춥니다. GitHub의 새로운 설계는 이 병목 현상을 해결하기 위해 데이터 안전성과 트래픽 제공을 분리합니다. 이는 복사본 간의 합의가 필요한 푸시 부분을 ref 업데이트로만 최소화할 것입니다. 저장과 컴퓨팅을 분리함으로써, 권한 있는 복사본은 Azure Blob Storage에 상주하게 되며, 경량 워커가 읽기 및 캐싱을 처리합니다. 이러한 아키텍처 변경은 내부 벤치마크에서 최대 35배 더 높은 쓰기 처리량을 가능하게 합니다. 핵심 원칙은 조정 지점을 작고 데이터 제공과 분리하는 것입니다. 개별 개발자에게는 자체 워크플로우에서 유사한 확장성 문제를 피하기 위해 에이전트 커밋 빈도를 인지하는 것이 중요합니다. 인간과 AI의 근본적인 커밋 패턴 차이는 소프트웨어 개발을 위한 이러한 인프라 진화를 필요로 합니다.