Google Cloud에서 Reflection의 Beam에 대한 Day 0 지원: llm-d 및 NVIDIA Dynamo를 통한 5배 빠른 성능
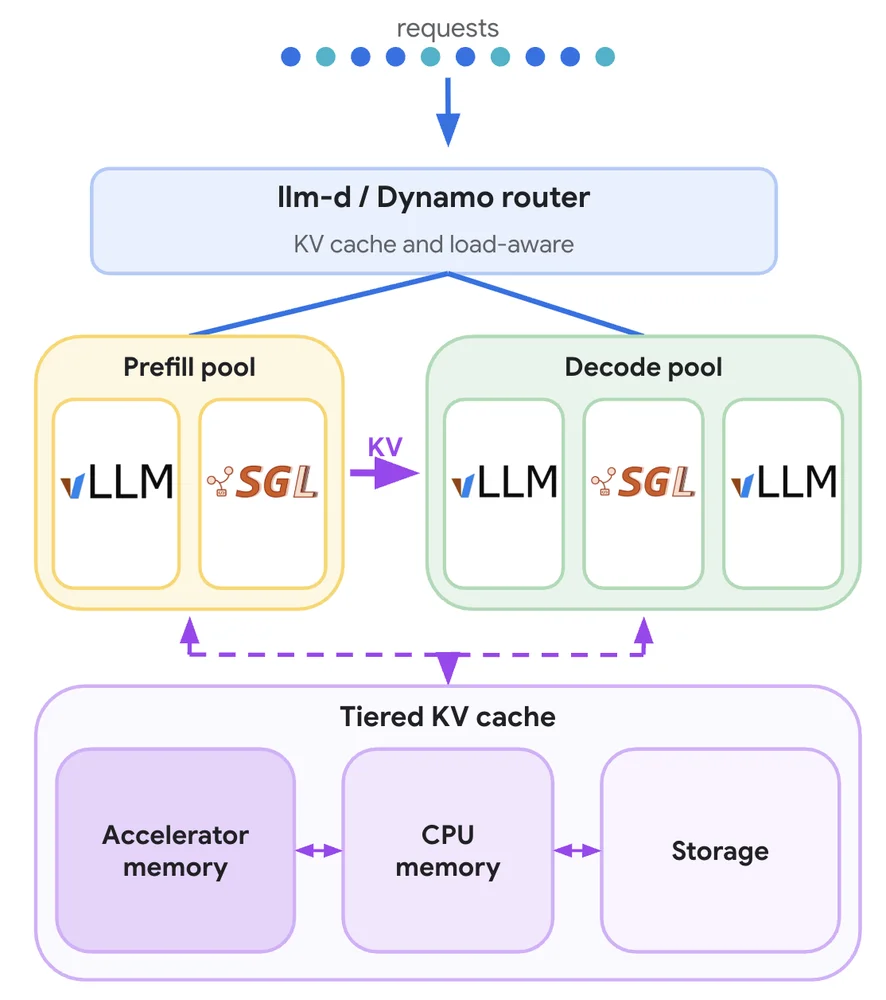
Reflection이 고급 소프트웨어 엔지니어링 및 장기 에이전트 작업용으로 설계된 오픈 웨이트 모델인 Beam을 출시했습니다. Beam은 Apache 2.0 라이선스로 운영되며, 해당 파라미터 클래스의 모델에 대해 인상적인 추론 효율성을 제공합니다. Google Cloud는 Beam에 대한 즉각적인 지원을 발표했으며, AI Hypercomputer 및 NVIDIA AI Infrastructure에서 배포 레시피를 제공합니다. Reflection과 함께 Google Cloud는 llm-d 및 NVIDIA Dynamo를 사용하여 Beam의 성능을 최적화하여 서빙을 강화했습니다. Google Cloud에 Beam을 배포한 결과 에이전트 작업에 대한 성능이 크게 향상되고 지연 시간이 단축되었습니다. 이번 출시는 모델 및 시스템 효율성의 복합적인 향상을 강조하며, 에이전트의 처리량 증가 및 지연 시간 감소로 이어집니다. 고효율 다중 턴 서빙은 KV 캐시 인식 라우팅 및 추측 디코딩과 같은 고급 기술을 통해 달성됩니다. 개발자는 이제 에이전트 작업에 대한 턴키 최적화 배포의 이점을 쉽게 누릴 수 있습니다. 에이전트 작업에 대한 추론을 확장하려면 모델 및 서빙 시스템 계층 모두에서 최적화가 필요합니다. Beam의 고유한 아키텍처는 토큰당 파라미터의 일부만 활성화하여 컴퓨팅 요구 사항을 대폭 줄입니다. 서빙 스택은 장기 컨텍스트 시나리오에서 사전 채우기 컴퓨팅 및 KV 캐시 용량과 같은 병목 현상을 해결합니다. 이 공동 개발 솔루션은 개발자에게 강력하고 효율적인 AI 도구를 제공하는 것을 목표로 합니다.