Google의 Agentic Data Cloud로 대규모 에이전트에 동력을 공급하는 새로운 기능
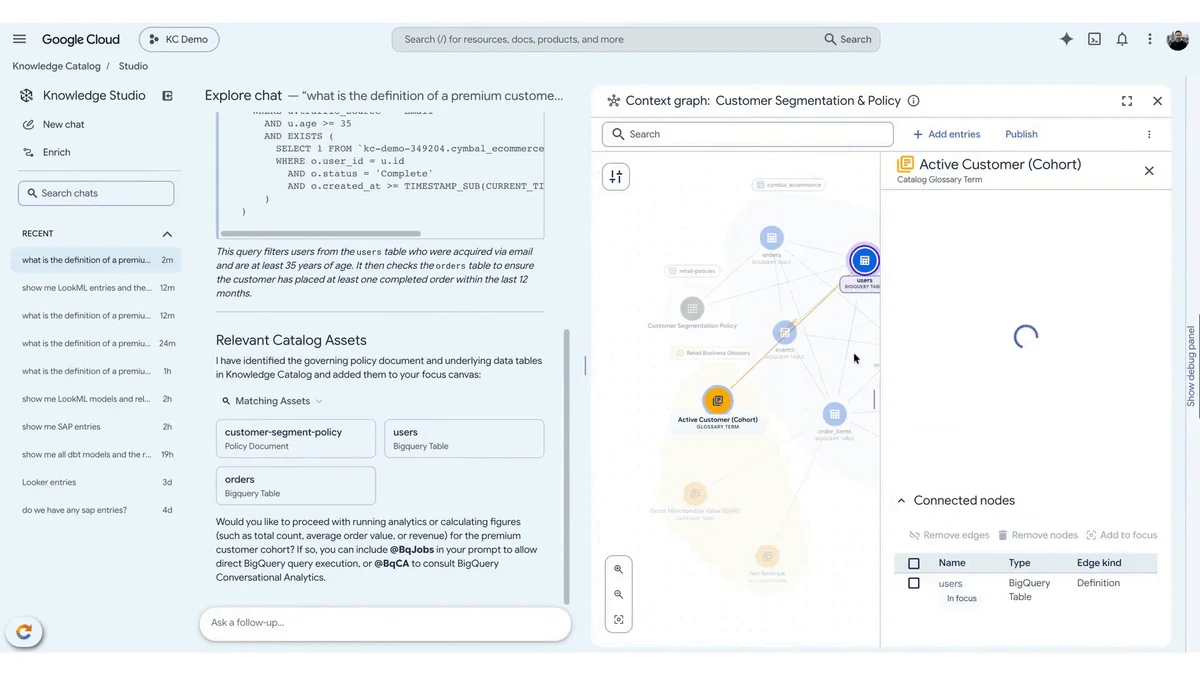
조직들은 수익, 효율성 및 위험 관리를 향상시키기 위해 에이전트 기반 자동화를 점점 더 활용하고 있습니다. Google의 Agentic Data Cloud는 엔터프라이즈 데이터를 통합하고, 정확성을 보장하며, 저렴한 비용으로 선제적으로 운영하도록 설계된 System of Action입니다. 국경 없는 Lakehouse는 개방형 Apache Iceberg 형식을 사용하여 멀티 클라우드, 온프레미스 및 SaaS 플랫폼 전반의 분산 데이터를 활성화합니다. 새로운 향상 기능은 Gemini가 자연어를 사용하여 Lakehouse를 쿼리할 수 있도록 하고, 크로스 클라우드 상호 연결은 안전하고 제로 이그레스 수수료 데이터 액세스를 제공합니다. AlloyDB 통합은 에이전트가 Iceberg 테이블을 직접 쿼리하여 과거 및 실시간 데이터를 효율적으로 조인할 수 있도록 합니다. Spanner Omni는 하이브리드 에이전트 애플리케이션에 Google 수준의 일관성과 확장을 제공합니다. Google Cloud의 범용 컨텍스트 엔진인 Knowledge Catalog는 에이전트를 엔터프라이즈 컨텍스트에 기반하여 정확성을 향상시키고, 지연 시간을 줄이며, 토큰 비용을 낮춥니다. 자체 학습 강화 및 재사용 가능한 OKF 컨텍스트 세트는 Google Workspace 및 SharePoint와 같은 비정형 소스에서 컨텍스트 큐레이션을 자동화합니다. Knowledge Catalog의 새로운 스튜디오 환경은 컨텍스트를 탐색하고 관리하기 위한 대화형 UI를 제공합니다. Knowledge Catalog는 이제 Gemini에서 기본으로 제공되어, 관리되는 비즈니스 컨텍스트에 데이터 질문을 기반으로 하고 다양한 플랫폼의 신뢰할 수 있는 의미론적 모델을 지원합니다. Google은 실무자 경험을 혁신하여 데이터 및 ML 엔지니어가 Gemini의 머신러닝 기술을 사용하여 의도 기반 결과에 대한 에이전트를 오케스트레이션할 수 있도록 합니다. 비즈니스 사용자는 단순히 질문하여 실시간 운영 보고서를 생성할 수 있습니다. Data Agent Kit는 Google Data Cloud 도구를 개발자의 선호하는 IDE 및 CLI에 통합합니다. Google은 또한 에이전트 규모에 대한 데이터 인프라를 엔지니어링하고 있으며, 신속한 프로토타이핑을 위해 AlloyDB Express를, AlloyDB for production의 에이전트를 위해 PostgreSQL을 도입하고 있습니다. Managed Service for Apache Spark는 가격 대비 성능을 확장하며, BigQuery는 더 빠른 쿼리, 페타바이트 규모의 그래프 분석을 위한 BigQuery Graph, 그리고 TimesFM 3.0 및 TabFM과 같은 새로운 Google Research 모델로 향상되었습니다.