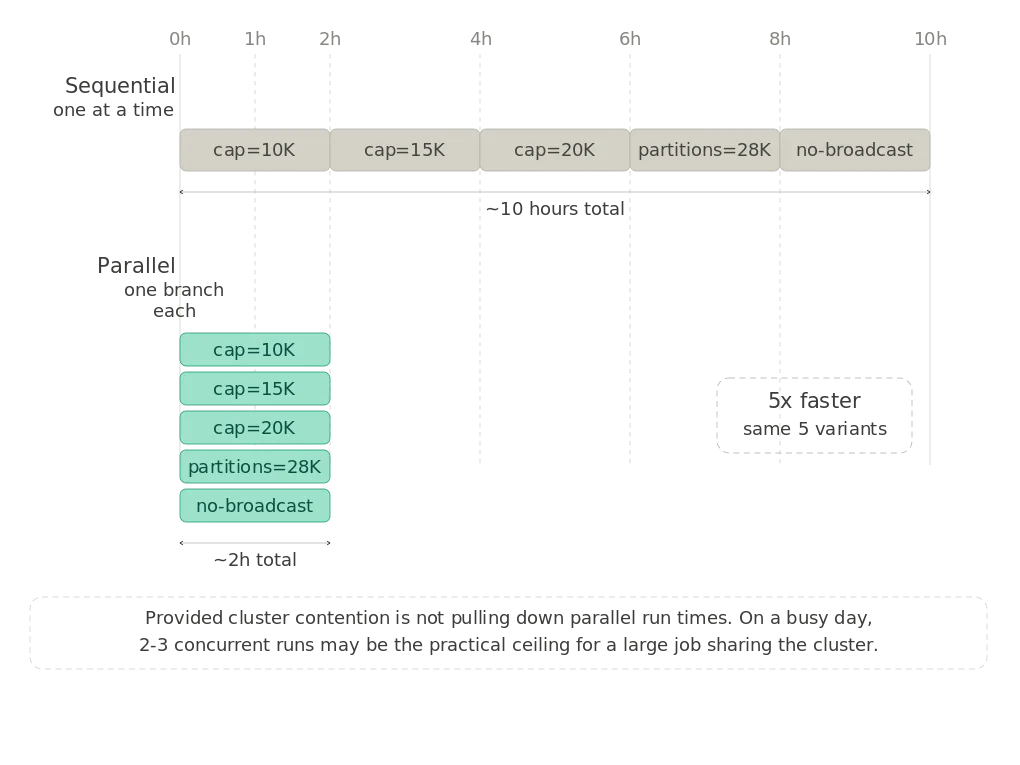
Netflix의 member-sessionizer는 사용자 시청 세션을 생성하기 위해 수십억 개의 이벤트를 처리하는 중요한 데이터 파이프라인입니다. 데이터 편향으로 인해 샘플링되지 않은 대규모 데이터셋에서만 발생하는 Out-Of-Memory 오류와 같은 문제는 Netflix의 프로덕션 규모에서 표준 디버깅 접근 방식으로는 해결되지 않았습니다. 저자의 돌파구는 단일 실행 속도를 높이는 것에서 여러 동시 실험을 가능하게 하는 것으로 초점을 전환한 것이었습니다. 이는 Dataflow의 브랜치 기반 개발을 활용하여 각 테스트 변형을 격리함으로써 달성되었습니다.스케줄러를 매개변수화하고 각 실험에 자체 브랜치와 출력 테이블을 할당함으로써 여러 테스트를 동시에 실행할 수 있었습니다. 이는 테스트당 총 실행 시간을 몇 시간에서 가장 긴 단일 작업의 지속 시간으로 크게 단축했습니다. AI 에이전트는 수많은 병렬 실험을 실행하는 운영 복잡성을 관리하고, 구성 업데이트, 작업 트리거 및 메트릭 폴링을 자동화하는 데 사용되었습니다. 이를 통해 저자는 지루한 수동 확인에서 벗어나 즉시 결과를 비교할 수 있었습니다.Netflix의 클라우드 개발 환경에서 지속적인 tmux 세션은 수 시간 동안 실행되는 Spark 작업이 네트워크 끊김이나 노트북 종료로 인해 중단되는 것을 방지하는 데 중요했습니다. 핵심 성능 병목 현상은 전체 이벤트 백을 메모리에 버퍼링하는 collect_list 연산자와 비효율적인 데이터 구조로 확인되었습니다. 특히, 세션 ID를 UUID 문자열로 변경하고 필드에 Scala Options를 사용하는 것은 메모리 사용량을 크게 증가시켰습니다. 또한, 부풀려진 문자열 속성은 각 이벤트에 불필요한 부담을 추가했습니다.수정 사항에는 Options에서 기본 필드를 언박싱하고 사용되지 않는 속성을 제거하여 이벤트 백을 축소하는 것이 포함되었습니다. 세션에 불변하는 메타데이터는 세션 헤더로 옮겨졌습니다. 두 가지 직관에 반하는 발견은 Spark 메모리 관리의 복잡성을 강조했습니다. 행을 좁히는 것이 브로드캐스트 조인을 강제하여 더 빠른 OOM을 유발할 수 있었고, Adaptive Query Execution은 브로드캐스트 해시 조인을 통해 메모리에 대량의 데이터를 조용히 축적했습니다. AQE의 브로드캐스트 임계값을 조정하여 이 문제를 해결했습니다.체계적인 로깅 시스템은 각 실험, 해당 구성 및 주요 메트릭을 추적하여 단일 진실 공급원을 만들고 격리된 변수 변경을 강제했습니다. 세션 잘림 수정 사항을 Spark Window 스테이지 이전에 테스트하는 실수가 있었는데, 이는 잘림 전에 메모리를 버퍼링했습니다. 최종적으로 수정된 수정 사항은 메모리 부풀림을 방지하기 위해 잘림을 업스트림으로 옮겼습니다. 이러한 튜닝 노력은 즉각적인 문제를 해결했지만, 전체 세션을 단일 행으로 집계하는 근본적인 데이터 형태는 미래의 확장성 문제를 제기합니다.

collect_list연산자와 비효율적인 데이터 구조로 확인되었습니다. 특히, 세션 ID를 UUID 문자열로 변경하고 필드에 Scala Options를 사용하는 것은 메모리 사용량을 크게 증가시켰습니다. 또한, 부풀려진 문자열 속성은 각 이벤트에 불필요한 부담을 추가했습니다.수정 사항에는 Options에서 기본 필드를 언박싱하고 사용되지 않는 속성을 제거하여 이벤트 백을 축소하는 것이 포함되었습니다. 세션에 불변하는 메타데이터는 세션 헤더로 옮겨졌습니다. 두 가지 직관에 반하는 발견은 Spark 메모리 관리의 복잡성을 강조했습니다. 행을 좁히는 것이 브로드캐스트 조인을 강제하여 더 빠른 OOM을 유발할 수 있었고, Adaptive Query Execution은 브로드캐스트 해시 조인을 통해 메모리에 대량의 데이터를 조용히 축적했습니다. AQE의 브로드캐스트 임계값을 조정하여 이 문제를 해결했습니다.체계적인 로깅 시스템은 각 실험, 해당 구성 및 주요 메트릭을 추적하여 단일 진실 공급원을 만들고 격리된 변수 변경을 강제했습니다. 세션 잘림 수정 사항을 Spark Window 스테이지 이전에 테스트하는 실수가 있었는데, 이는 잘림 전에 메모리를 버퍼링했습니다. 최종적으로 수정된 수정 사항은 메모리 부풀림을 방지하기 위해 잘림을 업스트림으로 옮겼습니다. 이러한 튜닝 노력은 즉각적인 문제를 해결했지만, 전체 세션을 단일 행으로 집계하는 근본적인 데이터 형태는 미래의 확장성 문제를 제기합니다.